

Mabsham 786
2.2k Publicaciones
Mabsham 786
Denunciar
Bloquear usuario
M.A,M.ed
Abrir operación

Titular de SUI
Trader de alta frecuencia
1.5 años
6.0K+ Siguiendo
1.7K+ Seguidores
2.7K+ Me gusta
Publicaciones
Cartera
Todo
Cotizaciones
Directo
·
--
#BinancePick
gran oportunidad para llevarte una parte del fondo de premios de 1000000 USDC💵🎉💰
no te pierdas la oportunidad ......
$USDC
{future}(USDCUSDT)
#BinancePick
gran oportunidad para llevarte una parte del fondo de premios de 1000000 USDC💵🎉💰
no te pierdas la oportunidad ......
$USDC
gran oportunidad para llevarte una parte del fondo de premios de 1000000 USDC💵🎉💰
no te pierdas la oportunidad ......
$USDC
71
·
--
#BinancePick
únete ahora y consigue una parte del fondo de recompensas de 1000000 USDC😇💵💰🎉🚀
te deseo mucha suerte 🤞......$USDC
{future}(USDCUSDT)
#BinancePick
únete ahora y consigue una parte del fondo de recompensas de 1000000 USDC😇💵💰🎉🚀
te deseo mucha suerte 🤞......$USDC
únete ahora y consigue una parte del fondo de recompensas de 1000000 USDC😇💵💰🎉🚀
te deseo mucha suerte 🤞......$USDC
81
·
--
$OPG
{future}(OPGUSDT)
¿No has notado que la mayoría de las conversaciones de IA en cripto terminan dando vueltas al mismo problema: la confianza? ¿Quién está ejecutando el modelo? ¿Dónde está alojado? ¿Alguien puede verificar realmente lo que está pasando detrás de escena?
Recuerdo cuando la IA descentralizada empezó a captar atención. Muchos proyectos sonaban interesantes, pero siempre me pareció extraño que la propia infraestructura siguiera dependiendo en gran medida de unos pocos proveedores centralizados. Tal vez esperaba demasiado, demasiado pronto. Aun así, la contradicción era difícil de ignorar.
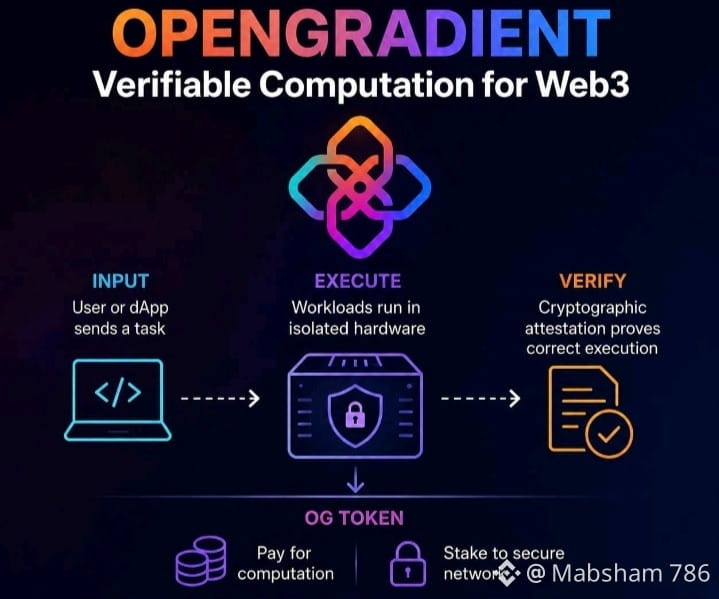
Por eso OpenGradient me llamó la atención. La idea de una red descentralizada construida para alojar, ejecutar y verificar modelos de IA a gran escala se parece más a lo que debería ser la inteligencia abierta. No solo compartir modelos, sino crear un entorno donde la inferencia pueda comprobarse y la infraestructura esté distribuida. Todavía estoy intentando entender cómo funciona esto en la práctica en redes grandes.
Lo que me genera curiosidad es cómo la demanda de IA sigue expandiéndose mientras, al mismo tiempo, crecen las preocupaciones sobre la transparencia. Quizá lo estoy pensando demasiado, pero la confianza podría volverse tan importante como el rendimiento bruto del modelo. Si los usuarios no pueden verificar los resultados, ¿la infraestructura de IA abierta realmente se mantiene abierta?
Todavía no sé qué arquitecturas ganarán a largo plazo. El cripto tiene la costumbre de sorprender a todos. Pero los proyectos que exploran una infraestructura de IA verificable y descentralizada parecen dignos de seguirse, porque están haciendo preguntas que la industria no podrá ignorar para siempre.
#op/usdt
$OPG
¿No has notado que la mayoría de las conversaciones de IA en cripto terminan dando vueltas al mismo problema: la confianza? ¿Quién está ejecutando el modelo? ¿Dónde está alojado? ¿Alguien puede verificar realmente lo que está pasando detrás de escena?
Recuerdo cuando la IA descentralizada empezó a captar atención. Muchos proyectos sonaban interesantes, pero siempre me pareció extraño que la propia infraestructura siguiera dependiendo en gran medida de unos pocos proveedores centralizados. Tal vez esperaba demasiado, demasiado pronto. Aun así, la contradicción era difícil de ignorar.
Por eso OpenGradient me llamó la atención. La idea de una red descentralizada construida para alojar, ejecutar y verificar modelos de IA a gran escala se parece más a lo que debería ser la inteligencia abierta. No solo compartir modelos, sino crear un entorno donde la inferencia pueda comprobarse y la infraestructura esté distribuida. Todavía estoy intentando entender cómo funciona esto en la práctica en redes grandes.
Lo que me genera curiosidad es cómo la demanda de IA sigue expandiéndose mientras, al mismo tiempo, crecen las preocupaciones sobre la transparencia. Quizá lo estoy pensando demasiado, pero la confianza podría volverse tan importante como el rendimiento bruto del modelo. Si los usuarios no pueden verificar los resultados, ¿la infraestructura de IA abierta realmente se mantiene abierta?
Todavía no sé qué arquitecturas ganarán a largo plazo. El cripto tiene la costumbre de sorprender a todos. Pero los proyectos que exploran una infraestructura de IA verificable y descentralizada parecen dignos de seguirse, porque están haciendo preguntas que la industria no podrá ignorar para siempre.
#op/usdt
¿No has notado que la mayoría de las conversaciones de IA en cripto terminan dando vueltas al mismo problema: la confianza? ¿Quién está ejecutando el modelo? ¿Dónde está alojado? ¿Alguien puede verificar realmente lo que está pasando detrás de escena?
Recuerdo cuando la IA descentralizada empezó a captar atención. Muchos proyectos sonaban interesantes, pero siempre me pareció extraño que la propia infraestructura siguiera dependiendo en gran medida de unos pocos proveedores centralizados. Tal vez esperaba demasiado, demasiado pronto. Aun así, la contradicción era difícil de ignorar.
Por eso OpenGradient me llamó la atención. La idea de una red descentralizada construida para alojar, ejecutar y verificar modelos de IA a gran escala se parece más a lo que debería ser la inteligencia abierta. No solo compartir modelos, sino crear un entorno donde la inferencia pueda comprobarse y la infraestructura esté distribuida. Todavía estoy intentando entender cómo funciona esto en la práctica en redes grandes.
Lo que me genera curiosidad es cómo la demanda de IA sigue expandiéndose mientras, al mismo tiempo, crecen las preocupaciones sobre la transparencia. Quizá lo estoy pensando demasiado, pero la confianza podría volverse tan importante como el rendimiento bruto del modelo. Si los usuarios no pueden verificar los resultados, ¿la infraestructura de IA abierta realmente se mantiene abierta?
Todavía no sé qué arquitecturas ganarán a largo plazo. El cripto tiene la costumbre de sorprender a todos. Pero los proyectos que exploran una infraestructura de IA verificable y descentralizada parecen dignos de seguirse, porque están haciendo preguntas que la industria no podrá ignorar para siempre.
#op/usdt
84
·
--
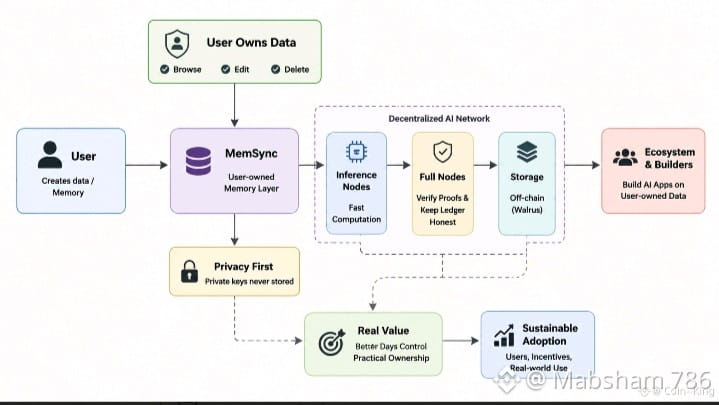
#opg $OPG El verdadero punto fuerte de OpenGradient, para mí, no es solo “IA onchain”. Es la idea de que los datos y los modelos pueden permanecer bajo propiedad del usuario en lugar de quedar dentro de una única caja negra. En MemSync, los usuarios pueden explorar, editar o eliminar la memoria latente, y sus claves privadas nunca se almacenan. Esto es algo muy importante porque el control solo importa cuando realmente puedes tocar los datos tú mismo.
Lo que me gusta de OpenGradient es la forma en que divide el trabajo. Los nodos de inferencia realizan el trabajo rápido, los nodos completos verifican las pruebas y mantienen el libro contable honesto, y el almacenamiento se mantiene fuera de la cadena en Walrus para que esta no se infle. Esa estructura se siente más realista que pedirle a cada validador que lo haga todo.
Aun así, lo difícil no es el diagrama. Es la adopción. OpenGradient tiene que convencer a los desarrolladores de que los datos bajo propiedad del usuario valen la pena por las piezas adicionales en movimiento, y de que la gente seguirá usándolo cuando se disipe la novedad. Ahí es donde empieza la prueba real.
Para mí, OpenGradient importa porque está intentando que el control sea práctico, no solo teórico. ¿Ese modelo resistirá cuando empiecen a empujarlo usuarios reales, costos reales e incentivos reales?
@OpenGradient #opg $OPG
{future}(OPGUSDT)
#op/usdt
#opg $OPG El verdadero punto fuerte de OpenGradient, para mí, no es solo “IA onchain”. Es la idea de que los datos y los modelos pueden permanecer bajo propiedad del usuario en lugar de quedar dentro de una única caja negra. En MemSync, los usuarios pueden explorar, editar o eliminar la memoria latente, y sus claves privadas nunca se almacenan. Esto es algo muy importante porque el control solo importa cuando realmente puedes tocar los datos tú mismo.
Lo que me gusta de OpenGradient es la forma en que divide el trabajo. Los nodos de inferencia realizan el trabajo rápido, los nodos completos verifican las pruebas y mantienen el libro contable honesto, y el almacenamiento se mantiene fuera de la cadena en Walrus para que esta no se infle. Esa estructura se siente más realista que pedirle a cada validador que lo haga todo.
Aun así, lo difícil no es el diagrama. Es la adopción. OpenGradient tiene que convencer a los desarrolladores de que los datos bajo propiedad del usuario valen la pena por las piezas adicionales en movimiento, y de que la gente seguirá usándolo cuando se disipe la novedad. Ahí es donde empieza la prueba real.
Para mí, OpenGradient importa porque está intentando que el control sea práctico, no solo teórico. ¿Ese modelo resistirá cuando empiecen a empujarlo usuarios reales, costos reales e incentivos reales?
@OpenGradient #opg $OPG
#op/usdt
Lo que me gusta de OpenGradient es la forma en que divide el trabajo. Los nodos de inferencia realizan el trabajo rápido, los nodos completos verifican las pruebas y mantienen el libro contable honesto, y el almacenamiento se mantiene fuera de la cadena en Walrus para que esta no se infle. Esa estructura se siente más realista que pedirle a cada validador que lo haga todo.
Aun así, lo difícil no es el diagrama. Es la adopción. OpenGradient tiene que convencer a los desarrolladores de que los datos bajo propiedad del usuario valen la pena por las piezas adicionales en movimiento, y de que la gente seguirá usándolo cuando se disipe la novedad. Ahí es donde empieza la prueba real.
Para mí, OpenGradient importa porque está intentando que el control sea práctico, no solo teórico. ¿Ese modelo resistirá cuando empiecen a empujarlo usuarios reales, costos reales e incentivos reales?
@OpenGradient #opg $OPG
#op/usdt
1
101
·
--
#opg $OPG @OpenGradient
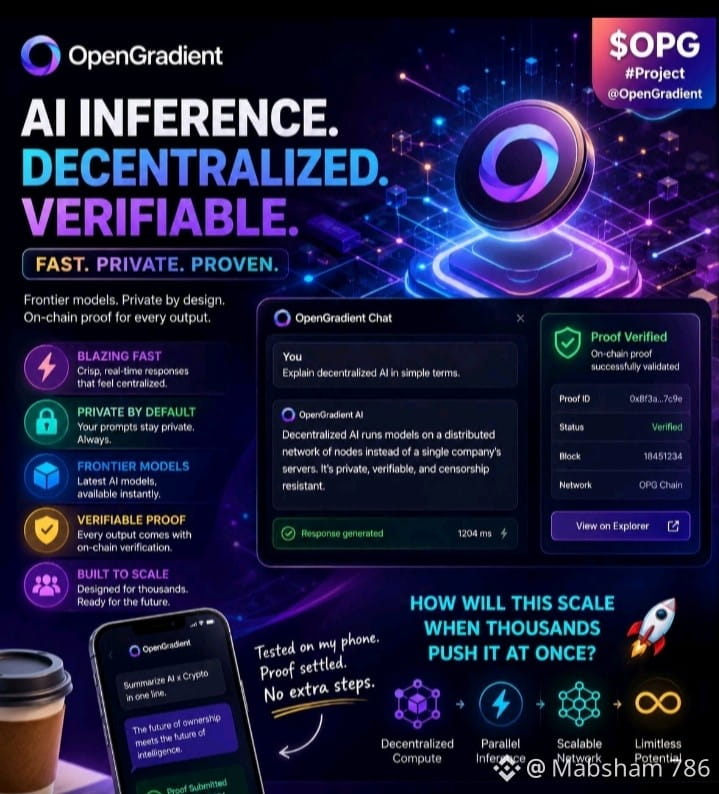
La llamada al modelo no era el problema. El prompt pasó, la forma de la respuesta se veía normal y el notebook seguía comportándose como un flujo de trabajo de ML habitual. Luego apareció la parte del chain. El estado de la wallet, la liquidación del pago, el momento de la confirmación, otra cosa que revisar antes de poder confiar en el resultado.
Ahí es donde normalmente los ingenieros pierden la paciencia.
No porque la inferencia verificada sea inútil. Es más bien que el flujo cambia de identidad de repente. Un minuto estás probando el comportamiento del modelo. Al minuto siguiente estás depurando una infraestructura de la que no querías volverte responsable.
Aquí es donde el SDK de Python de OpenGradient me parece importante. No porque haga que la capa on-chain desaparezca. No lo hace. OPG sigue ahí, gestionando la parte económica de la solicitud. Pero el SDK puede reducir la frecuencia con la que esa capa interrumpe a la persona que intenta construir.
Quizá eso suene pequeño. No creo que lo sea.
En el trabajo de ML, el ritmo importa. Si cada llamada de inferencia obliga a cambiar de contexto hacia wallets, aprobaciones o el seguimiento de transacciones, el mejor sistema de pruebas todavía se siente pesado.
La prueba real es simple: después de que funcione la primera llamada verificada, ¿el ingeniero vuelve por la segunda sin temer la parte del chain?
$OPG
{future}(OPGUSDT)
#opg $OPG @OpenGradient
La llamada al modelo no era el problema. El prompt pasó, la forma de la respuesta se veía normal y el notebook seguía comportándose como un flujo de trabajo de ML habitual. Luego apareció la parte del chain. El estado de la wallet, la liquidación del pago, el momento de la confirmación, otra cosa que revisar antes de poder confiar en el resultado.
Ahí es donde normalmente los ingenieros pierden la paciencia.
No porque la inferencia verificada sea inútil. Es más bien que el flujo cambia de identidad de repente. Un minuto estás probando el comportamiento del modelo. Al minuto siguiente estás depurando una infraestructura de la que no querías volverte responsable.
Aquí es donde el SDK de Python de OpenGradient me parece importante. No porque haga que la capa on-chain desaparezca. No lo hace. OPG sigue ahí, gestionando la parte económica de la solicitud. Pero el SDK puede reducir la frecuencia con la que esa capa interrumpe a la persona que intenta construir.
Quizá eso suene pequeño. No creo que lo sea.
En el trabajo de ML, el ritmo importa. Si cada llamada de inferencia obliga a cambiar de contexto hacia wallets, aprobaciones o el seguimiento de transacciones, el mejor sistema de pruebas todavía se siente pesado.
La prueba real es simple: después de que funcione la primera llamada verificada, ¿el ingeniero vuelve por la segunda sin temer la parte del chain?
$OPG
La llamada al modelo no era el problema. El prompt pasó, la forma de la respuesta se veía normal y el notebook seguía comportándose como un flujo de trabajo de ML habitual. Luego apareció la parte del chain. El estado de la wallet, la liquidación del pago, el momento de la confirmación, otra cosa que revisar antes de poder confiar en el resultado.
Ahí es donde normalmente los ingenieros pierden la paciencia.
No porque la inferencia verificada sea inútil. Es más bien que el flujo cambia de identidad de repente. Un minuto estás probando el comportamiento del modelo. Al minuto siguiente estás depurando una infraestructura de la que no querías volverte responsable.
Aquí es donde el SDK de Python de OpenGradient me parece importante. No porque haga que la capa on-chain desaparezca. No lo hace. OPG sigue ahí, gestionando la parte económica de la solicitud. Pero el SDK puede reducir la frecuencia con la que esa capa interrumpe a la persona que intenta construir.
Quizá eso suene pequeño. No creo que lo sea.
En el trabajo de ML, el ritmo importa. Si cada llamada de inferencia obliga a cambiar de contexto hacia wallets, aprobaciones o el seguimiento de transacciones, el mejor sistema de pruebas todavía se siente pesado.
La prueba real es simple: después de que funcione la primera llamada verificada, ¿el ingeniero vuelve por la segunda sin temer la parte del chain?
$OPG
11
3
142
·
--
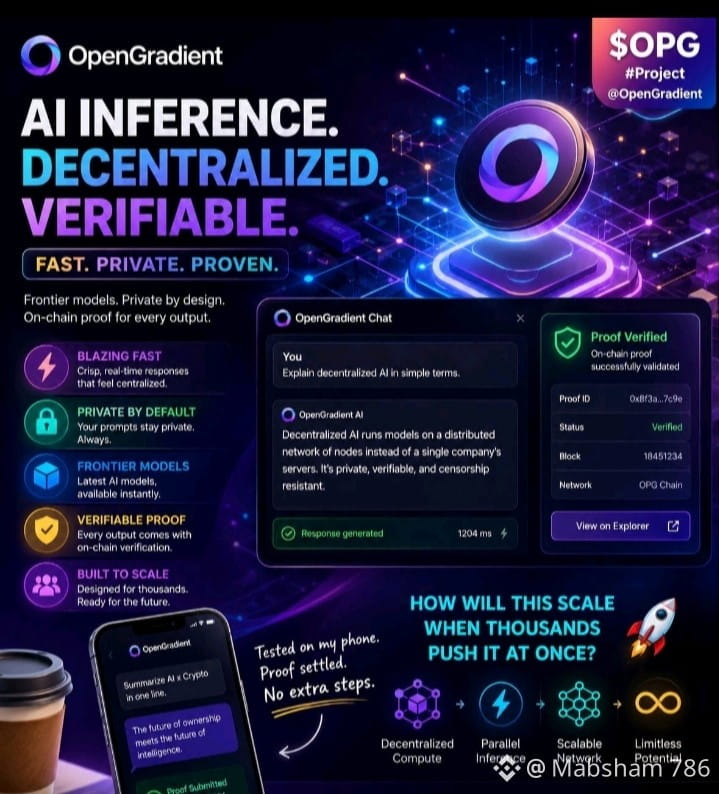
#opg $OPG @OpenGradientLa solicitud falló tres veces en menos de un minuto.
Al principio, culpé a la capacidad. El panel mostraba suficientes nodos de inferencia en línea, así que la explicación obvia era congestión o una mala ruta. No era tan simple.
La mayoría de los nodos disponibles no podía atender esa carga de trabajo exacta. Uno no tenía el modelo requerido. Otro no tenía capacidad libre. Un tercero podía ejecutarlo, pero no a través de la ruta de verificación que la aplicación esperaba.
Suficientes nodos. Aparentemente.
Eso cambió la forma en que miraba la participación de la red OPG. Contar operadores me dice quién está presente. No me dice la probabilidad de que una solicitud en vivo encuentre el modelo correcto, el hardware disponible, una latencia aceptable y una ruta de prueba válida al mismo tiempo.
Incluso esa probabilidad puede verse mejor de lo que realmente es. Varios proveedores pueden parecer independientes mientras comparten una misma región en la nube, una misma dependencia de software o la misma razón económica para apagarse cuando se debilitan las recompensas.
Así que he dejado de tratar la participación como un simple conteo de cabezas. En su lugar, observo las brechas de cobertura: qué cargas de trabajo fallan, cuándo fallan y si los nuevos operadores realmente eliminan una capacidad faltante o solo agregan más capacidad donde la red ya tiene suficiente.
La próxima prueba real no será otro anuncio de crecimiento. Será un pico de demanda, una interrupción regional o un período silencioso en el que los operadores marginales tengan que decidir si seguir disponibles sigue valiendo la pena.$OPG
{future}(OPGUSDT)
#op/usdt
#opg $OPG @OpenGradientLa solicitud falló tres veces en menos de un minuto.
Al principio, culpé a la capacidad. El panel mostraba suficientes nodos de inferencia en línea, así que la explicación obvia era congestión o una mala ruta. No era tan simple.
La mayoría de los nodos disponibles no podía atender esa carga de trabajo exacta. Uno no tenía el modelo requerido. Otro no tenía capacidad libre. Un tercero podía ejecutarlo, pero no a través de la ruta de verificación que la aplicación esperaba.
Suficientes nodos. Aparentemente.
Eso cambió la forma en que miraba la participación de la red OPG. Contar operadores me dice quién está presente. No me dice la probabilidad de que una solicitud en vivo encuentre el modelo correcto, el hardware disponible, una latencia aceptable y una ruta de prueba válida al mismo tiempo.
Incluso esa probabilidad puede verse mejor de lo que realmente es. Varios proveedores pueden parecer independientes mientras comparten una misma región en la nube, una misma dependencia de software o la misma razón económica para apagarse cuando se debilitan las recompensas.
Así que he dejado de tratar la participación como un simple conteo de cabezas. En su lugar, observo las brechas de cobertura: qué cargas de trabajo fallan, cuándo fallan y si los nuevos operadores realmente eliminan una capacidad faltante o solo agregan más capacidad donde la red ya tiene suficiente.
La próxima prueba real no será otro anuncio de crecimiento. Será un pico de demanda, una interrupción regional o un período silencioso en el que los operadores marginales tengan que decidir si seguir disponibles sigue valiendo la pena.$OPG
#op/usdt
Al principio, culpé a la capacidad. El panel mostraba suficientes nodos de inferencia en línea, así que la explicación obvia era congestión o una mala ruta. No era tan simple.
La mayoría de los nodos disponibles no podía atender esa carga de trabajo exacta. Uno no tenía el modelo requerido. Otro no tenía capacidad libre. Un tercero podía ejecutarlo, pero no a través de la ruta de verificación que la aplicación esperaba.
Suficientes nodos. Aparentemente.
Eso cambió la forma en que miraba la participación de la red OPG. Contar operadores me dice quién está presente. No me dice la probabilidad de que una solicitud en vivo encuentre el modelo correcto, el hardware disponible, una latencia aceptable y una ruta de prueba válida al mismo tiempo.
Incluso esa probabilidad puede verse mejor de lo que realmente es. Varios proveedores pueden parecer independientes mientras comparten una misma región en la nube, una misma dependencia de software o la misma razón económica para apagarse cuando se debilitan las recompensas.
Así que he dejado de tratar la participación como un simple conteo de cabezas. En su lugar, observo las brechas de cobertura: qué cargas de trabajo fallan, cuándo fallan y si los nuevos operadores realmente eliminan una capacidad faltante o solo agregan más capacidad donde la red ya tiene suficiente.
La próxima prueba real no será otro anuncio de crecimiento. Será un pico de demanda, una interrupción regional o un período silencioso en el que los operadores marginales tengan que decidir si seguir disponibles sigue valiendo la pena.$OPG
#op/usdt
87
·
--
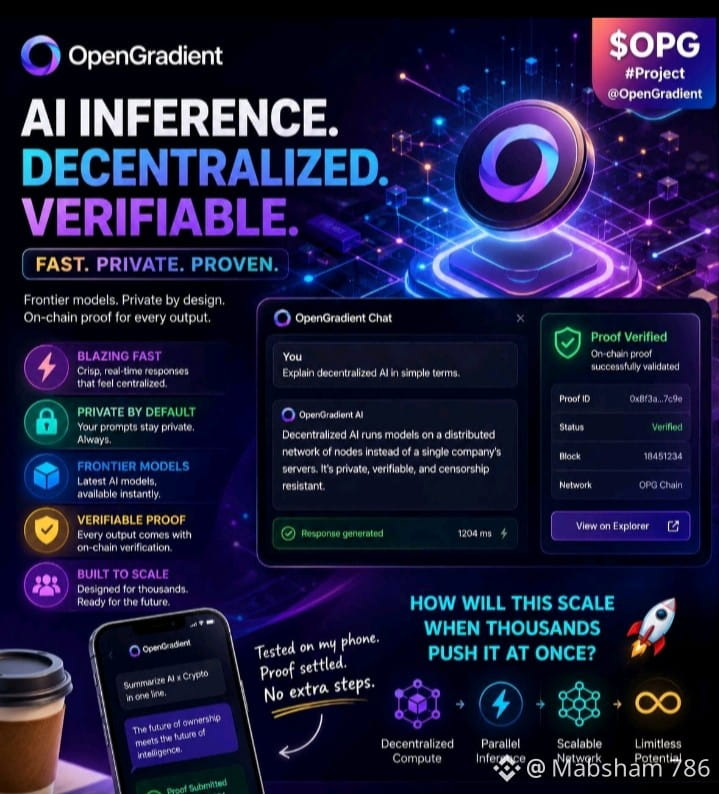
#opg $OPG Sigo mirando OpenGradient como una prueba de si la IA puede ser algo más que una caja negra. Lo que importa para mí no es el eslogan, sino la estructura: la inferencia se ejecuta en nodos especializados, mientras que la verificación se envía a la cadena, para que la gente no tenga que confiar solo en un operador para decir “funcionó”. Eso es algo muy importante en cripto, donde la confianza se rompe rápido cuando el sistema es opaco.
Lo que lo hace interesante es la mezcla de incentivos. Si los nodos tienen que registrarse, demostrar que son honestos y seguir siendo seleccionados para el trabajo, entonces la mala conducta se vuelve más difícil de ocultar. Eso se parece más a un mercado con recibos que a una API cerrada. La configuración primero con TEE para LLM no es perfecta, porque todavía se apoya en la confianza del hardware, pero es un paso práctico si el objetivo es una auditabilidad mejor sin matar la velocidad.
Para mí, la prueba real es la adopción. ¿Pueden los creadores y los usuarios preocuparse lo suficiente por la prueba, la latencia y la fiabilidad como para mantener la actividad fluyendo cuando la novedad se desvanece? Ahí es donde la transparencia o se convierte en una ventaja real, o solo en otra buena idea. ¿Qué piensas? ¿La verificabilidad realmente cambia el comportamiento, o la mayoría de los usuarios todavía eligen el camino más fácil?
@OpenGradient $OPG
{future}(OPGUSDT)
$RE #op/usdt
#opg $OPG Sigo mirando OpenGradient como una prueba de si la IA puede ser algo más que una caja negra. Lo que importa para mí no es el eslogan, sino la estructura: la inferencia se ejecuta en nodos especializados, mientras que la verificación se envía a la cadena, para que la gente no tenga que confiar solo en un operador para decir “funcionó”. Eso es algo muy importante en cripto, donde la confianza se rompe rápido cuando el sistema es opaco.
Lo que lo hace interesante es la mezcla de incentivos. Si los nodos tienen que registrarse, demostrar que son honestos y seguir siendo seleccionados para el trabajo, entonces la mala conducta se vuelve más difícil de ocultar. Eso se parece más a un mercado con recibos que a una API cerrada. La configuración primero con TEE para LLM no es perfecta, porque todavía se apoya en la confianza del hardware, pero es un paso práctico si el objetivo es una auditabilidad mejor sin matar la velocidad.
Para mí, la prueba real es la adopción. ¿Pueden los creadores y los usuarios preocuparse lo suficiente por la prueba, la latencia y la fiabilidad como para mantener la actividad fluyendo cuando la novedad se desvanece? Ahí es donde la transparencia o se convierte en una ventaja real, o solo en otra buena idea. ¿Qué piensas? ¿La verificabilidad realmente cambia el comportamiento, o la mayoría de los usuarios todavía eligen el camino más fácil?
@OpenGradient $OPG
$RE #op/usdt
Lo que lo hace interesante es la mezcla de incentivos. Si los nodos tienen que registrarse, demostrar que son honestos y seguir siendo seleccionados para el trabajo, entonces la mala conducta se vuelve más difícil de ocultar. Eso se parece más a un mercado con recibos que a una API cerrada. La configuración primero con TEE para LLM no es perfecta, porque todavía se apoya en la confianza del hardware, pero es un paso práctico si el objetivo es una auditabilidad mejor sin matar la velocidad.
Para mí, la prueba real es la adopción. ¿Pueden los creadores y los usuarios preocuparse lo suficiente por la prueba, la latencia y la fiabilidad como para mantener la actividad fluyendo cuando la novedad se desvanece? Ahí es donde la transparencia o se convierte en una ventaja real, o solo en otra buena idea. ¿Qué piensas? ¿La verificabilidad realmente cambia el comportamiento, o la mayoría de los usuarios todavía eligen el camino más fácil?
@OpenGradient $OPG
$RE #op/usdt
6
2
214
·
--
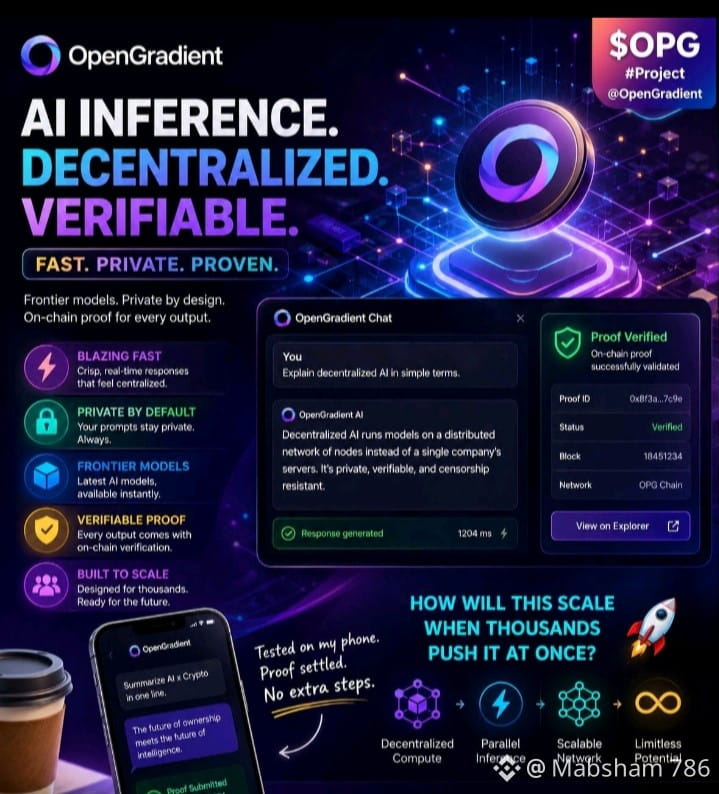
#opg $OPG OpenGradient parece estar compitiendo por desarrolladores.
La red ahora aloja 2.000+ modelos de IA, ha procesado más de 2M inferencias verificables y ha generado más de 500K pruebas criptográficas.
Estos números sugieren que ya hay una actividad significativa ocurriendo bajo la superficie.
Lo que me interesa es de dónde proviene esa actividad.
Los usuarios cambian de aplicaciones todo el tiempo.
Los desarrolladores son más difíciles de mover.
Una vez que un desarrollador se compromete con una capa de infraestructura, las migraciones se vuelven costosas. Se construyen integraciones. Se lanzan productos. Empiezan a formarse dependencias.
Por eso la infraestructura tiende a crear algunos de los efectos de red más fuertes en la tecnología.
La pregunta es si OpenGradient ya está alcanzando esa etapa.
Un creciente repositorio de modelos está animando.
Millones de inferencias están animando.
Pero la adopción se ve muy distinta cuando los desarrolladores empiezan a tratar un protocolo como una necesidad en lugar de una opción.
Esa es la transición que espera lograr cada proyecto de infraestructura.
Lo que aún intento averiguar es si la capa de verificación de OpenGradient simplemente está atrayendo experimentación hoy...
O si gradualmente se está convirtiendo en una pieza de infraestructura que los futuros productos de IA no querrán operar sin.
Porque si es lo segundo, el métrico más importante quizá no sea en absoluto la cantidad de usuarios.
Puede ser el número de desarrolladores que construyen en silencio encima de ello.$OPG
{future}(OPGUSDT)
#op/usdt
#opg $OPG OpenGradient parece estar compitiendo por desarrolladores.
La red ahora aloja 2.000+ modelos de IA, ha procesado más de 2M inferencias verificables y ha generado más de 500K pruebas criptográficas.
Estos números sugieren que ya hay una actividad significativa ocurriendo bajo la superficie.
Lo que me interesa es de dónde proviene esa actividad.
Los usuarios cambian de aplicaciones todo el tiempo.
Los desarrolladores son más difíciles de mover.
Una vez que un desarrollador se compromete con una capa de infraestructura, las migraciones se vuelven costosas. Se construyen integraciones. Se lanzan productos. Empiezan a formarse dependencias.
Por eso la infraestructura tiende a crear algunos de los efectos de red más fuertes en la tecnología.
La pregunta es si OpenGradient ya está alcanzando esa etapa.
Un creciente repositorio de modelos está animando.
Millones de inferencias están animando.
Pero la adopción se ve muy distinta cuando los desarrolladores empiezan a tratar un protocolo como una necesidad en lugar de una opción.
Esa es la transición que espera lograr cada proyecto de infraestructura.
Lo que aún intento averiguar es si la capa de verificación de OpenGradient simplemente está atrayendo experimentación hoy...
O si gradualmente se está convirtiendo en una pieza de infraestructura que los futuros productos de IA no querrán operar sin.
Porque si es lo segundo, el métrico más importante quizá no sea en absoluto la cantidad de usuarios.
Puede ser el número de desarrolladores que construyen en silencio encima de ello.$OPG
#op/usdt
La red ahora aloja 2.000+ modelos de IA, ha procesado más de 2M inferencias verificables y ha generado más de 500K pruebas criptográficas.
Estos números sugieren que ya hay una actividad significativa ocurriendo bajo la superficie.
Lo que me interesa es de dónde proviene esa actividad.
Los usuarios cambian de aplicaciones todo el tiempo.
Los desarrolladores son más difíciles de mover.
Una vez que un desarrollador se compromete con una capa de infraestructura, las migraciones se vuelven costosas. Se construyen integraciones. Se lanzan productos. Empiezan a formarse dependencias.
Por eso la infraestructura tiende a crear algunos de los efectos de red más fuertes en la tecnología.
La pregunta es si OpenGradient ya está alcanzando esa etapa.
Un creciente repositorio de modelos está animando.
Millones de inferencias están animando.
Pero la adopción se ve muy distinta cuando los desarrolladores empiezan a tratar un protocolo como una necesidad en lugar de una opción.
Esa es la transición que espera lograr cada proyecto de infraestructura.
Lo que aún intento averiguar es si la capa de verificación de OpenGradient simplemente está atrayendo experimentación hoy...
O si gradualmente se está convirtiendo en una pieza de infraestructura que los futuros productos de IA no querrán operar sin.
Porque si es lo segundo, el métrico más importante quizá no sea en absoluto la cantidad de usuarios.
Puede ser el número de desarrolladores que construyen en silencio encima de ello.$OPG
#op/usdt
1
120
·
--
#opg $OPG OpenGradient aprovechó el capital restakeado existente de Ethereum a través de EigenLayer para asegurar su capa de inferencia de IA. En papel, eso es un atajo pragmático, pero no estoy completamente seguro de si la seguridad heredada y la seguridad diseñada a medida son realmente equivalentes cuando la carga de trabajo que se verifica es tan impredecible como la inferencia de IA.
Lo que parece interesante es cómo se divide la estructura de nodos debajo de todo esto. Los nodos de inferencia manejan la computación pesada en GPU, los nodos completos verifican las pruebas criptográficas resultantes en consenso, y los nodos de datos suministran información externa en tiempo real dentro de entornos de ejecución confiables. Tres roles distintos, cada uno con diferentes requisitos de hardware y diferentes modos de falla. Me hace pensar en cómo se ve realmente la coordinación cuando una capa experimenta un rendimiento degradado — ¿acelera todo el pipeline de manera suave, o un cuello de botella en un tipo de nodo crea problemas en cascada que el modelo de restaking no estaba realmente diseñado para absorber?
La pregunta que viene a la mente es qué pasa con los restakers de EigenLayer si el AVS de OpenGradient introduce condiciones de slashing que no modelaron completamente al delegar. Los restakers delegan a operadores que seleccionan qué servicios apoyar, y esa cadena de decisiones conlleva un riesgo real de capital. Mirando desde afuera, la mayoría de los restakers probablemente no están leyendo las especificaciones de verificación de inferencia de IA antes de delegar — están confiando en el juicio de su operador, lo que introduce una capa de suposición que se sienta silenciosamente debajo del modelo de seguridad.$OPG
{future}(OPGUSDT)
#op/usdt
#opg $OPG OpenGradient aprovechó el capital restakeado existente de Ethereum a través de EigenLayer para asegurar su capa de inferencia de IA. En papel, eso es un atajo pragmático, pero no estoy completamente seguro de si la seguridad heredada y la seguridad diseñada a medida son realmente equivalentes cuando la carga de trabajo que se verifica es tan impredecible como la inferencia de IA.
Lo que parece interesante es cómo se divide la estructura de nodos debajo de todo esto. Los nodos de inferencia manejan la computación pesada en GPU, los nodos completos verifican las pruebas criptográficas resultantes en consenso, y los nodos de datos suministran información externa en tiempo real dentro de entornos de ejecución confiables. Tres roles distintos, cada uno con diferentes requisitos de hardware y diferentes modos de falla. Me hace pensar en cómo se ve realmente la coordinación cuando una capa experimenta un rendimiento degradado — ¿acelera todo el pipeline de manera suave, o un cuello de botella en un tipo de nodo crea problemas en cascada que el modelo de restaking no estaba realmente diseñado para absorber?
La pregunta que viene a la mente es qué pasa con los restakers de EigenLayer si el AVS de OpenGradient introduce condiciones de slashing que no modelaron completamente al delegar. Los restakers delegan a operadores que seleccionan qué servicios apoyar, y esa cadena de decisiones conlleva un riesgo real de capital. Mirando desde afuera, la mayoría de los restakers probablemente no están leyendo las especificaciones de verificación de inferencia de IA antes de delegar — están confiando en el juicio de su operador, lo que introduce una capa de suposición que se sienta silenciosamente debajo del modelo de seguridad.$OPG
#op/usdt
Lo que parece interesante es cómo se divide la estructura de nodos debajo de todo esto. Los nodos de inferencia manejan la computación pesada en GPU, los nodos completos verifican las pruebas criptográficas resultantes en consenso, y los nodos de datos suministran información externa en tiempo real dentro de entornos de ejecución confiables. Tres roles distintos, cada uno con diferentes requisitos de hardware y diferentes modos de falla. Me hace pensar en cómo se ve realmente la coordinación cuando una capa experimenta un rendimiento degradado — ¿acelera todo el pipeline de manera suave, o un cuello de botella en un tipo de nodo crea problemas en cascada que el modelo de restaking no estaba realmente diseñado para absorber?
La pregunta que viene a la mente es qué pasa con los restakers de EigenLayer si el AVS de OpenGradient introduce condiciones de slashing que no modelaron completamente al delegar. Los restakers delegan a operadores que seleccionan qué servicios apoyar, y esa cadena de decisiones conlleva un riesgo real de capital. Mirando desde afuera, la mayoría de los restakers probablemente no están leyendo las especificaciones de verificación de inferencia de IA antes de delegar — están confiando en el juicio de su operador, lo que introduce una capa de suposición que se sienta silenciosamente debajo del modelo de seguridad.$OPG
#op/usdt
84
·
--
#opg $OPG
{future}(OPGUSDT)
$OPG es una organización creativa y profesional que se enfoca en ofrecer soluciones relevantes para su audiencia. Su creatividad ayuda a generar nuevas ideas, enfoques innovadores y oportunidades únicas para el crecimiento. A través de un estilo de trabajo profesional,$OPG mantiene altos estándares, fiabilidad y calidad en todo lo que hace. La organización valora el trabajo en equipo, la responsabilidad y la comunicación efectiva para alcanzar sus objetivos. Lo más importante, opg se mantiene relevante al comprender las tendencias actuales, las necesidades del cliente y las demandas del mercado. Al combinar creatividad, profesionalismo y relevancia, opg continúa creando valor, construyendo confianza y logrando el éxito mientras se adapta a entornos cambiantes y desafíos futuros.#op/usdt
#opg $OPG
$OPG es una organización creativa y profesional que se enfoca en ofrecer soluciones relevantes para su audiencia. Su creatividad ayuda a generar nuevas ideas, enfoques innovadores y oportunidades únicas para el crecimiento. A través de un estilo de trabajo profesional,$OPG mantiene altos estándares, fiabilidad y calidad en todo lo que hace. La organización valora el trabajo en equipo, la responsabilidad y la comunicación efectiva para alcanzar sus objetivos. Lo más importante, opg se mantiene relevante al comprender las tendencias actuales, las necesidades del cliente y las demandas del mercado. Al combinar creatividad, profesionalismo y relevancia, opg continúa creando valor, construyendo confianza y logrando el éxito mientras se adapta a entornos cambiantes y desafíos futuros.#op/usdt
$OPG es una organización creativa y profesional que se enfoca en ofrecer soluciones relevantes para su audiencia. Su creatividad ayuda a generar nuevas ideas, enfoques innovadores y oportunidades únicas para el crecimiento. A través de un estilo de trabajo profesional,$OPG mantiene altos estándares, fiabilidad y calidad en todo lo que hace. La organización valora el trabajo en equipo, la responsabilidad y la comunicación efectiva para alcanzar sus objetivos. Lo más importante, opg se mantiene relevante al comprender las tendencias actuales, las necesidades del cliente y las demandas del mercado. Al combinar creatividad, profesionalismo y relevancia, opg continúa creando valor, construyendo confianza y logrando el éxito mientras se adapta a entornos cambiantes y desafíos futuros.#op/usdt
89
Inicia sesión para explorar más contenidos
Únete a usuarios de criptomonedas de todo el mundo en Binance Square
⚡️ Obtén la información más reciente y útil sobre criptomonedas.
💬 Confía en el mayor exchange de criptomonedas del mundo.
👍 Descubre opiniones reales de creadores verificados.
Correo electrónico/número de teléfono
Temas en tendencia
BinanceSAFUFundTransferCompleted7499BTC
33,042 visualizaciones
724 participa(n) en el debate
Binance informa que se completó la transferencia del fondo SAFU, por un total de 7.499 BTC
Binance News
·43 «Me gusta»
·23.2k visualizaciones
BinanceRecovery90% of stolen assets
127,281 visualizaciones
162 participa(n) en el debate
YiHe:ProofOfReserves:10TokensAt100%Backing
129,455 visualizaciones
711 participa(n) en el debate