


Título original: (La gran migración de la IA en China)
Autor original: Sleepy
En la historia industrial hay una规律: cuanto más se acerca un cambio de generación, más claramente se ve dónde crece realmente una tecnología.
En la Gran Bretaña de las décadas de 1760 y 1770, acababan de inventar la hiladora hidráulica y los propietarios de fábricas se dirigían al norte, a los valles fluviales de Derbyshire y Lancashire, a ambos lados de los Peninos. En aquella época, la máquina de vapor de Watt aún no había llegado a las fábricas textiles; las ruedas hidráulicas seguían siendo las que movían los husos. Unas décadas después, cuando la máquina de vapor se generalizó, las fábricas fueron trasladándose poco a poco de los valles a las cuencas carboníferas y a las afueras de las ciudades.
Cada cambio tecnológico empieza con la invención de un algoritmo, un plano o una máquina, y enseguida da paso a una gran migración geográfica en busca de electricidad, agua y terrenos.
Cuando todo está en calma, la cadena de suministro global parece una red extendida y plana: se puede acceder a la capacidad de cómputo incluso al otro lado del Pacífico, y es fácil hacerse la ilusión de que el software y la inteligencia no tienen peso ni dependen del lugar donde se desarrollan. Pero cuando llegan los bloqueos y los cercos, la nube vuelve a tocar tierra y muestra su verdadera naturaleza de industria pesada: necesita electricidad, teme al calor, depende de las conexiones y, sobre todo, de quién es dueño de los chips de cada fila de servidores.
El 16 de octubre de 1964, China detonó con éxito su primera bomba atómica en Lop Nur, bajo el nombre en clave «596». Cinco años antes, el 20 de junio de 1959, el Comité Central del Partido Comunista de la Unión Soviética escribió al Comité Central del Partido Comunista de China para aplazar la entrega de los modelos didácticos y los planos de la bomba atómica acordados en el convenio.
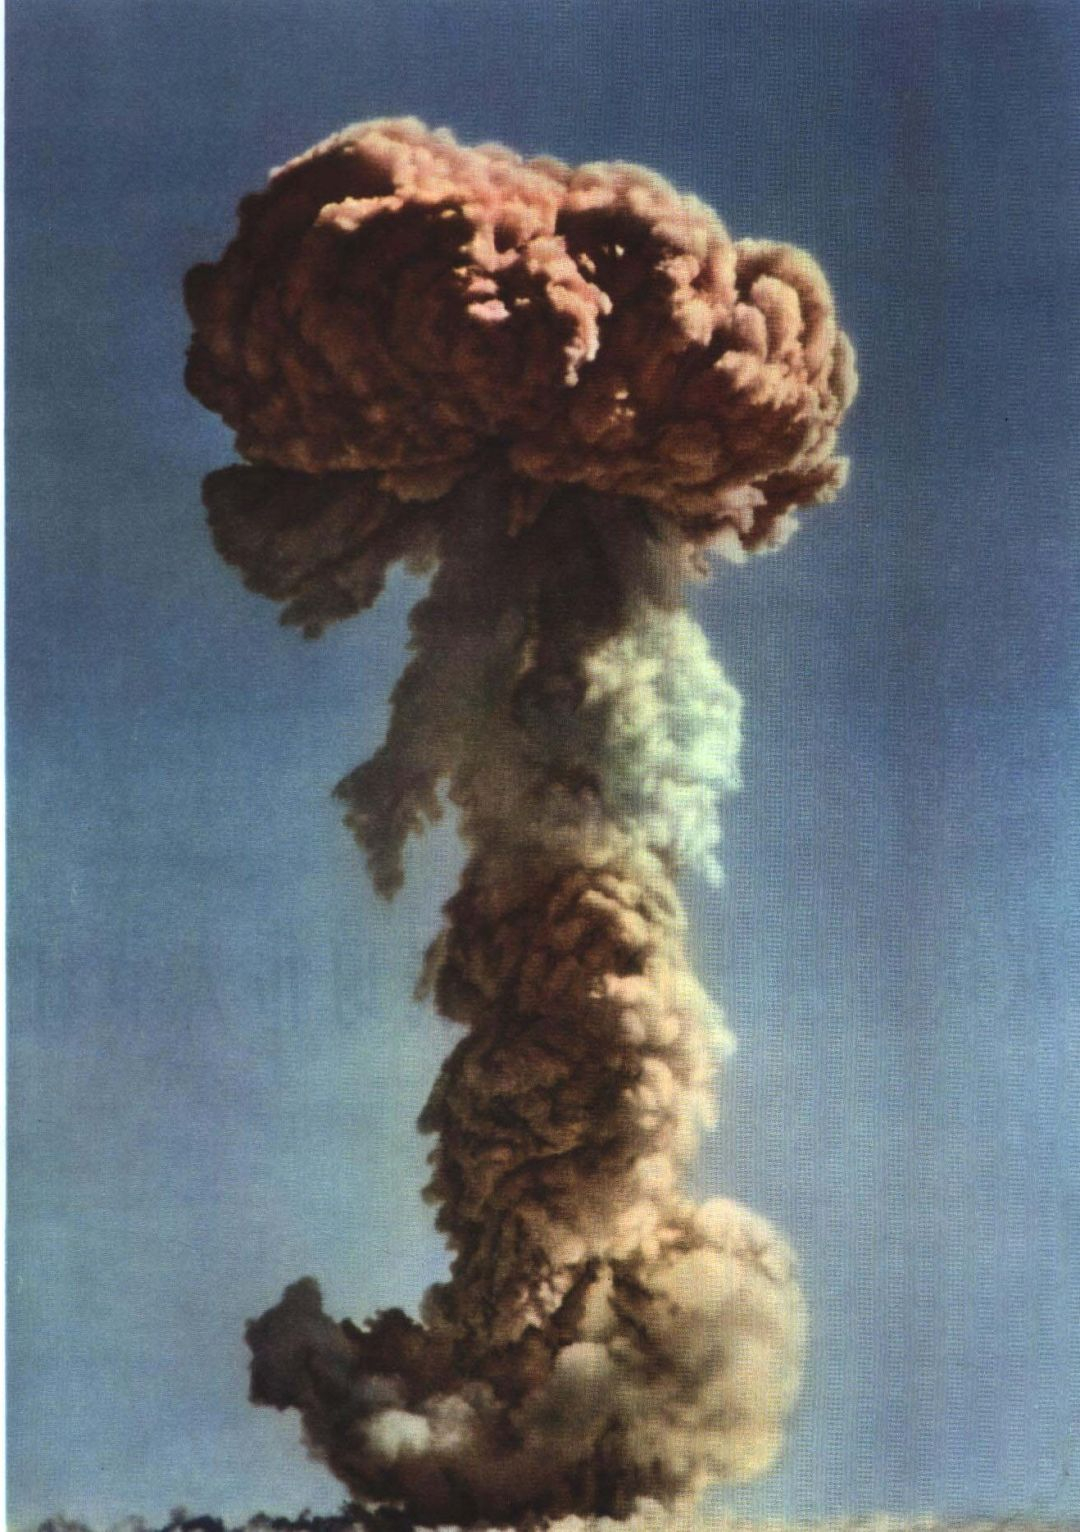
Nube en forma de hongo de la explosión de la primera bomba atómica china en Lop Nur, 1964|Fuente: People's Pictorial
Casi ese mismo otoño se establecieron los criterios para elegir las ubicaciones del Tercer Frente: cerca de las montañas, dispersas y ocultas. Al ejecutarlos se añadieron dos palabras: «entrar en cuevas». Durante los quince años siguientes, millones de trabajadores, cuadros, intelectuales y soldados del Ejército Popular de Liberación dejaron las ciudades del este y del nordeste y trasladaron máquinas herramienta, altos hornos y laboratorios a las montañas del suroeste y el noroeste. En el momento de mayor actividad, participaron más de cuatro millones de personas.
Más de medio siglo después, la industria más avanzada del mundo se había transformado en grandes modelos.
Quienes entrenan grandes modelos tienen una tarea diaria obligatoria: guardar checkpoints. Miles o decenas de miles de tarjetas aceleradoras funcionan conectadas durante meses; si una sola se desconecta, el entrenamiento se interrumpe. Por eso, a intervalos regulares se guardan todos los pesos del modelo, el estado del optimizador y las semillas aleatorias, para poder reanudar desde el último punto guardado si algo sale mal.
En inglés, esta palabra también tiene un significado original: puesto de control fronterizo.
En noviembre de 2026, tras una larga búsqueda de tarjetas que cruzó el ecuador, el sector chino de grandes modelos llegó a su propio puesto de control.
60 discos duros
La historia empieza con cuatro maletas que volaban a Kuala Lumpur.
A principios de marzo de 2025, cuatro ingenieros chinos volaron de Pekín a Malasia. Cada uno llevaba una maleta en la que había colocado ordenadamente 15 discos duros; entre todos transportaban 80 TB de datos.
Su destino era un centro de datos local de Malasia, donde su empleador había alquilado unas 300 máquinas con servidores equipados con chips avanzados de Nvidia.
Para este viaje, los colegas en China empezaron con más de ocho semanas de antelación a pulir el conjunto de datos y ajustar una y otra vez los programas de entrenamiento. Una vez que los datos se meten en cajas y salen del país, es muy difícil volver a empezar desde cero como se haría en China, ya en un centro de datos en el extranjero. ¿Y por qué no enviarlos por internet? Porque la transmisión por la red «podría tardar meses»; era más rápido llevarlos en persona.
Según el plan, lo que finalmente traerían de vuelta a China sería mucho más pequeño: solo unos cientos de GB, los parámetros del modelo ya entrenado.
Este es el corte más primitivo de la primera migración de capacidad de cómputo de los grandes modelos chinos: como no podían entrar las tarjetas, los datos salieron en avión.
Lo que obligó a los ingenieros a subirse a un avión fueron las restricciones a los chips, cada vez más estrictas año tras año.
El 7 de octubre de 2022, Estados Unidos prohibió por primera vez la venta de las Nvidia A100 y H100 a China; Nvidia no tardó en crear para el mercado chino las A800 y H800, con menor ancho de banda de interconexión. Apenas un año después, el 17 de octubre de 2023, las versiones ralentizadas también quedaron excluidas.
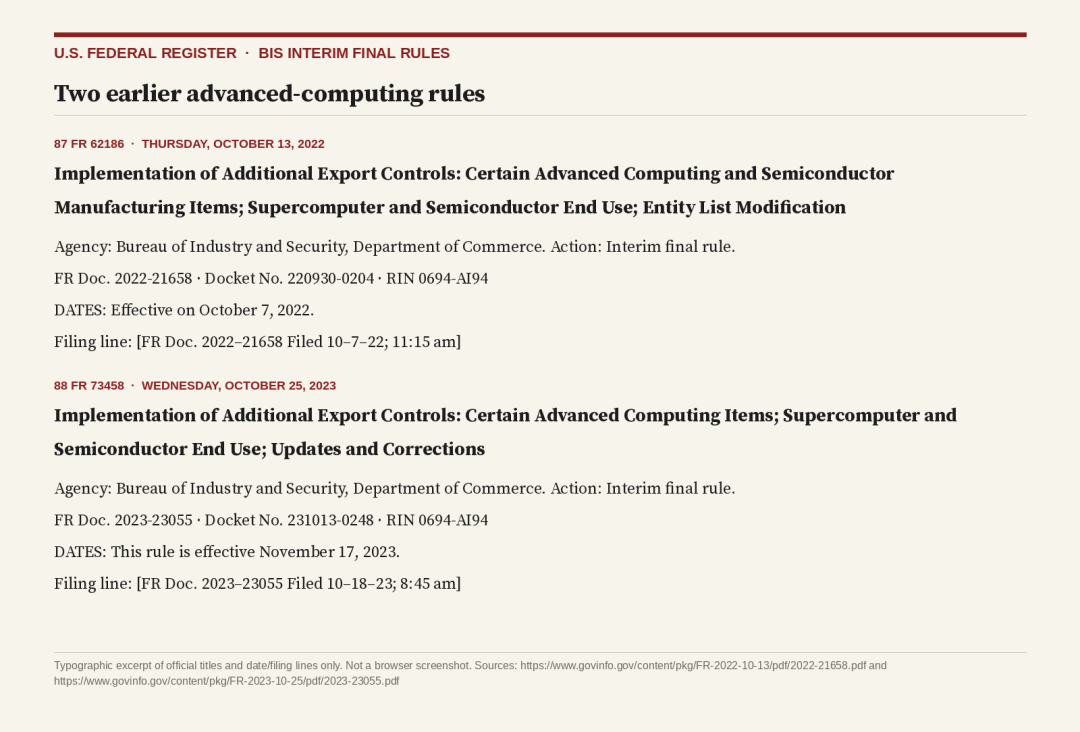
Normas estadounidenses de control de las exportaciones de chips de computación avanzada de 2022 y 2023|Fuente: sitio web oficial del Gobierno
Ese año, en el mercado chino era casi imposible conseguir una tarjeta. El precio de la A100 pasó de unos 40.000 yuanes a principios de año a casi 250.000; en la semana posterior a la entrada en vigor de las nuevas normas de octubre, la cotización de la H800 casi se duplicó y los distribuidores llegaron a pedir 2,45 millones de yuanes por un servidor completo de ocho tarjetas.
Al mismo tiempo, la infraestructura de computación de China atravesó una oleada de nacimientos prematuros. Entre 2023 y 2024, distintas regiones anunciaron más de 500 proyectos de centros de computación inteligente; a finales de 2024, al menos 150 ya estaban operativos.
Por un lado, los laboratorios tenían dinero en efectivo, pero no podían comprar tarjetas; por otro, los centros de datos de distintas regiones estaban vacíos. La causa era el umbral físico del entrenamiento de grandes modelos: los modelos de vanguardia necesitan decenas de miles de tarjetas de gama alta de una misma generación, conectadas mediante redes de alta velocidad para formar un gran clúster. En cambio, en los centros de datos repartidos por el país predominaban las tarjetas de inferencia dispersas y anticuadas, incapaces de conectarse entre sí, o las GPU de la generación anterior.
Por suerte, las restricciones estadounidenses a la exportación de entonces dejaban una rendija: regulaban la compraventa, pero no el alquiler.
Las empresas con sede en China no podían comprar chips para introducirlos en el país, pero sí alquilar centros de datos de proveedores de nube extranjeros y de propietarios no chinos. El sector pronto encontró un modo de repartirse el trabajo: el preentrenamiento, que requiere más capacidad de cómputo y un gran ancho de banda para la comunicación entre clústeres, se hacía en centros de datos en el extranjero; una vez entrenado el modelo, se traían sus pesos a China y se utilizaban los recursos de computación nacionales para atender las consultas cotidianas de los usuarios.
La ruta ya estaba abierta y el rudimentario método de las maletas pronto fue sustituido por la moderna infraestructura en la nube.
Más adelante, los ingenieros ya ni siquiera tuvieron que salir del país. Los clústeres de entrenamiento se quedaron en centros de datos del Sudeste Asiático o del norte de Europa, mientras los equipos de algoritmos iniciaban sesión a distancia desde sus puestos en Haidian, Pekín; Yuhang, Hangzhou; o Xuhui, Shanghái, y escribían línea tras línea los comandos de arranque en la terminal.
Las plantaciones de palma aceitera de Johor
En el cielo del planeta hay un corredor invisible llamado «la ruta migratoria de Asia Oriental-Australasia».
Parte del extremo oriental de Rusia y de Alaska, cruza Asia Oriental y el Sudeste Asiático y se extiende hasta Australia y Nueva Zelanda. Atraviesa 22 países y cada año más de 50 millones de aves acuáticas la recorren en sus migraciones hacia el sur y el norte. Los humedales de manglar de la costa suroeste del estado malasio de Johor son uno de sus lugares de descanso; Tanjung Piai, allí situado, es el punto más meridional de la Asia continental.
En los últimos cinco años, una nueva especie de ave migratoria de silicio se ha sumado a esta ruta.
Johor y Singapur están separados únicamente por el estrecho de Johor, una franja angosta de agua. Estas tierras rojizas han cambiado de cultivo varias veces. En la década de 1940, clanes chinos llegados desde Singapur cruzaron el mar, talaron la selva tropical y plantaron pimienta y gambier; con la llegada de los colonizadores británicos, los cultivos se transformaron en caucho; en la segunda mitad del siglo XX, las colinas quedaron cubiertas de palmas aceiteras.
Hoy, las excavadoras han arrasado extensiones enteras de palmas aceiteras para plantar el cuarto cultivo económico de Johor: centros de datos.
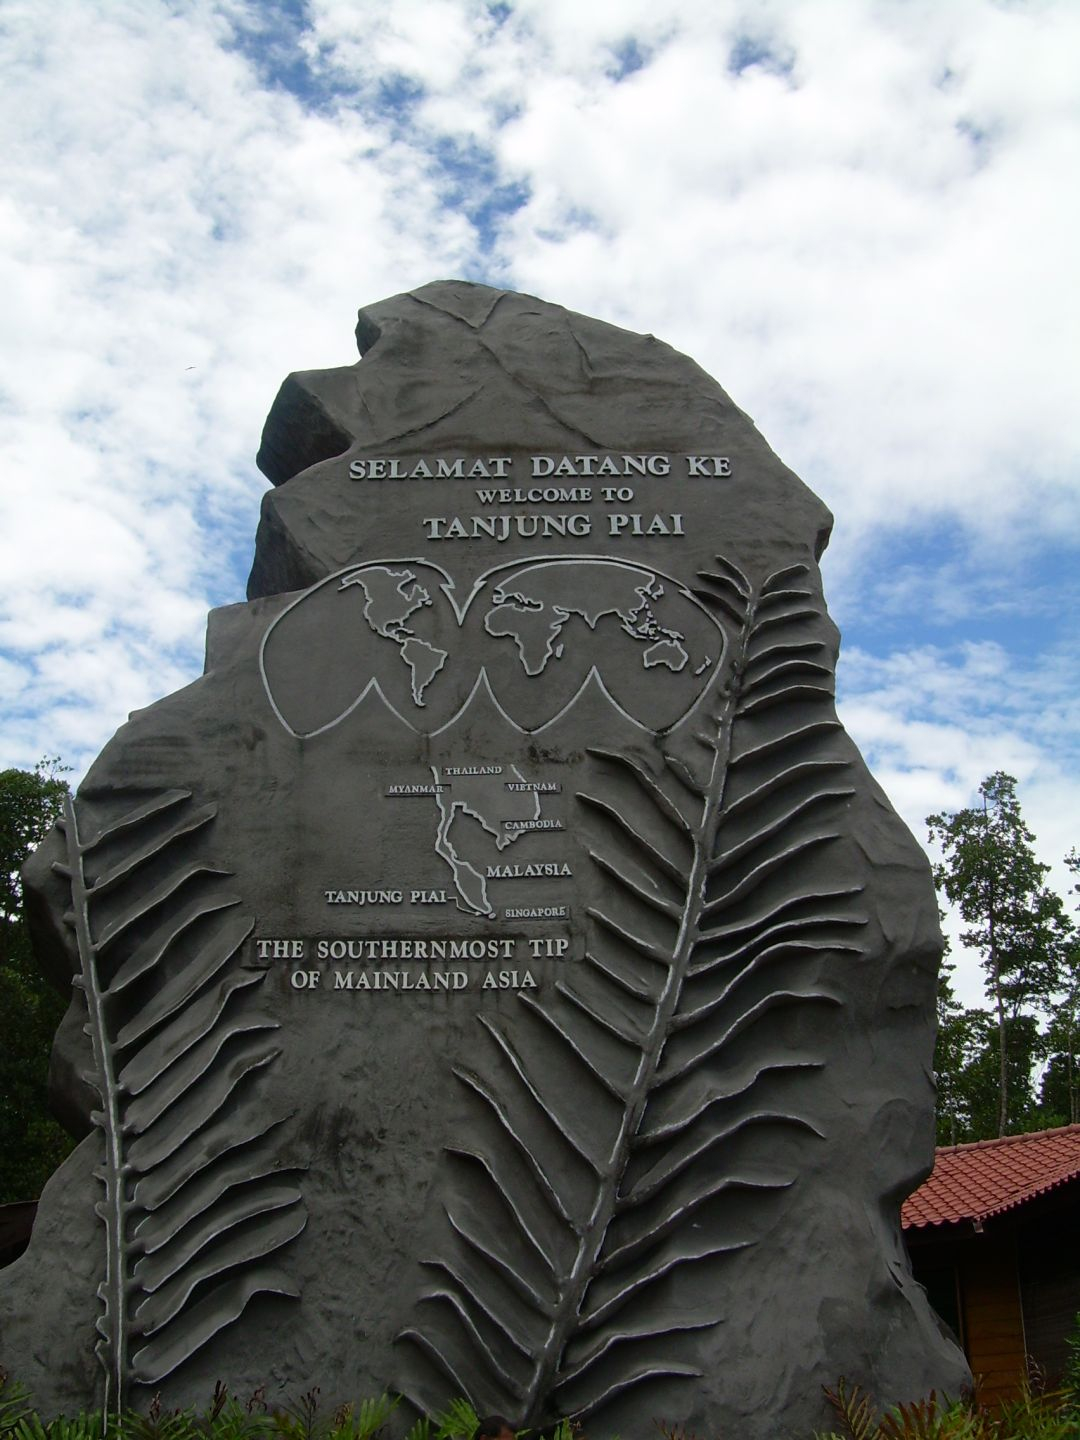
Monumento que marca el punto más meridional de la Asia continental, Tanjung Piai, Johor|Fuente: D.W. Fisher-Freberg
En 2021, la carga de TI en línea de todo el estado de Johor apenas llegaba a 10 MW. A finales de 2025, había superado los 900 MW.
Lo que atraía a las empresas era la enorme diferencia en el coste de los factores de producción a ambos lados del estrecho.
Singapur tiene poco suelo y la electricidad es cara; entre 2019 y 2022 suspendió la aprobación de nuevos centros de datos. En el parque tecnológico de Sedenak, en Johor, al otro lado del estrecho, el terreno cuesta solo 5,12 dólares singapurenses por pie cuadrado, frente a unos 6.000 en la zona de Tai Seng, en Singapur; y la electricidad en Johor cuesta aproximadamente la mitad que en Singapur.
Lo que más sorprendía a sus homólogos extranjeros era la velocidad de entrega de los equipos chinos de infraestructura. Los operadores con capital chino conseguían terrenos en Johor, los nivelaban, instalaban el tendido eléctrico y el sistema de refrigeración, y en nueve a doce meses podían encender las luces y entregar el centro de datos. DayOne y Bridge Data Centres —que se fusionó con ChinData y ahora pertenece a capital estadounidense— sumaban al menos el 58 % de la capacidad de TI en línea de Johor. Y, entre los operadores con capital chino de Johor, el mayor cliente era ByteDance.
El puesto de control de la calzada que conecta Johor Bahru con Woodlands, en Singapur, revisa los documentos de cientos de miles de personas cada día. Es uno de los pasos fronterizos terrestres más transitados del mundo y el checkpoint físico más conocido de la zona; mientras tanto, en los centros de datos a ambos lados del estrecho, otro tipo de checkpoint se va guardando, archivo tras archivo, en discos duros.
En noviembre de 2025, el Financial Times informó de que Alibaba y ByteDance entrenaban sus modelos más recientes en centros de datos del Sudeste Asiático con contratos de alquiler de propietarios no chinos. Un operador de centros de datos de Singapur explicó entonces a los medios: «Entrenar los modelos más avanzados requiere los mejores chips, y todo es legal y cumple las normas».
El centro de estudios estadounidense IFP calculó que, a finales de 2026, las empresas chinas podrían movilizar mediante acceso remoto desde el extranjero una capacidad equivalente a un millón de H100, de la cual alrededor del 75 % estaría en el Sudeste Asiático. Desde 2021, Malasia ha aprobado inversiones en centros de datos por un total acumulado de 95.000 millones de dólares.
El equipo que llegó más lejos alcanzó los confines del círculo polar ártico. Desde mayo de 2025, una filial extranjera de ByteDance alquiló 2.304 chips Nvidia B200 en el pequeño pueblo noruego de Glomfjord, entre sus fiordos. Allí la energía proviene de la hidroeléctrica y el clima se mantiene frío todo el año. Ese único contrato de ByteDance representó cerca de tres cuartas partes de los ingresos de aquella neocloud europea en ese año.
Pero todos sabían que un techo prestado no protege de la lluvia para siempre.
Las aves migratorias vuelan hacia el sur, pero nunca para establecerse allí.
Las dos empresas, en 2025
Ante el cerco a la capacidad de cómputo, entre 2025 y 2026 las dos empresas chinas de grandes modelos más representativas, Kimi y DeepSeek, siguieron caminos distintos.
En la ruta hacia el sur en busca de tarjetas, Moonshot AI fue la que más se esforzó. Según una persona informada, su búsqueda mundial de capacidad de cómputo fue «muy agresiva».
En julio de 2025, Moonshot AI lanzó K2, con un billón de parámetros, y completó el preentrenamiento con 15,5 billones de tokens usando su optimizador propio MuonClip. Un año después, el 16 de julio de 2026, presentó oficialmente K3, cuyo total de parámetros ascendía a 2,8 billones, convirtiéndolo en el primer modelo de pesos abiertos del mundo de la categoría de 3T.
Al evaluar K3, el investigador estadounidense de IA Nathan Lambert señaló expresamente que el modelo se había creado «en un entorno con limitaciones de GPU». En una conversación con investigadores de Kimi, mencionó medio en broma que en OpenAI un investigador corriente podría tener a su disposición «miles de máquinas equivalentes a H100», y que sus interlocutores «se quedaron atónitos».
Con muchas menos tarjetas que sus homólogos de Silicon Valley, los equipos chinos produjeron resultados que no podían ignorarse al otro lado del océano. Un informe empresarial publicado en noviembre de 2026 por la firma de capital riesgo de Silicon Valley Menlo Ventures reveló que el 89 % del gasto de las empresas estadounidenses en grandes modelos de código abierto se destinaba a modelos chinos; Kimi, por sí sola, se llevaba el 61 %.
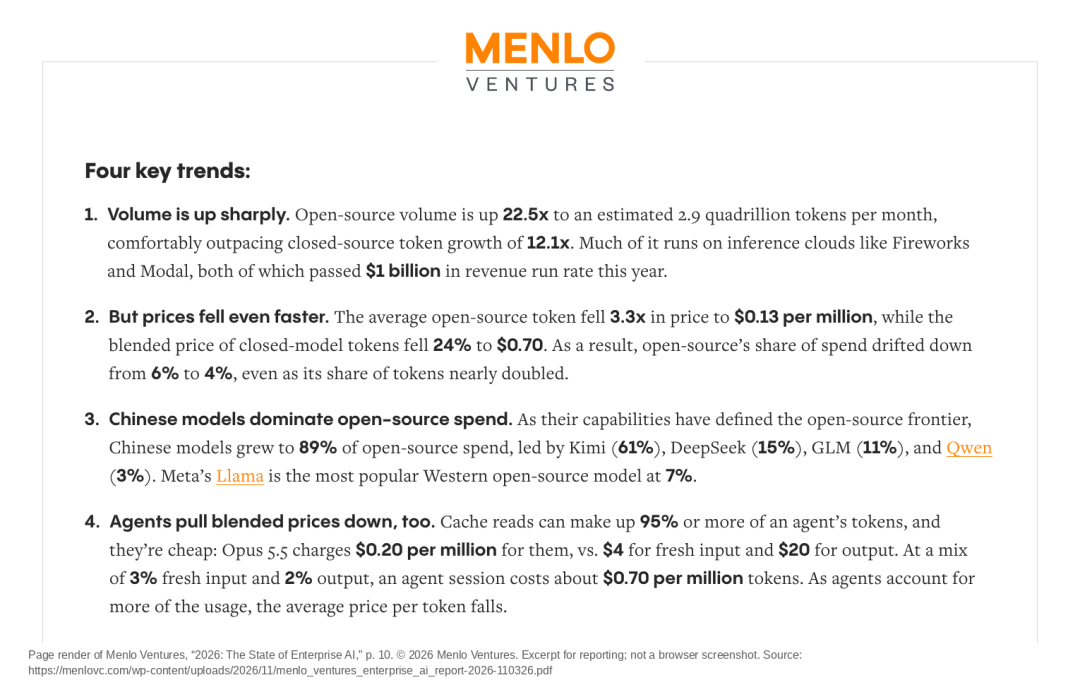
Informe de IA empresarial de Menlo Ventures 2026|Fuente: Menlo Ventures
Cuando un modelo es demasiado potente, el problema más inmediato es quedarse sin tarjetas.
Apenas tres días después del lanzamiento de K3, el 19 de julio, Kimi publicó una nota oficial sobre la escasez de capacidad de cómputo y la suspensión temporal de nuevas suscripciones. Indicaba que, durante las 48 horas anteriores, las solicitudes de los usuarios habían superado con creces las previsiones y se acercaban al límite de capacidad del clúster existente. Tuvieron que cerrar temporalmente el canal para nuevos miembros y esperar a que llegara una nueva partida de capacidad para reabrirlo por tandas.
Para aliviar la presión sobre los clústeres de inferencia, Moonshot AI recurrió a todas las opciones imaginables. Acordó con varios proveedores de nube estadounidenses compartir los ingresos del alojamiento de K3 y aprovechó la ventaja de sus pesos abiertos para que los proveedores extranjeros usaran sus propias GPU y atendieran, en nombre de Kimi, a los clientes empresariales de otros países.
Pero el preentrenamiento del modelo insignia de la siguiente generación no se podía resolver desviando solicitudes. Según informó The Information a finales de julio, el K4 previsto sería mucho mayor que K3. Moonshot AI puso la mira en Indonesia, firmó un contrato de alquiler por un total aproximado de 150 millones de dólares y reservó un clúster de chips Nvidia Blackwell Ultra B300 en un centro de datos indonesio, con la intención de ponerlo en marcha como pronto en 2027. Según los informes, esas tarjetas estaban destinadas precisamente a K4.
Mientras Moonshot AI buscaba tarjetas por todo el Sudeste Asiático, DeepSeek, desde Hangzhou, eligió otro camino.
En julio de 2024, Liang Wenfeng dijo en una entrevista con Dark Matter: «El problema al que nos enfrentamos nunca ha sido el dinero, sino el embargo de los chips de gama alta».
A finales de ese año, DeepSeek lanzó V3, entrenado con 2.048 H800. El coste total de la última etapa de entrenamiento fue de apenas unos 5,576 millones de dólares. El informe técnico señaló que durante todo el proceso «no hubo ningún pico de pérdida irrecuperable ni se realizó ninguna reversión».
DeepSeek R1 se lanzó el 20 de enero de 2025 y sacudió al mundo con sus capacidades de razonamiento impulsadas por el aprendizaje por refuerzo. Sin embargo, después de R1, mientras sus homólogos alquilaban tarjetas en el extranjero, DeepSeek no trasladó su entrenamiento principal fuera del país. Un informe del Financial Times de noviembre de 2025 reveló que DeepSeek insistía en entrenar en China y que ingenieros de Huawei trabajaban de manera permanente en su sede de Hangzhou.
El precio de quedarse fue soportar dificultades y esperas muy reales.
En 2025, Huawei envió un equipo de ingenieros a las oficinas de DeepSeek para ayudarla a entrenar el modelo de razonamiento de siguiente generación, R2, con chips Ascend de fabricación nacional. Según el Financial Times, el entrenamiento tropezó con problemas de estabilidad, software y lentitud en la comunicación entre chips; el lanzamiento de R2 se aplazó una y otra vez, y también se retrasó el calendario de entrenamiento de los modelos de generación multimodal.
Desde fuera solo se veía que DeepSeek había ralentizado el paso; pocos entendieron los preparativos que estaba haciendo bajo la superficie.
En agosto de 2025, DeepSeek lanzó la versión de transición V3.1 y escribió en las notas de lanzamiento que el formato de precisión UE8M0 FP8 utilizado por el modelo se había diseñado específicamente para «la próxima generación de chips nacionales, cuyo lanzamiento es inminente».
El 24 de abril de 2026, el largamente perfeccionado DeepSeek V4 por fin salió al mercado. En el anuncio, la empresa dijo que, debido a las limitaciones de capacidad de cómputo de gama alta, el rendimiento del servicio V4-Pro sería limitado, y que los precios bajarían una vez que los supernodos Ascend 950 empezaran a comercializarse en masa durante el segundo semestre.
Al mirar atrás desde aquel momento del otoño de 2026, una empresa había buscado tarjetas por todas partes y había llevado su modelo a las herramientas de desarrolladores de todo el mundo; otra se había quedado en China, perseverando en la arquitectura de base y abriendo camino para los grandes clústeres nacionales. Juntas, ambas rutas formaban las dos alas de la IA china durante la transición.
Hasta que Washington decidió soldar por completo aquella puerta al extranjero.
Las 16:15
Durante las dos primeras semanas de noviembre de 2026, las puertas se cerraron una tras otra.
Primero llegaron los avisos verbales. El 3 de noviembre, el Financial Times reveló que el equipo de ventas de Nvidia había empezado a comunicar verbalmente a sus socios mundiales de servicios en la nube que, en los nuevos contratos, al menos el 51 % de la capacidad debía venderse a clientes no chinos. El requisito no quedó por escrito, pero dejó perplejos a los propietarios de centros de datos del Sudeste Asiático: fuera de Estados Unidos, ¿dónde iban a encontrar tantos clientes no chinos?
Al día siguiente, el 4 de noviembre, Oracle canceló un contrato de alquiler de gran escala que tenía con Tencent en el Sudeste Asiático. Era un acuerdo de cinco años, por un valor total aproximado de 7.000 millones de dólares, que incluía alrededor de 100.000 chips. Se vino abajo porque funcionarios estadounidenses expresaron su oposición.
El 12 de noviembre, Jensen Huang, al frente de Nvidia durante 33 años, dimitió como director ejecutivo a raíz de la polémica. El empresario de origen chino, que había dicho públicamente que la IA china solo iba «unos nanosegundos» por detrás de la estadounidense y que las restricciones estadounidenses a la exportación eran «en gran medida contraproducentes», abandonó el tablero en aquel delicado final de otoño.
El lunes 16 de noviembre, a las 16:15, hora de la costa este de Estados Unidos, la Oficina de Industria y Seguridad del Departamento de Comercio presentó en el sistema del Registro Federal una norma provisional definitiva titulada «Addressing Remote Access to Advanced Semiconductors» (Abordar el acceso remoto a semiconductores avanzados). Se publicó oficialmente el 19 de noviembre y entró en vigor ese mismo día.
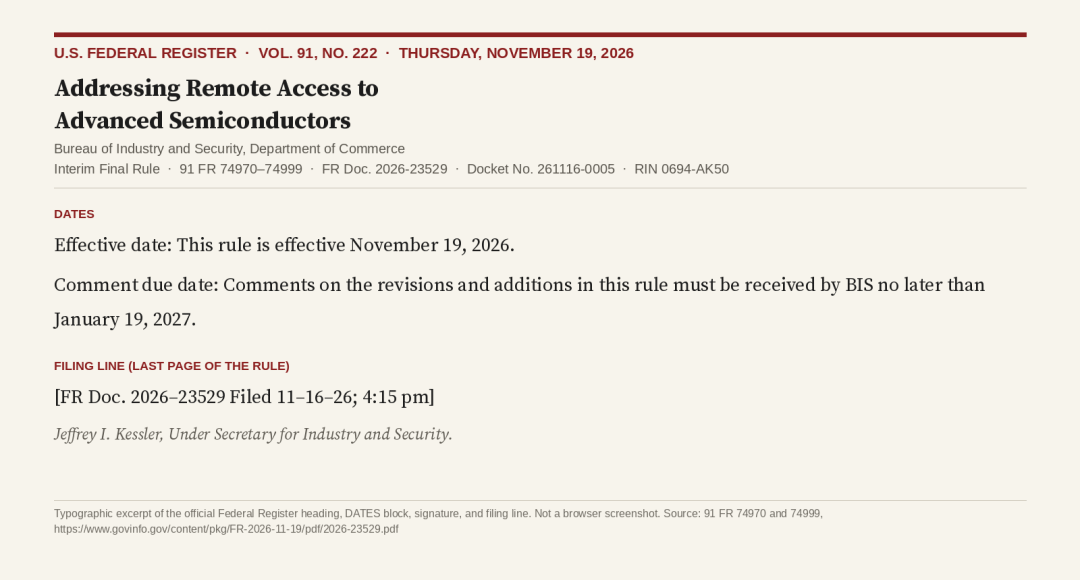
Nuevas normas sobre el acceso remoto a semiconductores avanzados|Fuente: sitio web oficial del Gobierno
Casualmente, ese mismo día el presidente estadounidense Donald Trump asistía en Shenzhen a la reunión informal de líderes de la APEC y, tras el encuentro, elogió la «outstanding personal relationship» (excelente relación personal) que mantenía con el líder chino.
La disposición central de las nuevas normas era una sola: cualquier centro de datos del mundo que proporcionara a una empresa con sede en China —incluidas sus filiales en el extranjero— más de 12 millones de TPP de capacidad de cómputo tendría que obtener previamente una licencia del Departamento de Comercio de Estados Unidos para recibir chips avanzados.
12 millones de TPP equivalen aproximadamente a 750 chips H100, es decir, unos cuatro o cinco racks.
Entrenar un gran modelo de vanguardia de un billón de parámetros requiere, para empezar, miles o incluso decenas de miles de tarjetas. Cuatro o cinco racks no bastan ni para empezar.
Para los centros de datos existentes en el extranjero que ya prestaban servicio a clientes chinos, las nuevas normas establecían un periodo de gracia de 90 días para solicitar una licencia; de lo contrario, «se enfrentarían a futuras restricciones a la exportación». Contados desde la entrada en vigor, el 19 de noviembre, los 90 días vencían justo alrededor del 17 de febrero de 2027.
Las nuevas normas incluían una cláusula de presunción: si un centro de datos extranjero se negaba a facilitar la información de diligencia debida de sus clientes, o no podía hacerlo, ese comportamiento por sí solo se consideraría una «Red Flag» y permitiría «presumir» que el exportador «tenía conocimiento».
En otras palabras, si no puedes explicar qué código se está ejecutando en el centro de datos, se da por sentado que hay algo sospechoso.
Indonesia, Malasia, Singapur, Tailandia y Brasil fueron mencionados expresamente: el envío de chips avanzados de IA a cualquiera de estos cinco países requeriría una licencia. Si el comprador era una empresa con sede en Estados Unidos, bastaría con que el exportador presentara informes mensuales para quedar exento.
El corte físico del suministro llegó enseguida. En la conferencia telefónica sobre resultados del 17 de noviembre, Colette Kress, que había asumido como directora ejecutiva interina tras sustituir a Jensen Huang, confirmó: «Ya no enviamos a China productos de centros de datos Hopper que hayan recibido autorización». Según informó también el Financial Times, TSMC y Samsung suspendieron los envíos a algunos clientes chinos mientras esperaban las licencias.
El Ministerio de Comercio de China expresó su profundo descontento y anunció que adoptaría contramedidas; el portavoz del Ministerio de Asuntos Exteriores, Guo Jiakun, afirmó sin rodeos que aquello era «un caso típico de coerción económica y jurisdicción de largo alcance».
Un depósito del 50 %
La misma semana en que entraron en vigor las normas comerciales, el apalancamiento financiero empezó también a cerrar el grifo del dinero para los centros de datos del Sudeste Asiático.
Muchos creen que detrás de las neoclouds que brotan por todo el Sudeste Asiático hay conglomerados dispuestos a gastar sin medida. En realidad, es un negocio de activos pesados que depende mucho del endeudamiento. Según Bloomberg, desde 2023 las empresas de centros de datos de Asia-Pacífico han obtenido préstamos por un total aproximado de 49.000 millones de dólares. Un informe de investigación del sector de semiconductores calcula que entre el 70 % y el 80 % de la financiación de los proyectos neocloud procede de deuda. Lo habitual es que el propietario del centro de datos use contratos de alquiler a largo plazo firmados con grandes clientes para obtener préstamos bancarios, comprar tarjetas Nvidia y luego devolver el principal y los intereses con los alquileres recibidos.
En esta cadena, el porcentaje del depósito es el termómetro del riesgo geopolítico.
En el mercado internacional de capacidad de cómputo, un cliente corriente que alquila un clúster de servidores Nvidia B300 suele pagar un depósito de alrededor del 15 %.
En cambio, cuando Moonshot AI firmó en Indonesia el contrato de alquiler de B300 por 150 millones de dólares, aceptó pagar primero un depósito del 50 % para asegurarse las tarjetas, cuya entrega no tendría lugar hasta 2027.
A principios de noviembre, según informó CNBC, cuando Moonshot AI negociaba en Europa el alquiler de más de 8.000 chips Blackwell, alguien llegó a proponer que tuviera que pagar por adelantado entre un 30 % y un 50 % más que los clientes no chinos.
Las nuevas normas del 19 de noviembre hicieron que esa prima se quedara sin contraparte comercial.
Según The Information, tras la promulgación de las nuevas normas, Moonshot AI canceló el contrato indonesio de 150 millones de dólares y suspendió las negociaciones de otros acuerdos nuevos. Así quedó cancelado el lote de chips extranjeros que había reservado para K4.
Más problemático que cancelar el alquiler fue que los bancos retiraran los préstamos.
El 17 de noviembre, Bloomberg reveló que se había congelado un préstamo de 480 millones de dólares a Aolani Cloud, proveedor de servicios en la nube de Singapur. El dinero se iba a usar para comprar GPU Nvidia destinadas a un centro de datos de Malasia que prestaba servicio a ByteDance. Según informes anteriores, había unas 36.000 B200 en el proyecto de cooperación entre las dos empresas en Malasia. El banco que lideraba el préstamo era DBS Bank, de Singapur; cuando surgieron noticias de las nuevas normas, los cinco prestamistas empezaron a debatir su retirada.
Por su parte, GMI Cloud, otro proveedor de nube, había pedido prestados 300 millones de dólares para construir en Tailandia instalaciones de computación al servicio de Tencent. Las condiciones del préstamo decían expresamente que, si Tencent era incluida en una lista de restricciones de Estados Unidos, los prestamistas tendrían derecho a exigir el reembolso anticipado.
Ante la intensa presión para cumplir las normas, los Gobiernos del Sudeste Asiático empezaron a replegarse. Johari Abdul Ghani, ministro de Inversión, Comercio e Industria de Malasia, declaró a CNBC: «Si queremos seguir en el tablero, tenemos que respetar las reglas de Estados Unidos». El viceministro de Comercio de Tailandia dijo públicamente que los nuevos proyectos sin aprobación estadounidense «podrían no llegar a completarse». El Ministerio de Desarrollo Digital e Información y el Ministerio de Comercio e Industria de Singapur emitieron una declaración conjunta en la que afirmaban que «no permitirán que las empresas utilicen sus vínculos con Singapur para eludir o infringir las leyes de otros países».
La reacción de los mercados de capitales fue rápida: ese mismo 17 de noviembre, dos valores malasios vinculados a centros de datos se desplomaron casi un 20 % durante la sesión, y el gigante de servicios públicos YTL Power cayó cerca de un 10 %.
En cambio, ese mismo día, en el mercado de Hong Kong, en China, Semiconductor Manufacturing International Corporation subió un 7 %.
En realidad, mucho antes de que Washington cerrara la puerta, Pekín ya había empezado a orientar activamente a la industria para que regresara.
En septiembre de 2025, la Administración del Ciberespacio de China exigió a ByteDance, Alibaba y otras empresas que dejaran de comprar y probar las RTX Pro 6000D de Nvidia, diseñadas específicamente para el mercado chino; en noviembre, se pidió que los proyectos estatales de centros de datos utilizaran únicamente chips nacionales. Provincias del oeste que son centros de computación, como Gansu, Guizhou y Mongolia Interior, ofrecieron a los centros de datos que utilizaran chips nacionales subvenciones en la factura eléctrica de hasta el 50 %. En enero de 2026, después de que Estados Unidos autorizara condicionalmente las H200, las aduanas chinas comunicaron a los agentes de declaración que las H200 «no podían entrar».
Por un lado, Washington cerraba con llave los centros de datos extranjeros; por otro, China cerraba con firmeza la puerta trasera de los chips especiales para su mercado. El entrenamiento fuera del país y la inferencia dentro, una práctica que había durado tres años, llegó a su fin con el corte simultáneo desde ambos lados del Pacífico.
Los usuarios se están llevando todas las tarjetas
Volvamos la mirada a China. Para entender la urgencia de la gran migración de finales de 2026, primero hay que ver la otra cara de la dulce y dolorosa tensión que atraviesan los laboratorios nacionales: el crecimiento de usuarios ha sido tan rápido que está consumiendo todas las tarjetas destinadas a la investigación y el desarrollo.
A las 00:11 del 4 de marzo de 2026, Lin Junyang, responsable técnico de Qwen de Alibaba, publicó una breve frase en inglés en X: «me stepping down. bye my beloved qwen».
La versión oficial sobre la salida de Lin Junyang fue que se debió a discrepancias en la distribución de responsabilidades; la capacidad de cómputo era solo el telón de fondo. Pero las quejas que expresó dos meses antes en un diálogo del sector revelaban la preocupación compartida por muchos responsables técnicos de primera línea: dijo que atender las entregas cotidianas ya consumía la mayor parte de la capacidad de cómputo del equipo, y que apenas quedaban tarjetas para explorar de verdad las fronteras del campo.
ByteDance también atravesaba esa misma tensión interna.
En agosto de 2026, según informó LatePost, ByteDance llegó a debatir seriamente el entrenamiento de un supermodelo de más de 5 billones de parámetros. Tras revisar sus recursos, descubrió que la capacidad de cómputo disponible «difícilmente podría seguir sosteniendo el desarrollo paralelo de varias líneas», y el equipo Seed empezó a consolidar internamente la arquitectura.
¿Por qué incluso gigantes con tanto dinero como ByteDance y Alibaba sienten que no tienen suficientes tarjetas?
Porque 2026 fue el año en que las aplicaciones de IA chinas entraron de verdad en la vida cotidiana de la población. Después del Año Nuevo chino, los usuarios activos diarios de Doubao, la aplicación de ByteDance, superaron de golpe los 200 millones. Un gran número de usuarios activos implica enormes costes de inferencia y presión operativa. Según 36Kr, ByteDance, pese a ser conocida por su habilidad para invertir en captación de usuarios, mantuvo muy bajo este año el presupuesto de promoción de Doubao: seguir atrayendo usuarios habría agravado aún más la escasez de tarjetas de inferencia.
En el sector de los grandes modelos, el preentrenamiento y la inferencia diaria compiten por la misma reserva de capacidad de cómputo. Cuanto más utilizan el servicio los usuarios, menos tarjetas quedan para entrenar la siguiente generación de modelos.
Esta «preocupación afortunada» se manifiesta de forma aún más dramática en las empresas emergentes.
Tras el lanzamiento del modelo insignia GLM-5 de Zhipu AI, el 16 de febrero de 2026, la avalancha de solicitudes simultáneas superó el límite previsto. Aunque Zhipu ya había ampliado varias veces su clúster de chips nacionales y limitado las ventas del paquete Coding Plan, el servicio en línea seguía sufriendo colas y bloqueos. La empresa tuvo que hacer un llamamiento público a fabricantes de chips, socios de capacidad de cómputo y proveedores de servicios de inferencia.
MiniMax, que no construye sus propios centros de datos y depende de comprar capacidad a proveedores de nube, también aumentó drásticamente su presupuesto. El 26 de agosto de 2026, MiniMax firmó un acuerdo complementario con Alibaba Cloud para elevar de golpe los límites anuales de compra de los tres años entre 2026 y 2028. Los límites originales eran de 115, 125 y 135 millones de dólares; los nuevos pasaron a 300, 400 y 500 millones. Su fundador, Yan Junjie, reconoció en un pódcast extranjero: «Para nosotros, y en especial para una empresa china de IA, la capacidad de cómputo siempre es una limitación».
En septiembre, hasta DeepSeek, conocida por su eficiencia de ingeniería, empezó a redirigir a los usuarios. Las solicitudes que antes se enviaban a V4-Pro pasaron al recién lanzado V4.1-Flash. El 16 de noviembre, «DeepSeek ha alcanzado el límite de uso» se convirtió en tendencia en Weibo; muchos usuarios intensivos toparon con el límite tras menos de dos horas de conversación continua.
Al comprender esta relación entre oferta y demanda, se entiende por qué en China, durante el segundo semestre de 2026, se respiraba una sensación sutil de tensión acumulada.
Durante esos meses, las versiones menores y los modelos Flash de distintas empresas se sucedieron a gran velocidad, mientras que los insignia de parámetros enormes ralentizaban el paso. Zhipu anunció GLM-6 el 31 de agosto, sin dar una fecha concreta de lanzamiento; según se informó, la versión Pro de MiniMax, de unos 3 billones de parámetros, estaba prevista para el tercer trimestre, pero aún no ha aparecido; DeepSeek lanzó V4.1-Flash, pero no V4.1-Pro.
Al mismo tiempo, la guerra de precios de las API, en la que hace dos años se gastaba sin reparar en costes, se apagó por completo. Según las estadísticas, en el segundo trimestre de 2026 el precio medio de entrada de las API de grandes modelos en China era alrededor de un 48 % más alto que en el primer trimestre de 2025, y el precio de salida, alrededor de un 80 % más alto. En las horas punta, el precio de salida de DeepSeek llegó a multiplicarse por 4,5.
Zhu Xiaohu llegó a afirmar: «Este podría ser el último año de los modelos fundacionales de gran escala».
Pero, a nuestro juicio, esa conclusión invierte precisamente la relación de causa y efecto.
Los modelos insignia no han ralentizado sus lanzamientos porque los modelos fundacionales hayan alcanzado un techo. Lo han hecho porque los grandes modelos chinos han salido de los laboratorios y han entrado de verdad en escenarios reales utilizados por cientos de millones de personas y en las herramientas de desarrolladores de todo el mundo.
El instituto de investigación Epoch AI calcula que, entre 2022 y mediados de 2026, China obtuvo apenas alrededor de una décima parte de la nueva capacidad de cómputo de IA añadida en el mundo. Sin embargo, las estadísticas de Hugging Face, la mayor comunidad de código abierto del planeta, muestran que entre febrero de 2025 y febrero de 2026 más del 40 % de las descargas de modelos de toda la plataforma correspondieron a modelos desarrollados por equipos chinos.
Con una décima parte de la nueva capacidad de cómputo mundial, se sostuvieron más del 40 % de las descargas globales de modelos abiertos y las consultas cotidianas de cientos de millones de personas en China.
Además, las rígidas limitaciones de capacidad de cómputo obligaron a los ingenieros chinos a demostrar su destreza en optimización de arquitectura e ingeniería de sistemas. Un experto del sector citado por Caixin estima que un modelo pequeño, profundamente ajustado mediante harness, puede alcanzar casi el 90 % de las capacidades de un gran modelo con aproximadamente un 4 % de su coste.
Como evaluó Dylan Patel, de SemiAnalysis, unos días antes de que entraran en vigor las nuevas normas de noviembre: «En cuanto a capacidades, Moonshot AI probablemente está a la altura de los laboratorios estadounidenses; lo que tiene es una gran carencia de capacidad de cómputo y despliegue».
Ahora, estos ingenieros, que mejor que nadie saben cómo aprovechar cada tarjeta, van a trasladarse en bloque a los cimientos de los chips nacionales.
Alineación de precisión
Trasladarse del ecosistema CUDA de Nvidia a una base de computación nacional no es una mudanza que pueda hacerse con una orden administrativa. Ante todo, es una ardua batalla de ingeniería de bajo nivel, meticulosa hasta el último bit.
En palabras de los ingenieros de chips y frameworks, la primera prueba decisiva al volver a casa se llama «alineación de precisión».
En teoría, si se usa la misma arquitectura de modelo y se introducen los mismos datos de entrenamiento, las dos curvas de descenso de la pérdida —una obtenida en una GPU Nvidia y otra en una NPU Huawei Ascend— deberían superponerse a la perfección, como dos hojas de papel de calco.
Pero en el mundo real de la ingeniería, basta con que haya una pequeña diferencia en la precisión numérica del hardware subyacente o en el orden de reducción de los operadores de comunicación para que las dos curvas se separen considerablemente.
iFlytek fue una de las primeras empresas chinas en superar este arduo reto.
En el acta de una reunión con inversores de abril de 2026, iFlytek expuso las diferencias objetivas entre las dos generaciones de hardware. La Ascend 910B, que constituía entonces su principal equipo, tenía 64 GB de memoria por tarjeta, mientras que la Nvidia H200 tenía 141 GB; el ancho de banda de memoria era de 1,6 TB/s en una y 4,8 TB/s en la otra. Tal como venía de fábrica, la eficiencia de entrenamiento de iFlytek en un clúster 910B equivalía a solo un 30 % aproximadamente de la de un clúster Nvidia A800 de tamaño similar.
iFlytek colaboró estrechamente con Huawei y reescribió y optimizó los operadores uno por uno. En 2025, consiguió elevar del 30 % al 84 % la eficiencia del entrenamiento de aprendizaje por refuerzo con cadenas largas de pensamiento, y la eficiencia de todo el proceso de entrenamiento de los modelos MoE nativos de Ascend llegó al 93 %. Aun así, el periodo de adaptación necesario seguía siendo una realidad. iFlytek escribió en su informe que, cuando aparece un nuevo algoritmo predominante a nivel internacional, puede ejecutarse directamente en tarjetas Nvidia, mientras que en las tarjetas nacionales hace falta resolver, entre otras cosas, la optimización de la eficiencia de las bibliotecas de operadores; el proceso de adaptación suele requerir entre tres y seis meses adicionales.
En octubre de 2026, Liu Qingfeng, presidente de iFlytek, dijo: «No queremos que iFlytek sea la única empresa que entrene con capacidad de cómputo nacional».
Liu Qingfeng no tuvo que esperar mucho. DeepSeek, que había decidido quedarse en China, avanzó mucho en este camino aquel otoño.
Mirando atrás, el tropiezo de la migración de R2 que DeepSeek vivió en 2025 no fue una derrota; al contrario, se convirtió en el tanteo más valioso para todo el sector chino de grandes modelos.
El mismo día del lanzamiento de DeepSeek V4, en abril de 2026, los chips Ascend ya ofrecían compatibilidad con la inferencia, y el kernel central de paralelismo de expertos se había validado tanto en hardware Nvidia como Ascend. En julio, un equipo de investigación liderado por Huawei y en el que participaban instituciones como el Instituto Hetao de Shenzhen reveló que había completado el posentrenamiento de todos los parámetros del modelo DeepSeek V4-Pro, de 1,6 billones de parámetros, en un clúster de unas 1.000 Ascend 910C. El sistema funcionó de forma continua durante aproximadamente un mes, con más de 1.500 iteraciones, «sin saltos de pasos ni NaN»; la utilización de la capacidad de cómputo del modelo se mantuvo estable en el 34,9 % y cada paso tardó 27 segundos.
El 30 de septiembre, víspera de la Fiesta Nacional, DeepSeek anunció oficialmente que publicaría como código abierto un conjunto completo de componentes centrales de bajo nivel para la plataforma Ascend, correspondientes uno a uno con la versión para Nvidia: desde la herramienta de compilación TileLang hasta las bibliotecas de cálculo y comunicación distribuida.
Para adaptarse a las características de acceso a memoria de los chips nacionales, DeepSeek incluso modificó por iniciativa propia la disposición en memoria de la caché KV de su conocida implementación de atención FlashMLA. Empaquetó juntos los valores y los factores de escala para que los chips Ascend tuvieran que mover menos veces la memoria.
En el paradigma de Silicon Valley de los últimos años, las empresas de modelos siempre escribían código siguiendo la arquitectura de hardware definida por Nvidia. En cambio, en Hangzhou, en 2026, los laboratorios punteros de modelos empezaron a reestructurar por iniciativa propia sus operadores de bajo nivel para adaptarlos a las características de los chips nacionales.
Además, Huawei y DeepSeek están colaborando para construir un supernodo de 128 tarjetas basado en Ascend 950.
Este año, el laboratorio de SemiAnalysis puso en marcha y probó en condiciones reales un chip de prueba Huawei Ascend 950PR. Su consumo era de 203,3 vatios y la temperatura del núcleo, de 56 °C; de los 128 GB de memoria de alto ancho de banda HBM integrados en la placa, se utilizaban poco más de 5 GB. A plena carga, el consumo rondaba los 600 vatios. En la operación de multiplicación de matrices, intensiva en cálculo y una de las pruebas más exigentes para el rendimiento bruto, la utilización medida alcanzó el 41,5 % del máximo teórico. A modo de comparación, la H100 clásica de Nvidia alcanza el 46,8 %.
Además de DeepSeek, toda la flota china de grandes modelos está renovando su código de bajo nivel. Kimi K3, de Moonshot AI, incorporó entrenamiento con conciencia de cuantización desde la etapa de ajuste fino supervisado; GLM-5, de Zhipu, quedó adaptado desde el primer día de su lanzamiento a siete fabricantes nacionales de chips, entre ellos Huawei Ascend, Cambricon, Hygon y Kunlun; en los repositorios de código de los grandes laboratorios, cada vez hay menos operadores exclusivamente CUDA y más implementaciones multiplataforma como TileLang.
Los dos árboles tecnológicos a ambos lados del Pacífico están desarrollando raíces independientes desde los formatos de precisión más básicos hasta la disposición de la memoria.
El invierno de Ulanqab
El 17 de febrero de 2022, cuatro departamentos, entre ellos la Comisión Nacional de Desarrollo y Reforma, emitieron conjuntamente un documento para iniciar la construcción de nodos nacionales de centros de computación en ocho regiones: Pekín-Tianjin-Hebei, el delta del Yangtsé, la Gran Área de la Bahía de Guangdong-Hong Kong-Macao, Chengdu-Chongqing, Mongolia Interior, Guizhou, Gansu y Ningxia. También planificaron diez clústeres nacionales de centros de datos. Ese día se puso en marcha por completo el proyecto «Computación oriental, transmisión de datos occidental».
A veces la historia depara coincidencias asombrosas. Casi exactamente cinco años después, alrededor del 17 de febrero de 2027, vencía precisamente el plazo de 90 días que las nuevas normas estadounidenses habían fijado para los centros de datos existentes en el extranjero.
Hace cinco años, cuando el documento mencionó topónimos occidentales y septentrionales como Helinger, Qingyang, Gui'an y Zhongwei, mucha gente creyó que se trataba simplemente de un proyecto rutinario de distribución de energía: el suelo y la energía escaseaban cada vez más en el este, mientras que en el oeste y en las tierras al norte de la Gran Muralla sobraban el viento y el sol.
Cinco años después, cuando se cerraron las puertas de los centros de datos extranjeros, la gente alzó la vista y descubrió que la base destinada a recibir el regreso de la IA china ya se había extendido por las praderas del norte, las mesetas de loess y las cuevas de las montañas del suroeste.
En Qingyang, Gansu, los antiguos terrenos de loess se han cubierto de centros de computación inteligente. Allí, día y noche, se procesan las tareas de entrenamiento e inferencia de Qwen, de Alibaba; Zhipu; y Kimi.
En Gui'an, Guizhou, Tencent construyó directamente su centro de datos principal dentro de una montaña; la enorme masa rocosa mantiene una temperatura constante de 15 °C durante todo el año. Más del 80 % de las nuevas tarjetas Ascend de Huawei Cloud se enviaron a Gui'an, donde también se encuentra el mayor despliegue de supernodos Ascend CloudMatrix384 de Huawei. Hace más de medio siglo, las montañas escarpadas de Guizhou escondían las ruidosas fábricas del Tercer Frente; medio siglo después, esas mismas montañas albergan filas y filas de capacidad de cómputo nacional, con sus luces indicadoras parpadeando.
En Helinger, Mongolia Interior, el 14 de octubre de este año se anunció oficialmente la primera reserva mundial de 10.000 tarjetas Ascend 950DT. En ese momento se estaban ajustando los sistemas, y un solo edificio del centro de datos podía alojar un clúster de 30.000 tarjetas.
En esta gran migración hacia el norte, la estación de paso más concurrida se llama Ulanqab.
En mongol, Ulanqab significa «paso de montaña rojo». Está a unos 350 kilómetros de Pekín y se llega en tren de alta velocidad en menos de dos horas. Su altitud es elevada y la temperatura media anual es de solo 4,3 °C. Durante buena parte del año, el aire frío del exterior puede utilizarse directamente para refrigerar los centros de datos.
En las praderas onduladas al sur de la ciudad, los centros de datos se suceden uno tras otro. El parque Xinghe, que el Grupo Envision está construyendo allí, tiene una capacidad total proyectada de 800 MW. La primera fase, de 120 MW, se entregó en apenas un año, con un coste de construcción equivalente a una quinta parte del de proyectos similares en Estados Unidos.
En el pasado, Ulanqab era conocida por un cultivo: la patata. Zhang Lei, fundador de Envision, dijo que quería que los tokens de los grandes modelos fueran «tan baratos como las patatas».
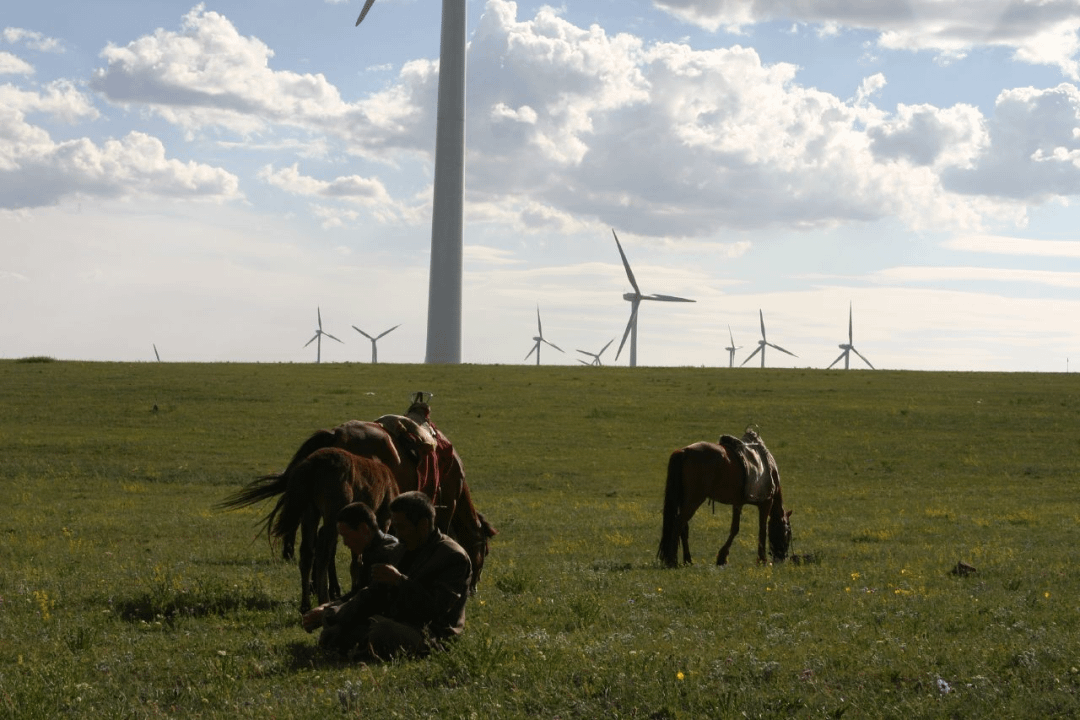
Parque eólico de las praderas de Huitengxile, verano de 2007|Fuente: Steven Buss
A finales de noviembre, la temperatura nocturna en Ulanqab suele bajar hasta los diez grados bajo cero. El viento del norte de la Gran Muralla recorre las praderas al sur de la ciudad y hace girar lentamente aerogeneradores de más de cien metros. La electricidad circula por las líneas de transmisión hasta los centros de datos, con temperatura y humedad controladas, e ilumina filas y filas de racks recién instalados.
La húmeda temporada de lluvias continúa en el estrecho de Johor, al sur.
Según el calendario, las aves migratorias no regresarán al norte hasta la próxima primavera; esta vez, la capacidad de cómputo se les adelantó.
-FIN-
Enlace al original