
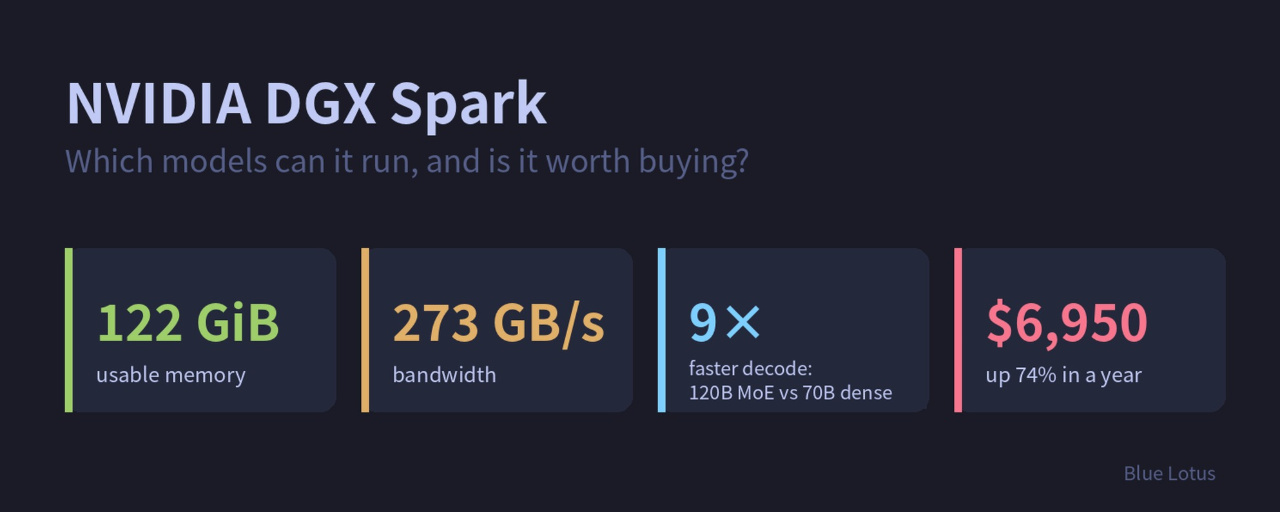
El NVIDIA DGX Spark cabe en la palma de la mano y el sistema indica que dispone de 121,93 GiB de memoria utilizable. Esa cifra invita a una conclusión tentadora: si los 128 GB pueden usarse como memoria de GPU, ¿no debería poder ejecutar cualquier modelo grande que le pongas?
Que un modelo quepa en la memoria no significa que vaya a funcionar rápido. Lo que esta máquina puede hacer realmente depende de dos cifras, y cada una mide algo muy distinto.
Dos cifras: capacidad y ancho de banda
El DGX Spark está construido sobre el chip GB10 de NVIDIA. La CPU y la GPU comparten un único conjunto de 128 GB de memoria LPDDR5x y, una vez reservada la parte del sistema, quedan unos 122 GiB para los modelos. A modo de comparación, una RTX 5090 tiene 32 GB de VRAM. Si nos fijamos solo en la capacidad, un Spark ofrece tanto como cuatro tarjetas gráficas gaming de gama alta.
Sin embargo, su ancho de banda de memoria es de apenas unos 273 GB/s. La RTX 5090 alcanza 1,8 TB/s, más de seis veces esa cifra.
La capacidad determina si un modelo cabe. El ancho de banda determina qué tan rápido responde.
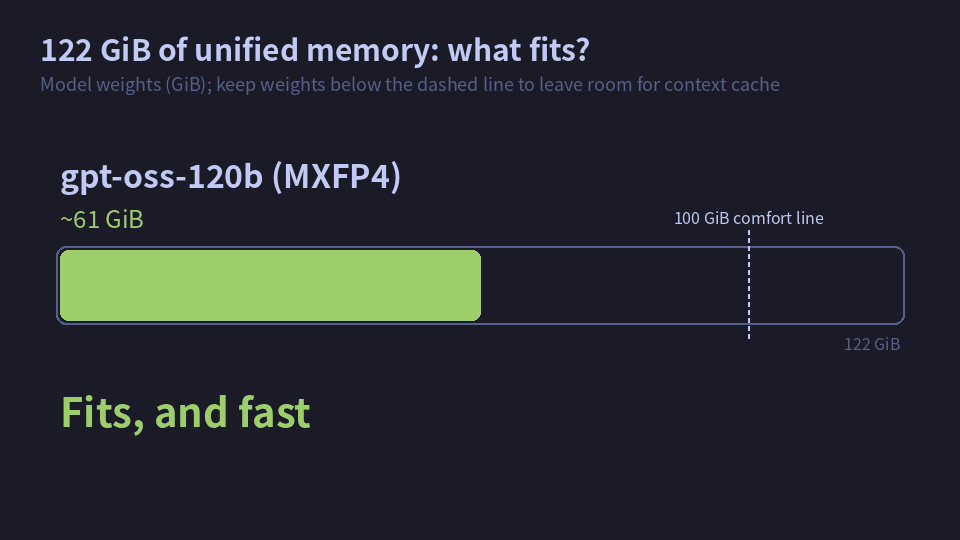
Ordenados por tamaño de los pesos: gpt-oss-120b ocupa unos 61 GiB y un GLM-4.5-Air de 4 bits, unos 68 GiB. Ambos caben holgadamente y dejan más de 40 GiB para la caché de contexto. Qwen3-235B solo cabe a 3 bits, y entonces el espacio queda justo. Un modelo de 671B como DeepSeek V3 necesita unos 380 GiB incluso a 4 bits, así que no cabe en un solo Spark.
Una regla práctica: procura que los pesos no superen los 100 GiB. Por encima de ese límite, ya no queda espacio para una caché de contexto largo.
La velocidad se reduce a una fórmula
Para generar cada token, el modelo tiene que leer de la memoria todos los pesos que utiliza en ese paso. Eso impone un límite máximo a la velocidad de generación para un solo usuario:
Velocidad máxima de generación ≈ ancho de banda de memoria ÷ bytes leídos por token
Un Llama 70B de 4 bits (Q4_K_M) ocupa unos 42,5 GB, y 273 ÷ 42,5 ≈ 6,4. Ese es su límite teórico; en la práctica, las cifras son más bajas.
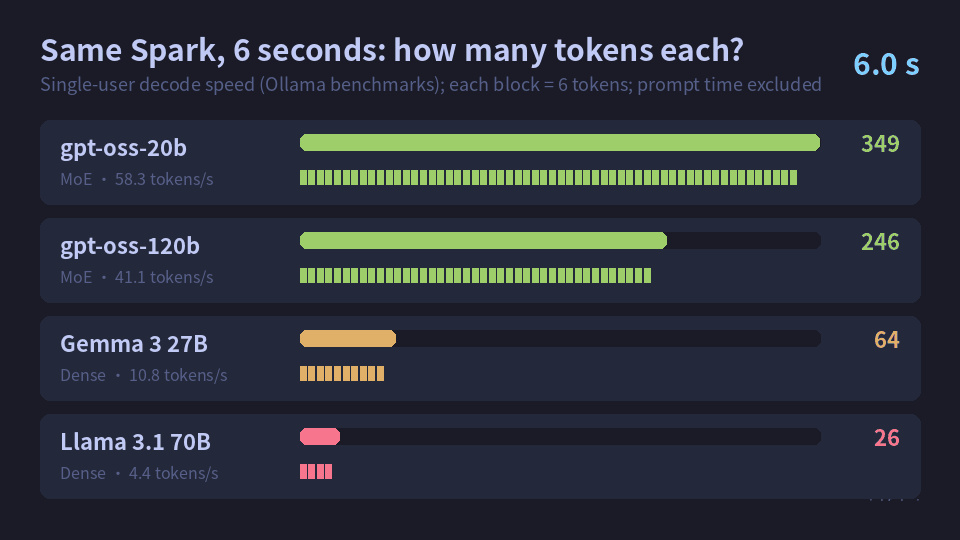
Pruebas comparativas oficiales de Ollama en el DGX Spark:
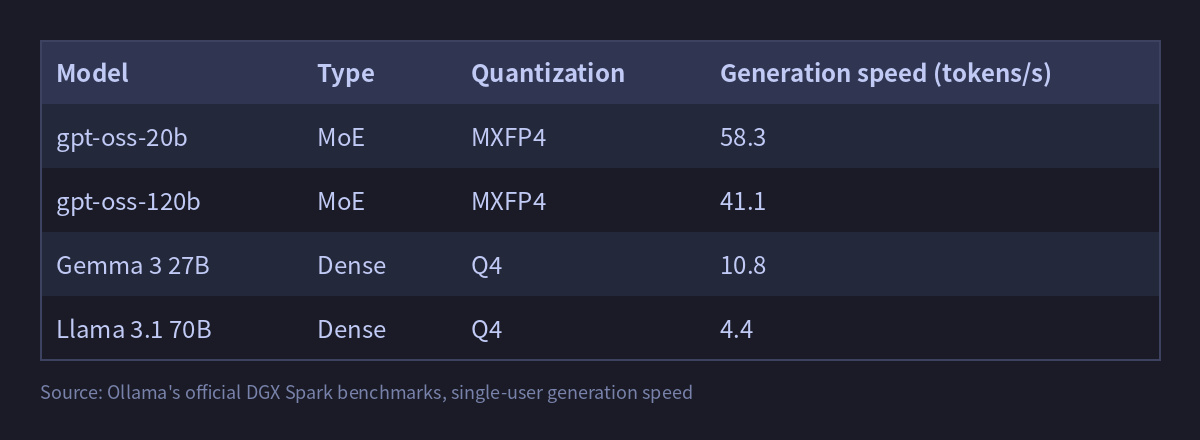
A 4 tokens por segundo, ves cómo la respuesta va saliendo a cuentagotas. La experiencia interactiva es dolorosa.
Lo contraintuitivo: 120B funciona casi 10 veces más rápido que 70B
La fila más interesante de esa tabla es la de gpt-oss-120b. Tiene alrededor de un 67 % más de parámetros que Llama 70B, pero genera texto más de 9 veces más rápido.
La razón es la arquitectura. Llama 70B es un modelo denso: sus 70.000 millones de parámetros participan en cada token, así que todos se leen de la memoria cada vez. gpt-oss-120b es un modelo de mezcla de expertos (MoE): sus 117.000 millones de parámetros se dividen en muchos «expertos», y cada token solo recurre a unos pocos. Se activan apenas unos 5.100 millones de parámetros por token.
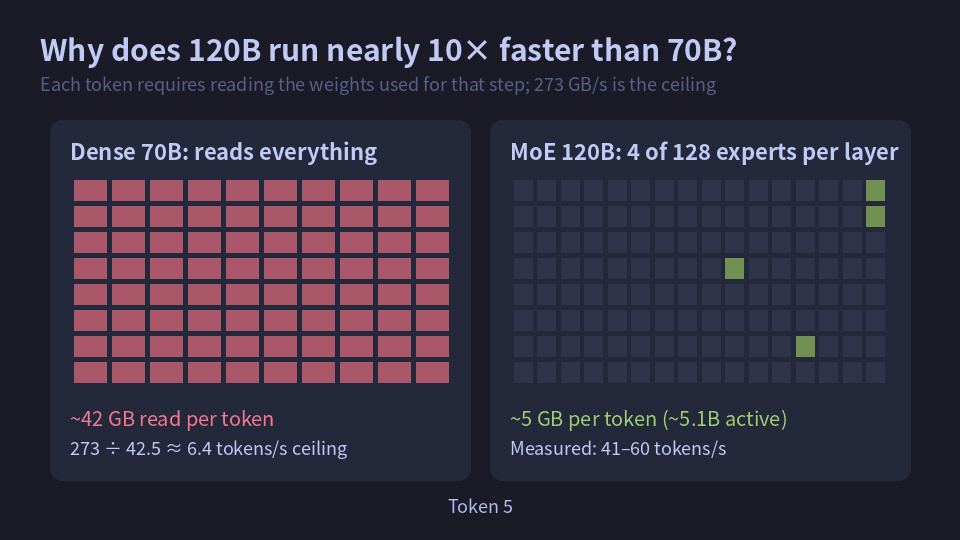
El modelo denso de 70B lee unos 42 GB por token. El MoE de 120B lee solo unos 5 GB: aproximadamente 2 GB de los expertos seleccionados, más unos 3 GB de las capas de atención y salida, que se mantienen a mayor precisión. Eso explica la diferencia de velocidad de casi diez veces en una máquina limitada por el ancho de banda.
Esto también determina la regla para elegir modelos: el Spark está hecho para MoE. El total de parámetros puede ser grande porque hay mucha memoria. Los parámetros activos deben ser pocos porque el ancho de banda es limitado.
Qué puede ejecutar realmente
Según esta lógica, los modelos de pesos abiertos más comunes se dividen en siete categorías:
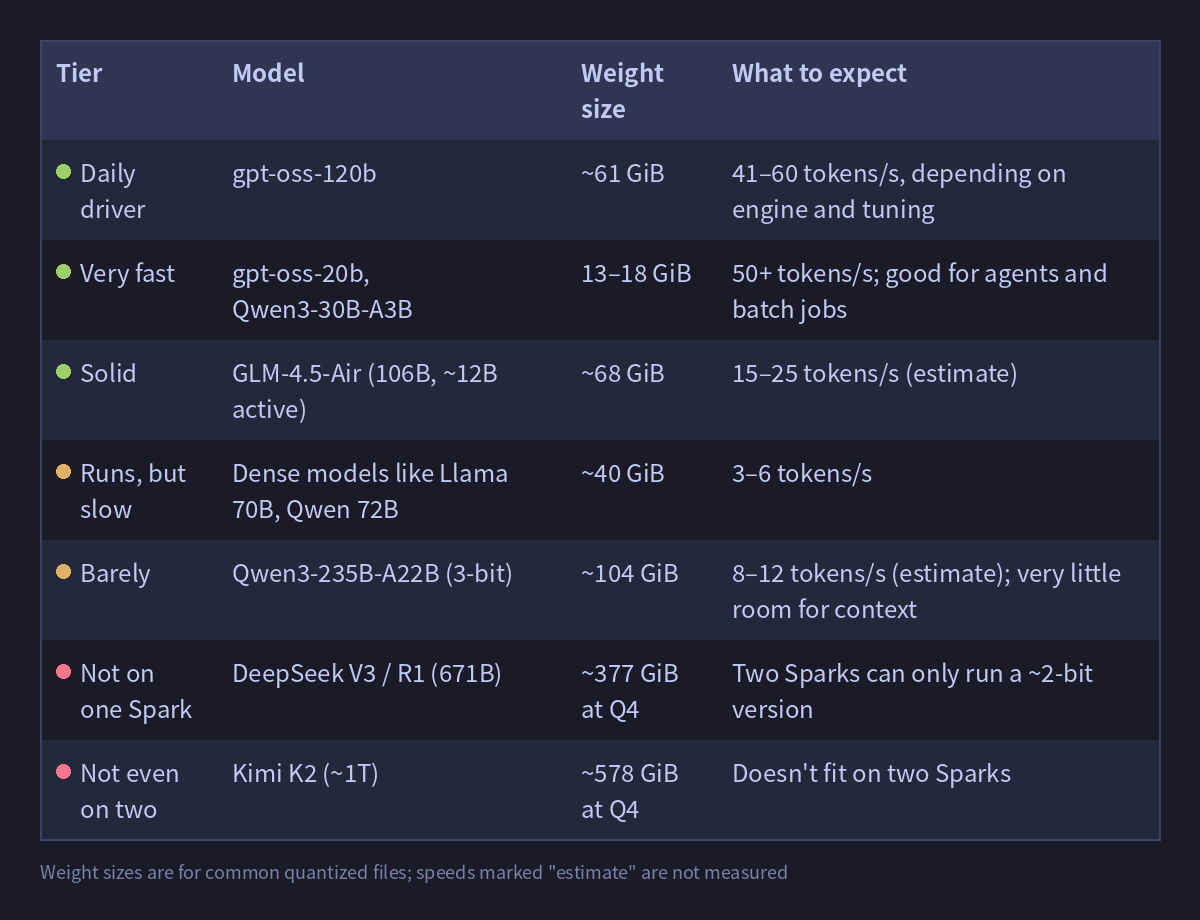
El motor de inferencia también importa. Las pruebas comparativas de gpt-oss-120b publicadas en foros muestran unos 46 tokens/s en llama.cpp, unos 52 en SGLang y hasta 60 tokens/s en una versión optimizada de vLLM. Para un solo usuario, llama.cpp es la opción más sencilla. Para uso compartido con muchas solicitudes simultáneas, elige vLLM.
Conectar dos unidades: 256 GB
El Spark tiene integrada una tarjeta de red de alta velocidad ConnectX-7. Se pueden conectar dos unidades directamente y usar paralelismo de tensores para dividir un modelo en dos, ejecutando cada una la mitad.
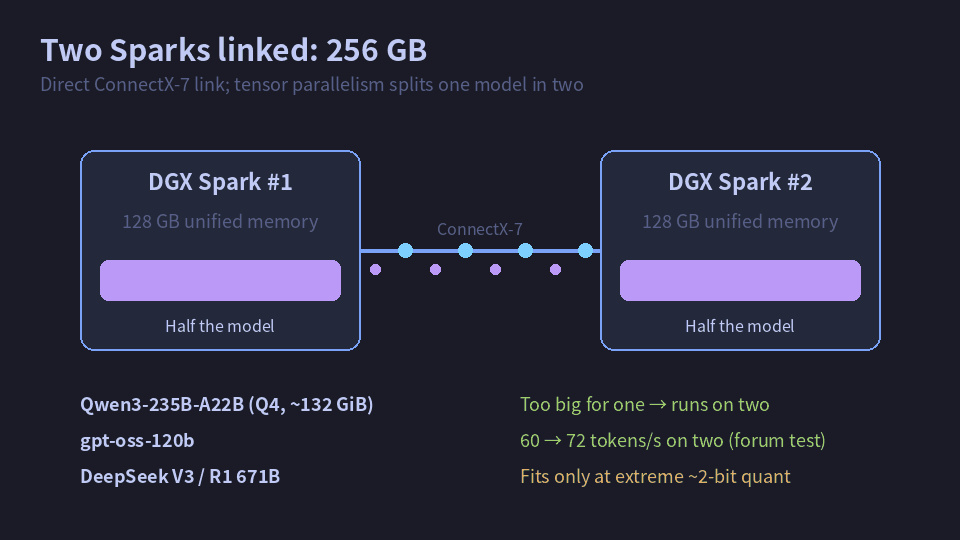
Con 256 GB entre dos unidades, Qwen3-235B se ejecuta completo a 4 bits. En las pruebas comparativas de los foros, gpt-oss-120b pasa de 60 tokens/s en un Spark a 72 en dos: una mejora modesta, ya que desde el principio no le faltaba memoria. DeepSeek 671B sigue cabiendo solo con una cuantización extrema de unos 2 bits en dos unidades; la pérdida de calidad es notable y apenas vale la pena.
¿Vale lo que cuesta?
Esta máquina no ha hecho más que encarecerse durante el último año. La Founders Edition de NVIDIA con 128 GB salió a 3.999 dólares, subió a 4.699 dólares en febrero de 2026 y se disparó a 6.950 dólares en octubre: un aumento del 74 % en un año. Cuando subió el precio en febrero, NVIDIA mencionó la escasez de memoria; los medios también atribuyeron el aumento de octubre a la escasez mundial de memoria.
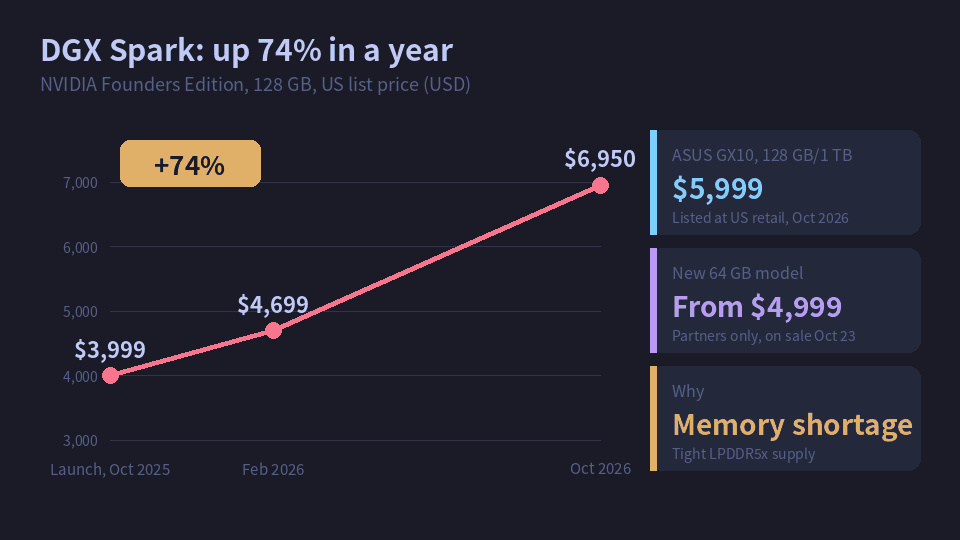
Ahora comparemos esos precios con las cifras de ancho de banda a las que siempre volvemos:
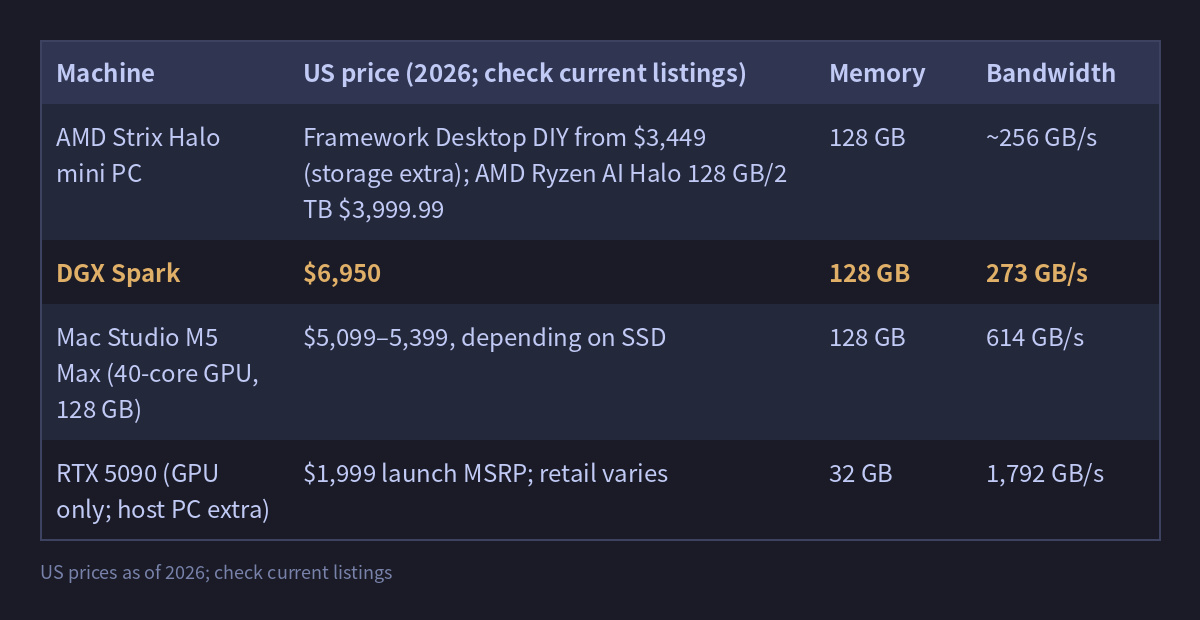
Con los mismos 128 GB, un mini PC AMD Strix Halo tiene aproximadamente el mismo ancho de banda que el Spark y cuesta más o menos la mitad. Un Mac Studio M5 Max cuesta ahora menos que el Spark y tiene 2,2 veces su ancho de banda, así que genera texto notablemente más rápido. Si lo único que quieres es ejecutar modelos grandes localmente, el Spark no ofrece una ventaja clara en precio.
Lo que compras con el dinero adicional es la pila de software de NVIDIA: CUDA, vLLM, SGLang y TensorRT-LLM funcionan de inmediato; las solicitudes largas se procesan rápido, el ajuste fino funciona y todo lo que desarrolles aquí se ejecutará sin cambios en los servidores NVIDIA del centro de datos. Si no necesitas nada de eso, no vale lo que cuesta.
Para quién es
Piensa en esta máquina como una estación de trabajo capaz de alojar modelos grandes, pero que no se comunica rápido:
Para chatear a diario y recibir ayuda con programación, gpt-oss-120b es suficientemente rápido y bueno;
Para agentes y el procesamiento por lotes de documentos, usa un modelo MoE más pequeño; en las pruebas comparativas anteriores, gpt-oss-20b decodifica aproximadamente un 40 % más rápido que gpt-oss-120b;
El ajuste fino de modelos de hasta 70B (QLoRA) es donde los 128 GB de memoria realmente valen la pena;
Los modelos densos de 70B solo son adecuados para tareas sin conexión en las que no importa esperar; si tienes que usar uno, añade un modelo borrador pequeño para la decodificación especulativa, que acelera notablemente el proceso.
Si lo que más quieres es «que una persona converse rápido con un modelo grande», un Mac Studio o una GPU con mucha VRAM es más adecuado. Si solo quieres alojar un modelo de clase 100B al menor costo posible, un mini PC AMD ofrece una mejor relación calidad-precio. El Spark solo vale lo que cuesta si tu trabajo depende de CUDA, implica ajuste fino o necesita ejecutar la misma pila de software que el centro de datos.
Al elegir un modelo, hazte solo dos preguntas: ¿Caben los parámetros totales en 122 GiB? ¿Son suficientemente pocos los parámetros activos? Si la respuesta a ambas es sí, es una buena opción para esta máquina.
¿Comprar hardware o pagar una suscripción?
Después de hacer las cuentas del hardware, hay un cálculo más directo.
Yo elijo las suscripciones: Claude Max 5x por 100 dólares al mes, más ChatGPT Plus (que incluye Codex) por 20 dólares al mes, para un total de 1.440 dólares al año. Un Spark de 6.950 dólares pagaría ambas durante casi 5 años; solo Max 5x, durante casi 6 años.
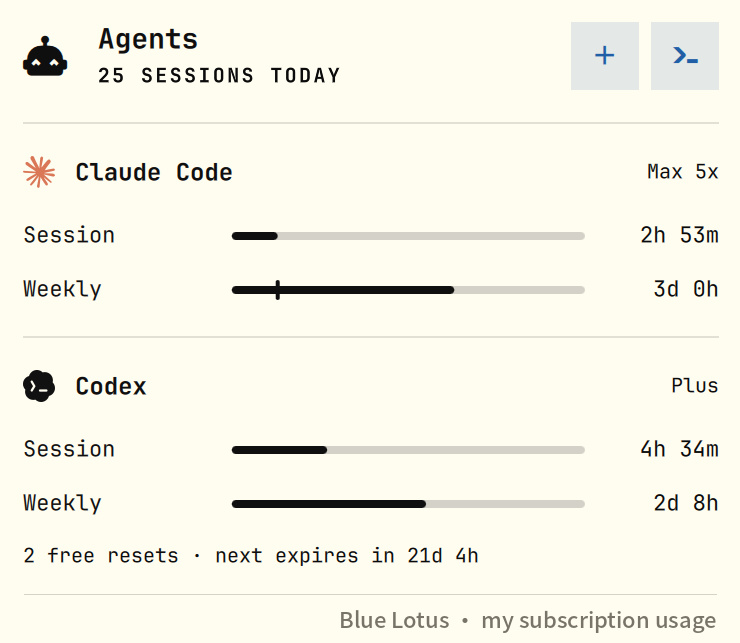
Este es mi uso en un día: 25 sesiones de agentes, alrededor del 60 % de la cuota semanal de Claude Code utilizada cuando todavía faltan 3 días para el reinicio, y algo más de la mitad de la cuota semanal de Codex. A ese ritmo, las dos suscripciones suelen cubrir mis necesidades y me dan acceso a modelos de vanguardia. La mejor opción local, gpt-oss-120b, todavía se queda atrás en programación y tareas de larga duración.
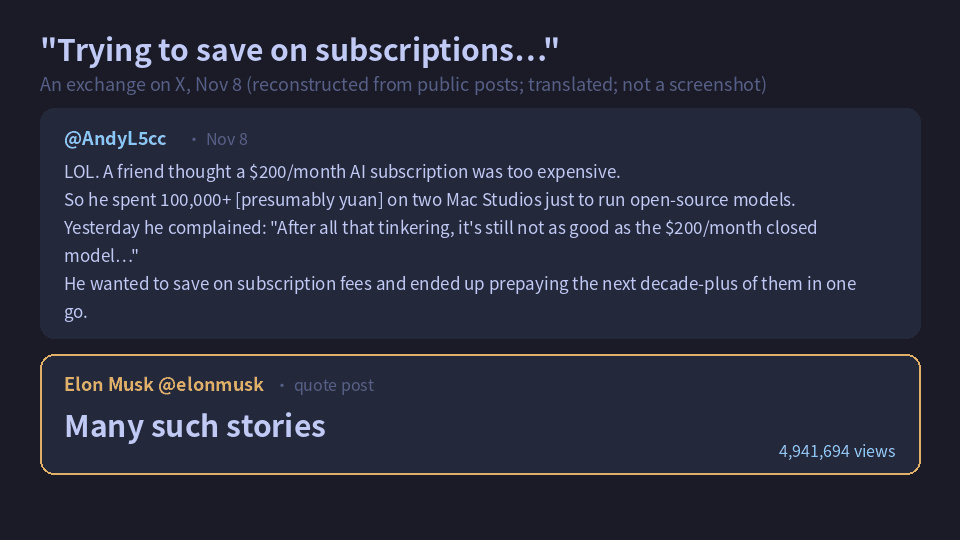
No soy el único que hace estas cuentas. El 8 de noviembre, una publicación en chino se hizo viral en X: alguien pensó que una suscripción de IA de 200 dólares al mes era demasiado cara, así que se dio la vuelta y gastó más de 100.000 (presumiblemente yuanes) en dos Mac Studios para ejecutar modelos de código abierto, solo para descubrir, tras muchos ajustes, que «sigue sin ser tan bueno como el modelo cerrado de 200 dólares al mes». El resumen de quien publicó: «Quería ahorrar en las cuotas de suscripción y terminó pagándolas por adelantado de una sola vez para la próxima década y pico». Elon Musk citó la publicación con solo tres palabras: «Muchas historias así». La cita obtuvo casi 5 millones de visualizaciones.
Sam Altman, de OpenAI, explicó hace poco esta lógica en un pódcast: la memoria de los ordenadores personales solo se utiliza alrededor del 5 % del tiempo (según su propia estimación), mientras que la nube, al agrupar solicitudes y procesarlas por lotes, normalmente puede aumentar la utilización y repartir los costos. Vende suscripciones en la nube, así que tiene intereses en este argumento, pero la lógica se sostiene: en la nube, una sola lectura de los pesos puede atender a todo un lote de solicitudes a la vez y repartir el costo; una máquina personal atiende a una persona cada vez y permanece inactiva buena parte del día. Así que, antes de comprar hardware local, calcula cuánto lo usarás realmente: cuanto menos lo uses, peor será la inversión.
Los modelos locales sí ofrecen cosas que una suscripción no puede:
Privacidad: datos de clientes, código interno y requisitos de cumplimiento; los datos no pueden salir de tu propia máquina;
Sin restricciones de plataforma: el modelo no está sujeto a las políticas de contenido de un proveedor, y tú decides qué responde;
Sin conexión y sin límites: funciona sin conexión y las tareas por lotes no consumen una cuota;
Ajuste fino: si quieres entrenar tu propio modelo, una suscripción no te lo permite.
Para la mayoría, una suscripción es más barata y los modelos son más potentes. Comprar un Spark solo tiene sentido si al menos una de las cuatro necesidades anteriores es innegociable.