

En el episodio anterior combiné a partes iguales la puntuación del modelo y el momentum. En el periodo de prueba obtuvimos una rentabilidad del +172.93%, una caída máxima del -18.44% y un Sharpe de 2.076. Al final dije que, en el siguiente episodio, conectaríamos la combinación con un buffer y un stop loss, y luego la probaríamos en el periodo de validación.
Antes de empezar, me detuve un momento. Los resultados de los nueve sistemas con mejor rendimiento estaban repartidos entre distintos scripts de ablación y directorios de caché; los parámetros estaban en diccionarios de configuración y los archivos de señales no seguían una nomenclatura uniforme. Si cambiara de ordenador o retomara el trabajo dentro de dos semanas, ¿podría volver a obtener exactamente esos nueve resultados? La respuesta es no.
Así que en este episodio no vamos a perseguir más rentabilidad; primero dejaremos los nueve sistemas organizados en un directorio que permita reproducirlos con un solo clic. Un backtest que no se puede reproducir no se diferencia en nada de inventarse una historia.
Esta entrega incluye tres elementos: nueve archivos de estrategias, seis archivos de señales y un notebook unificado. Las nueve estrategias se ejecutaron correctamente y los 9/9 resultados coincidieron punto por punto con los valores esperados.
Uno. Por qué reproducir primero en lugar de seguir ajustando parámetros
En las dos entregas anteriores de esta serie, una se centró en limpiar el universo de monedas y la otra en corregir la interfaz de selección. En esta entrega ya hay nueve estrategias. Es fácil seguir añadiendo parámetros, pero cada uno hace que sea un poco más difícil reproducir los resultados.
Las nueve estrategias anteriores procedían de diccionarios de configuración de `robust_ablation.py` y `risk_guard_ablation.py`. La misma lógica de selección de monedas se copiaba en distintas configuraciones y los parámetros quedaban fijados. Al cambiar una señal, no se podía distinguir si había cambiado la señal o la ruta del código. Y lo que es peor, al ver una cifra, los demás no podían saber con qué versión del código, qué archivo de señales ni qué conjunto de parámetros se había generado.
La reproducción no es un mero formalismo. Convierte la salida de un script puntual en un archivo que se puede citar, comparar y compartir para que otros lo revisen. Tanto si más adelante se añaden tasas de financiación o deslizamiento como si se hace walk-forward, hace falta un punto de partida estable.
Dos. Nueve archivos de estrategias: fijar solo los parámetros, sin duplicar la lógica
Se creó el directorio `alpha/crypto/strategy_catalog/` y se colocaron allí los nueve archivos de estrategias. Cada archivo corresponde a una estrategia:
- top5 combinado
- modelo buf4 stop loss 35
- mom10 top5 long-only buf5
- modelo buf4 stop loss 10
- modelo long-only buf5 stop loss 10
- mom10 top5
- modelo buf4
- modelo long-only buf5
- mom10 top20 long-only buf5
Los nueve archivos son subclases ligeras; no duplican la lógica de las clases base. La selección de monedas, el buffer de ranking y la máquina de estados del stop loss siguen en `CryptoRobustStrategy` y `CryptoRobustGuardedStrategy`; las subclases solo fijan parámetros.
Cada archivo exporta de manera uniforme seis objetos: el nombre de la estrategia, la familia de señales, la clase de estrategia, los parámetros del backtest, las métricas esperadas del periodo de prueba y los valores de referencia del periodo de validación. Estos últimos solo están disponibles para las tres estrategias mom10; por ahora, los del modelo y la combinación quedan vacíos. El notebook los utiliza para ensamblar todo automáticamente, sin tener que escribir a mano nueve bloques de código de backtest.
¿Por qué no crear nueve implementaciones independientes? Porque si cada uno de los nueve archivos copiara la lógica de selección de monedas, habría nueve posibles fuentes de errores. Al modificar la clase base, el cambio beneficia a las nueve estrategias; al modificar los parámetros, basta con cambiar un archivo y no se afectan los otros ocho.
La descripción en chino al inicio de cada archivo deja claras cuatro cosas: cómo se seleccionan las posiciones largas y cortas, qué familia de señales y qué columnas se necesitan, qué significan los parámetros fijados y en qué circunstancias puede fallar la estrategia. Este último punto es importante. Si un archivo solo explica cómo ganar dinero y no cuándo se puede perder, es fácil acabar ajustando parámetros una y otra vez en una estrategia que ya ha dejado de funcionar.
Aquí hay un error concreto que conviene evitar. `stop_pct` y `stop_cooldown` deben incluirse a la vez en `BACKTEST_SETTING` para las tres estrategias con stop loss. Esto se debe a que el runner de backtest lee `setting.get("stop_pct")`, no el atributo de la clase. Si solo se define en la clase, la propia estrategia seguirá detectando el stop loss, pero el runner no corregirá las pérdidas y ganancias a posteriori. El backtest terminará normalmente, pero las cuentas del día del stop loss serán incorrectas. El notebook incluye una aserción que exige que el atributo de la clase y el valor de `setting` coincidan; si no coinciden, se produce un error.
Otra limitación es que `on_bars` de `CryptoRobustGuardedStrategy` codifica p5 y p0 directamente, por lo que solo admite seleccionar monedas por nivel, no mediante la señal combinada. Ninguna de las nueve estrategias combina señales con stop loss, así que esta vez no se modifica la clase base; la limitación se indica en la descripción de los tres archivos con stop loss. Para combinar señales con stop loss en el futuro, primero habrá que extraer la interfaz de selección de la clase base.
Tres. Seis archivos de señales: tres familias, una versión para prueba y otra para validación
Las nueve estrategias comparten tres familias de señales; no hace falta duplicarlas nueve veces:
- Señales del modelo: p5, p0 y score, procedentes de un modelo LightGBM de cinco clases
- Señal mom10: momentum de los últimos 10 días de negociación
- Señal combinada: mitad del ranking de puntuación del modelo y mitad del ranking de momentum
Cada familia de señales tiene una versión para el segmento de prueba y otra para el de validación: seis archivos en total.
¿Por qué no copiar una señal para cada estrategia? Porque la señal es la entrada y la estrategia es la forma de consumirla. Una misma señal del modelo puede consumirse de distintas maneras: top5, buffer4, stop loss 10, etc. Copiarla nueve veces haría que la comprobación del hash perdiera sentido y facilitaría que se modificara una copia y se olvidara otra.
Todas las señales comparten el mismo esquema. Los archivos combinados añaden tres columnas de diagnóstico:
| Columna | Tipo | Significado |
|---|---|---|
| datetime | Datetime("us") | Medianoche del día de negociación, hora sin zona horaria |
| vt_symbol | String | Código del contrato |
| signal | Array(Float64, 6) | Probabilidades de las cinco clases |
| p5 | Float64 | signal[5], probabilidad de entrar en el nivel más alto |
| p0 | Float64 | signal[0], probabilidad de entrar en el nivel más bajo |
| score | Float64 | p5 menos p0 |
| mom_return_10 | Float64 | Momentum de 10 días |
| score_rank_pct | Float64 | Percentil del ranking transversal de la puntuación del modelo; solo en los archivos combinados |
| mom_rank_pct | Float64 | Percentil del ranking transversal del momentum; solo en los archivos combinados |
| blend_score | Float64 | Mitad de cada una de las dos columnas; solo en los archivos combinados |
Antes de escribir los archivos, se comprueban cuatro cosas: que la combinación de fecha y contrato sea una clave única; que no haya intersección entre los contratos y la lista de exclusión de criptomonedas puras; que `signal` siga siendo `Array(Float64, 6)` y no se haya convertido en `List`; y que p5, p0 y score sean coherentes entre sí.
Hay otro detalle que es fácil pasar por alto: no se puede cambiar el orden de las filas.
Al seleccionar monedas, si hay un empate en el límite del ranking, el ordenamiento estable determina quién entra y quién queda fuera según el orden original de las filas. Ordenar el archivo de señales por fecha o por contrato puede cambiar las posiciones y, por tanto, los rendimientos. Por eso, todas las proyecciones y columnas añadidas conservan el orden de las filas del archivo de origen; está prohibido ordenar. No es una cuestión de estilo de código, sino de poder reproducir los resultados.
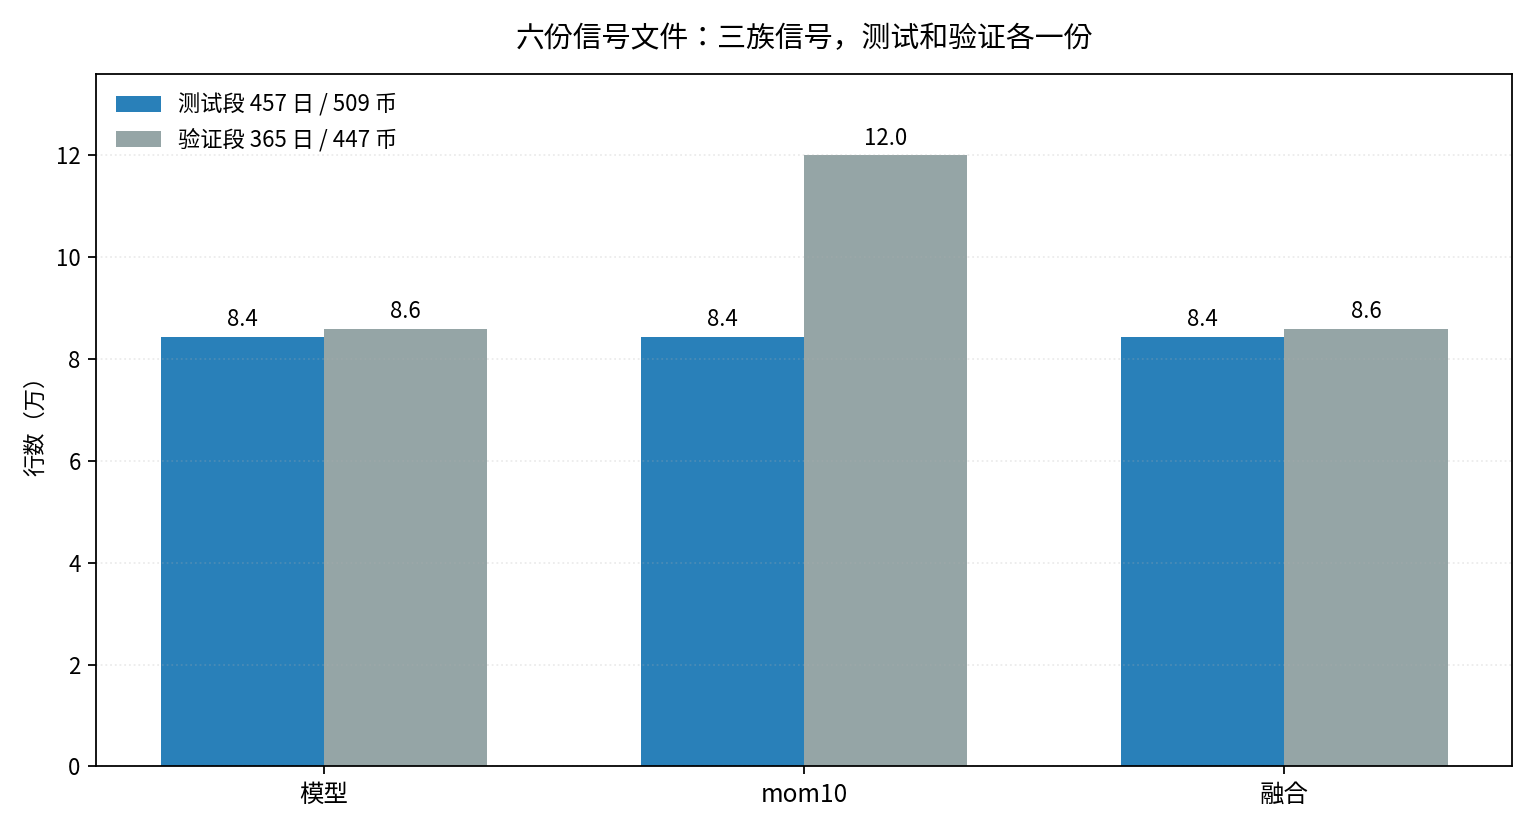
Figura 1: cada archivo del segmento de prueba tiene 84.000 filas. Los archivos de modelo y de señales combinadas del segmento de validación tienen 86.000 filas, y el archivo mom10 del segmento de validación, 120.000. El mayor número de filas de mom10 en validación no significa que haya más monedas, sino que se usa una convención de codificación distinta.
Cuatro. Los segmentos de prueba y validación de mom10 no son intercambiables
Este es el error más fácil de cometer en esta ocasión.
El segmento de prueba de mom10 usa `mom_return_10`, recortado en el conjunto de datos y limitado al intervalo de -3 a 3. El segmento de validación de mom10 usa `mom10` sin recortar, procedente de la tabla de riesgo. Los dos archivos parecen contener la misma señal, pero en realidad usan codificaciones distintas.
No son intercambiables, ni se puede recalcular uno a partir del otro. Antes de comparar segmentos, hay que comprobar la convención utilizada. Si se concatenan directamente los resultados de ambos segmentos, parecerá que ambos miden mom10, pero en realidad no miden lo mismo.
El segmento de validación del modelo tiene otra limitación. VALID intervino en la parada temprana del IC diario, así que `model_valid` solo puede considerarse parcialmente dentro de muestra. El `best_iteration` del modelo de esta ejecución es 290 y el IC diario del segmento de validación es 0.0373. Esta cifra no debe considerarse un resultado limpio fuera de muestra; las conclusiones del periodo de validación deben tomarse con cautela.
Para garantizar que no haya divergencias entre el entrenamiento y la proyección, el notebook incluye una barrera de paridad con el segmento de prueba: vuelve a hacer predicciones para ese segmento y las compara fila por fila con el `model_test` guardado. La diferencia absoluta máxima debe ser inferior a `1e-6`. En esta ejecución, la diferencia real fue 0.0.
Cinco. Un notebook para verificar, cargar, hacer backtests y conciliar resultados
El punto de entrada unificado es `strategy_catalog_backtest.ipynb`. Cuatro interruptores controlan la ejecución:
- `RUN_SEGMENTS=["test"]`: ejecutar primero solo el segmento de prueba
- `FORCE_REBUILD_SIGNALS=False`: reconstruir las señales solo si faltan
- `RETRAIN_MODEL=False`: por defecto, no volver a entrenar; usar directamente el modelo en caché
- `ALLOW_MODEL_MISMATCH=False`: detener la ejecución si el modelo no coincide, sin continuar en silencio
El flujo consta de seis pasos:
1. Cargar AlphaLab, los componentes de CRYPTO.LOCAL y el filtro de criptomonedas puras
2. Verificar o generar los seis archivos de señales
3. Importar dinámicamente los nueve módulos de estrategias y ensamblar el catálogo de estrategias
4. Cargar las tres familias de señales y los datos OHLC de cada segmento, y ejecutar el runner de backtest para cada estrategia
5. Escribir las métricas JSON y el parquet del valor liquidativo diario de cada estrategia
6. Generar una tabla de conciliación con los valores reales, los esperados, las diferencias y el resultado de la comprobación
El backtest reutiliza `risk_guard_ablation.run_config`; no se escribe un runner nuevo. Este ya incluye la sustitución de las pérdidas y ganancias del día en que se activa el stop loss, el ajuste a cero del remanente al día siguiente, la conservación de las comisiones y el recálculo de las métricas. Si se escribiera otro backtest para este catálogo, tarde o temprano los dos motores producirían cifras distintas.
Los criterios de conciliación son fijos:
- El error en el rendimiento y la caída máxima no debe superar 0,01 puntos porcentuales
- El error de Sharpe no debe superar 0,001
- El error de Calmar no debe superar 0,01
- El número de operaciones y el número de stop loss deben coincidir exactamente
En esta ejecución, las 9 de 9 estrategias superaron todas las comprobaciones. El valor liquidativo diario de cada estrategia tiene 457 filas y el patrimonio final equivale a 10 millones multiplicados por 1 más la tasa de rendimiento. El número de stop loss de las tres estrategias con stop loss fue de 121, 646 y 652, exactamente igual al registrado por las estrategias.
No es que coincidan más o menos: coinciden punto por punto.
Seis. Resultados de las nueve estrategias
Las nueve estrategias en una misma tabla, ordenadas por rendimiento descendente:
| Estrategia | Señal | Rendimiento | Caída máxima | Sharpe | Operaciones | Stop loss |
|---|---|---:|---:|---:|---:|---:|
| top5 combinado | Combinada | +172.93% | -18.44% | 2.076 | 7251 | 0 |
| mom10 top5 long-only buf5 | mom10 | +152.67% | -30.13% | 1.577 | 5879 | 0 |
| modelo buf4 stop loss 35 | Modelo | +151.47% | -31.42% | 1.635 | 4787 | 121 |
| modelo buf4 | Modelo | +137.55% | -54.80% | 1.368 | 4745 | 0 |
| mom10 top5 | mom10 | +134.22% | -39.03% | 1.385 | 6201 | 0 |
| modelo buf4 stop loss 10 | Modelo | +130.86% | -16.25% | 1.906 | 4719 | 646 |
| modelo long-only buf5 | Modelo | +115.08% | -51.89% | 1.174 | 4855 | 0 |
| modelo long-only buf5 stop loss 10 | Modelo | +114.01% | -14.39% | 1.846 | 4743 | 652 |
| mom10 top20 long-only buf5 | mom10 | +68.98% | -21.81% | 1.563 | 22474 | 0 |
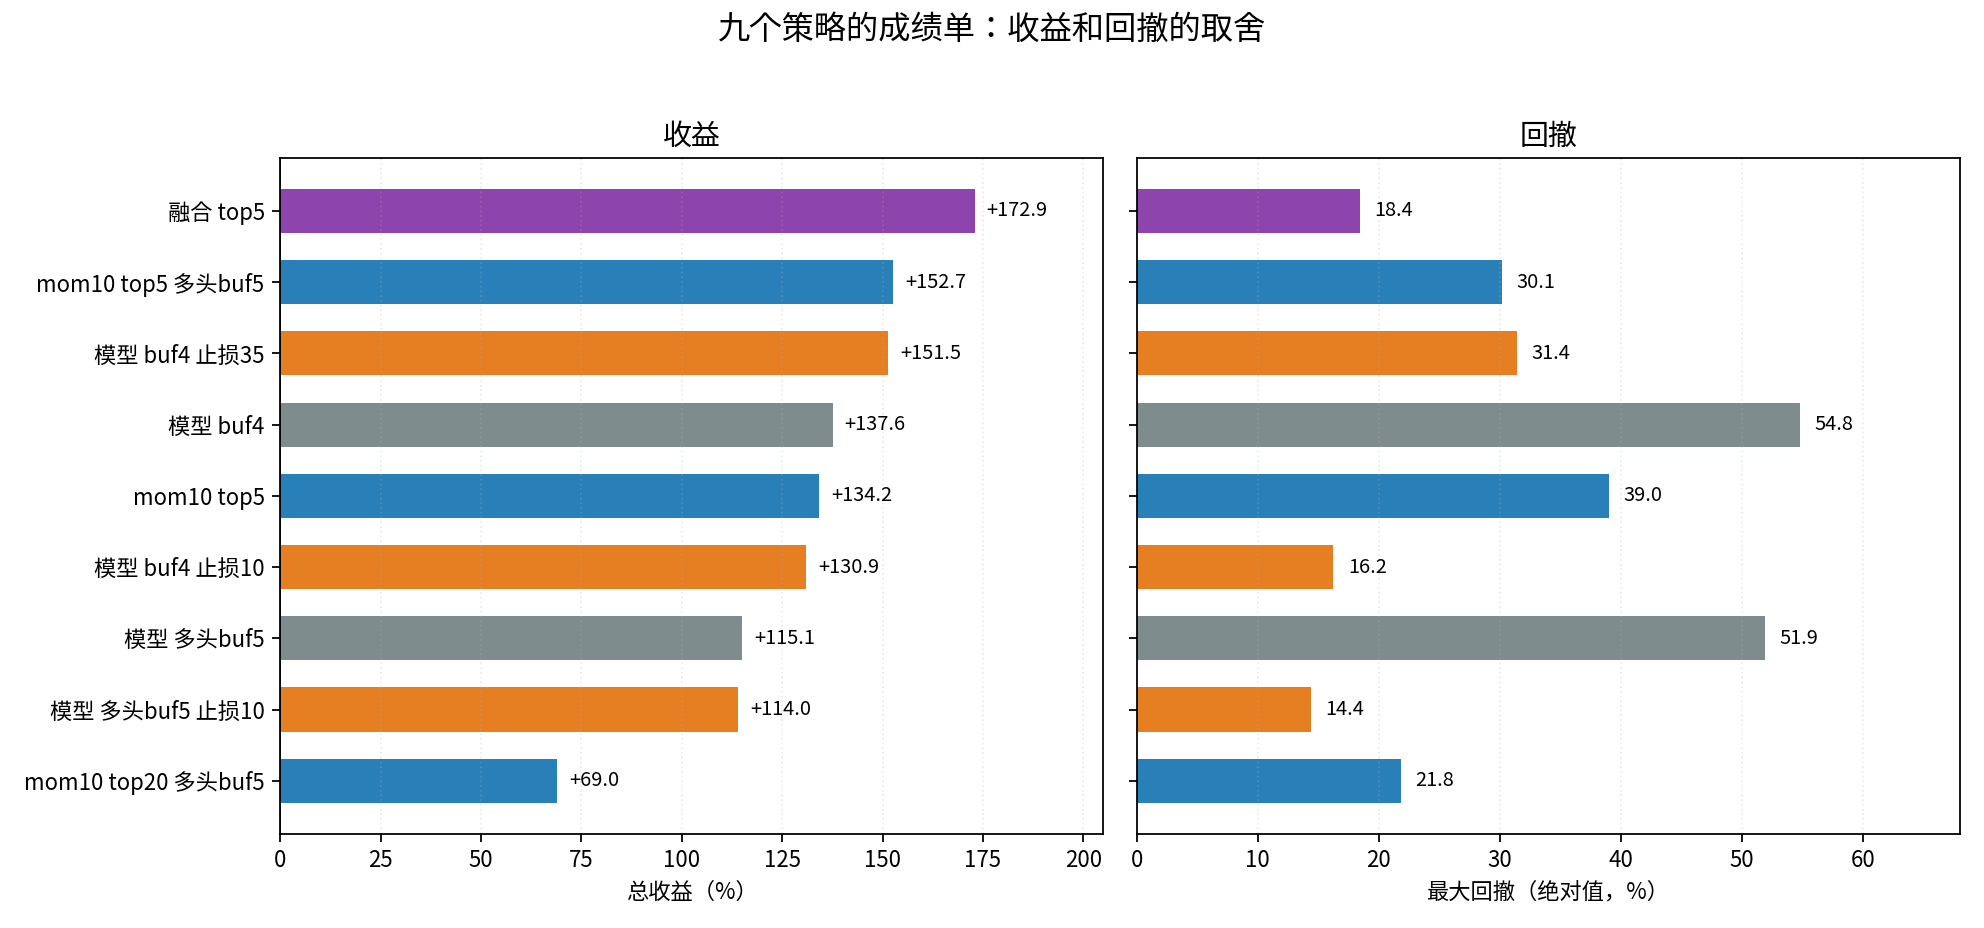
Figura 2: a la izquierda, el rendimiento; a la derecha, el valor absoluto de la caída, en el mismo orden. El naranja representa las estrategias del modelo con stop loss, el gris las estrategias del modelo sin stop loss, el azul mom10 y el morado la combinación.
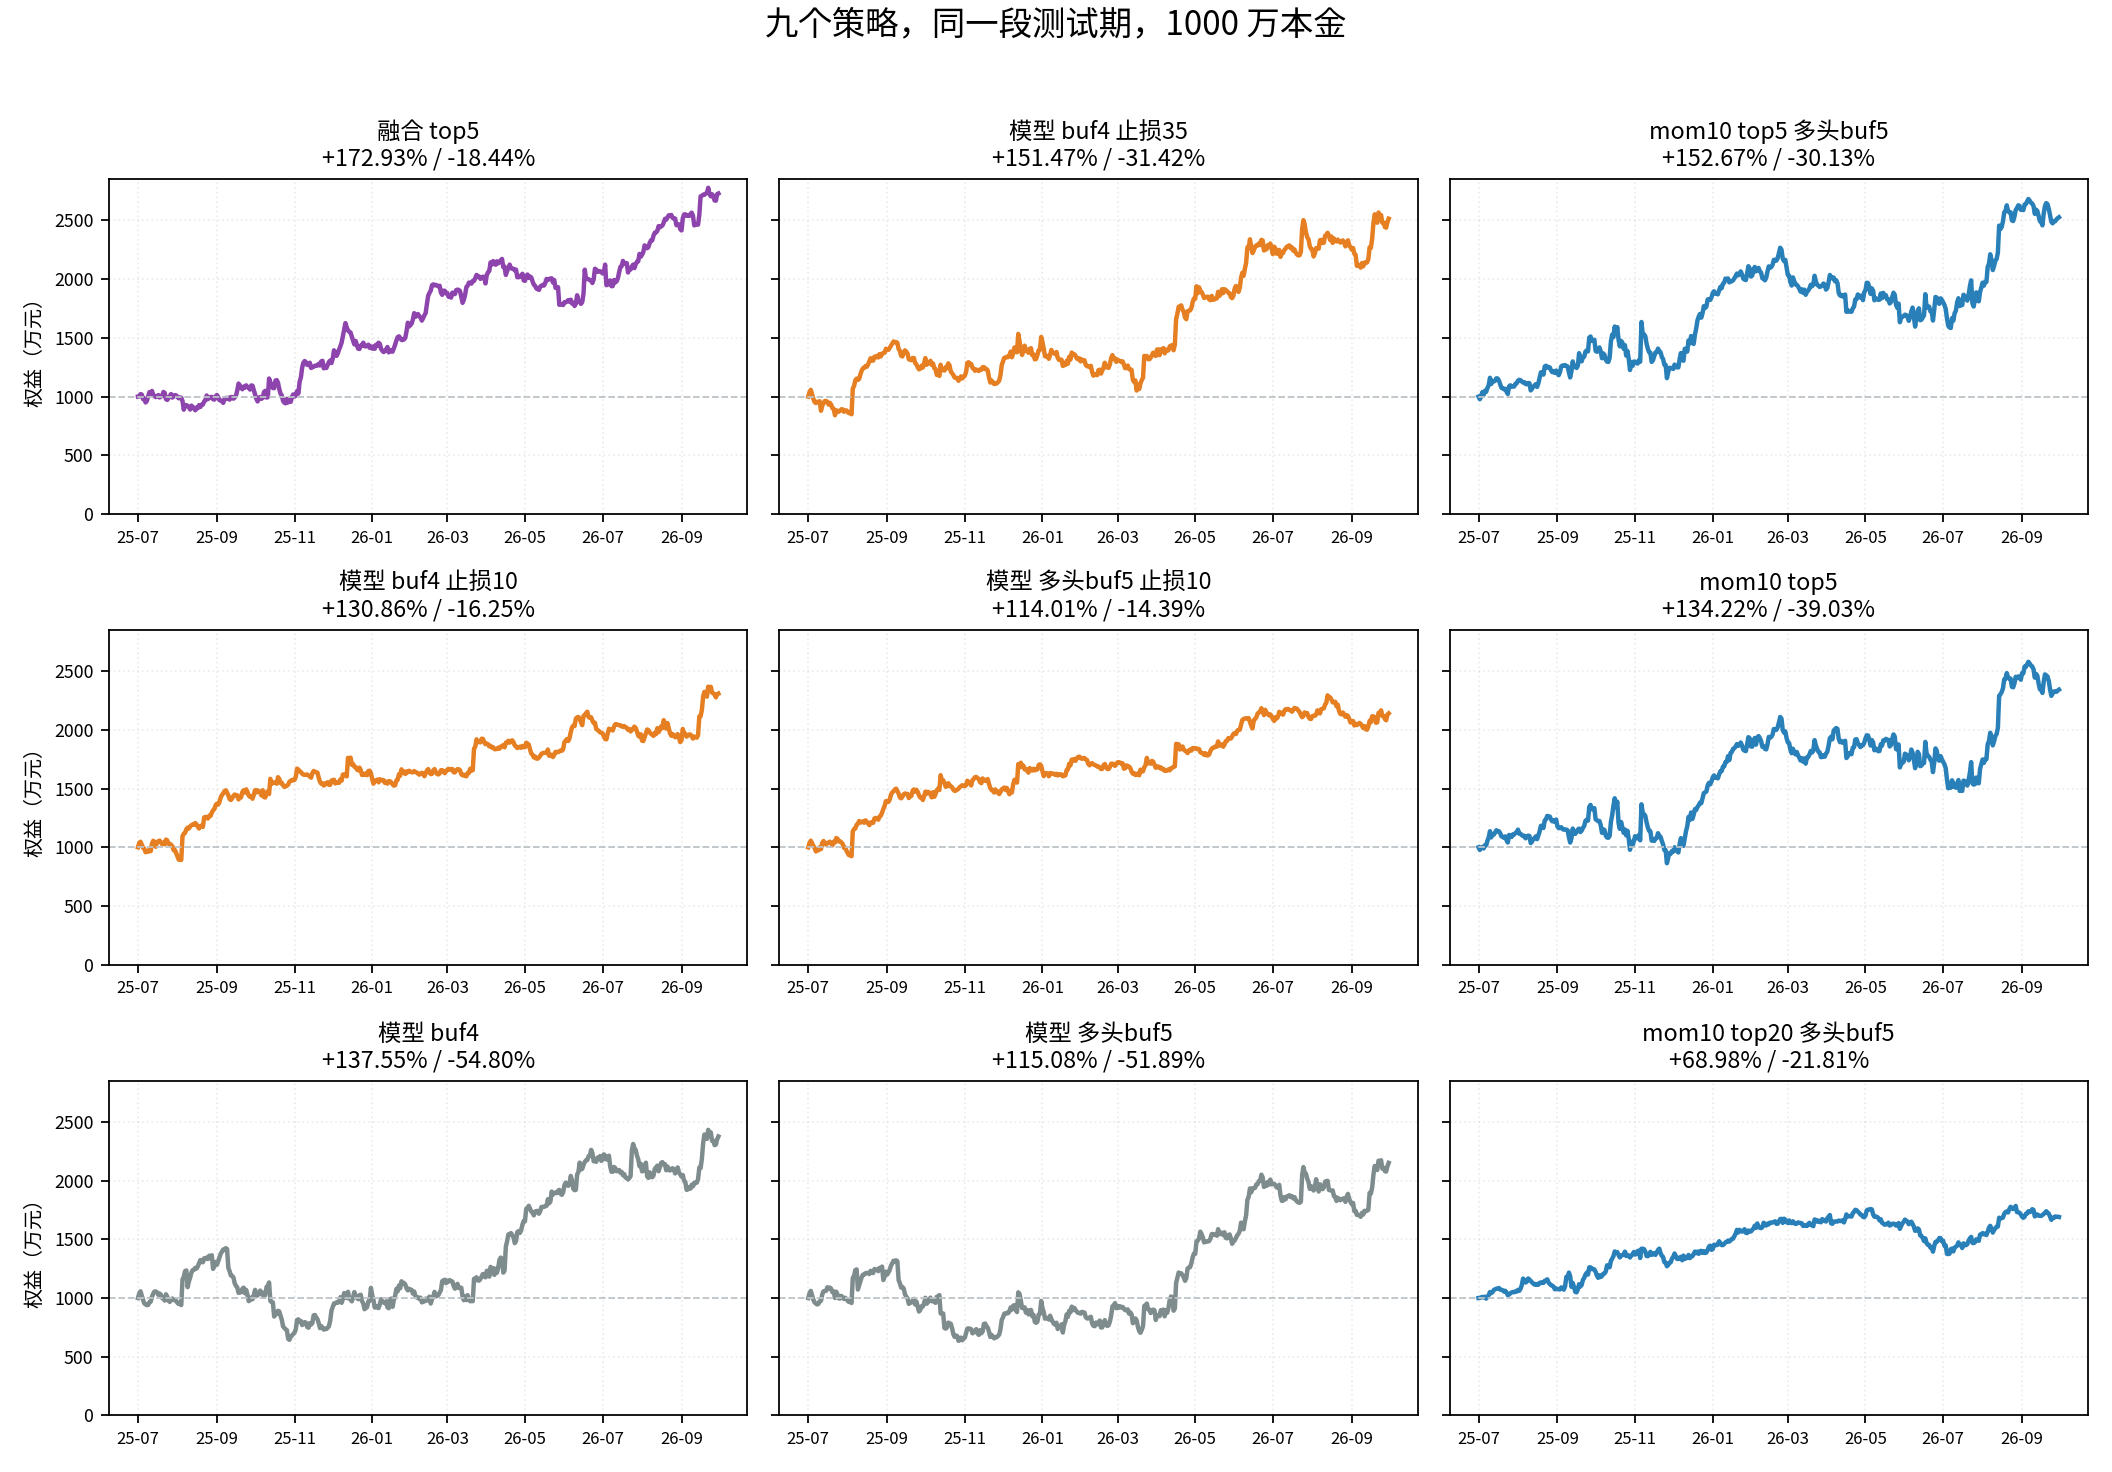
Figura 3: curvas del valor liquidativo de las nueve estrategias durante el mismo periodo de prueba y con el mismo capital inicial de 10 millones; comparten el eje vertical. Las dos cifras del título son el rendimiento total y la caída máxima.
Algunas observaciones:
Primero, la combinación sigue en primer lugar. Su rendimiento es +172.93%, la caída es -18.44% y el Sharpe, 2.076; las tres cifras son las mejores de las nueve estrategias. Su Calmar es 7.49 y es la única configuración cuyo rendimiento, caída y Sharpe superan a la vez a los de la mejor variante de mom10. Si se compara solo con mom10 top5, el modelo buf4 stop loss 35 también supera las tres métricas, pero no supera el +152.67% de mom10 long-only buffer5.
Segundo, el stop loss puede reducir la caída, pero no sale gratis. Las dos variantes stop10 reducen la caída a -14.39% y -16.25%, y alcanzan un Sharpe de 1.846 y 1.906. Sin embargo, ya se comprobó en la entrega anterior que stop10 es muy sensible al deslizamiento: con un deslizamiento del 2%, el rendimiento prácticamente cae a cero. stop35 ofrece un rendimiento de +151.47% y una caída de -31.42%; es más estable y adecuado cuando el deslizamiento es incierto.
Tercero, la caída de las variantes de referencia del modelo sigue entre -52% y -55%. El buffer elevó el rendimiento desde valores negativos hasta entre +115% y +137%, pero no resolvió el riesgo de cola. Mejorar el rendimiento y mejorar el riesgo son dos cosas distintas; no hay que ignorar la caída solo porque el rendimiento se haya vuelto positivo.
Cuarto, mom10 top20 tiene el rendimiento más bajo, solo +68.98%, y realizó 22474 operaciones, más que cualquier otra estrategia. Ampliar las posiciones no significa que el resultado vaya a ser mejor: los costes de transacción se comen parte del rendimiento. Por eso, más adelante será imprescindible incluir los costes en los cálculos.
Este catálogo muestra las ventajas y desventajas, no un único ganador. La elección depende del capital, el nivel de deslizamiento, la tolerancia a las caídas y los costes de reajuste de posiciones.
Siete. Registro de reproducción: commit, versiones y hashes
Cada ejecución genera un registro de reproducción en el notebook. En esta ocasión incluye:
- Hora de ejecución: 2026-10-20T09:39:45
- Git commit: `261a7147ed6810bd4e7a76397a9149f7353a6470`
- Estado del espacio de trabajo: hay cambios sin confirmar
- Python 3.13.13, polars 1.41.2, lightgbm 4.6.0, vnpy 4.4.0
- `best_iteration` del modelo: 290
- IC diario del segmento de validación: 0.03727
- Diferencia absoluta máxima de paridad del segmento de prueba: 0.0
También se registran los SHA256 de los seis archivos de señales:
| Archivo de señales | Primeros 12 caracteres de SHA256 |
|---|---|
| model_test | c8e9e5642a78 |
| model_valid | 77e53a0a794b |
| mom10_test | d59cf2be7a10 |
| mom10_valid | 70e25941c252 |
| blend_mom10_test | 1d5b40457ab2 |
| blend_mom10_valid | c379b7b1bab9 |
Hay que indicar con honestidad que el espacio de trabajo contiene cambios sin confirmar. Esto significa que el código de estos resultados no corresponde a un commit limpio; estrictamente hablando, el número de commit por sí solo quizá no baste para que otra persona pueda reproducirlos por completo. Antes de la próxima ejecución, conviene confirmar los cambios o guardar también el diff. El valor de un registro de reproducción no está en que quede bonito, sino en dejar las diferencias en un lugar donde se puedan rastrear.
La próxima vez que alguien pregunte de dónde sale una cifra, no hará falta explicarlo: bastará con compartir el registro de ejecución, los hashes de las señales y el notebook.
Ocho. Limitaciones y próxima entrega
Primero, eliminemos cualquier ilusión.
Los nueve resultados corresponden a un único segmento de prueba, de julio de 2025 a septiembre de 2026: 457 días. Los parámetros también se eligieron repetidamente durante este periodo de prueba, así que no se trata de un periodo limpio fuera de muestra. La reproducción de los 9/9 resultados solo demuestra que el código y las señales pueden reproducir estas cifras; no demuestra que esas cifras vayan a repetirse en el futuro.
El segmento de validación del modelo está parcialmente dentro de muestra, porque VALID intervino en la parada temprana. El universo de monedas del segmento de validación de mom10 es distinto del del segmento de validación del modelo, así que no se pueden comparar directamente los resultados de familias distintas. En esta ocasión tampoco se han tenido en cuenta las tasas de financiación, las liquidaciones forzosas, el deslizamiento real ni los filtros de monedas nuevas y de baja liquidez.
En la próxima entrega haremos tres cosas: conectar la señal combinada con el buffer y el stop loss, ejecutar el periodo de validación y después realizar un walk-forward. Si los resultados no se sostienen en el periodo de validación, el +172.93% no será más que una cifra atractiva del periodo de prueba y habrá que volver a revisar la estrategia.
La reproducción no es el destino, sino el punto de partida. Primero se ponen unos buenos cimientos; luego se construye.
Este laboratorio cuantitativo seguirá publicando registros, desde los datos y los factores hasta la gestión del riesgo. Si te resulta útil, puedes guardarlo. Nos vemos en la próxima entrega.