

En el período anterior, la rentabilidad de referencia seguía en -5.5 %. En este, combiné el modelo y el momentum al 50 % cada uno y logré un +172.93 %.
Al final del episodio anterior dije que en el siguiente añadiría las tasas de financiación y el deslizamiento. Después de escribir ese artículo, hice una pausa, porque aún quedaba sin resolver una cuestión más fundamental: el IC diario del modelo es positivo, pero ¿por qué sigo perdiendo dinero al seleccionar monedas basándome en él? Si no resolvemos esto, añadir las tasas de financiación solo sirve para calcular los costes de una estrategia equivocada.
Primero responderé a esta pregunta. La respuesta no está en el modelo, sino en las reglas para seleccionar monedas. Después de corregirlas, combiné el modelo y el momentum al 50 % cada uno y, durante el período de prueba, obtuve una rentabilidad del +172.93 %, una caída máxima del -18.44 % y un Sharpe de 2.076. Pero no te alegres todavía: más adelante explicaré cuánto hay que tomar esa cifra con pinzas.
Uno. Una contradicción: IC positivo, estrategia con pérdidas
Tras reconstruir todo el proceso de principio a fin en la entrega anterior, la línea base limpia quedó en -5,52 % de rentabilidad y -91,61 % de caída. Sin embargo, el IC diario de la misma versión del modelo en el conjunto de prueba era de +0,0336, con un ICIR de 5,91. Un IC positivo indica que existe una relación entre el ranking de las puntuaciones predictivas y las rentabilidades futuras. Si la estrategia pierde dinero, el problema está en el paso en que convierto las puntuaciones en posiciones.
El problema no es que el modelo no funcione, sino que la interfaz está mal.
Dos. Causa raíz: se entrena con score, pero se seleccionan activos con p5 y p0
El modelo tiene cinco clases. p5 es la probabilidad de que la rentabilidad futura quede en el nivel más alto, y p0, la de que quede en el más bajo. El entrenamiento y la evaluación del IC usan score = p5 − p0.
Pero la estrategia abre posiciones largas seleccionando según p5 de mayor a menor, y posiciones cortas según p0 de mayor a menor.
El problema es que la correlación transversal diaria entre p5 y p0 llega a +0,82. Un activo puede tener un p5 muy alto y, a la vez, un p0 también muy alto. Eso no significa que vaya a subir, sino que puede experimentar movimientos muy bruscos. Al elegir posiciones largas según el valor absoluto de p5, se seleccionan activos extremos, no activos con perspectivas alcistas.
Así que el modelo predice la dirección, pero la estrategia selecciona volatilidad. En este caso, un IC positivo y una estrategia con pérdidas no son contradictorios.
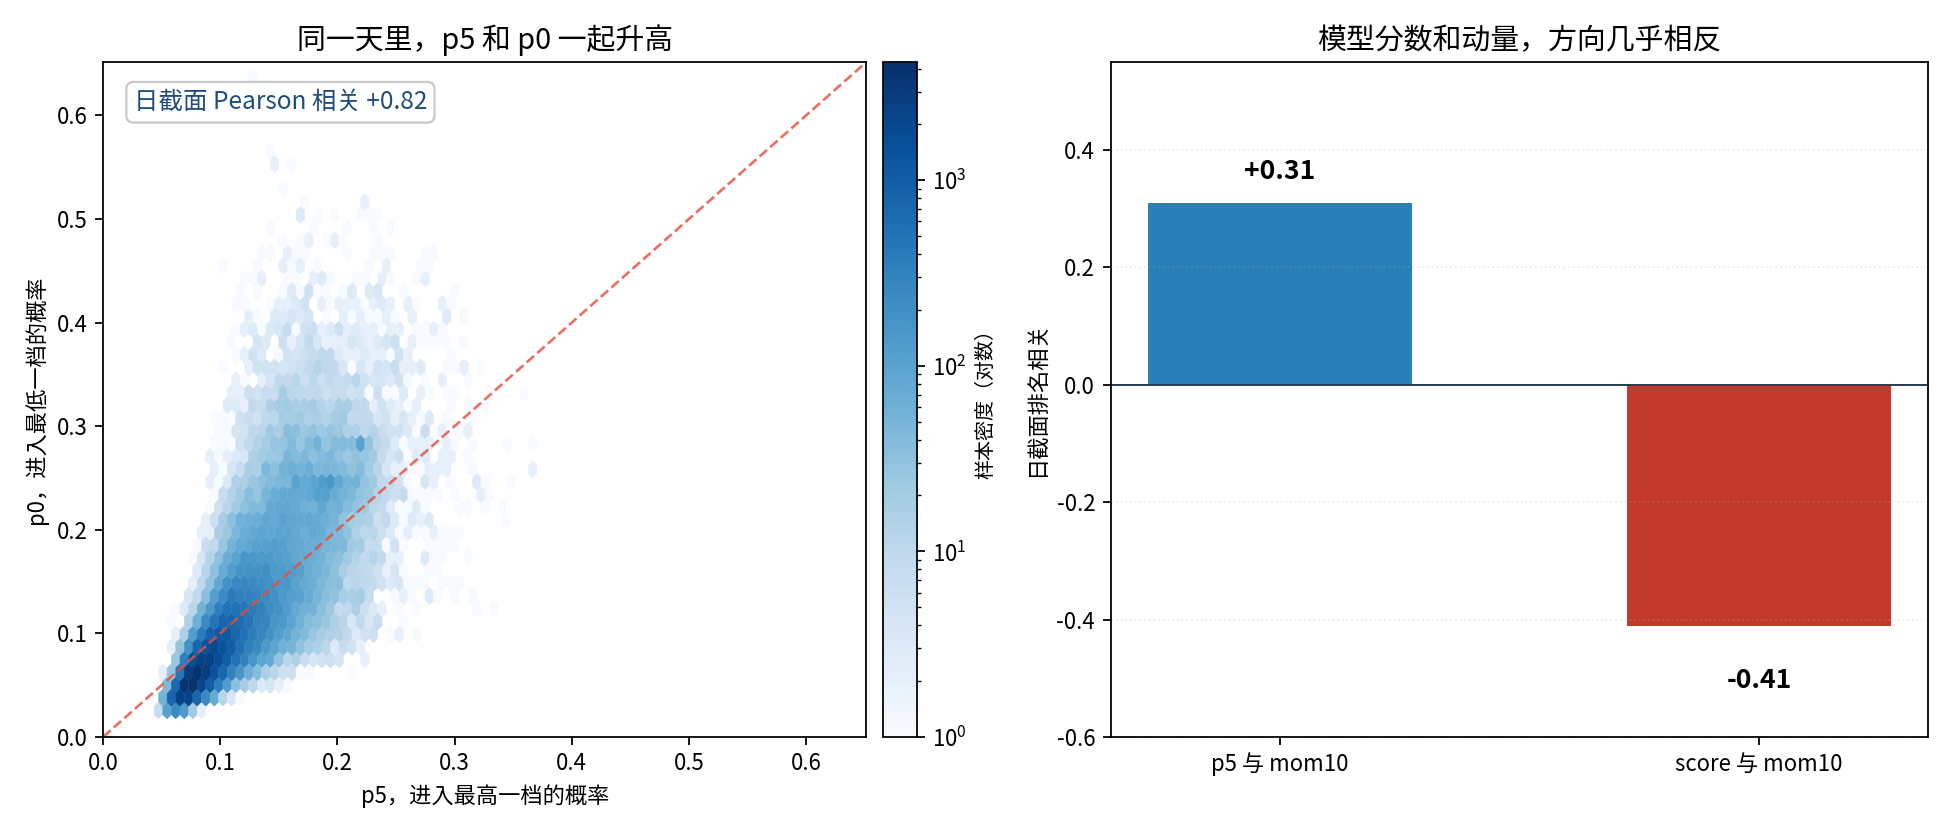
Figura 1: a la izquierda, los valores de p5 y p0 de los 84.000 ejemplos; la nube de puntos se pega claramente a la diagonal. A la derecha, la correlación entre los rankings del score del modelo y del momentum: una es positiva y la otra negativa.
Tres. Ordenar solo por score hace que el patrimonio caiga por debajo de cero
La primera reacción es sencilla: si se entrena con score, también hay que seleccionar los activos por score. Para las posiciones largas, se eligen los 5 valores más altos; para las cortas, los 5 más bajos.
El resultado fue peor:
- Posiciones largas y cortas seleccionadas por score: -110,67 % de rentabilidad y -154,83 % de caída
- Cambiando solo el lado largo: -75,08 % de rentabilidad y -114,98 % de caída
- Cambiando solo el lado corto: -43,20 % de rentabilidad y -109,29 % de caída
El patrimonio de los tres grupos cayó por debajo de cero, así que las métricas ya no son válidas; en real, la cuenta habría quebrado. Ampliar a top10 mejora un poco las cosas, pero sigue habiendo pérdidas: -18,77 % de rentabilidad y -53,34 % de caída. Añadir buffer5 a las posiciones largas de score también da -83,11 %, y el patrimonio cae por debajo de cero.
Ordenar solo por score no es la solución. La correlación entre los rankings transversales de score y mom10 es de -0,41: el score tiene esencialmente un sesgo de reversión. En un período de prueba dominado por el momentum, usarlo por sí solo es ir contra la tendencia.
Cuatro. Construcción de cartera: topN no sirve, el buffer sí
Como la dirección de selección de activos no es el único problema, también probé distintas formas de construir la cartera.
Ampliar el número de posiciones no sirve. Model top10 obtuvo -27,85 % de rentabilidad y -54,89 % de caída; top20, -4,48 % de rentabilidad y -38,06 % de caída. Ampliar solo diluye el efecto; no convierte un alfa negativo en positivo.
El buffer de ranking sí funciona. buffer4 obtuvo +137,55 % de rentabilidad, -54,80 % de caída y un Sharpe de 1,368. Desde buffer3 hasta buffer15 hay una franja amplia de resultados positivos: buffer3, +72,36 %; buffer5, +119,82 %; buffer6, +103,74 %; buffer7, +94,12 %; buffer8, +99,20 %; buffer10, +86,25 %; buffer15, +86,38 %.
La razón se ve al desglosar los resultados por dirección. En model top5, la pata larga perdió 877.000 y la corta ganó 325.000: el lado largo sufría pérdidas crónicas. El buffer permite mantener un poco más a los ganadores que ya están en cartera, en lugar de cambiarlos continuamente cuando su ranking oscila cerca del límite. Con buffer5 simétrico, la pata larga obtuvo +12.407.000.
Pero el buffer solo funciona en el lado largo. Con buffer5 en el lado corto, el patrimonio cae por debajo de cero; el mínimo fue de -709.000 en marzo de 2026 y, en real, la cuenta ya habría quebrado. El lado corto no se puede arreglar con un buffer.
También hice una prueba placebo. Tras barajar las señales, top5 dio -33,25 % y buffer4, -47,65 %, lo que indica que el buffer no está creando alfa a partir del ruido. Pero las puntuaciones aleatorias también pueden dar +33,41 % y +45,79 %, así que la varianza de los resultados positivos en un único período es muy alta. No se puede sacar una conclusión solo porque una cifra se vea bien.
Cinco. Un baño de realidad: el factor individual mom10 supera al modelo
Antes de seguir ajustando el modelo, probé un referente de un solo factor con los mismos criterios: mom10, es decir, el momentum de los últimos 10 días de negociación.
mom10 top5 obtuvo una rentabilidad de +134,22 %, una caída máxima de -39,03 % y un Sharpe de 1,385. Al añadir buffer5 al lado largo, los resultados fueron +152,67 % de rentabilidad, -30,13 % de caída máxima y 1,577 de Sharpe.
La línea base del modelo es -5,52 %. La correlación entre los rankings transversales de p5 del modelo y mom10 es de solo +0,31, y la coincidencia diaria de top5 es del 23,3 %.
Es decir, el modelo y el momentum coinciden en parte, pero no demasiado; usado por sí solo, el modelo rinde menos que el momentum. Es posible que el IC positivo del modelo proceda principalmente de los niveles intermedios, mientras que en los extremos largo y corto no haya alfa negociable. El modelo aún no ha demostrado aportar valor adicional.
Al poner las configuraciones anteriores en un gráfico de rentabilidad y caída, la distribución queda clara. Cuanto más arriba y a la izquierda, mejor: la estrategia larga-corta basada en score queda abajo a la derecha y la combinación, arriba a la izquierda.
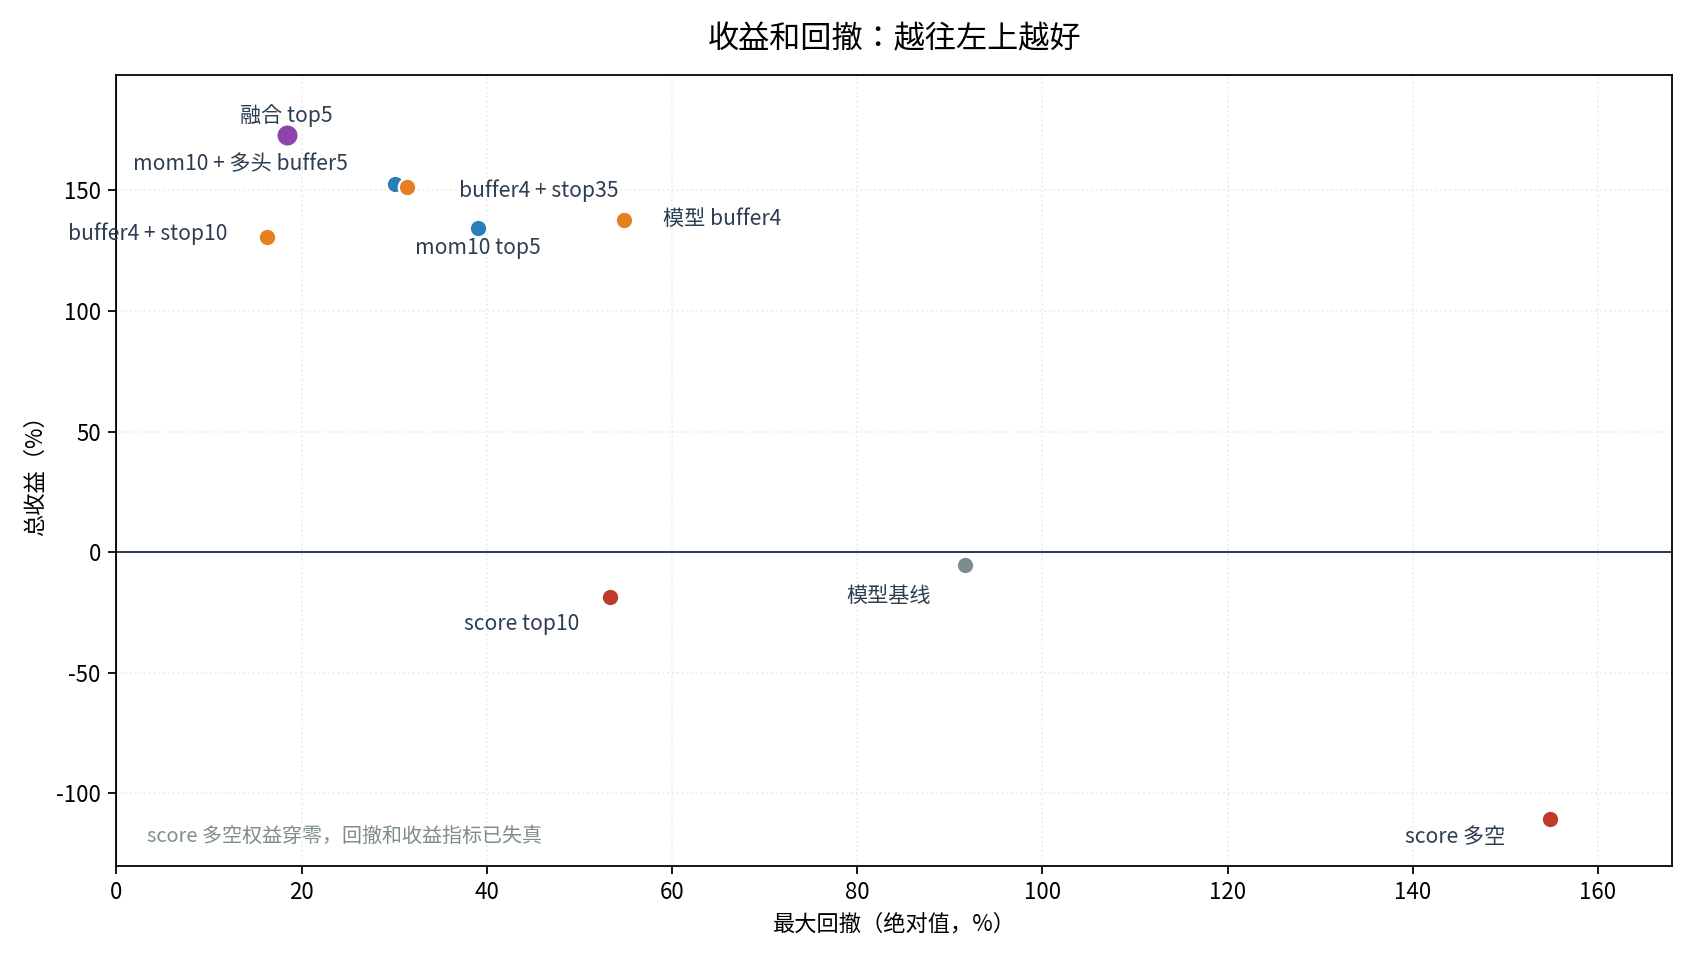
Figura 2: cada punto representa una configuración; el eje horizontal muestra la caída máxima y el vertical, la rentabilidad total. El patrimonio de la estrategia larga-corta basada en score cae por debajo de cero, por lo que las métricas ya no son válidas.
Seis. Combinación: dos señales casi opuestas, mitad y mitad
Lo realmente interesante es la relación entre ambas. La correlación entre los rankings transversales de score y mom10 es de -0,41: uno tiende a la reversión y el otro al momentum, casi se contradicen.
Como ninguna funciona lo bastante bien por separado, tomé la mitad de cada una. Cada día, multipliqué por 0,5 el percentil del ranking transversal de score y el percentil del ranking transversal de mom10, y los sumé para obtener la puntuación combinada. Para las posiciones largas, seleccioné los 5 activos con la puntuación combinada más alta; para las cortas, los 5 con la más baja. Todo lo demás se mantuvo igual.
Resultados:
- Rentabilidad: +172,93 %
- Caída máxima: -18,44 %
- Sharpe: 2,076
- Calmar: 7,49
- Los cinco trimestres fueron positivos: +539.000, +3.734.000, +5.358.000, +972.000 y +6.690.000, respectivamente
Al desglosar las patas larga y corta, la posición larga de la combinación obtuvo +7.040.000 y la corta, +10.253.000. La pata larga de mom10 por sí sola perdió 1.849.000; la combinación convirtió esa pata larga con pérdidas en una ganadora, mientras que el lado corto siguió dependiendo del momentum.
La coincidencia entre las posiciones largas de la combinación y las de mom10 es de solo el 7,0 %, y con las posiciones largas de score, del 19,3 %. En el lado corto, la coincidencia con mom10 es del 25,2 %, mientras que con score es de solo el 5,8 %. No es una variante de una estrategia de momentum, sino una combinación de dos patas distintas.
Supera a mom10 en rentabilidad, caída y Sharpe: es la única configuración que lo ha conseguido hasta ahora.
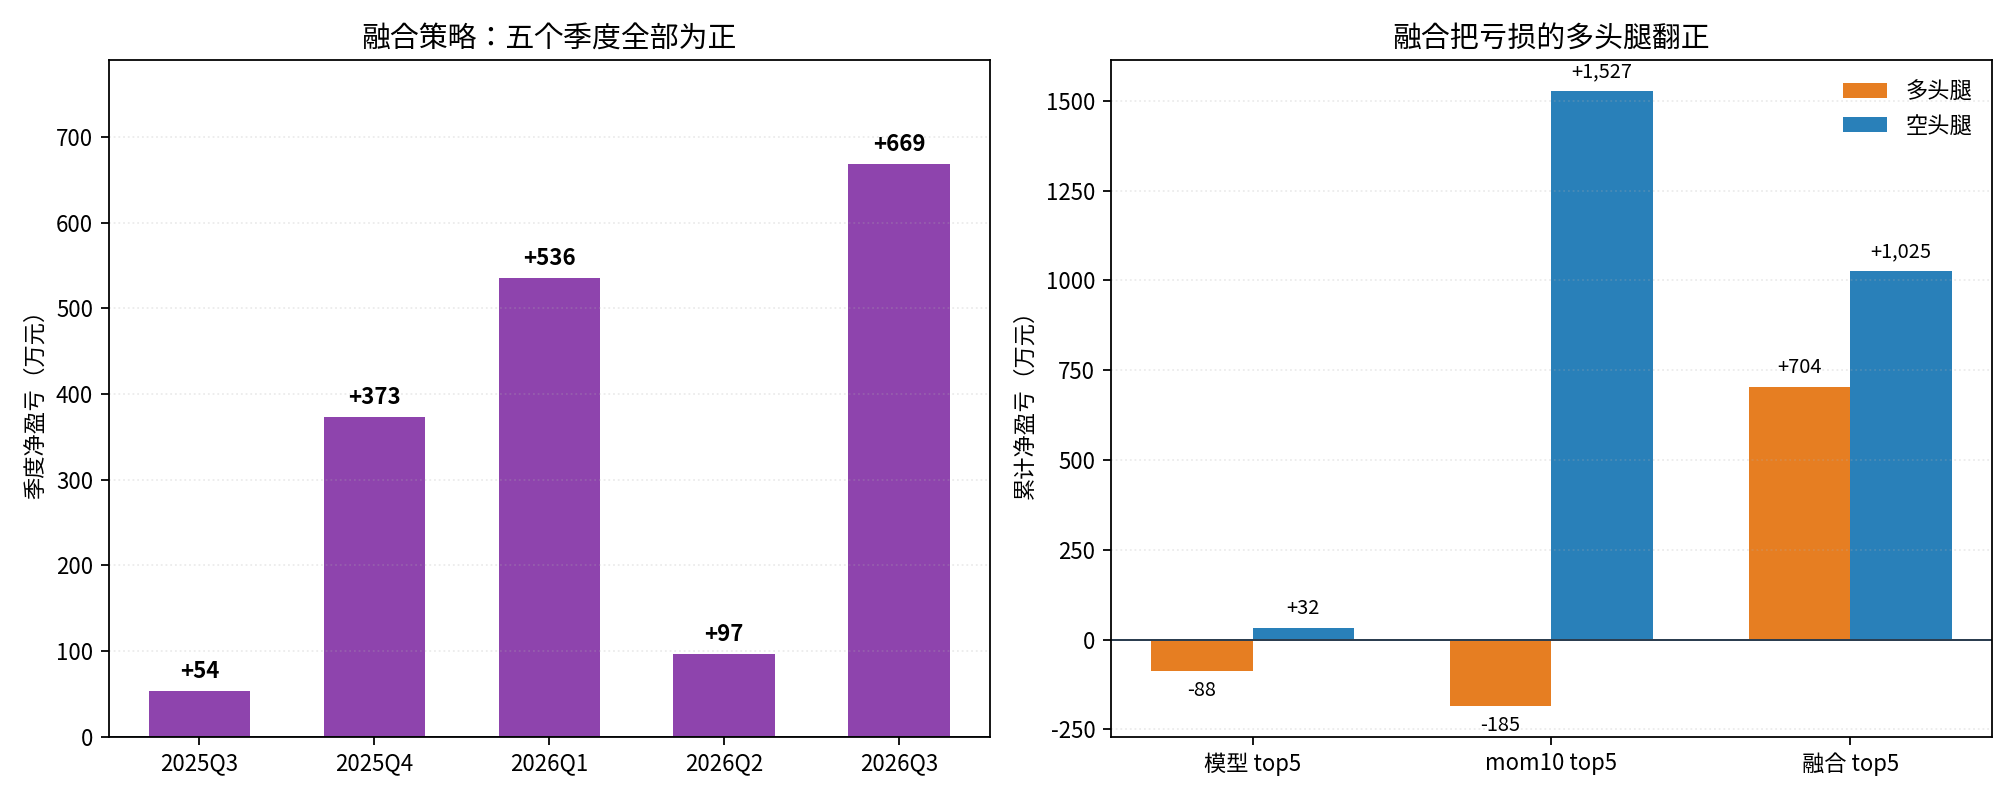
Figura 3: a la izquierda, las ganancias y pérdidas netas trimestrales de la combinación; los cinco trimestres fueron positivos. A la derecha, la comparación de las patas largas y cortas de las tres estrategias: la combinación convirtió en positiva la pata larga de mom10, que tenía pérdidas.
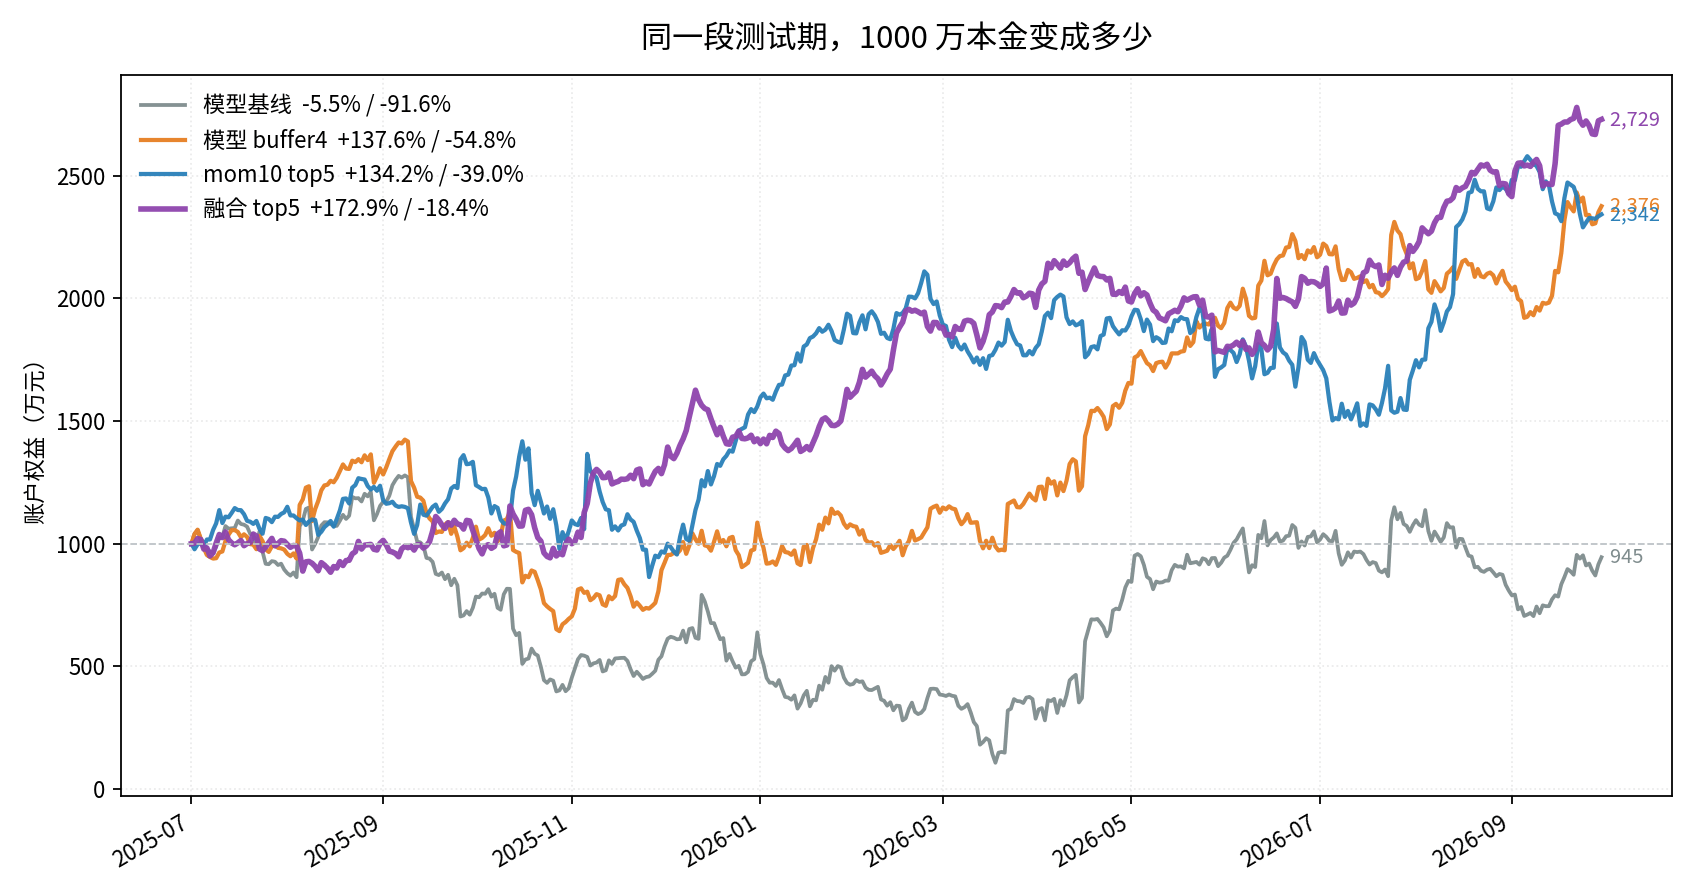
Figura 4: mismo período de prueba y un capital inicial de 10 millones. El valor final de la combinación fue de 27,29 millones, con una caída claramente menor que la de model buffer4 y mom10.
Siete. Añadir buffer y stop loss
También probé una combinación de buffer y stop loss sobre la señal del modelo.
- buffer4 más stop10: +130,86 % de rentabilidad, -16,25 % de caída máxima, Sharpe de 1,906, Calmar de 6,43 y 646 activaciones del stop
- buffer4 más stop35: +151,47 % de rentabilidad, -31,42 % de caída máxima, Sharpe de 1,635, Calmar de 3,85 y 121 activaciones del stop
El stop loss es muy sensible al deslizamiento. Con buffer4 más stop10, un deslizamiento del 1 % da +66,10 % de rentabilidad y -22,76 % de caída máxima; con un 2 % de deslizamiento, queda en solo +1,35 % de rentabilidad y -48,76 % de caída máxima. Con buffer4 más stop35, todavía se obtiene +126,40 % de rentabilidad y -37,00 % de caída máxima con un 2 % de deslizamiento.
Por tanto, si el deslizamiento es bajo, usa stop10; si es incierto, usa stop35.
Hay otro resultado contraintuitivo. La mayoría de los días en que se activa el stop son días con pérdidas. La mejora de la rentabilidad se debe principalmente a la trayectoria de las posiciones después de la activación, no a perder menos ese mismo día. Esto coincide con la conclusión de la entrega anterior: el valor del stop está en limitar las pérdidas posteriores, no en el resultado contable del momento en que se activa.
Atención: esta prueba se hizo sobre la señal del modelo, no sobre la señal combinada. Aún no he probado la combinación con buffer y stop loss.
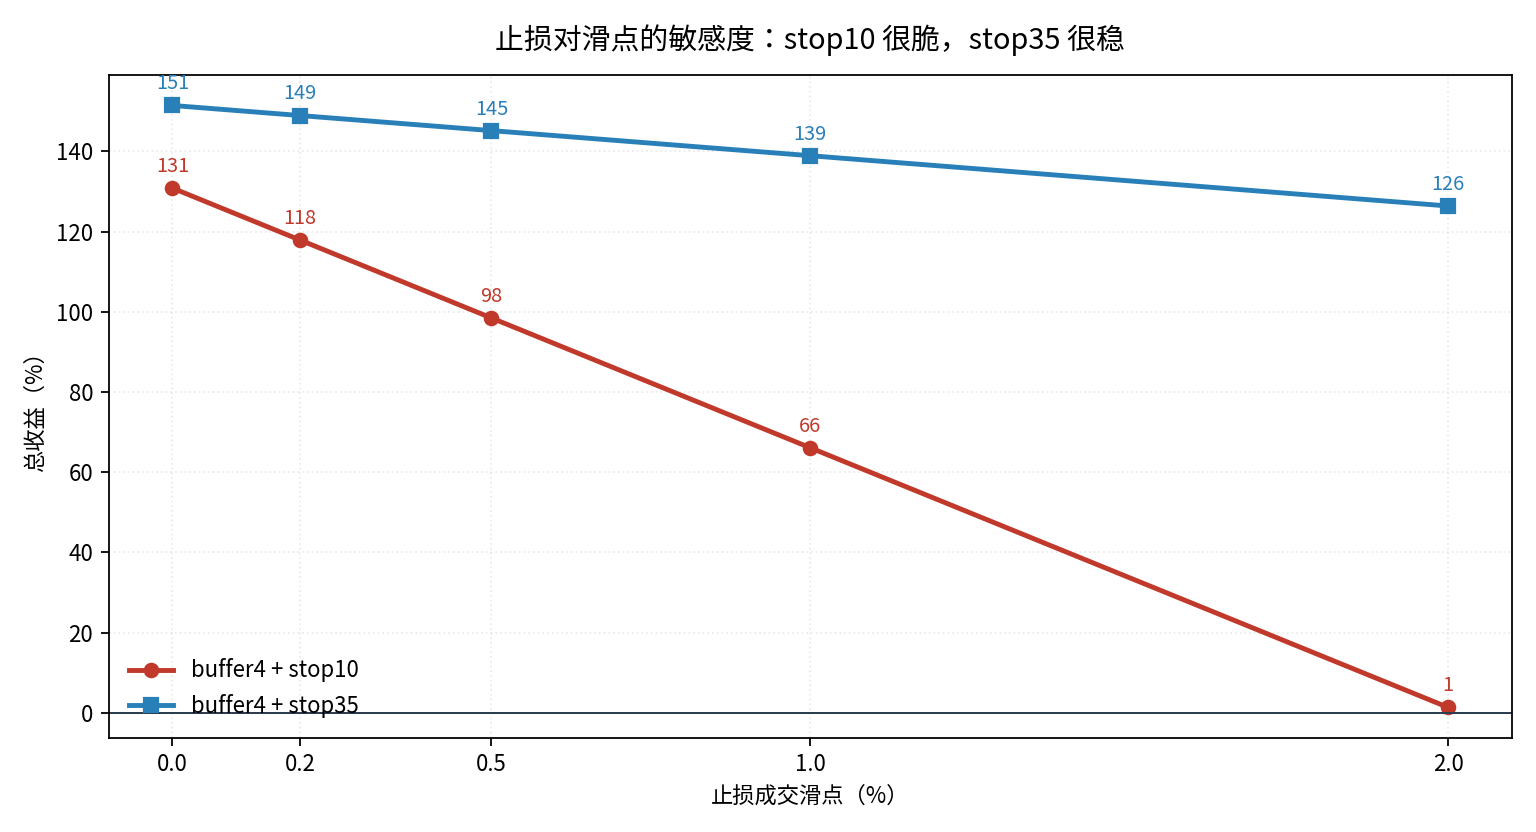
Figura 5: la rentabilidad de stop10 cae del 131 % al 1 %, mientras que la de stop35 baja solo del 151 % al 126 %. Cuantas más veces se activa, mayor es el efecto erosivo del deslizamiento.
Ocho. Límites y próxima entrega
Primero, pongamos las cosas en perspectiva.
Todos los resultados corresponden a un único período de prueba: de julio de 2025 a septiembre de 2026, 457 días. Además, los parámetros se eligieron repetidamente dentro de ese mismo período, así que no es una muestra externa limpia. No se ha probado la sensibilidad del peso 50/50 de la combinación ni de la ventana de mom10. Tampoco se ha combinado la señal con buffer y stop loss. No se ha cuantificado el efecto de activar repetidamente el stop. No se han aplicado filtros para monedas nuevas o con poca liquidez. No se han tenido en cuenta las tasas de financiación, las liquidaciones ni el deslizamiento real.
La rentabilidad de la combinación también está muy concentrada: los primeros 10 días de negociación aportaron el 65,7 % de las ganancias y pérdidas netas. Esta concentración implica que los resultados podrían ser muy distintos en otro período de muestra.
En la próxima entrega conectaré la señal combinada con buffer y stop loss, y la probaré en un período de validación y con walk-forward. Si no se sostiene en el período de validación, el +172,93 % no será más que una cifra vistosa del período de prueba.
Si tú también trabajas en estrategias perpetuas para activos como $BTC o $ETH, puedes empezar comprobando una cosa: ¿la puntuación que se usa para entrenar es la misma que se usa para seleccionar activos? Si no lo es, no ajustes los parámetros todavía; primero alinea la interfaz.
Este laboratorio cuantitativo seguirá compartiendo sus registros, desde los datos y los factores hasta la gestión del riesgo. Si te ha resultado útil, puedes guardarlo. ¡Hasta la próxima!