


Si conversas con un modelo de lenguaje grande durante el tiempo suficiente, ¿puede convertirse en tu «doble digital»?
Autor y fuente del artículo: Xinzhi Yuan
Desde los usuarios virtuales y los entrevistados sintéticos hasta los agentes de IA personalizados, cada vez gana más popularidad una misma línea de desarrollo tecnológico: primero se conoce a una persona real mediante entrevistas, cuestionarios y datos personales; después, se hace que un modelo de lenguaje grande interprete a esa persona y prediga cómo respondería a preguntas que nunca ha visto.
Pero aquí surge una pregunta más difícil: aunque la IA ya haya aprendido cómo piensas ahora, ¿podrá seguir respondiendo como tú ante una situación nueva sobre la que nunca te hayan preguntado?
Para comprobarlo, investigadores del MIT y otras instituciones propusieron HugAgent, que usa modelos grandes basados en entrevistas de participantes reales para predecir sus respuestas ante nuevos contextos como la sanidad universal, la vigilancia pública y la densificación de viviendas. El estudio abarca 54 participantes, 1,742 ítems de evaluación y prueba modelos como GPT, Claude, Gemini, DeepSeek, LLaMA y Qwen. El artículo fue aceptado como Main Oral en EMNLP 2026.
La investigación encontró que las entrevistas personales sí ayudan al modelo a simular con más precisión a una persona concreta. Pero hay un fenómeno más digno de atención: cuanto más tiempo se conversa con una persona, más claro tiene la IA cómo piensa ahora, aunque no necesariamente sabe mejor cómo responderá cuando cambien las condiciones.
Esto también plantea a los «dobles digitales» una pregunta más fundamental: ¿la IA está construyendo un modelo sobre ti, o solo un perfil personal cada vez más detallado?
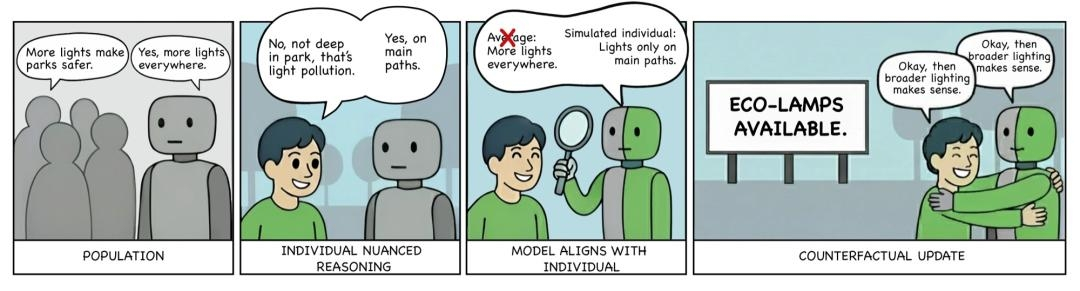
De «parecer una persona normal» a «parecer esta persona concreta». HugAgent va un paso más allá y pregunta: cuando cambian las condiciones, ¿la IA todavía puede seguir representando a esta persona?
Por qué se necesita HugAgent
De «parecer humano» a «parecer esta persona»
En los últimos años, simular humanos con grandes modelos se ha convertido poco a poco en una línea de investigación real. Los investigadores han hecho que los LLM actúen como consumidores, votantes y participantes de experimentos; y, más allá, también han intentado simular a una persona real concreta: construir un «doble digital» mediante entrevistas largas, cuestionarios y datos personales, y luego dejar que la IA siga representando al individuo en nuevas preguntas posteriores.
Esta ruta suena muy natural. Cuanta más información le da una persona a la IA, más la entiende, y en teoría más debería poder predecir sus respuestas.
Pero aquí hay un salto clave:
Describir a una persona y predecir a una persona no son la misma cosa.
Supón que, en una entrevista, una persona dice apoyar la sanidad universal, pero al mismo tiempo le preocupan los costes, la eficiencia y la elección personal. Tal vez el modelo ya pueda determinar con precisión cuál es su postura actual.
Pero, ¿y si las condiciones cambian?
Si el nuevo plan pudiera ahorrarle 3000 dólares al año a su familia, o si aún pudiera conservar un seguro privado, ¿seguiría tomando la misma decisión?
En ese momento, lo que el modelo debe hacer ya no es solo recordar «él apoya la sanidad universal», sino inferir, a partir de expresiones pasadas, qué valora realmente y cómo reequilibrará las cosas cuando cambien distintas condiciones.
Justo eso es lo que HugAgent quiere poner a prueba:
Si construimos una persona suficientemente rica mediante entrevistas, ¿puede predecir cómo responderá esa persona fuera de la entrevista?
Este es un problema inevitable cuando se pasa de «parecer humano» a «parecer esta persona».
HugAgent no solo registra respuestas
Y también sacar a la luz el «por qué»
Para comprobar si la IA puede simular a «una persona concreta», primero hay que saber qué piensa realmente esa persona.
Por eso HugAgent no partió de perfiles públicos ni de texto en internet, sino que volvió a reclutar participantes reales. El equipo eligió tres temas con claras divisiones en Estados Unidos y que además implican una verdadera compensación de valores: sanidad universal, vigilancia pública y densificación de viviendas, es decir, relajar ciertas restricciones de zonificación para permitir construir viviendas más altas y densas. Tras un filtrado de calidad entre más de 120 personas reclutadas, finalmente se conservaron 54 participantes.
Primer paso: cuestionario, para registrar «tu yo actual».
Primero, los participantes completan información demográfica y luego dan una puntuación de apoyo de 1 a 10 a distintos temas. Al mismo tiempo, también deben valorar cuánto influye en su postura una serie de razones.
Por ejemplo, ante la misma oposición a la densificación de viviendas, una persona puede preocuparse sobre todo por el carácter del vecindario y el valor de la propiedad, mientras que otra puede fijarse principalmente en el tráfico, el alquiler o la oferta de vivienda. El «a favor o en contra» final es solo una respuesta; lo que realmente diferencia a unas personas de otras suele ser las razones detrás de esa respuesta y cuán importantes son esas razones.
Toda esta información constituye el belief state (estado de creencias) actual de una persona, es decir, qué postura sostiene ahora y qué razones respaldan esas posturas.
Segundo paso: cambiar las condiciones y registrar «si… entonces qué».
Después, el cuestionario empieza a cambiar una de las condiciones.
Si después de la densificación de viviendas el alquiler local baja entre un 10% y un 15%? ¿Si la sanidad universal puede ahorrarle 3000 dólares al año a una familia? ¿Si las grabaciones de la vigilancia pública solo se guardan durante 48 horas?
Los participantes deben volver a dar su postura en cada nuevo escenario hipotético y volver a evaluar la importancia de las razones relacionadas.
Así, el equipo de investigación no solo sabe cómo piensa una persona «ahora», sino que también registra cómo respondería ella misma cuando cambia cierta condición. El cambio entre ambos estados constituye el belief update (actualización de creencias) que HugAgent quiere predecir.
Lo más importante es que estas respuestas provienen del propio participante. Después, cuando el modelo se examina, no ve directamente la respuesta correcta del contexto objetivo.
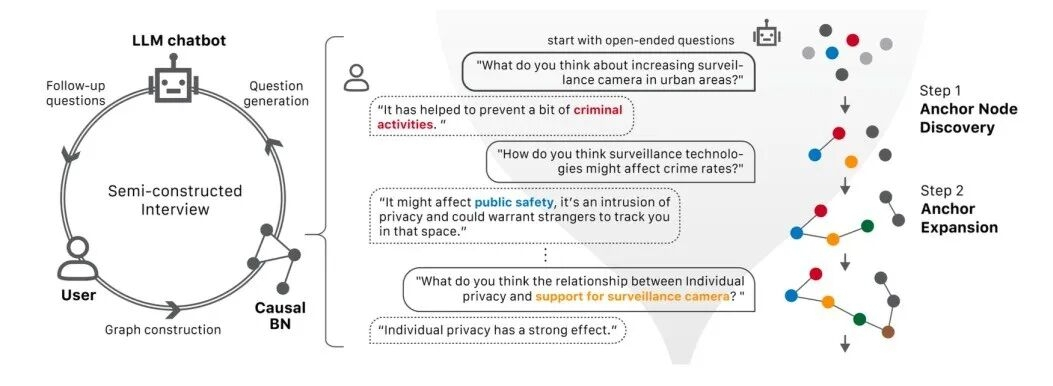
Pie de figura: proceso de entrevista de TraceYourThinking. El sistema parte de preguntas abiertas, construye dinámicamente un grafo de creencias causales según las respuestas del participante y genera automáticamente la siguiente ronda de preguntas de seguimiento, para comprender gradualmente las opiniones de una persona, sus razones y las relaciones entre distintos factores.
Tercer paso: entrevista think-aloud, sacar poco a poco el «por qué».
No basta con registrar las respuestas del cuestionario.
Después, los participantes realizaron una entrevista semiestructurada think-aloud (pensar en voz alta) a través del chatbot de código abierto TraceYourThinking del equipo, pudiendo escribir o hablar directamente, mientras iban explicando sus razones de juicio a medida que pensaban.
No se trata de una lista de preguntas fija de principio a fin.
El robot organiza dinámicamente un «grafo de creencias causales» a partir de lo que el participante ha dicho antes: qué factores mencionó, hacia qué dirección hacen cambiar la postura esos factores y con qué intensidad influyen. Con base en esa información, el sistema genera automáticamente la siguiente pregunta de seguimiento para seguir indagando en lo que aún no quedó claro, en lo contradictorio o en lo que merece profundizarse.
Por ejemplo, si una persona dice preocuparse por el coste de una política, el robot puede seguir preguntando: si el coste bajara, ¿hasta qué punto cambiaría eso tu actitud? Si responde «la verdad, no estoy muy seguro», el sistema también seguirá indagando esa incertidumbre.
«No estoy seguro» también es información.
También puede significar que la postura de esa persona no es firme, o que dos valores están tirando en direcciones opuestas. Frente a una simple puntuación de 1 a 10, una entrevista think-aloud deja pistas mucho más ricas: qué le importa a esa persona, por qué le importa, qué juicios son muy firmes y en qué puntos sigue dudando.
Al final, el modelo recibe la información de fondo sobre esa persona y esta entrevista, pero no la respuesta real que esa persona dio en el contexto objetivo.
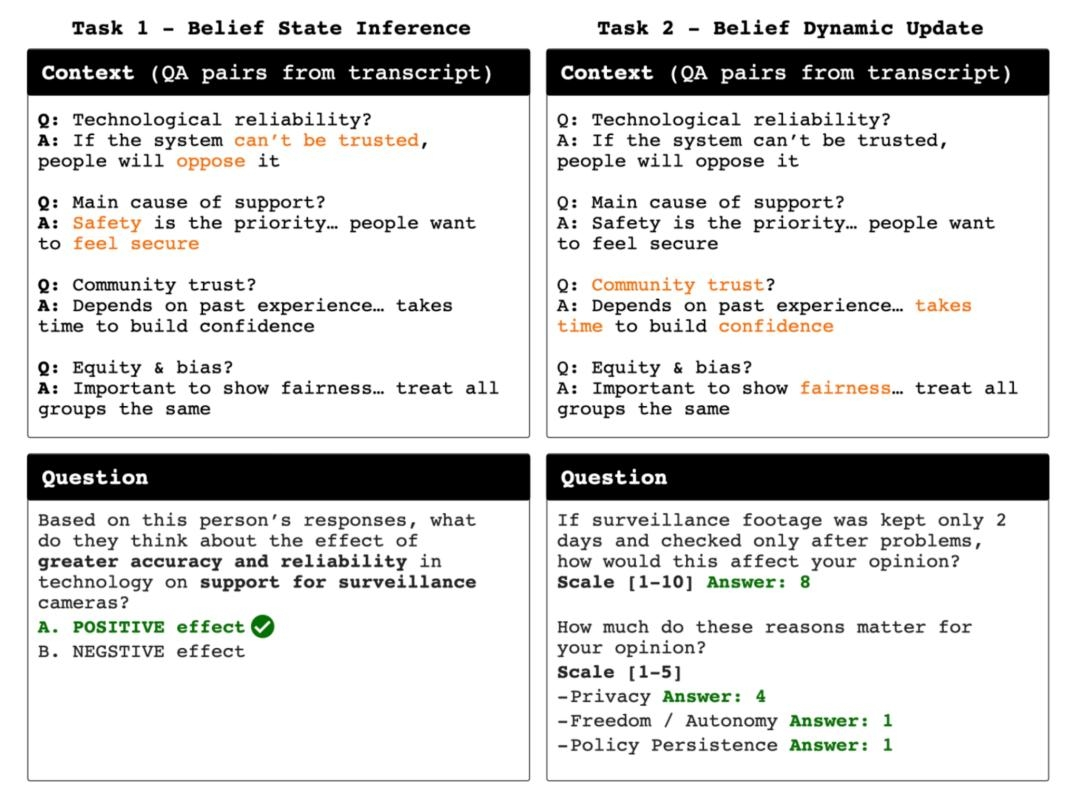
Pie de figura: las dos tareas de evaluación de HugAgent. Belief State Inference infiere las creencias actuales de una persona a partir de la entrevista; Belief Dynamics Update añade un nuevo escenario hipotético y predice cómo cambiarán la postura y las razones de esa misma persona.
HugAgent convierte luego ese material en dos tipos de examen.
La primera clase es Belief State Inference, con 356 preguntas, y prueba si el modelo puede inferir, a partir de la entrevista, creencias que la persona no expresó directamente.
La segunda clase es Belief Dynamics Update, con 1386 preguntas, y prueba si, ante un nuevo escenario hipotético, el modelo puede predecir la nueva postura de la persona y el peso de sus razones.
El benchmark completo contiene 1742 ítems de evaluación.
Para fijar un techo empírico de la tarea, el equipo invitó a parte de los participantes a responder de nuevo las mismas preguntas 14 días después. La consistencia entre las respuestas de los participantes y sus propias respuestas de dos semanas antes fue del 84.84% y del 85.66% en los dos tipos de tareas, y esto se utilizó como ceiling (techo empírico) para comparar los modelos posteriormente.
Llegados aquí, una pregunta que era muy abstracta por fin se vuelve directamente medible:
Si hablamos cada vez más con una persona, ¿su «doble digital» también irá cada vez mejor prediciéndola?
Resultado central: entender «tu yo actual» es fácil; cuando cambian las condiciones, se vuelve difícil
El resultado más intuitivo de HugAgent es que el rendimiento del modelo en las dos tareas se separa claramente.
En Belief State Inference, el mejor método alcanzó una precisión del 77.56%, mientras que GPT-4o obtuvo un 74.66%. Cuando los participantes respondieron de nuevo las mismas preguntas 14 días después, su auto-consistencia fue del 84.84%, que el artículo usa como ceiling empírico para esta tarea.
En Belief Dynamics Update (actualización dinámica de creencias), el mejor Claude Sonnet 4.5 alcanzó el 68.61%, LLaMA 3.3 70B el 67.57% y GPT-4o el 63.11%; el ceiling empírico correspondiente fue del 85.66%.
Es decir, dentro de cada configuración de evaluación, los modelos grandes ya son bastante buenos extrayendo de la entrevista «qué piensa ahora» una persona, pero frente a un nuevo contexto al que nunca había respondido antes, todavía están bastante lejos de la respuesta del propio participante.
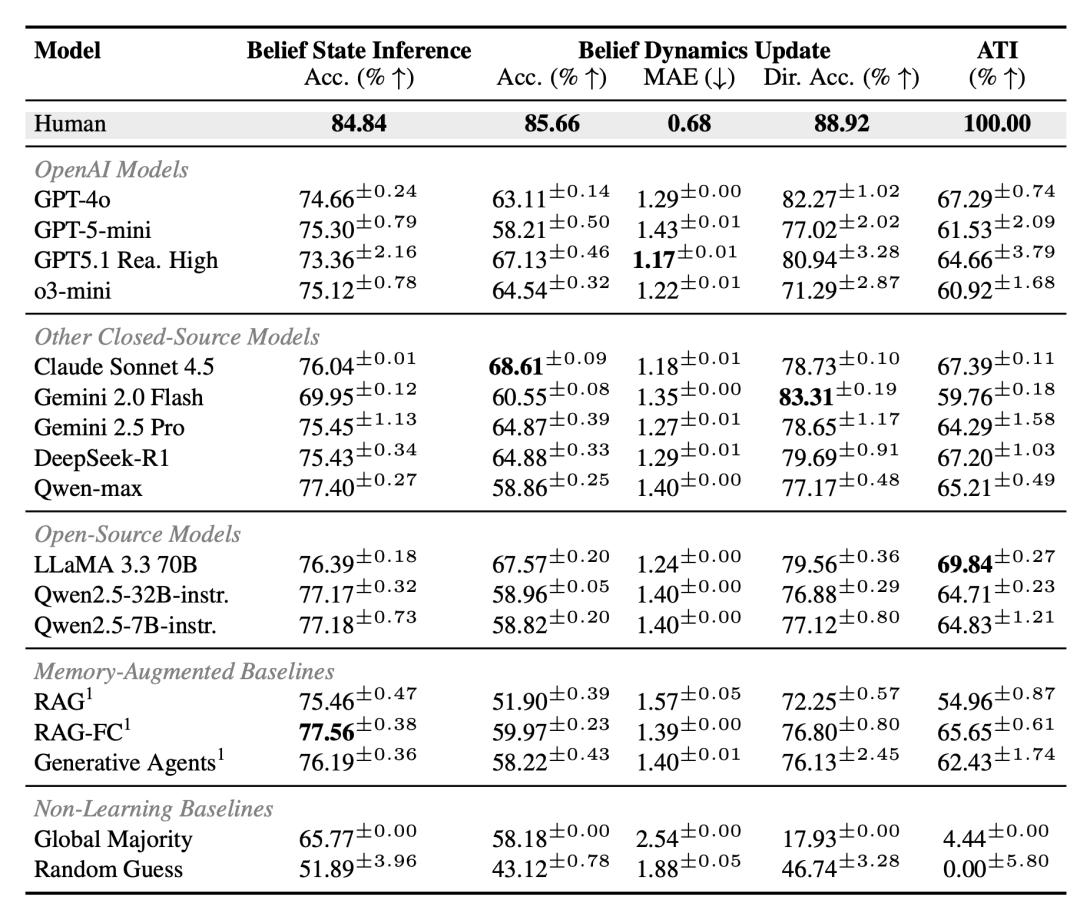
Pie de figura: rendimiento global de distintos modelos en las dos tareas de HugAgent. En comparación con inferir las creencias actuales de una persona, los modelos todavía quedan más lejos del techo de consistencia del propio participante cuando predicen respuestas en nuevos contextos.
Sin embargo, eso no significa que las respuestas en nuevos contextos no puedan predecirse en absoluto a partir de la entrevista.
Tomando GPT-4o como ejemplo, si no se proporciona entrevista personal y solo se depende de información demográfica y similar, la precisión en Belief Dynamics Update es de solo 39.83%; al añadir la entrevista completa de esa persona, sube al 63.11%.
Qwen2.5-32B también mostró un cambio similar, al subir del 32.12% al 58.96%.
Es decir, la entrevista no solo añade al modelo un contexto más largo. Lo que esa misma persona dijo realmente sí contiene información individual sobre cómo responderá después.
Experimentos cross-person adicionales también dieron resultados similares: si se sustituye la entrevista de la propia persona por la de otra, la precisión de GPT-4o en la tarea de actualización cae al 39.30%, casi volviendo al nivel de no tener entrevista personal.
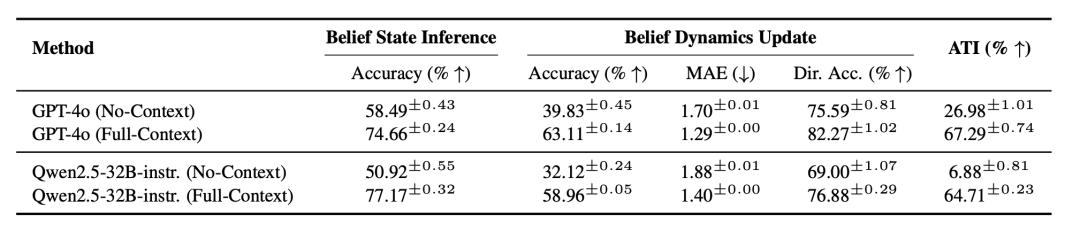
Pie de figura: comparación entre el rendimiento sin entrevistas personales y el rendimiento tras incorporar la entrevista completa de la propia persona. La entrevista personal mejora claramente la capacidad del modelo para predecir a participantes concretos.
Si la entrevista sirve, una idea muy natural es: entonces, hablemos un poco más.
Si el doble digital es principalmente una cuestión de cantidad de información, entonces 5 rondas de entrevista deberían rendir peor que 10, y 10 peor que una entrevista completa.
Pero HugAgent no encontró esa relación estable.
Tomando Qwen2.5-32B como ejemplo, a medida que aumenta el contenido de la entrevista, la precisión de Belief State Inference sube del 68.84% al 73.02%, y finalmente alcanza el 77.17%.
Pero el Belief Dynamics Update no mejoró al mismo tiempo; al contrario, pasó del 61.79% al 60.73%, y con la entrevista completa quedó en 58.96%.
Eso no quiere decir que las entrevistas no sirvan. Los experimentos anteriores ya muestran que la diferencia entre «no conocer a esta persona» y tener la entrevista de la propia persona es muy clara.
Lo verdaderamente digno de atención es esto:
Pasar de no tener información personal a tenerla es importante, pero seguir acumulando materiales sobre una persona no implica automáticamente una predicción más precisa de nuevos contextos.
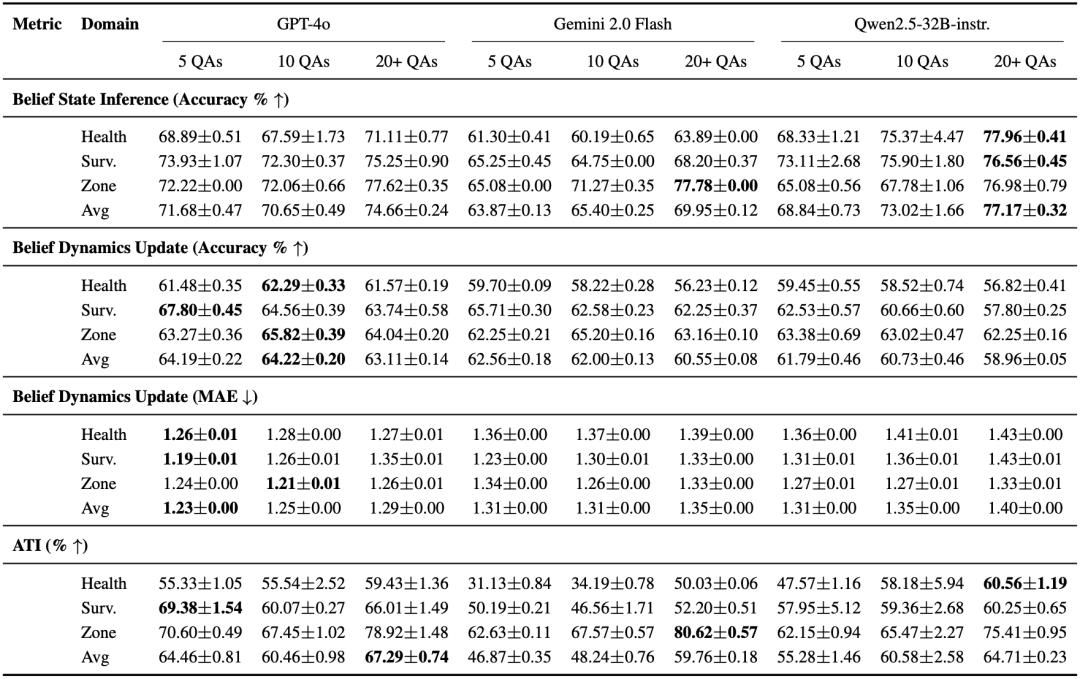
Rendimiento del modelo con distintas longitudes de entrevista. Más contexto puede dar más pistas sobre las creencias actuales, pero no produjo una mejora igualmente estable en la predicción de respuestas en nuevos contextos.
Si desglosamos más, también se pueden ver algunas pistas de dónde está exactamente la dificultad para el modelo.
Predecir el cambio de una persona puede descomponerse, de forma aproximada, en dos preguntas: si cambiará o no, y, si cambia, hacia qué dirección lo hará.
Al menos en el ámbito médico, una vez que GPT-4o determina que la actitud de una persona cambiará, la precisión al predecir la dirección del cambio alcanza el 88.89%; pero al juzgar si esa persona realmente cambiará o no, la precisión es solo del 49.36%.
Esto indica que el modelo suele saber hacia qué dirección empujará la actitud la nueva información; lo más difícil quizá sea otra pregunta:
¿Qué tipo de cambio basta de verdad para que esta persona cambie de opinión?
Una posible razón es que la entrevista revela con relativa facilidad qué factores le importan a una persona y, en líneas generales, hacia qué dirección empujan su postura; pero en qué punto exacto tiene esa persona un «umbral de cambio» mayor o menor es mucho más difícil de inferir a partir de expresiones previas.
La verdadera prueba del doble digital
Tras ver estos resultados, lo que deja HugAgent no es solo un ranking de modelos GPT, Claude o Gemini. Más importante aún, pone sobre la mesa una pregunta en la investigación sobre «dobles digitales» que se suele pasar por alto con facilidad:
Que un modelo reproduzca tu pasado con gran fidelidad no demuestra automáticamente que pueda representar tus respuestas futuras.
Esta distinción es especialmente importante para human simulation.
Si la IA solo se usa para resumir las opiniones ya conocidas de una persona, quizá una persona suficientemente detallada ya sea muy útil. Pero cada vez más aplicaciones quieren hacer mucho más que eso. Los investigadores quieren usar participantes sintéticos para probar políticas aún no publicadas, quieren que consumidores simulados juzguen cómo reaccionaría un producto nuevo y también quieren que agentes personalizados gestionen nuevas elecciones que el usuario nunca había enfrentado.
Todos estos usos tienen un supuesto común:
El modelo debe ser capaz de extrapolar desde la información personal ya observada hacia contextos sobre los que no se preguntó directamente.
Y es precisamente ahí donde comienza la verdadera prueba del doble digital.
Repetir opiniones conocidas es solo el punto de partida. El verdadero valor de un doble digital es que, incluso cuando cambian las preguntas y cambian las condiciones, siga pudiendo representar a esa persona.
Si un modelo solo puede reproducir cada vez con más fidelidad las opiniones que ya aparecieron en la entrevista, entonces se parece más a un expediente personal muy detallado. La verdadera dificultad es esta: cuando cambian las condiciones y aparece por primera vez una elección desconocida, ¿puede seguir avanzando a partir de los motivos y las compensaciones de esa persona?
Los resultados de HugAgent muestran que este paso no puede darse por sentado.
Las entrevistas personales sí aportan información valiosa sobre el individuo, pero más entrevistas no se traducen de forma estable en predicciones más precisas en contextos no vistos. Al construir futuros dobles digitales, la pregunta quizá no sea solo «cuántos datos más hay que recoger», sino también:
¿Qué hay que saber exactamente sobre una persona para predecir cómo juzgará algo ante una pregunta que nunca antes respondió?
Por supuesto, lo que HugAgent mide por ahora sigue siendo autorreporte en escenarios hipotéticos, no cambios reales y de largo plazo en el comportamiento y las opiniones del mundo real. Responde a esto: según la entrevista de una persona y sus respuestas previas, ¿se puede predecir cómo responderá ante un escenario hipotético que nunca había visto antes? Y la distancia entre el modelo y el 100% tampoco puede explicarse por completo como falta de capacidad del modelo. Las respuestas humanas fluctúan por sí mismas, y algunas preguntas hipotéticas quizá tampoco tengan una única respuesta deducible a partir de la información ya disponible.
Por eso, la pregunta que queda al final puede ser más fundamental que cualquier puntuación concreta de benchmark:
¿Qué evidencia deberíamos usar para creer que una IA realmente es suficiente para «representar» a alguien?
¿Es que puede repetir las opiniones de esa persona?
¿Puede responder a varias preguntas de cuestionario que nunca había visto?
¿O solo cuando el entorno y las condiciones cambien, y aun así pueda tomar decisiones similares a las del propio individuo, deberíamos empezar a llamarlo un doble digital fiable?
Los modelos grandes cada vez son mejores almacenando nuestras preferencias, nuestro lenguaje y nuestras experiencias.
Pero pasar de un expediente detallado de «sobre mí» a un modelo que realmente pueda representarme en situaciones desconocidas todavía puede dejar una distancia bastante larga.
Entrevistar a una persona puede ser ya suficiente para que la IA se parezca cada vez más a ella.
Pero «parecerse a él» y «poder representarlo» siguen siendo dos cosas distintas.