

El 19 de septiembre, Rayls publicó un artículo (Privacy has a price). En el título decía honest math, pero todo el texto solo ofrecía un rango numérico: que una prueba requiere desde unos cientos de milisegundos hasta unos segundos. Durante varias semanas seguidas estuve escribiendo sobre la arquitectura de privacidad de Rayls; esta vez comparto contenido nuevo con ustedes. Descargué el código de las pruebas que hizo público, lo ejecuté decenas de veces y les comparto esta conclusión interesante.
Primero, hablemos de qué trató el blog. Su argumento central se puede resumir en dos frases. La primera es dónde está el costo: las transacciones confidenciales son más caras que las transparentes; lo caro está en generar las pruebas de conocimiento cero, mientras que verificar resulta más barato. Una prueba para un traspaso confidencial básico, en hardware comercial común, tarda de cientos de milisegundos a unos segundos. La segunda frase es qué deberíamos preguntar: las instituciones no deberían enfocarse solo en el TPS, sino en cuál es el rendimiento cuando se consideran la privacidad y el nivel de auditoría que realmente necesitan, además de la carga de trabajo de negocio real. El blog sostiene que el volumen de las liquidaciones entre instituciones no es grande y que está completamente dentro de la capacidad de los sistemas de liquidación confidencial.
Esta entrada hace algo muy simple: tomar el problema que el blog plantea y llevárselo a Enygma para preguntarle con su código público. En lo que sigue, todo lo que esté escrito como «el blog dice» es una afirmación del texto original; lo que esté escrito como «yo medí» o «yo calculé» son mis resultados y deducciones; por favor, miradlos por separado.
Cómo lo medí
Las pruebas de conocimiento cero se pueden entender como un documento matemático: el pagador no publica el saldo ni el monto, pero puede demostrar a la red que esta operación es correcta. El sistema de pruebas que usa Enygma se llama Groth16. El código del servicio que genera pruebas es de código abierto en el repositorio rayls-sovereign-gnark-api en GitHub. El README describe su función como la interfaz de pruebas usada detrás de Privacy Ledger y Private Network Hub.
Lo que medí fue la última confirmación 67c4c26 del branch main el 22 de septiembre de 2026. No se cambió ni una línea del código del circuito ni del código de pruebas. Solo escribí algunos archivos de prueba adicionales para llamar a las funciones de generación de pruebas del propio repositorio; los datos de transacciones alimentados también provienen del conjunto de pruebas incluido en el repositorio, con una pareja para k=2 y otra para k=6.
Aquí k es el tamaño del conjunto anónimo. Según el código del circuito, una transferencia genera un compromiso de monto para cada uno de los k participantes; el emisor se oculta dentro de ese conjunto y los observadores no pueden saber quién paga a quién. Cuanto mayor sea k, más profundo es el ocultamiento y también más grande es el circuito. El script de pruebas de carga incluido en el repositorio usa k=6.
La clave la generé en mi propio equipo usando el mismo groth16.Setup con el mismo circuito. Esto no afecta al tiempo, porque el tiempo de generación depende de la estructura del circuito y no de los valores concretos de la clave. El README del repositorio también lo indica: esas claves del repositorio son un producto de desarrollo y pruebas generado con Setup unilateral, y no el resultado de un ritual de configuración confiable multiparte; el despliegue en producción requiere otro ritual, lo cual coincide con lo que el blog dice sobre que Groth16 necesita una configuración confiable.
El entorno de prueba es una máquina virtual Linux de un solo núcleo, Intel Xeon 2.1GHz, 3GB de memoria. Para cada escala se generan 20 pruebas consecutivas; después, tras unos minutos se vuelve a correr todo para la segunda ronda.
El valor medido
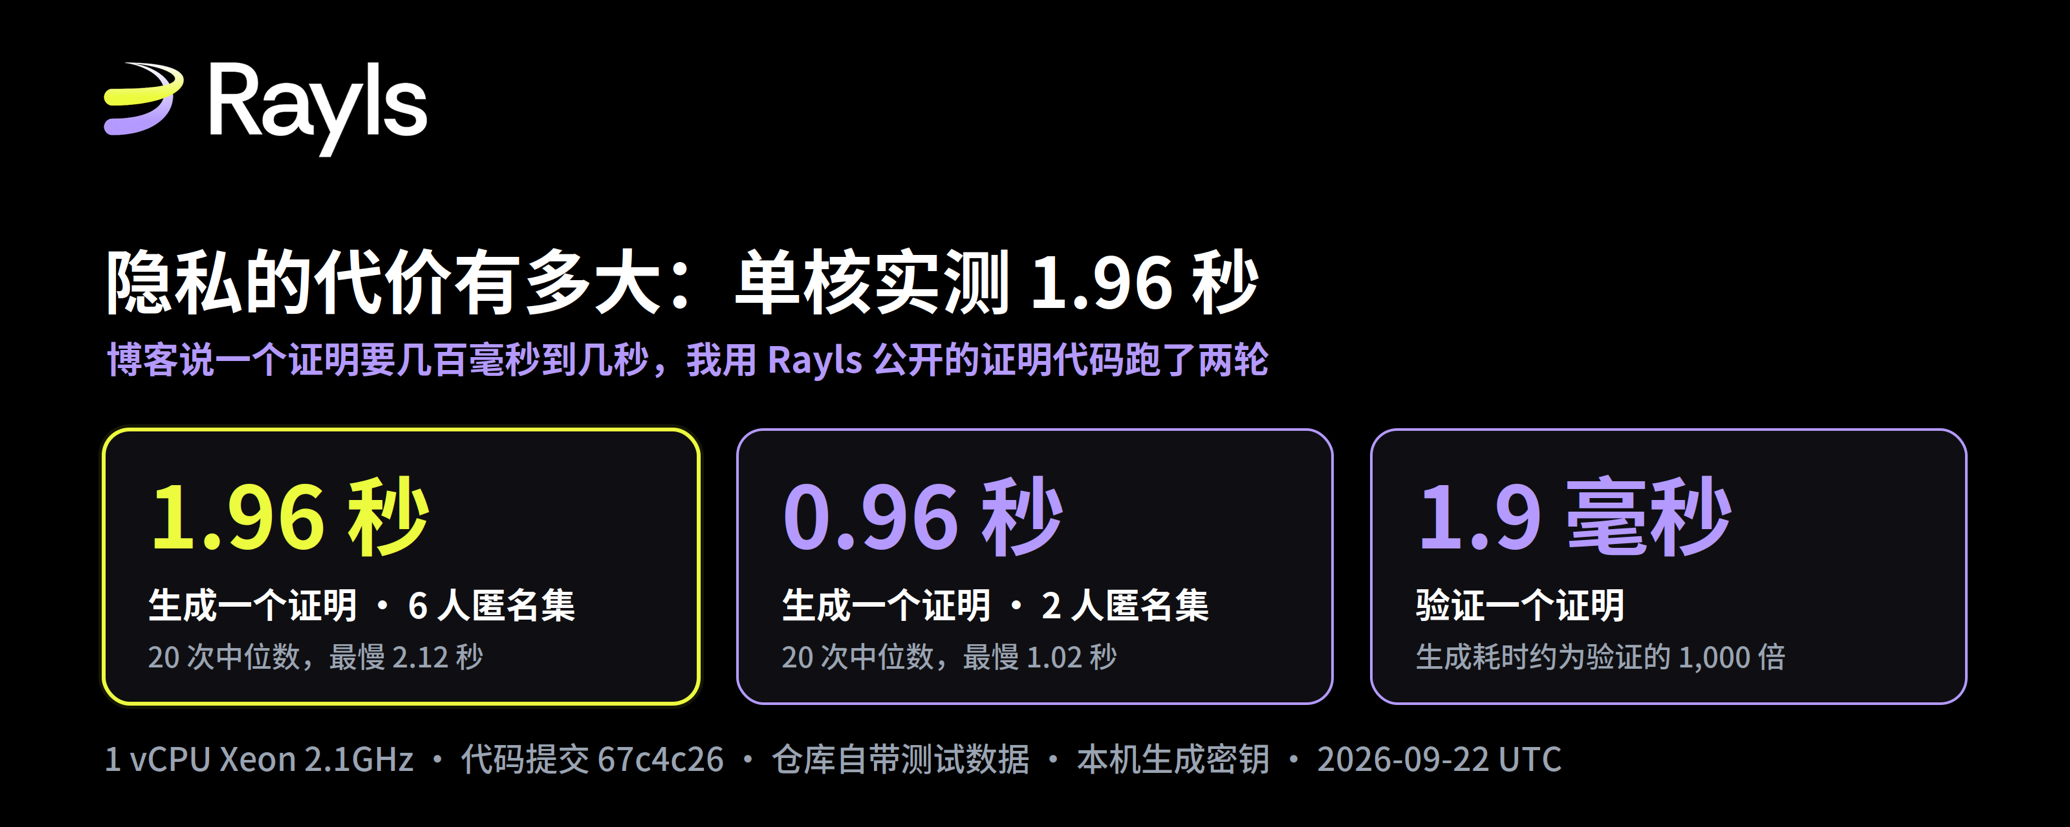
Resultados de la segunda ronda: para k=6, una mediana de 1.96 segundos en 20 pruebas; el más rápido fue 1.94 s y el más lento 2.12 s. Para k=2, la mediana es 0.96 s. La primera ronda fue 1.97 s y 0.96 s, respectivamente; la diferencia entre las dos rondas es de menos del 1%. Verificar una prueba solo tarda 1.9 milisegundos.
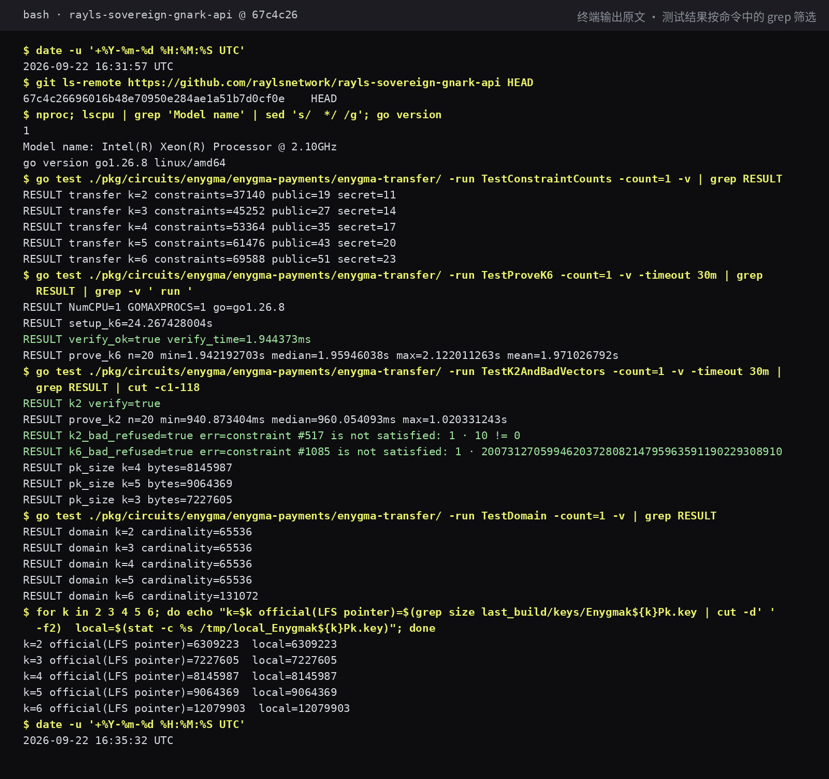
Estos números caen dentro del intervalo que dio el blog. Lo más importante, sin embargo, es la proporción entre generación y verificación: 1.96 segundos frente a 1.9 milisegundos, aproximadamente 1,000 a 1. El blog afirma que el tiempo se dedica principalmente a la generación y que la verificación es muy barata; esta proporción convierte la palabra «principalmente» en un multiplicador concreto.
También hice una comprobación inversa. El conjunto de pruebas incluye dos grupos de datos modificados a propósito: el grupo de k=2 cambia un monto de transferencia de 0 a 10, y el grupo de k=6 altera un valor hash. Ambos grupos fueron rechazados en la fase de prueba; se reportó respectivamente que no se cumplían las restricciones de la regla 517 y la regla 1085, y no se pudo generar ninguna prueba. Esto, por supuesto, no prueba que el circuito no tenga vulnerabilidades; solo indica que estas dos modificaciones evidentes se detienen.
Detalles que no aparecen en los dos blogs
El primer detalle es la escala del circuito. Por cada participante adicional, el número de restricciones aumenta de forma fija en 8,112. De k=2 con 37,140, sube línea por línea hasta 69,588 en k=6. Pero el sistema de pruebas asigna el espacio de cálculo al circuito redondeando a potencias de dos: de k=2 a k=5 cabe dentro de 65,536; en k=6 se excede en 4,052 y la escala de cómputo pasa directamente a 131,072.
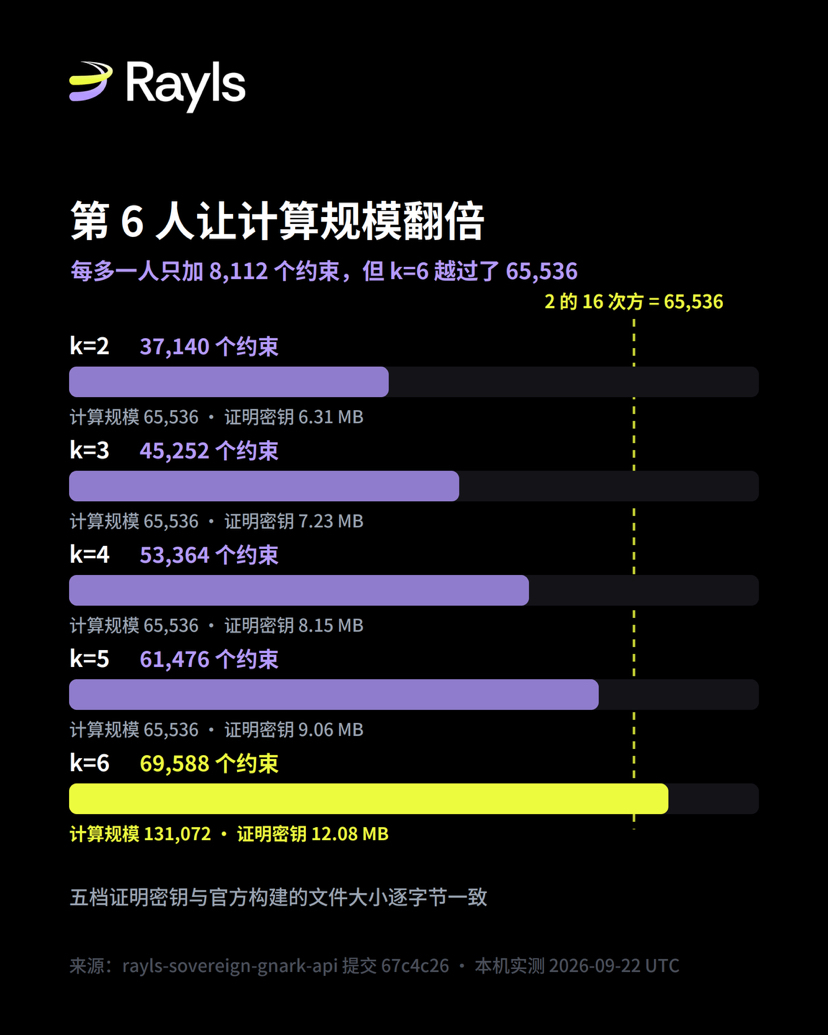 La evidencia está en el tamaño de los archivos de las claves de prueba. De k=2 a k=5, el tamaño de la clave aumenta de forma estable en 918,382 bytes por cada tramo; de repente, al pasar a k=6, aumenta en 3,015,534 bytes, más del triple que cualquiera de los tramos anteriores. La dirección del tiempo también coincide: del k=2 al k=6 hay un aumento del 104% en el tiempo de prueba (aprox. 87% más restricciones). Cuánto tiempo extra cuesta esa travesía de frontera por separado hay que esperarlo a los datos de transacciones entre k=3 y k=5 para poder desglosarlo; el repositorio solo ofrece k=2 y k=6, así que lo que ahora puedo confirmar es que la dirección coincide. Si el entorno de producción usa k=6, entonces está justo al otro lado de esa frontera: el coste de pasar de k=5 a k=6 sería mayor que el entre tramos anteriores; esta es mi deducción, no una afirmación del blog.
El segundo detalle es la consistencia. De las cinco claves de prueba por tramos que generé a partir del código fuente público, el tamaño de los archivos y los productos de compilación oficiales registrados en el repositorio coinciden exactamente byte por byte; la clave de verificación para k=6 también coincide. El contenido de las claves necesariamente es distinto, porque cada Setup vuelve a generar aleatoriamente; pero el tamaño coincide exactamente. Eso indica que la estructura del circuito compilada a partir del código fuente público es la misma que la del montaje oficial. En el artículo anterior mencioné que, durante la auditoría de Axyl, hay una parte de historial que no se puede rastrear entre el repositorio público y la versión privada usada en la auditoría. En esta parte del servicio de pruebas, al menos coincide entre el código fuente y la construcción oficial; si la construcción oficial coincide o no con el despliegue de producción, los materiales públicos todavía no lo responden.
把博客的问题代进真实负载
Conectemos con el artículo anterior. En esa entrada desglosé el origen de varios números de más de 15,000 TPS; describen la capa de consenso de Axyl. Esta vez se midió otra capa: el tiempo de pruebas que cada transacción confidencial necesita gastar primero en el lado del emisor. Los números de estas dos capas no se pueden sumar ni intercambiar.
El orden de magnitud que pone el blog es: miles de transacciones al día para relaciones entre grandes intermediarios; y decenas de miles de transferencias de alto valor al día para un servicio de liquidación en tiempo real de valor tokenizado de nivel banco central. Yo lo cambié por datos públicos de dos sistemas existentes. El Fedwire Funds Service de la Fed registra un promedio diario de 869,187 operaciones en 2025; CHAPS del Reino Unido un promedio diario en todo 2025 de 210,483 operaciones. Estas cifras son decenas de veces y varias veces, respectivamente, las que se usan como ejemplo en el blog.
Lo que calculé a continuación no es lo que dice el blog. Según una verificación con un solo núcleo, 1.96 segundos por una prueba con k=6, un núcleo genera como máximo unos 44,000 al día. Sustituir todas las transacciones diarias medias de Fedwire de 2025 por pruebas con k=6 requiere unas 473 horas-núcleo, equivalentes a 20 días completos ininterrumpidos de un núcleo. CHAPS necesita unas 115 horas-núcleo, menos de 5. Los materiales de presentación del Banco de Inglaterra de 2021 registran que el récord de número de operaciones de CHAPS en un día fue 320,034 el 29 de marzo de 2018, aproximadamente 1.7 veces el promedio diario de ese año; calculando con ese pico, se necesitarían solo unas 174 horas-núcleo.
Hay que aclarar el criterio de esta deducción. Convierte a «un núcleo por cada prueba», y las pruebas son independientes entre sí, por lo que se pueden asignar a distintos núcleos y generar en paralelo. Lo que calcula son las pruebas de la transferencia en sí; el registro, la extracción y el DvP pertenecen a otros circuitos. La transmisión de red y la liquidación on-chain no están incluidas. Además, el blog dice que las pruebas las genera el emisor, es decir, la carga está naturalmente distribuida en los nodos de cada institución, y no concentrada en una sola máquina.
Así que mi conclusión es: lo que el blog afirma—que el volumen de liquidación entre bancos está dentro del alcance de capacidad del sistema de liquidación confidencial—sigue siendo válido incluso con el volumen real. El blog usa un volumen que es menor que el de los sistemas reales; aun así, si se introducen cifras reales en su conclusión, esta sigue sosteniéndose, lo cual resulta más convincente que el ejemplo del texto original. En la sección de pagos minoristas, el blog admite que ese es el cuello de botella real; los números de esta vez no cambian ese juicio.
Cómo se debe usar este conjunto de números
Todos los números de esta vez provienen de un solo núcleo; podéis tomarlos como una referencia algo conservadora. La razón está en el código: cuando gnark genera una prueba, la multiplicación escalar de varias entradas que pesa más divide el trabajo en varias tareas para calcular en paralelo según el número de núcleos CPU de la máquina (se lee directamente runtime.NumCPU() en backend/groth16/bn254/prove.go). Los servidores de las instituciones normalmente tienen varios núcleos: una misma prueba se reparte entre más núcleos y el tiempo sería menor que el de los resultados de un solo núcleo aquí; cuánto más rápido puede ser depende del número de núcleos y del rendimiento de un solo núcleo.
El rango de medición de este artículo es la generación de pruebas de demostración del circuito de transferencias. En la cadena completa de servicio HTTP también hay parseo de JSON y gastos de red; el registro, la extracción y el DvP son otras clases de circuitos. Que el tamaño de las claves sea el mismo indica que la estructura del circuito es la misma, pero no implica que el contenido de las claves sea el mismo; esto ya se explicó antes.
Mi punto de vista
El título del blog es honest math, pero los números que da en el cuerpo son solo un intervalo. Ejecutando esto, el intervalo es correcto y la conclusión sobre la parte de liquidación entre bancos también se sostiene.
Lo que más me gustaría ver es el siguiente paso. La página de benchmarks de Axyl especifica condiciones como un comité de cuatro nodos y transacciones de 512 bytes; el rendimiento de las pruebas de Enygma merece el mismo trato: cuando se publiquen los números la próxima vez, hay que indicar el valor de k y la configuración de hardware para que las instituciones puedan reproducirlo por sí mismas, como yo. Ese es exactamente el tipo de afirmación de rendimiento que, según dice el blog al final, aguanta la validación en producción. Reproducirlo no es difícil; los comandos en la captura son el procedimiento completo.
Fuentes de referencia: Blog oficial de Rayls (Privacy has a price: the honest math behind confidential settlement at scale) (19 de septiembre de 2026); GitHub raylsnetwork/rayls-sovereign-gnark-api, commit 67c4c26 (leído y probado el 22 de septiembre de 2026); estadísticas anuales del Fedwire Funds Service de la Fed (actualizado el 26 de enero de 2026); Banco de Inglaterra: Payment and settlement statistics y (A brief introduction to RTGS and CHAPS) (edición 2021).