Seguí volviendo a una cosa al probar el comportamiento del fork de DUSK Network: el propio número de forks me dice menos que la confianza detrás de ese número. @Dusk
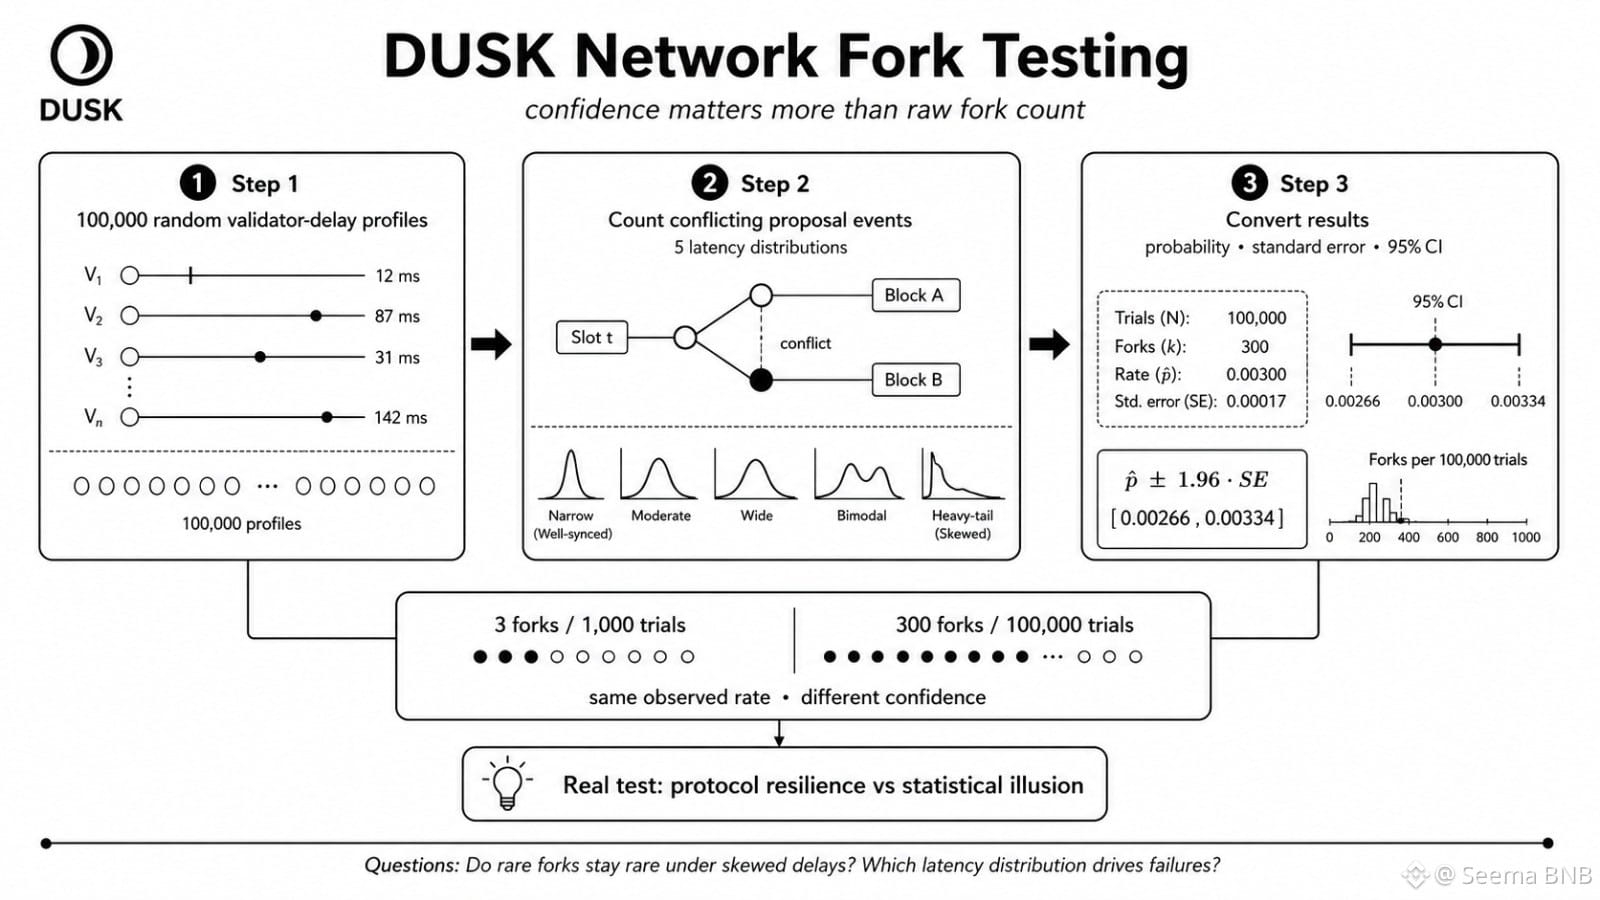
Tres forks en 1,000 ensayos se ve parecido a 300 forks en 100,000 ensayos. Misma tasa observada. Evidencia muy diferente.
Por eso no me detendría en un solo resultado de simulación.
Para DUSK Network, el Paso 1 debería generar 100,000 perfiles aleatorios de retraso de validadores. El Paso 2 debería reproducir condiciones de propuestas en conflicto a través de varias distribuciones de latencia, no un único modelo de red conveniente. Luego el Paso 3 convierte esos conteos de forks en probabilidad, error estándar e intervalos de confianza del 95%.
El problema oculto no es actividad versus inactividad. Es la resiliencia del protocolo versus la ilusión estadística.
¿Los forks raros se mantienen raros cuando los retrasos de los validadores se vuelven sesgados? ¿Una distribución de latencia domina los fallos? ¿El intervalo de confianza se reduce lo suficiente como para confiar en la estimación, o seguimos mirando ruido?
Alguna debilidad es normal. Los sistemas distribuidos son un caos, las redes se bloquean, los paquetes llegan tarde.
Mi duda es si DUSK Network sigue siendo estable cuando el modelo de retraso deja de ser “amigable”.
Una tasa baja de forks importa. Saber qué tan incierta es esa tasa importa más.
#dusk $DUSK
Tres forks en 1,000 ensayos se ve parecido a 300 forks en 100,000 ensayos. Misma tasa observada. Evidencia muy diferente.
Por eso no me detendría en un solo resultado de simulación.
Para DUSK Network, el Paso 1 debería generar 100,000 perfiles aleatorios de retraso de validadores. El Paso 2 debería reproducir condiciones de propuestas en conflicto a través de varias distribuciones de latencia, no un único modelo de red conveniente. Luego el Paso 3 convierte esos conteos de forks en probabilidad, error estándar e intervalos de confianza del 95%.
El problema oculto no es actividad versus inactividad. Es la resiliencia del protocolo versus la ilusión estadística.
¿Los forks raros se mantienen raros cuando los retrasos de los validadores se vuelven sesgados? ¿Una distribución de latencia domina los fallos? ¿El intervalo de confianza se reduce lo suficiente como para confiar en la estimación, o seguimos mirando ruido?
Alguna debilidad es normal. Los sistemas distribuidos son un caos, las redes se bloquean, los paquetes llegan tarde.
Mi duda es si DUSK Network sigue siendo estable cuando el modelo de retraso deja de ser “amigable”.
Una tasa baja de forks importa. Saber qué tan incierta es esa tasa importa más.
#dusk $DUSK