


EE. UU. ha pasado tres años, aplicando cuatro rondas de controles de exportación, abarcando 24 categorías de equipos semiconductores y más de 140 entidades en listas negras, intentando cortar el acceso de China a chips avanzados de AI. Pero según un informe publicado el 24 de marzo por la Comisión de Revisión de Seguridad Económica EE. UU.-China (USCC), el 80% de las startups de AI estadounidenses están utilizando modelos de código abierto de China.
La pared se construye en la capa de hardware. La puerta se abre en la capa de software.
Este conjunto de contradicciones no es una discusión política abstracta. Justo la semana pasada, se descubrió que el valor de la herramienta de programación AI, Cursor, que está valorada en 29.3 mil millones de dólares, tiene su base en el modelo de Kimi K2.5 de la cara oculta de la luna. Un modelo de una empresa china está impulsando una de las herramientas de desarrollo de AI más importantes de EE. UU.
Mientras tanto, el Pentágono ha etiquetado a Anthropic, una empresa estadounidense, con la etiqueta de "riesgo de cadena de suministro".
La dirección de la regulación y la dirección de la dependencia real son completamente opuestas.
Desde que comenzaron las restricciones de exportación de chips de nivel A100/H100 por parte de BIS en octubre de 2022, las restricciones de chips de EE. UU. han seguido intensificándose. En 2023, se cerró la fuga de H800, ampliando los indicadores de regulación de densidad de rendimiento. En diciembre de 2024, se añadió otra ronda, con 24 categorías adicionales de equipos semiconductores regulados y 140 entidades chinas en la lista negra, incluso la memoria de alto ancho de banda (HBM) y DRAM también se incluyeron en las restricciones. En enero de 2025, el Departamento de Comercio incluso lanzó un "marco de difusión de AI", intentando establecer un sistema de control global desde el nivel de modelo, pero este marco fue retirado dos días antes de entrar en vigor. Para diciembre de 2025, Trump cambió de dirección nuevamente y permitió la exportación de chips H200 a clientes aprobados en China.
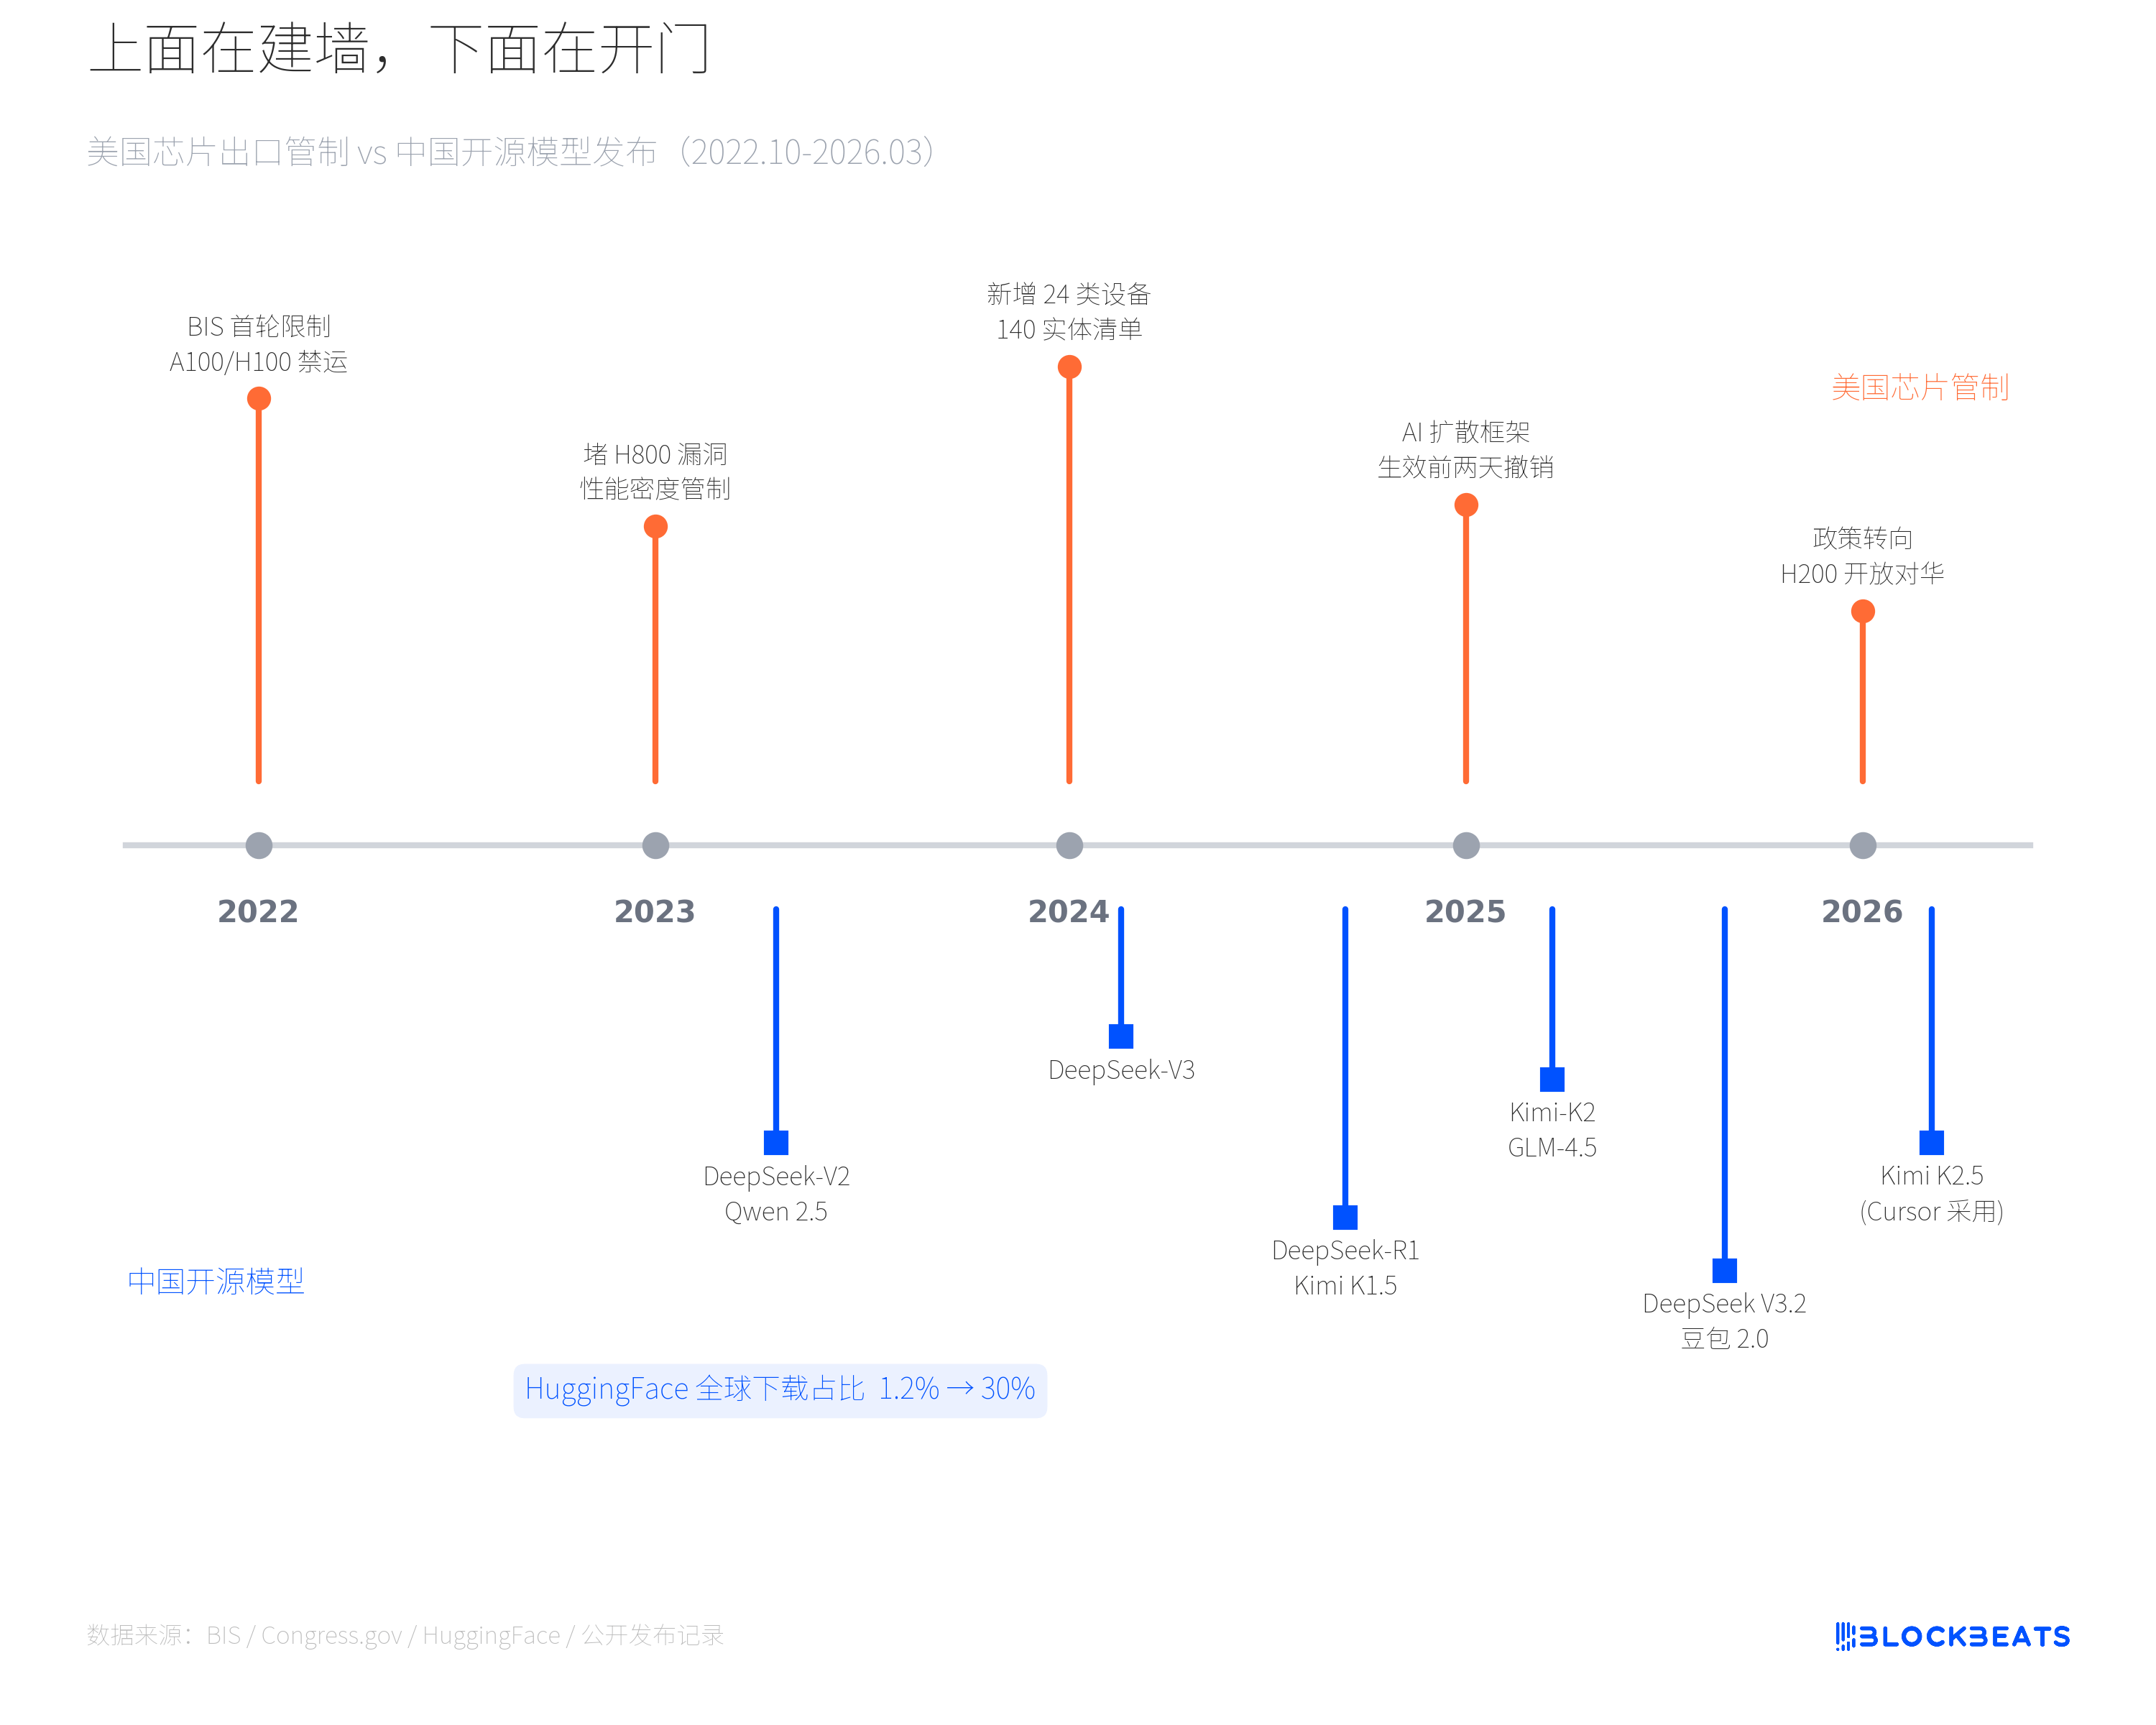
En la segunda mitad de esta línea de tiempo regulatoria, el ritmo de lanzamiento de modelos de código abierto en China ha ido en aumento. En 2024, DeepSeek-V2 y la serie Qwen 2.5 se lanzarán en código abierto. El 20 de enero de 2025, DeepSeek-R1 y Kimi K1.5 se lanzarán el mismo día, el primero alcanzó en un momento el primer lugar en la lista de descargas de la App Store de EE. UU., superando a ChatGPT. En la segunda mitad de 2025, Kimi-K2 y GLM-4.5 seguirán. A principios de 2026, Doubao 2.0 de ByteDance ya tiene 155 millones de usuarios activos semanales, y Kimi K2.5 ha sido adoptado directamente por Cursor. Cuanto más estricta es la regulación, más modelos hay.
Según datos oficiales de HuggingFace, la proporción de modelos de código abierto de China en las descargas globales se disparó del 1.2% a finales de 2024 a aproximadamente el 30% a principios de 2026. La cantidad total de descargas de la serie Qwen de Alibaba superó los 700 millones en enero de 2026, superando oficialmente a Llama de Meta. La regulación de chips no ha detenido la salida de software de AI de China, sino que podría haber acelerado el giro estratégico hacia el código abierto.
No es una mera coincidencia de datos. El informe de USCC utilizó un marco preciso para describir este fenómeno: "doble circulación". En el ciclo de hardware, China se ve limitada por los cuellos de botella en el suministro de chips. En el ciclo de software, China está infiltrando globalmente la infraestructura de AI a través de modelos de código abierto, formando una dependencia en la parte inferior. Las direcciones de fuerza de los dos ciclos son opuestas, pero se refuerzan mutuamente. La regulación ha limitado nuestra capacidad para acceder a la máxima potencia de cálculo, pero también ha forzado una trayectoria técnica que hace más con menos potencia de cálculo. DeepSeek-R1 alcanzó un rendimiento de vanguardia a un costo de inferencia muy inferior al de GPT-4o, y es el producto de esta trayectoria.
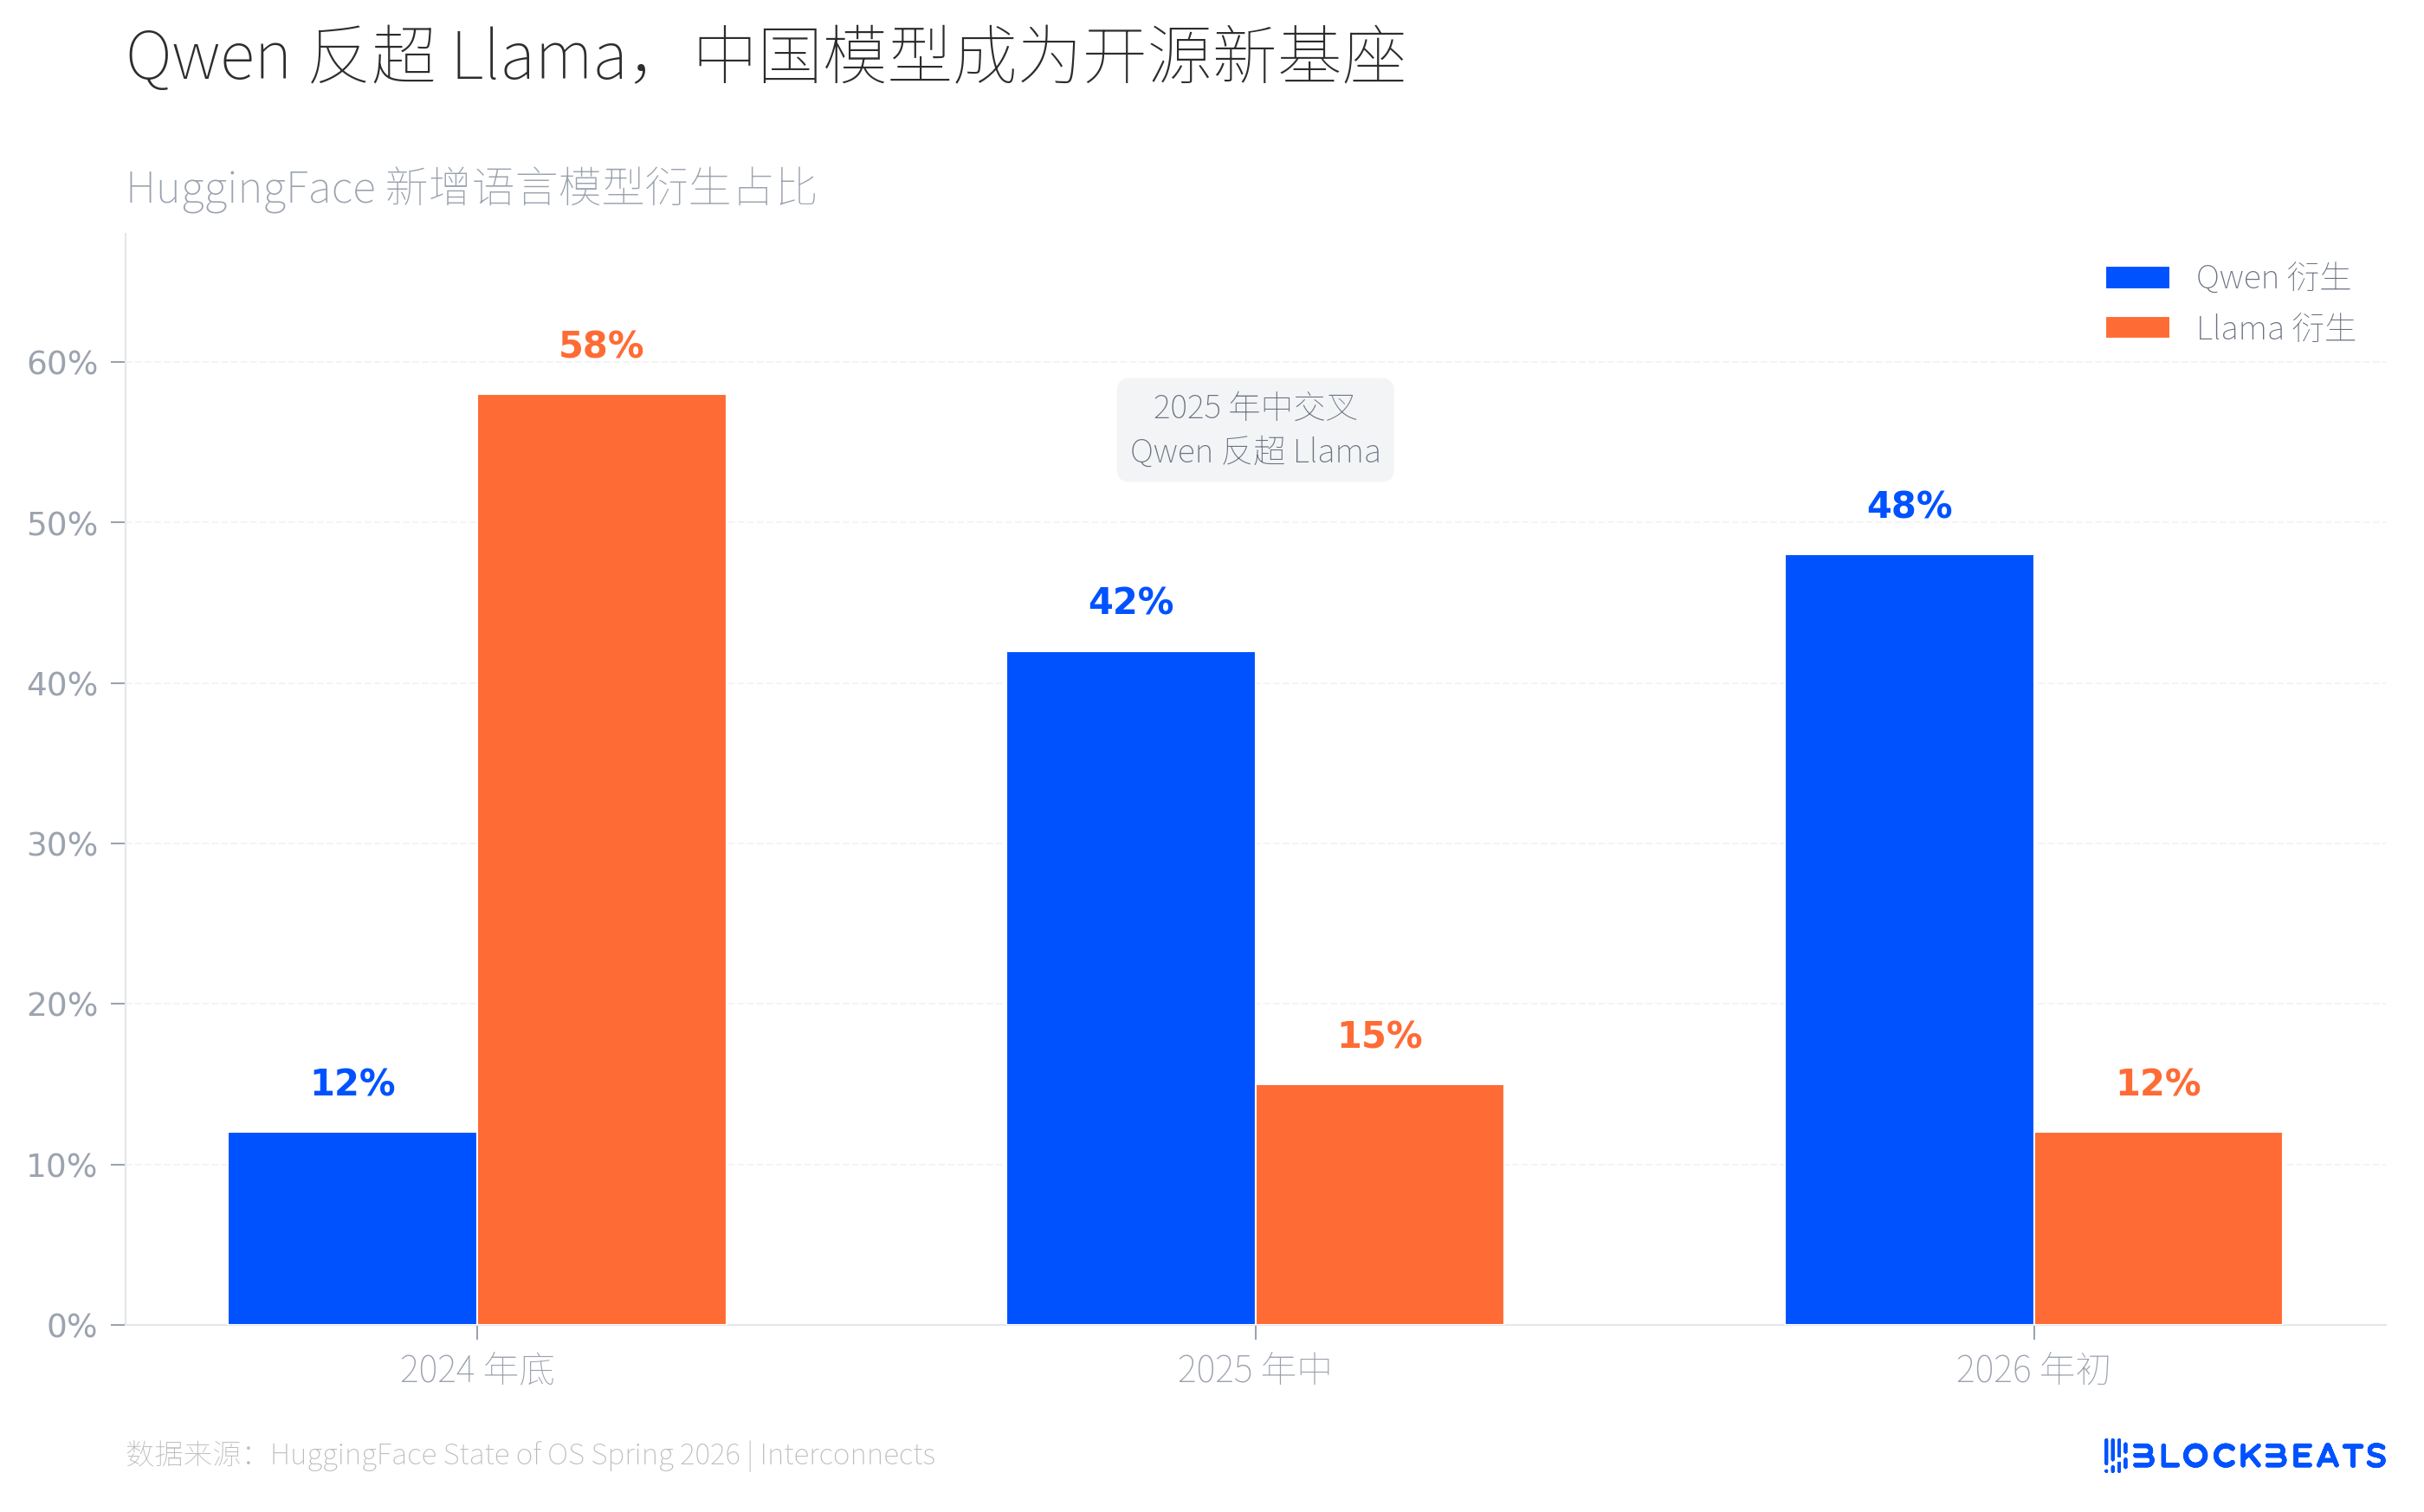
Los cambios en HuggingFace son evidentes. Según datos estadísticos de la plataforma, a finales de 2024, los modelos derivados de Llama representarán aproximadamente el 60% de los nuevos modelos de lenguaje, mientras que Qwen apenas alcanzará un poco más del 10%. Para mediados de 2025, aparece un punto de intersección, y según el blog oficial de HuggingFace, la proporción de derivados de Qwen se dispara por encima del 40%, mientras que Llama cae a aproximadamente el 15%. A principios de 2026, los derivados de Qwen se acercan a la mitad, y Llama continúa reduciéndose a aproximadamente el 12%.
La velocidad de esta intersección ha superado las expectativas de la mayoría. Hace dos años, el AI de código abierto era casi equivalente al ecosistema Llama de Meta. Los desarrolladores globales ajustaban, implementaban y producían sobre Llama. Ahora, lo mismo está ocurriendo en el ecosistema Qwen, solo que a una velocidad más rápida y con una cobertura más amplia.
Esto significa que cada vez más desarrolladores globales eligen modelos chinos como base para construir aplicaciones de AI. No por razones políticas, sino por rendimiento y nivel de apertura. La serie Qwen 2.5 cubre desde 0.5B hasta 72B en parámetros, permitiendo a los desarrolladores ajustar y desplegar en su propio hardware sin necesidad de pagar a OpenAI o Anthropic para invocar API. El código abierto ha eliminado el bloqueo de proveedores y también ha eliminado las fronteras.
Un detalle notable es que, según un informe de MIT Technology Review de febrero, las empresas de AI en China están formando una competencia diferenciada en la estrategia de código abierto. DeepSeek sigue una ruta de eficiencia de costo extrema, Kimi se centra en la capacidad de contexto largo y código, y Qwen busca una cobertura total de parámetros. Esta situación de múltiples rutas ha enriquecido cada vez más las opciones para los desarrolladores globales. Nuestros modelos de código abierto están redefiniendo la cadena de suministro global de AI con su fortaleza.
¿Cómo es el extremo de esta cadena de suministro?
El 19 de marzo, el desarrollador @fynnso descubrió el ID del modelo accounts/anysphere/models/kimi-k2p5-rl-0317-s515-fast en el código de Cursor. El cofundador de Cursor, Aman Sanger, luego admitió que Composer 2 está construido sobre Kimi K2.5. Según Lee Robinson, VP de Cursor, "el modelo base solo contribuyó con aproximadamente una cuarta parte de la capacidad de cómputo, el resto proviene de nuestro propio entrenamiento". Pero el modelo base es solo eso. Un producto valorado en 29.3 mil millones de dólares, cuyo modelo base proviene de la cara oculta de la luna, una empresa china financiada por Alibaba y Sequoia (HongShan).
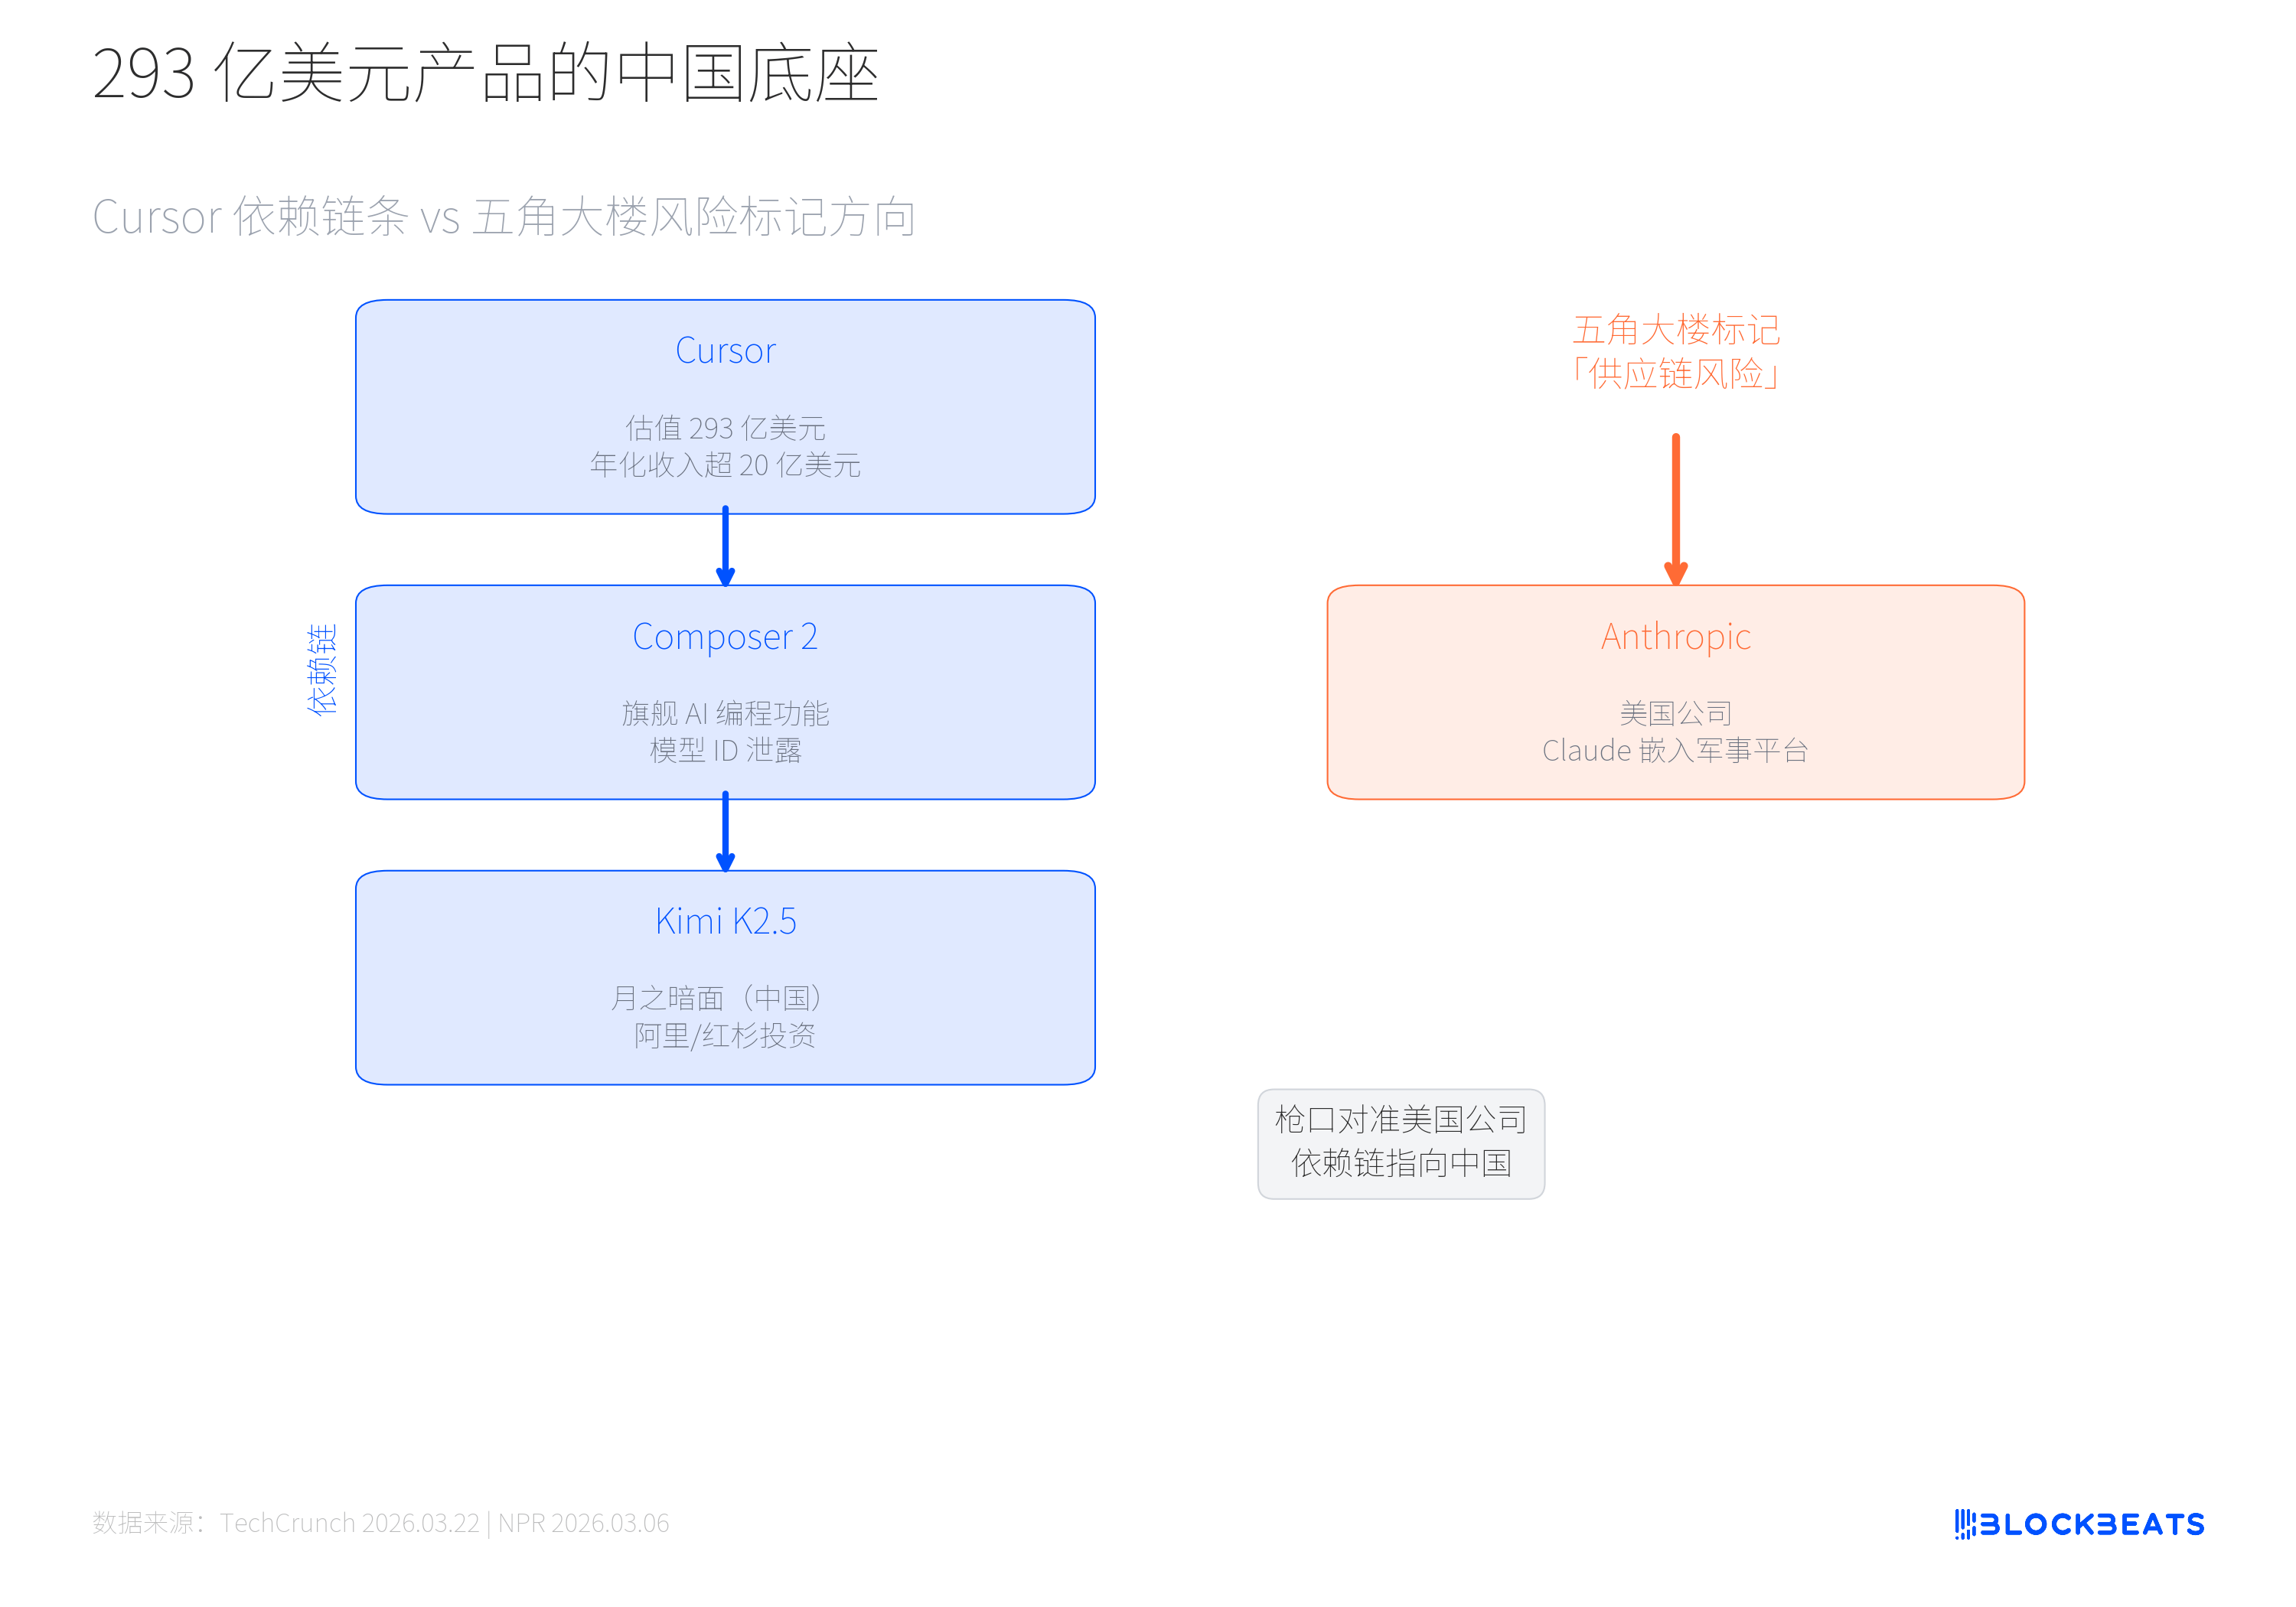
Al observar esta cadena de dependencia y las acciones del Pentágono juntas, la absurdidad se vuelve más evidente. El 5 de marzo, el Pentágono etiquetó oficialmente a Anthropic como "riesgo de cadena de suministro". Según NPR, la razón es que el CEO de Anthropic, Dario Amodei, se negó a ceder en dos líneas rojas, es decir, el uso de AI para armas autónomas y la vigilancia masiva de ciudadanos estadounidenses. Trump le dio al ejército seis meses para eliminar a Claude, mientras que Claude ya estaba profundamente integrado en plataformas militares y de seguridad nacional. Anthropic luego demandó al Pentágono el 9 de marzo.
Por un lado, el gobierno de EE. UU. etiqueta a su propia empresa con el riesgo de "cadena de suministro", y por otro lado, el 80% de las startups estadounidenses están utilizando modelos chinos. El primero es un juego político, el segundo es una realidad técnica. No hay intersección entre ambos.
El 80% de las startups estadounidenses están utilizando modelos chinos, mientras que la etiqueta de riesgo del Pentágono se ha colocado sobre una empresa estadounidense. La regulación se acumula en el hardware, mientras que la dependencia crece silenciosamente en el software. Al otro lado de tres años de muros de chips, hay un nuevo hecho en formación: el AI de código abierto de China ya no es un "perseguidor", sino el lado de oferta de la infraestructura de AI global.