



Organizado y compilado por: Sunny, Shenchao TechFlow
El protocolo informático Blockchain AI Gensyn anunció el 12 de junio que había completado una financiación Serie A de 43 millones de dólares liderada por a16z.
La misión de Gensyn es brindar a los usuarios acceso a una escala informática equivalente a poseer un clúster informático privado y, fundamentalmente, lograr un acceso justo que evite el control o el cierre por parte de cualquier entidad central. Mientras tanto, Gensyn es un protocolo informático descentralizado centrado en entrenar modelos de aprendizaje automático.
Al recordar el podcast de los fundadores de Gensyn, Harry y Ben, con Epicenter a finales del año pasado, se puede encontrar que discutieron en profundidad la investigación de los recursos informáticos, incluidos AWS, la infraestructura local y la infraestructura de la nube, para comprender cómo optimizar y utilizar estos recursos para Apoyar el desarrollo de aplicaciones de IA.
Al mismo tiempo, también discutieron en detalle la filosofía de diseño, los objetivos y el posicionamiento en el mercado de Gensyn, así como las diversas limitaciones, suposiciones y estrategias de ejecución enfrentadas durante el proceso de diseño.
El podcast presenta los cuatro roles principales en la red fuera de la cadena de Gensyn, explora las características de la red dentro de la cadena de Gensyn y la importancia de los tokens y la gobernanza de Gensyn.
Además, Ben y Harry también compartieron algo de ciencia de la IA interesante para brindarles a todos una comprensión más profunda de los principios básicos y las aplicaciones de la inteligencia artificial.
Anfitrión: Dra. Friederike Ernst, Epicenter Podcast
Oradores: Ben Fielding y Harry Grieve, cofundadores de Gensyn
Título del libro: 《Ben Fielding y Harry Grieve: Gensyn – El protocolo informático de aprendizaje profundo》
Fecha de emisión: 24 de noviembre de 2022
Blockchain como capa de confianza para la infraestructura de IA descentralizada
El anfitrión preguntó a Ben y Harry por qué combinaron su rica experiencia en inteligencia artificial y aprendizaje profundo con blockchain.
Ben dijo que su decisión no se tomó de la noche a la mañana, sino después de un período de tiempo relativamente largo. El objetivo de Gensyn es construir una infraestructura de IA a gran escala y, mientras investigaban cómo lograr la máxima escalabilidad, se dieron cuenta de que se necesitaba una capa sin confianza.
Deben poder consolidar las capacidades informáticas sin depender de la incorporación centralizada de nuevos proveedores ni encontrarse con limitaciones de expansión administrativa. Para resolver este problema, comenzaron a explorar investigaciones de cálculo verificables, pero descubrieron que esto siempre requería que un tercero de confianza o un juez verificara el cálculo.
Esta limitación los llevó a blockchain. Blockchain proporciona una manera de eliminar la necesidad de un único árbitro o tomador de decisiones porque permite el consenso entre grandes grupos.
Harry también compartió su filosofía de que él y Ben apoyan firmemente la libertad de expresión y están preocupados por la censura.
Antes de pasar a blockchain, estaban analizando el aprendizaje federado, un campo de aprendizaje profundo en el que se entrenan múltiples modelos en fuentes de datos distribuidas y luego se combinan para crear un metamodelo que puede aprender de todas las fuentes de datos. Trabajan con los bancos en este enfoque. Sin embargo, pronto se dieron cuenta de que el mayor problema era adquirir los recursos informáticos o procesadores que pudieran entrenar estos modelos.
Para maximizar la integración de los recursos informáticos, necesitan un método de coordinación descentralizada, que es donde entra en juego blockchain.
Encuesta de recursos informáticos de mercado: AWS, infraestructura local e infraestructura en la nube
Harry explicó las diferentes opciones de recursos informáticos para ejecutar modelos de IA, según el tamaño del modelo.
Los estudiantes pueden usar AWS o máquinas locales, las nuevas empresas pueden elegir AWS bajo demanda u opciones más económicas programadas.
Pero para las necesidades de GPU a gran escala, AWS puede verse limitado por el costo y la escalabilidad y, a menudo, opta por construir una infraestructura interna.
Las investigaciones muestran que muchas organizaciones están luchando por escalar, y algunas incluso optan por comprar y administrar GPU ellas mismas. En general, comprar una GPU es más rentable a largo plazo que ejecutarla en AWS.
Las opciones para los recursos informáticos de aprendizaje automático incluyen la computación en la nube, la ejecución de modelos de IA localmente o la creación de su propio clúster informático. El objetivo de Gensyn es proporcionar acceso a la misma escala informática que si tuviera su propio clúster, y la clave es lograr un acceso justo, que no pueda ser controlado ni desactivado por ninguna entidad central.
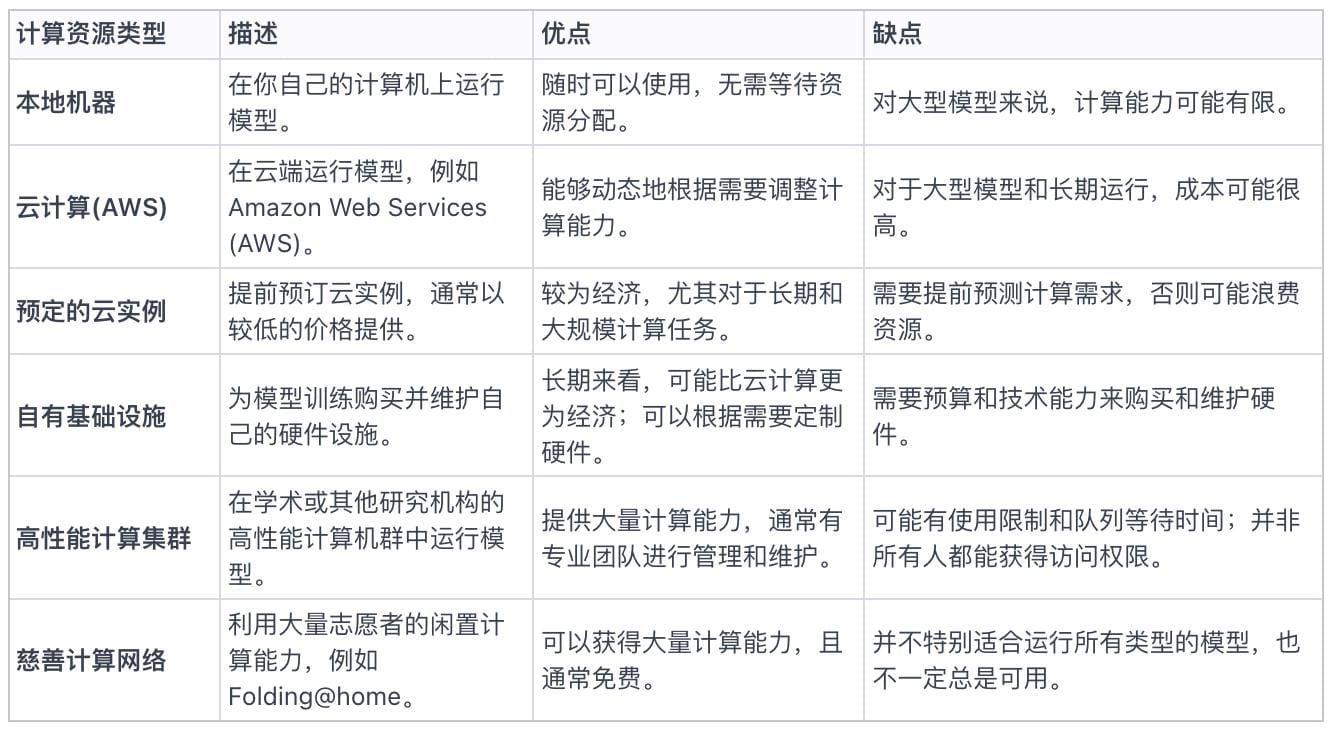
Tabla 1: Todas las opciones de recursos informáticos actualmente en el mercado
Discusión sobre la filosofía de diseño, los objetivos y el posicionamiento en el mercado de Gensyn.
El presentador preguntó en qué se diferencia Gensyn de proyectos informáticos blockchain anteriores, como Golem Network.
Harry explica que la filosofía de diseño de Gensyn se considera principalmente en dos ejes:
La granularidad del protocolo: a diferencia de los protocolos informáticos de propósito general como Golem, Gensyn es un protocolo granular centrado en entrenar modelos de aprendizaje automático.
Escalabilidad verificada: los primeros proyectos a menudo dependían de métodos de reputación o replicación que eran menos tolerantes a fallas bizantinas, lo que no brindaba suficiente confianza en los resultados del aprendizaje automático. El objetivo de Gensyn es aprovechar los aprendizajes de los protocolos computacionales en el mundo de las criptomonedas y aplicarlos específicamente al aprendizaje automático para optimizar la velocidad y el costo y al mismo tiempo garantizar un nivel satisfactorio de verificación.
Harry agregó que al considerar la naturaleza de lo que debe hacer la red, debe estar dirigida a ingenieros e investigadores de aprendizaje automático. Debe tener un componente de verificación, pero la clave es que debe ser resistente a la censura y neutral en términos de hardware en términos de permitir que cualquiera participe.
Restricciones, supuestos y ejecución durante el proceso de diseño.
Durante el proceso de diseño de la plataforma de Gensyn, Ben enfatizó la importancia de las suposiciones y restricciones del sistema. Su objetivo es crear una red que pueda transformar el mundo entero en una supercomputadora de IA y, para lograrlo, necesitan encontrar un equilibrio entre los supuestos del producto, los supuestos de la investigación y los supuestos tecnológicos.
Su razonamiento de por qué construyeron Gensyn como su propia cadena de bloques de primera capa fue mantener una mayor flexibilidad y libertad de toma de decisiones en áreas técnicas clave, como los mecanismos de consenso. Quieren poder preparar su protocolo para el futuro y no quieren imponer restricciones innecesarias en las primeras etapas del proyecto. Además, creen que en el futuro las cadenas podrán interactuar a través de un protocolo de mensajería ampliamente aceptado, por lo que su decisión va en línea con esta visión.
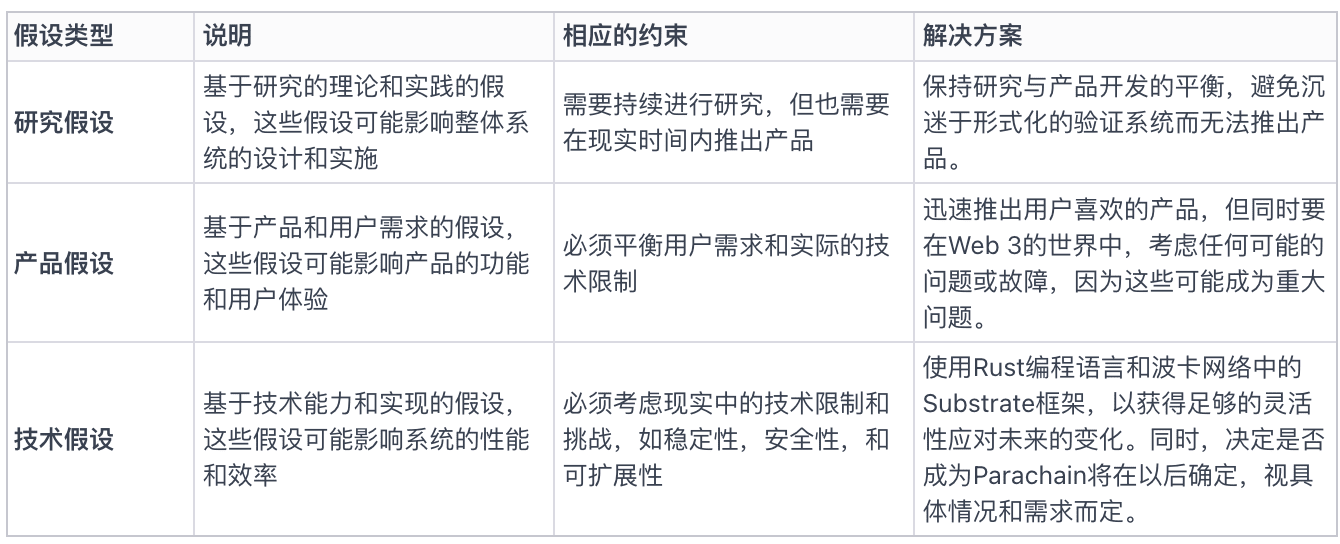
Figura 2: Supuestos de producto, supuestos de investigación y supuestos de tecnología, limitaciones y ejecución
Cuatro actores principales en la red fuera de cadena de Gensyn
En esta discusión sobre la economía Gensyn, se introducen cuatro roles principales: confirmadores, trabajadores, validadores y denunciantes. Los remitentes pueden enviar una variedad de problemas a la red Gensyn, incluida la generación de imágenes específicas o el desarrollo de modelos de inteligencia artificial que puedan conducir automóviles.
El remitente envía la tarea.
Harry explica cómo usar Gensyn para entrenar modelos. El usuario primero define el resultado deseado, como generar una imagen basada en un mensaje de texto, y luego construye un modelo que toma el mensaje de texto como entrada y genera la imagen correspondiente. Los datos de entrenamiento son fundamentales para el aprendizaje y la mejora del modelo. Después de preparar la arquitectura del modelo y los datos de capacitación, los usuarios los envían a la red Gensyn junto con hiperparámetros como el cronograma de tasa de aprendizaje y la duración de la capacitación. El resultado de este proceso de formación es un modelo entrenado que los usuarios pueden alojar y utilizar.
Cuando se le preguntó cómo seleccionar un modelo no entrenado, Harry sugirió dos métodos.
El primero se basa en el concepto de modelo básico actualmente popular, en el que grandes empresas como OpenAI o Midjourney construirán un modelo básico y luego los usuarios pueden entrenar el modelo básico con datos específicos.
La segunda opción es construir el modelo desde cero, a diferencia del enfoque del modelo base.
En Gensyn, los desarrolladores pueden enviar varias arquitecturas para capacitación y prueba utilizando métodos similares a la optimización evolutiva y optimizar continuamente para construir el modelo deseado.
Ben proporciona una visión en profundidad del modelo subyacente desde su perspectiva, que creen que es el futuro del campo.
Gensyn como protocolo, esperamos que pueda ser utilizado por DApps que implementen técnicas de optimización evolutiva o métodos similares. Estas DApps pueden enviar arquitecturas individuales al protocolo Gensyn para capacitación y pruebas, y construir el modelo ideal mediante un refinamiento iterativo.
El objetivo de Gensyn es proporcionar una base informática de aprendizaje automático puro y fomentar el desarrollo de un ecosistema a su alrededor.
Si bien los modelos previamente entrenados pueden introducir sesgos porque las organizaciones pueden usar conjuntos de datos propietarios o retener información sobre el proceso de capacitación, la solución de Gensyn es abrir el proceso de capacitación en lugar de eliminar cajas negras o confiar en un determinismo total. Al diseñar y entrenar modelos base colectivamente, podemos crear modelos globales sin estar sesgados por el conjunto de datos de ninguna empresa en particular.
solucionador
Para la distribución de tareas, una tarea corresponde a un servidor. Pero un modelo puede dividirse en múltiples tareas.
Los modelos de lenguaje grande están diseñados para aprovechar la máxima capacidad de hardware disponible en ese momento. Este concepto se puede extender a las redes para considerar la heterogeneidad de los dispositivos.
Para tareas específicas, como validadores o trabajadores, existe una opción para hacerse cargo de Mempool. Se selecciona aleatoriamente un trabajador entre aquellos que expresan su voluntad de asumir la tarea. Si el modelo y los datos no se pueden adaptar a un dispositivo específico, pero el propietario del dispositivo afirma que sí, se pueden generar multas por congestión del sistema.
La posibilidad de ejecutar una tarea en una máquina está determinada por una función aleatoria verificable que selecciona un trabajador de un subconjunto de trabajadores disponibles.
En cuanto a la cuestión de la verificación de las capacidades de los trabajadores, si los trabajadores no tienen las capacidades informáticas declaradas, no podrán completar las tareas informáticas, lo que se detectará al presentar la prueba.
Sin embargo, el tamaño de la tarea es un problema. Si las tareas se establecen demasiado grandes, puede provocar problemas en el sistema, como ataques de denegación de servicio (DoS), en los que los trabajadores afirman haber completado la tarea pero nunca la completan, desperdiciando tiempo y recursos.
Por lo tanto, la decisión sobre el tamaño de la tarea es crucial y debe tener en cuenta factores como la paralelización y la estructura optimizada de la tarea. Los investigadores están estudiando y explorando activamente los mejores métodos basados en diversas limitaciones.
Una vez que se lance la testnet, también se considerarán condiciones prácticas para observar cómo opera el sistema en el mundo real.
Definir el tamaño perfecto de la tarea puede ser un desafío y Gensyn está listo para ajustarse y mejorar en función de los comentarios y la experiencia del mundo real.
Mecanismo de verificación y puntos de control para cálculos a gran escala en la cadena.
Harry y Ben muestran que verificar la exactitud de un cálculo es un desafío importante porque no es determinista como una función hash, por lo que no es posible verificar simplemente mediante hash si se realizó un cálculo. Para solucionar este problema, la solución ideal es utilizar la aplicación de prueba de conocimiento cero de todo el proceso de cálculo. Actualmente, Gensyn todavía está trabajando para implementar esta capacidad.
Actualmente, Gensyn introduce un enfoque híbrido que utiliza puntos de control para verificar los cálculos del aprendizaje automático mediante mecanismos probabilísticos y puntos de control. Al combinar un esquema de auditoría estocástico con rutas espaciales de gradiente, se puede establecer una verificación relativamente sólida. Además, se introducen pruebas de conocimiento cero para mejorar el proceso de verificación y se aplican a la pérdida global del modelo.
Verificador y denunciante
El moderador y Harry discutieron los dos roles adicionales involucrados en el proceso de verificación: verificador y denunciante. Detallan las responsabilidades y roles específicos de estos dos roles.
La tarea del validador es garantizar la exactitud de los puntos de control, mientras que la tarea del denunciante es garantizar la precisión con la que el validador desempeña sus funciones. Los denunciantes resuelven el dilema del validador, asegurando que el trabajo del validador sea correcto y confiable. Los verificadores introducen errores intencionalmente en su trabajo, y la función del denunciante es identificar y exponer estos errores, garantizando así la integridad del proceso de verificación.
Los verificadores introducen errores deliberadamente para probar el estado de alerta de los denunciantes y garantizar la eficacia del sistema. Si hay un error en el trabajo, el validador detecta el error y notifica al reportero. Luego, el error se registra en la cadena de bloques y se verifica en la cadena. Periódicamente, y a un ritmo relevante para la seguridad del sistema, los validadores introducen errores intencionalmente para mantener a los denunciantes interesados. Si los denunciantes encuentran un problema, participan en un juego llamado "protocolo de localización", mediante el cual pueden limitar el cálculo a un punto específico en el árbol Merkle de una región específica de la red neuronal. Luego, esta información se envía a arbitraje en cadena. Esta es una versión simplificada del proceso para validadores y denunciantes que llevarán a cabo más desarrollo e investigación después de la ronda inicial.
Red en cadena de Gensyn
Ben y Harry discutieron en detalle cómo funciona el protocolo de coordinación de Gensyn en la cadena y los detalles de implementación. Primero mencionaron el proceso de construcción de bloques de red, que implica apostar tokens como parte de esa red de apuestas. Luego explican cómo se relacionan estos componentes con el protocolo Gensyn.
Ben explicó que el protocolo Gensyn es en gran medida un protocolo de red Polkadot de sustrato básico. Adoptan el mecanismo de consenso de Grandpa Babe basado en prueba de participación y los validadores operan de la manera habitual. Sin embargo, todos los componentes de aprendizaje automático introducidos anteriormente ocurren fuera de la cadena, lo que involucra a varios actores fuera de la cadena que realizan sus respectivas tareas.
Estos participantes reciben incentivos mediante apuestas, ya sea a través de la sección de apuestas en Substrate o enviando una cantidad específica de tokens en un contrato inteligente. Cuando finalmente se verifique su trabajo, serán recompensados.
El desafío mencionado por Ben y Harry es garantizar un equilibrio entre el monto de la apuesta, el posible monto de reducción y el monto de la recompensa para evitar la creación de incentivos para comportamientos perezosos o maliciosos.
Además, discutieron la complejidad que conlleva agregar denunciantes, pero su presencia es fundamental para garantizar la honestidad de los verificadores debido a las demandas de la computación a escala. Mientras continúan explorando formas de eliminar potencialmente a los denunciantes mediante tecnología a prueba de conocimiento cero. Afirmaron que el sistema actual coincide con lo que se describe en el documento ligero, pero están trabajando activamente para simplificar todos los aspectos.
El moderador preguntó si tenían algún tipo de solución de disponibilidad de datos y Henry explicó que introdujeron una capa encima del sustrato llamada prueba de disponibilidad (POA). Esta capa utiliza tecnologías como la codificación de borrado para abordar las limitaciones que encuentran en el mercado de niveles amplios de almacenamiento. Dijeron que estarían muy interesados en los desarrolladores que ya hayan implementado una solución de este tipo.
Ben añadió que sus necesidades implican no sólo almacenar datos de entrenamiento, sino también datos de prueba intermedios que no requieren almacenamiento a largo plazo. Por ejemplo, es posible que solo necesiten esperar unos 20 segundos cuando terminen de publicar una cierta cantidad de bloques. Sin embargo, las tarifas de almacenamiento que pagan actualmente en Arweave cubren cientos de años y son innecesarias para estas necesidades a corto plazo. Buscaban una solución que tuviera las garantías y características de Arweave y al mismo tiempo cubriera sus necesidades de almacenamiento a corto plazo a un coste menor.
Token Gensyn y gobernanza
Ben explicó la importancia del token gensyn en el ecosistema, ya que desempeña un papel clave a la hora de apostar, castigar, proporcionar recompensas y mantener el consenso. Su objetivo principal es garantizar la solidez financiera y la integridad del sistema. Ben también mencionó el uso cuidadoso de las tasas de inflación para pagar a los validadores y el aprovechamiento de los mecanismos de la teoría de juegos.
Hizo hincapié en el uso puramente técnico del token Gensyn y dijo que técnicamente garantizarán el momento y la necesidad de introducir el token Gensyn.
Harry dijo que son una minoría en la comunidad de aprendizaje profundo, especialmente en medio del escepticismo generalizado entre los estudiosos de la IA sobre las criptomonedas. No obstante, se dan cuenta del valor de los aspectos técnicos e ideológicos de las criptomonedas.
Sin embargo, cuando se lance la red, anticipan que la mayoría de los usuarios de aprendizaje profundo realizarán transacciones principalmente utilizando monedas fiduciarias, y la conversión a tokens se realizará sin problemas entre bastidores.
Por el lado de la oferta, los trabajadores y los comprometidos participarán activamente en el comercio de tokens y ya están recibiendo el interés de los mineros de Ethereum que tienen importantes recursos de GPU y buscan nuevas oportunidades.
Aquí, es importante garantizar que se elimine el miedo de los profesionales del aprendizaje profundo y del aprendizaje automático a la terminología de criptomonedas (como los tokens), desvinculándola de la interfaz de la experiencia del usuario. Gensyn dice que este es un caso de uso interesante que une los mundos de la Web 2 y la Web 3 porque tiene sentido económico y la tecnología necesaria para respaldar su existencia.
Inteligencia artificial de ciencia popular
IA, aprendizaje profundo y aprendizaje automático
Ben compartió sus puntos de vista sobre el desarrollo del campo de la IA en los últimos años. Él cree que, aunque el campo de la IA y el aprendizaje automático ha experimentado una serie de pequeñas explosiones en los últimos siete años, los avances actuales parecen estar creando un impacto real y aplicaciones valiosas que resuenan en un público más amplio. El aprendizaje profundo es un motor fundamental de estos cambios. Las redes neuronales profundas han demostrado su capacidad para superar los puntos de referencia establecidos por los métodos tradicionales de visión por computadora. Además, modelos como el GPT-3 han acelerado este progreso.
Harry explicó con más detalle las diferencias entre IA, aprendizaje automático y aprendizaje profundo. Él cree que estos tres términos a menudo se usan indistintamente, pero tienen diferencias significativas. Metafóricamente dijo que la IA, el aprendizaje automático y el aprendizaje profundo son como muñecas matrioskas rusas, siendo la IA la capa más externa.
En términos generales, la IA se refiere a programar máquinas para realizar tareas.
El aprendizaje automático, que se hizo popular en los años 1990 y principios de los 2000, utiliza datos para determinar la probabilidad de decisiones en lugar de depender de sistemas expertos con reglas si-entonces.
El aprendizaje profundo se basa en el aprendizaje automático, pero permite modelos más complejos.
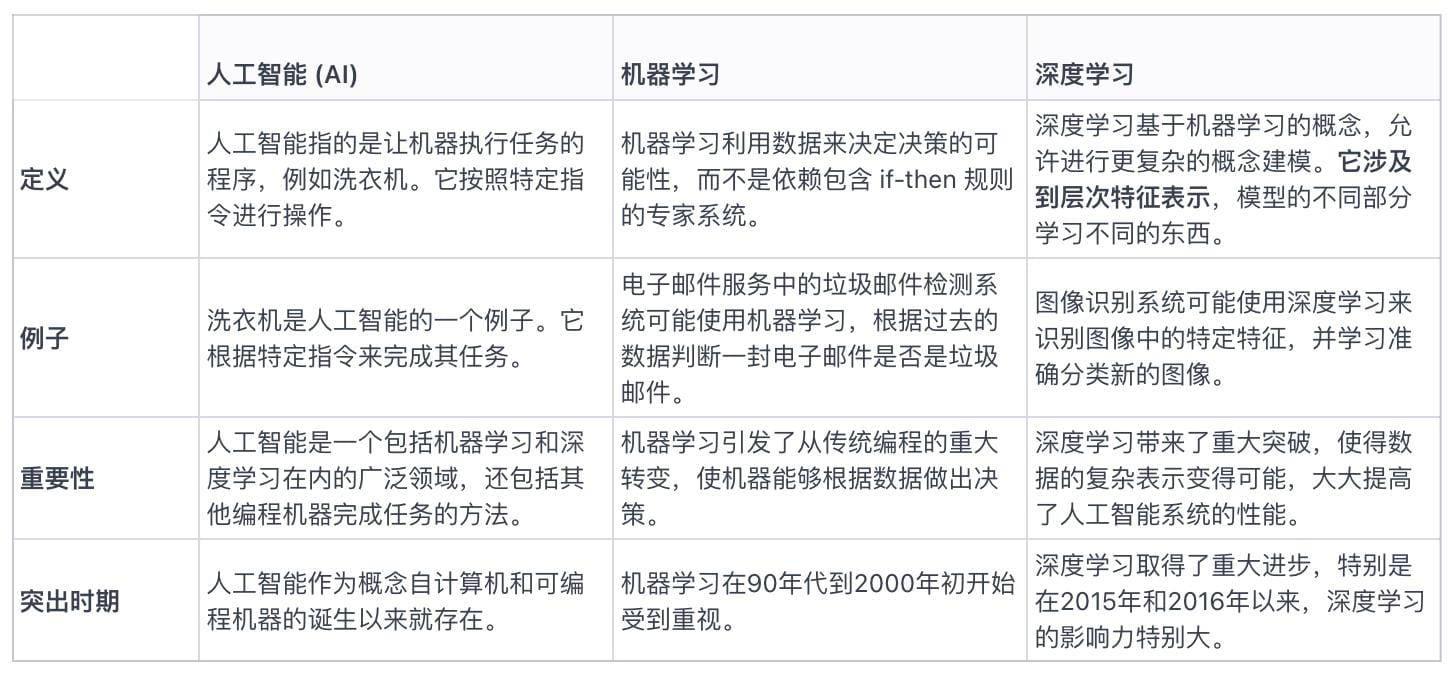
Figura 3: La diferencia entre inteligencia artificial, aprendizaje automático y aprendizaje profundo
Inteligencia artificial restringida, inteligencia artificial general, superinteligencia artificial
En este segmento, los anfitriones y los invitados brindan una mirada en profundidad a tres áreas clave de la inteligencia artificial: inteligencia artificial restringida (ANI), inteligencia artificial general (AGI) y superinteligencia artificial (ASI).
Inteligencia artificial estrecha (ANI): la IA actual se encuentra principalmente en esta etapa, donde las máquinas son muy buenas para realizar tareas específicas, como detectar tipos específicos de cáncer a partir de escáneres médicos mediante el reconocimiento de patrones.
Inteligencia general artificial (AGI): AGI se refiere a la capacidad de las máquinas para realizar tareas que son relativamente simples para los humanos pero que son muy desafiantes cuando se reflejan en los sistemas informáticos. Por ejemplo, permitir que una máquina navegue sin problemas en un entorno abarrotado mientras hace suposiciones discretas sobre todas las entradas circundantes es un ejemplo de AGI. AGI se refiere a la capacidad de un modelo o sistema para realizar tareas cotidianas como un humano.
Superinteligencia artificial (ASI): después de alcanzar la inteligencia artificial general, las máquinas pueden desarrollarse aún más hasta convertirse en una superinteligencia artificial. Esto se refiere a la capacidad de las máquinas para superar las capacidades humanas debido a la complejidad de sus modelos, mayor potencia informática, vida útil ilimitada y memoria perfecta. Este concepto se explora a menudo en películas de ciencia ficción y terror.
Además, los invitados también mencionaron que la integración del cerebro humano y las máquinas, por ejemplo a través de interfaces cerebro-computadora, puede ser una forma de lograr AGI, pero esto también plantea una serie de cuestiones morales y éticas.
Desbloquear la caja negra del aprendizaje profundo: determinista versus probabilístico
Ben explica que la naturaleza de caja negra de los modelos de aprendizaje profundo se debe a su gran tamaño. Todavía estás trazando un camino a través de una serie de puntos de decisión en la red. Sin embargo, este camino es muy grande y es difícil conectar los pesos o parámetros dentro del modelo con sus valores específicos, porque estos valores se derivan después de ingresar millones de muestras. Puede hacer esto con seguridad y puede realizar un seguimiento de cada actualización, pero la cantidad de datos que termine generando será muy grande.
Vio suceder dos cosas:
A medida que comprendemos cada vez más los modelos que construimos, la naturaleza de la caja negra está desapareciendo gradualmente. El aprendizaje profundo es un campo de investigación que ha pasado por un período interesante y rápido con muchos experimentos que no fueron impulsados por los fundamentos de la investigación. Se trata más de ver qué podemos sacar de ello. Así que le arrojamos más datos, probamos nuevas arquitecturas y simplemente vemos qué sucede, en lugar de comenzar desde los primeros principios, diseñar esto y saber exactamente cómo funciona. Entonces hubo un período emocionante en el que todo era una caja negra. Pero cree que este rápido crecimiento está empezando a desacelerarse, y estamos viendo a la gente revisar estas arquitecturas, examinarlas y decir: "¿Por qué funciona tan bien? Profundicemos en ello y demostremos que, en cierto modo, esta cortina". está siendo levantado.
Otra cosa que ha sucedido, quizás más controvertida, es un cambio en las opiniones sobre si los sistemas computacionales deben ser completamente deterministas o si podemos vivir en un mundo probabilístico. Nosotros, como seres humanos, vivimos en un mundo probabilístico. El ejemplo del vehículo autónomo puede ser el más claro. Cuando conducimos, aceptamos que sucederán eventos aleatorios, que puede haber accidentes menores y que puede haber problemas con el sistema del vehículo autónomo. Pero no podemos aceptar esto en absoluto y decimos que debe ser un proceso completamente determinista. Uno de los desafíos en la industria de los vehículos autónomos es que se supone que la gente aceptará los mecanismos probabilísticos que se aplican a los vehículos autónomos, pero en realidad la gente no lo hace. Él cree que esto cambiará y puede ser controvertido si nosotros, como sociedad, permitiremos que los sistemas informáticos probabilísticos coexistan con nosotros. No está seguro de si el camino será fácil, pero cree que así será.
Método de optimización de gradiente: el método de optimización central del aprendizaje profundo
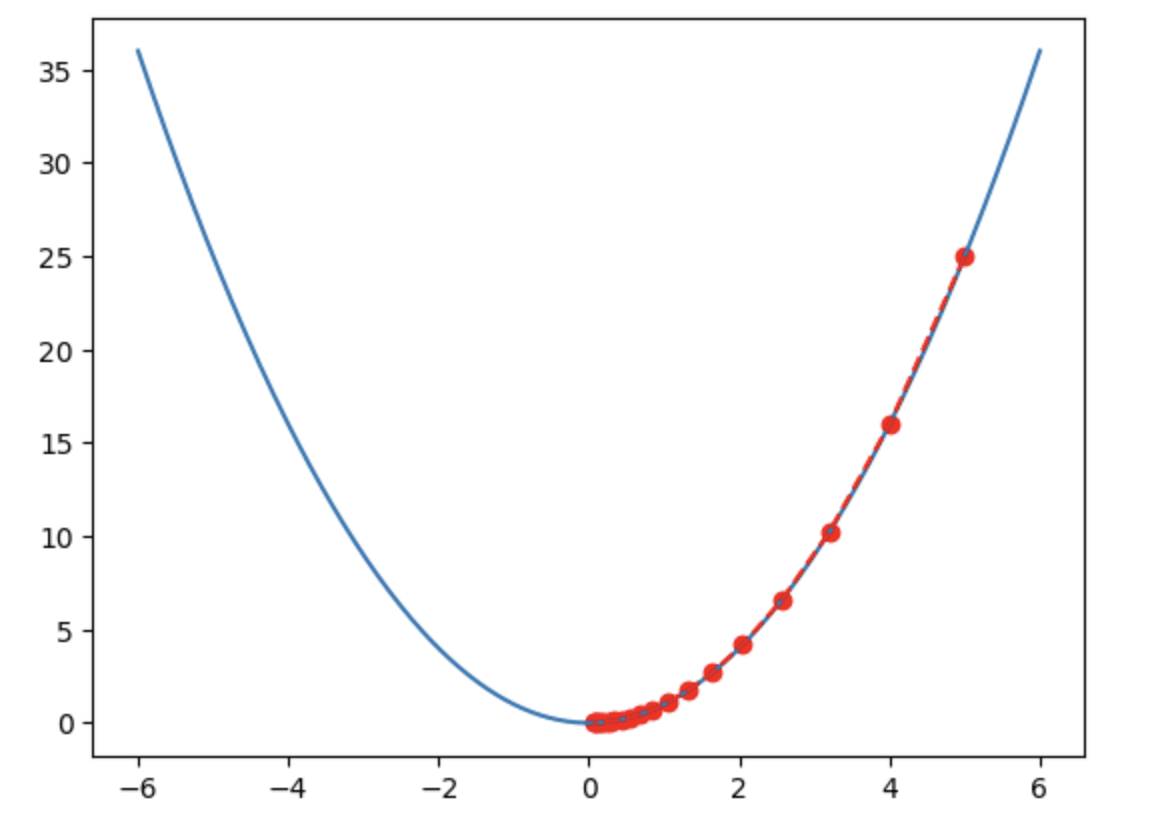
La optimización de gradientes es uno de los métodos centrales del aprendizaje profundo y desempeña un papel clave en el entrenamiento de redes neuronales. En las redes neuronales, una serie de parámetros de capa son esencialmente números reales. El entrenamiento de la red implica establecer estos parámetros en valores realistas que permitan que los datos se pasen correctamente y activen la salida deseada en las etapas finales de la red.
Los métodos de optimización basados en gradientes han traído cambios tremendos en los campos de las redes neuronales y el aprendizaje profundo. Este método utiliza gradientes, que son la diferenciación de los parámetros de cada capa de la red con respecto al error. Al aplicar la regla de la cadena, los gradientes se pueden propagar hacia atrás por toda la red jerárquica. En este proceso, puede determinar dónde se encuentra en la superficie de error. El error se puede modelar como una superficie en el espacio euclidiano, que aparece como una región llena de altibajos. El objetivo de la optimización es encontrar el área que minimice el error.
El degradado muestra para cada capa dónde se encuentra en la superficie y la dirección en la que debe actualizar los parámetros. Puede utilizar degradados para navegar por esta superficie ondulada y encontrar direcciones que reduzcan el error. El tamaño del escalón depende de la pendiente de la superficie. Si es empinado, saltarás más lejos; si no es empinado, saltarás más pequeño. Básicamente, simplemente estás navegando por la superficie, buscando un surco, y el gradiente te ayuda a determinar la posición y la dirección.
Este método fue un gran avance porque los gradientes brindan una señal clara y una dirección útil que lo guía de manera mucho más efectiva para saber dónde se encuentra en la superficie y dónde se encuentra que realizar saltos aleatorios en el espacio de parámetros en la cima de la montaña. aún en barrancos o en zonas llanas.
Aunque existen muchas técnicas en el aprendizaje profundo para resolver el problema de encontrar soluciones óptimas, la situación en el mundo real suele ser más compleja. Existen muchas técnicas de regularización que se utilizan en la capacitación en aprendizaje profundo, lo que la convierte más en un arte que una ciencia. Y es por eso que la optimización basada en gradientes es más un arte que una ciencia exacta cuando se aplica en la vida real.
Resumir
El objetivo de Gensyn es construir el sistema de recursos informáticos de aprendizaje automático más grande del mundo, que pueda aprovechar al máximo los recursos informáticos inactivos o infrautilizados, como teléfonos inteligentes personales, computadoras y otros dispositivos.
En el contexto del aprendizaje automático y blockchain, los registros que lleva el libro mayor suelen ser el resultado de cálculos, es decir, el estado de los datos que hemos procesado mediante el aprendizaje automático. Este estado puede ser: "He aprendido automáticamente esta ola de datos, es válida y ocurrió en X año y X mes". El objetivo principal de este registro es expresar el estado resultante más que detallar el proceso de cálculo.
En este marco, blockchain juega un papel importante:
Blockchain proporciona una forma de registrar los resultados del estado de los datos. Está diseñado para garantizar la autenticidad de los datos y evitar la manipulación y el repudio.
Existe un mecanismo de incentivo económico dentro de la blockchain, a través del cual se pueden coordinar los comportamientos de diferentes roles en la red informática, como por ejemplo los cuatro roles mencionados: remitente, trabajador, verificador y denunciante.
A través de una encuesta del mercado actual de la computación en la nube, descubrimos que la computación en la nube no es del todo indeseable, pero que varios métodos de computación tienen sus propios problemas específicos. El método informático descentralizado de blockchain puede desempeñar un papel en algunos escenarios, pero no puede reemplazar completamente la computación en la nube tradicional. En otras palabras, blockchain no es una solución panacea.
Finalmente, la IA puede considerarse como un tipo de productividad. Sin embargo, la forma de organizar y entrenar eficazmente la IA pertenece a la categoría de relaciones de producción. Esto incluye factores como la colaboración, el crowdsourcing y los incentivos. En este sentido, la Web 3.0 ofrece una gran cantidad de posibles soluciones y escenarios.
Por lo tanto, podemos entender que la combinación de blockchain e IA, especialmente en términos de intercambio de datos y modelos, coordinación de recursos informáticos y verificación de resultados, proporciona nuevas soluciones a algunos problemas en la posibilidad de entrenamiento y uso de la IA.
Cita
1. https://docs.gensyn.ai/litepaper/
2. https://a16zcrypto.com/posts/announcement/investing-in-gensyn/