

#inference
inference
1,600 vistas
32 están debatiendo
Hot
Lo último

⚡ EL CAPITAL INSTITUCIONAL CONSOLIDA LA INFRAESTRUCTURA DE IA A MEDIDA QUE LA VELOCIDAD DE INFERENCIA SE DESPLAZA HACIA $TAO 🔍
La adquisición de Moondream por parte de Prime Intellect señala un cambio institucional hacia la inferencia de alta eficiencia y la ejecución multimodal. 🦈 Al asegurarse el motor Photon —que ofrece más de 60 inferencias por segundo en unidades de hardware individuales—, el dinero inteligente está reduciendo activamente la latencia en complejas cadenas de agentes. 📊
Este movimiento marca una transición estructural: se pasa de modelos de tamaño descomunal a un rendimiento operativo ágil. 💡 A medida que la aceleración de la inferencia se convierte en la principal capa de liquidez que impulsa la implementación de la IA en el mundo real, el capital ya se está posicionando para adelantarse a la tendencia. 🌊
🤔 ¿La velocidad de inferencia optimizada desencadenará el próximo repunte sostenido de los protocolos de IA, o se siguen valorando mal las limitaciones del hardware físico? 👇
⚠️ Esto no es asesoramiento financiero. Gestiona siempre tus riesgos. 🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
1

·
--
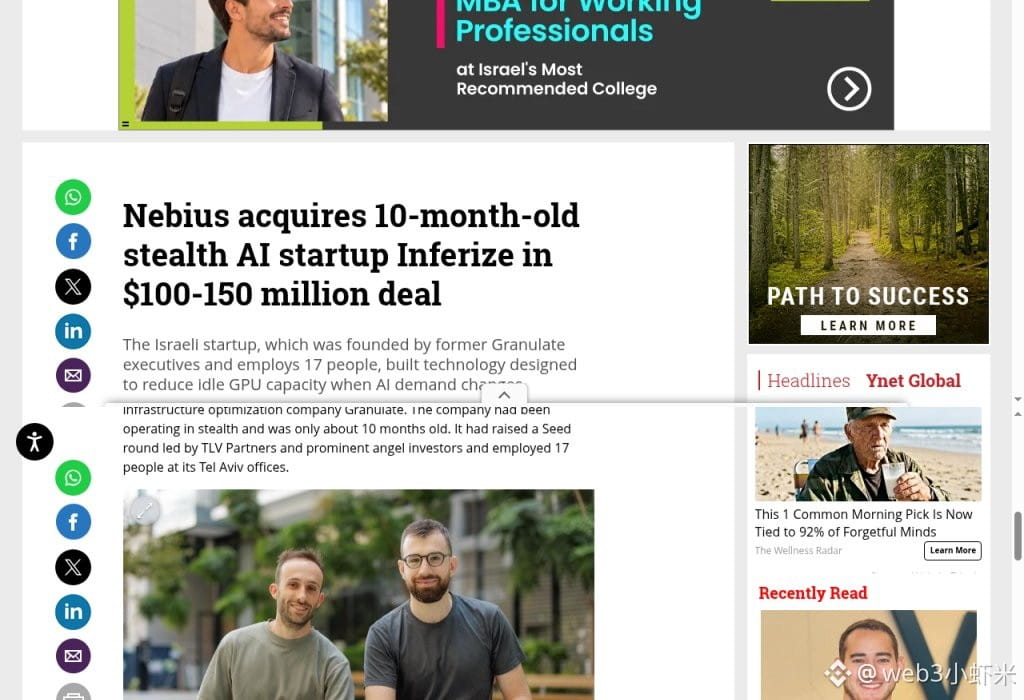
Se descubre CTech/Nebius: La empresa de nube de IA Nebius ($NBIS), listada en Nasdaq, adquirió a la startup israelí de optimización de inferencia Inferize, fundada hace aproximadamente 10 meses. Los términos oficiales de la transacción no se han divulgado; CTech estima que rondan entre 100 y 150 millones de dólares.
Lo que hacen es muy concreto: eliminan esa “tasa por GPU ociosa” durante el arranque en frío de los modelos. Cuando se cargan los pesos, se amplía la capacidad o se cambian los pesos a mitad de un proceso de aprendizaje por refuerzo, las tarjetas a menudo quedan dando vueltas sin hacer trabajo. Inferize busca que el cómputo se ajuste más de cerca a la demanda real, aumentando la utilización de la capacidad de Token Factory y reduciendo el costo por token. El equipo tiene unas 17 personas; el fundador trabajó antes en Granulate, que fue adquirida por Intel. Nebius afirma que el personal y la tecnología se integrarán en la plataforma de inferencia, y además antes se sumaron capacidades relacionadas con Eigen AI y Clarifai.
Del entrenamiento al despliegue, los proveedores de nube van completando, una por una, las capas de software. Esta adquisición de infraestructura pequeña pero “dura” es más interesante que solo contar historias.
$NBIS #AI #Inference #Nebius
Se descubre CTech/Nebius: La empresa de nube de IA Nebius ($NBIS ), listada en Nasdaq, adquirió a la startup israelí de optimización de inferencia Inferize, fundada hace aproximadamente 10 meses. Los términos oficiales de la transacción no se han divulgado; CTech estima que rondan entre 100 y 150 millones de dólares.
Lo que hacen es muy concreto: eliminan esa “tasa por GPU ociosa” durante el arranque en frío de los modelos. Cuando se cargan los pesos, se amplía la capacidad o se cambian los pesos a mitad de un proceso de aprendizaje por refuerzo, las tarjetas a menudo quedan dando vueltas sin hacer trabajo. Inferize busca que el cómputo se ajuste más de cerca a la demanda real, aumentando la utilización de la capacidad de Token Factory y reduciendo el costo por token. El equipo tiene unas 17 personas; el fundador trabajó antes en Granulate, que fue adquirida por Intel. Nebius afirma que el personal y la tecnología se integrarán en la plataforma de inferencia, y además antes se sumaron capacidades relacionadas con Eigen AI y Clarifai.
Del entrenamiento al despliegue, los proveedores de nube van completando, una por una, las capas de software. Esta adquisición de infraestructura pequeña pero “dura” es más interesante que solo contar historias.
$NBIS #AI #Inference #Nebius
407

·
--
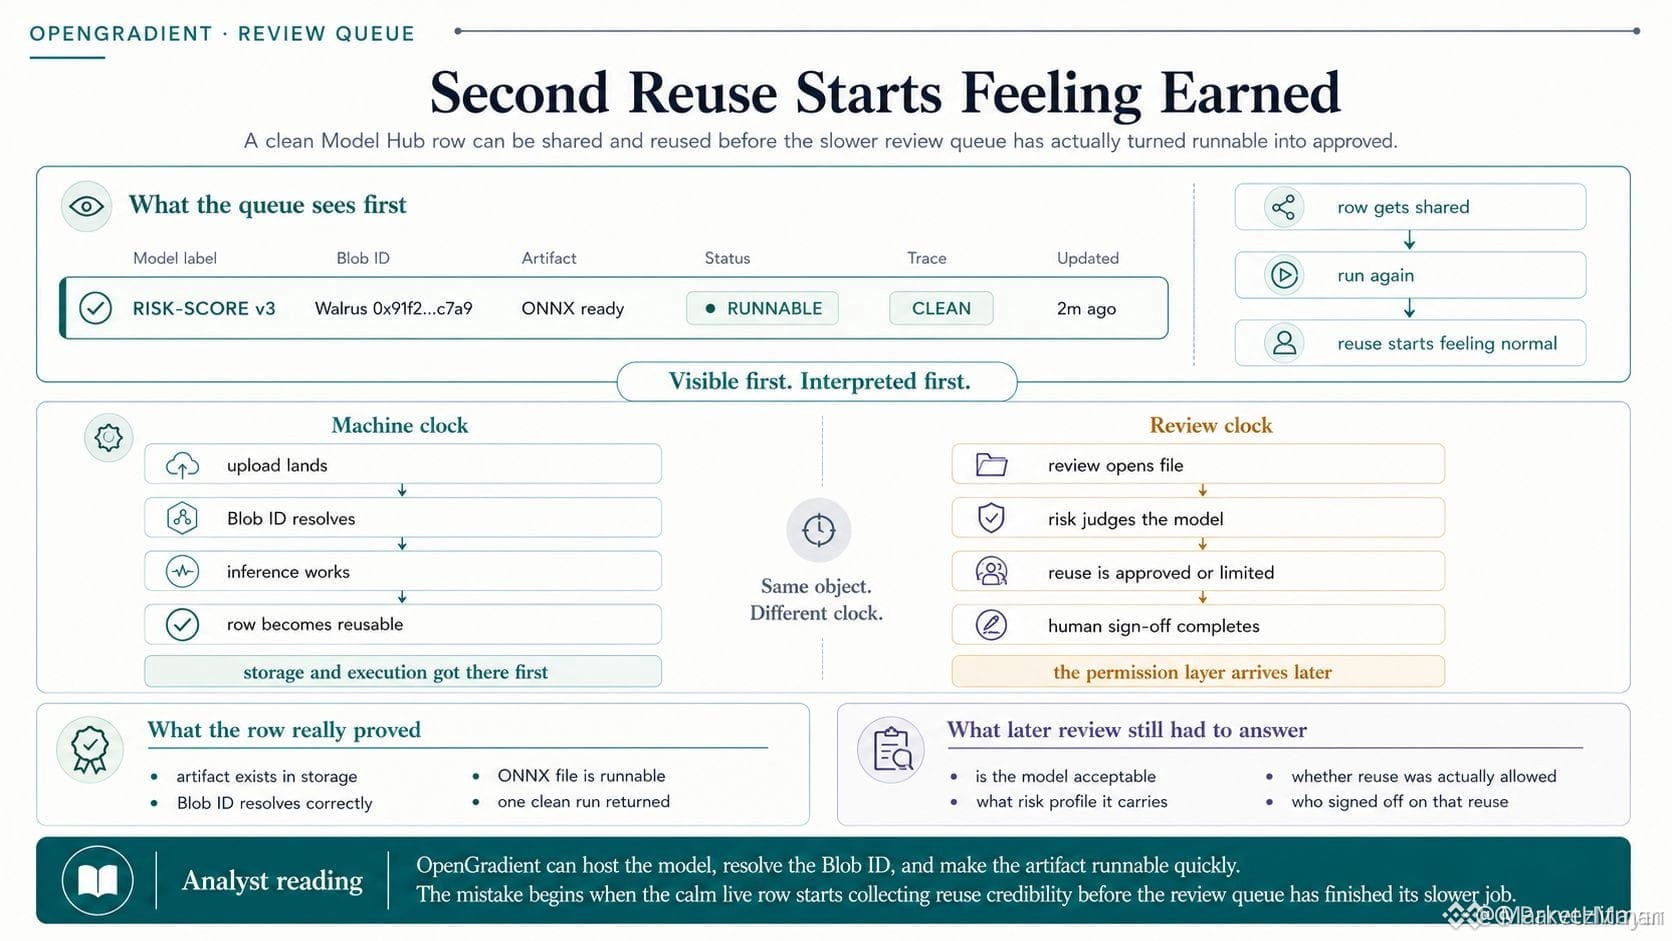
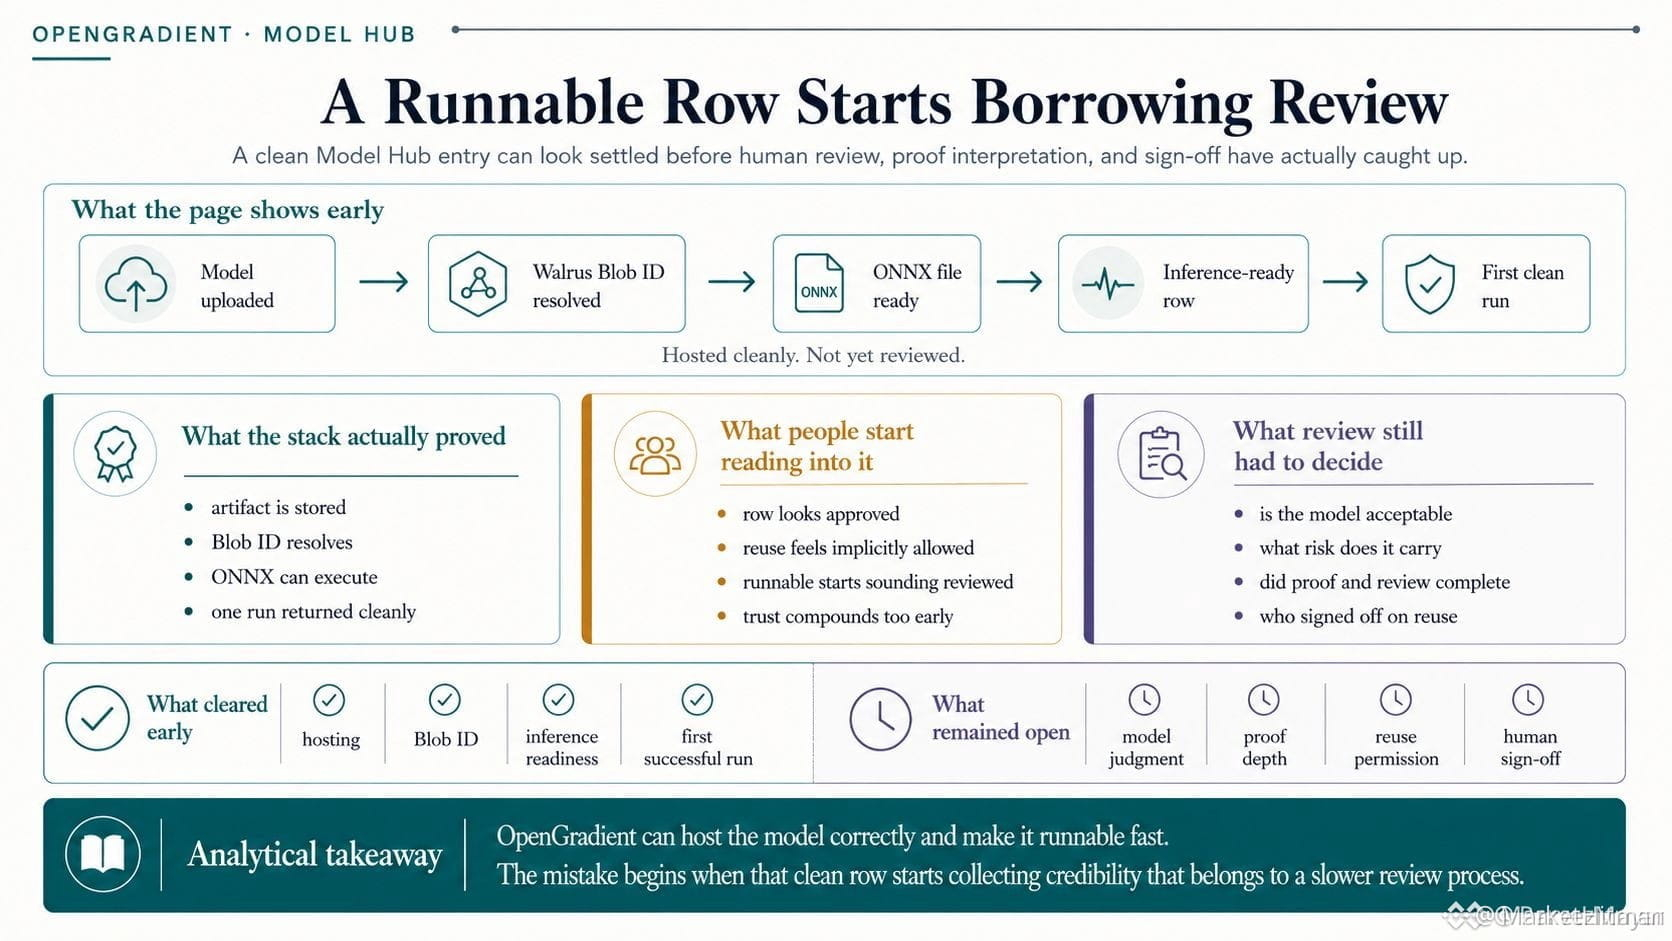
$OPG INFERENCE SE EJECUTA ANTES QUE LA COLA DE REVISIÓN 🔥
Una fila de modelo en OpenGradient Model Hub se verifica en segundos: traza limpia, ID de blob Walrus listo, archivo ONNX en vivo. Pero la revisión humana se queda atrás. Para el tercer reuso, esa fila empieza a comportarse como si ya estuviera revisada antes de que siquiera haya ganado el visto bueno. El sistema funciona a la perfección. El proceso, no.
Esta brecha entre la eficiencia de la máquina y la supervisión humana crea un punto ciego. El modelo era sólido, pero ¿estuvo realmente verificado? Confiar en la velocidad por encima del orden es una ventaja discreta — o una fuga discreta.
¿Estás ejecutando modelos que pasaron la máquina pero se saltaron la puerta humana?
No es asesoramiento financiero. Siempre gestiona tu riesgo.
#OPG #ModelHub #Inference #CryptoAI
🔥
19

$AI INFERENCE MEMORY PODRÍA SER EL PRÓXIMO GRAN CUELLO DE BOTELLA EN CRYPTO IA 💎
El analista de Critini Research, Jukan, refuta la visión bajista sobre el futuro de Micron y señala que, en la fase de inferencia de IA, añadir memoria es más valioso que añadir GPUs. El problema es simplemente que apilar GPUs de NVIDIA no mejora el rendimiento de inferencia porque las GPUs a menudo están ociosas debido a cuellos de botella de memoria. El ROI final para la inferencia depende más de la memoria que de las GPUs.
Esto cambia el relato del cómputo a la memoria, y ahí es donde los proyectos cripto centrados en almacenamiento descentralizado y en el ancho de banda de memoria podrían ver un cambio de paradigma en el valor. ¿Estás posicionado para este cambio de fase?
No es asesoramiento financiero. Gestiona siempre tu riesgo.
#AI #Memory #Inference #CryptoNarratives
💎
29
·
--
Todo el mundo cree que el ecosistema $BNB solo se mueve con actualizaciones en cadena.
La diplomacia global en Oriente Medio reencamina en silencio la potencia de cómputo lejos de los clústeres de nodos. Cuando las startups de IA se enfrentan a fricciones en la cadena de suministro, las redes descentralizadas pelean por los mismos restos de silicio. Observa el costo de los nodos RPC como tu indicador principal del estrés del hardware local.
$BNB $ETH #CryptoInfra #TechTrends #Inference
57
·
--
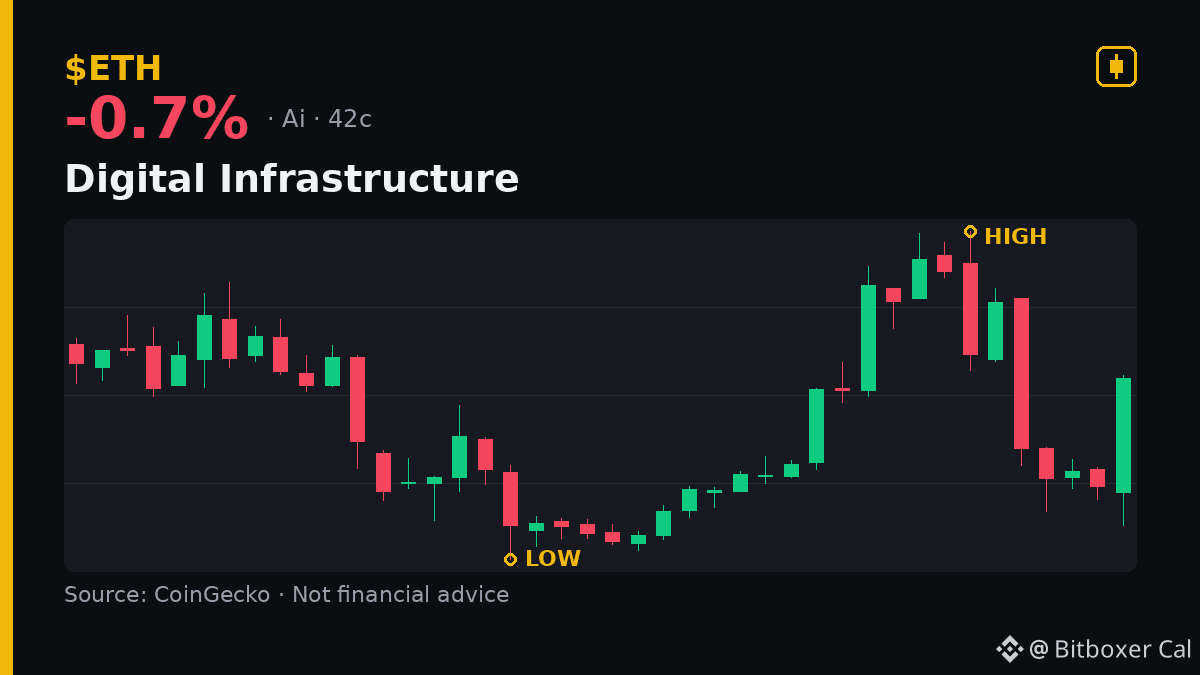
Nos dicen que la IA no es más que una carrera armamentista de hardware.
Eso es una distracción. Empresas como Mandela Digital demuestran que la resiliencia del software importa más que el poder de cómputo en bruto. Así como un motor pesado necesita un chasis sólido, las aplicaciones financieras en ETH o BTC requieren datos previsibles, ya sea que estén funcionando en chips de vanguardia o en hardware antiguo.
$ETH $BTC #AI #CryptoAI #Inference
69
·
--
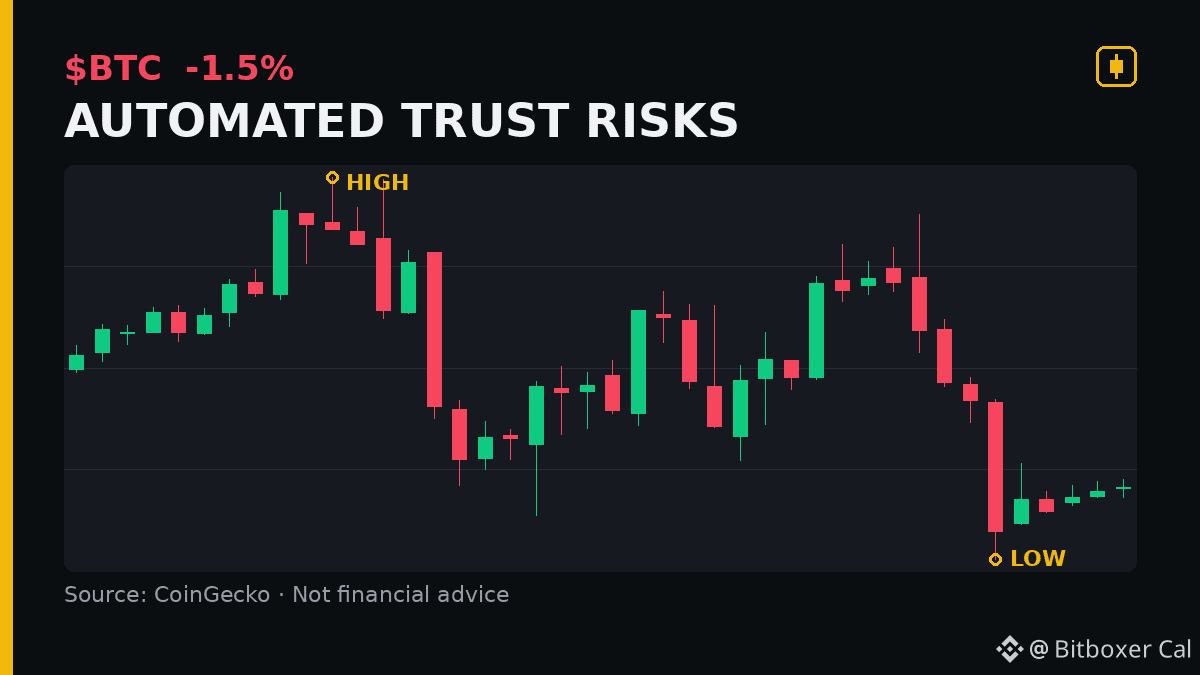
Los optimistas quieren que los algoritmos gestionen las tesorerías nacionales de Bitcoin porque creen que las matemáticas son inmunes al ego.
Olvidan que el código no tiene un balance para saldar deudas cuando algo falla. Confiar en un flujo de lógica opaco y sin posibilidad de ser parcheado es simplemente cambiar el error humano por una máquina que no puede rendir cuentas. Si el modelo alucina, la entidad que depende del ecosistema se queda sin nada más que con una falla del sistema.
$BTC $BNB #cryptoeducation #AI #Inference
78

·
--
🚀 $AI RIPL REDUCE LA LATENCIA DE INFERENCIA 14 VECES: ¡EL BORDE EN TIEMPO REAL, REDEFINIDO! 📈
📊 El motor RIPL de Liquid AI reduce la latencia del LFM2.5, con 1.200 millones de parámetros, a 34,6 ms en una sola NVIDIA B200, atendiendo dentro de ese plazo el 95 % de las solicitudes de 1.000 RPS. ⚡ Frente a los 498 ms de vLLM, la diferencia se amplía a 14,4×, lo que supone una ventaja decisiva en velocidad para la clasificación de búsquedas y el control del riesgo en pagos.
🦈 Esta aceleración convierte los modelos de lenguaje en recursos ágiles de primera línea, permitiendo a las instituciones aprovechar la liquidez antes de que se estabilice el flujo de órdenes. 💡 Se espera una rápida ola de adopción a medida que las empresas busquen una ventaja de latencia para superar a sus rivales en ciclos de decisión en tiempo real. 💬 ¿Cómo cambiará esta ventaja de velocidad tu estrategia de IA en tiempo real? 👇
⚠️ Esto no es asesoramiento financiero. Gestiona siempre tus riesgos. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
4
·
--
PRIME INFERENCE REVELA UN AVANCE EN LATENCIA DE 1 BILLÓN DE TOKENS PARA $AI INFRAESTRUCTURA ⚡ 📊
Prime Intellect ha lanzado Prime Inference, procesando casi 1 billón de tokens al día mientras reduce en un 40% la latencia p90 entre tokens para cargas de trabajo de agentes complejos. 📊 Al separar el procesamiento del prompt y la generación de la respuesta en diferentes GPUs, el sistema optimiza la eficiencia computacional a escala institucional.
Con una expansión del 50% en la capacidad de caché KV hasta 1.63M tokens por decodificador, este stack de código abierto conecta sin problemas el entrenamiento del modelo con la ejecución en tiempo real. 💡 Los datos operativos vuelven continuamente a los pipelines de aprendizaje por refuerzo, haciendo que la eficiencia de inferencia “en bruto” sea la métrica competitiva determinante. 🔍
💬 ¿Crees que la optimización de inferencia de código abierto acelerará el despliegue de agentes descentralizados, o los hubs de cómputo propietarios mantendrán su ventaja? 👇
⚠️ No es asesoramiento financiero. Gestiona siempre tu riesgo. 🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
93
·
--
ZHIPU DERRIBA LAS BARRERAS DE VELOCIDAD CON GLM-5.3-FLASHX ENCENDIENDO EL PRÓXIMO $AI INFRASTRUCTURE RALLY! ⚡ 🚀
El escalado de cómputo de la IA acaba de entrar en modo hiperimpulso cuando Zhipu presenta GLM-5.3-FlashX, liberando un asombroso rendimiento de 200 tokens por segundo. ⚡ Impulsado por Infra Agents internos que optimizan más de 100,000 chips especializados, las velocidades de procesamiento de extremo a extremo se triplicaron en menos de dos semanas.
Esta aceleración bruta del rendimiento señala un cambio masivo hacia la ejecución de modelos hipereficientes en todo el panorama de inteligencia descentralizada. 📊 A medida que la velocidad de inferencia bruta se convierte en el foso definitivo, el capital inteligente está adelantándose silenciosamente a la tesis del cuello de botella de la infraestructura. 💡
💬 ¿Los motores de inferencia de alta velocidad impulsarán la próxima gran fase de valoración para los tokens de IA este trimestre? 👇
⚠️ No es asesoramiento financiero. Gestiona siempre tu riesgo. 🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡ 🎯
55
$CEREBRAS AT $170 WAS THE INSIDER ENTRY – NOW OPENAI CONFIRMS 🔥
Entrada: 170 🔥
OpenAI lanzará GPT‑5.6 en hardware de Cerebras el próximo mes, alcanzando 750 tokens por segundo. Eso no es un rumor: es una validación directa de su pila de inferencia. Serenity, que compró a $170, todavía ve potencial a largo plazo pese a la prima actual.
La narrativa sobre la infraestructura se está calentando, y Cerebras está en el centro de todo. La pregunta ahora es si el mercado ya valora por completo este catalizador o si todavía hay margen para seguir subiendo. ¿Estás esperando una corrección o acumulando aquí?
No es asesoramiento financiero. Gestiona siempre tu riesgo.
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
28
·
--
$CRBR ESTABLECE EL LANZAMIENTO DE GPT-5.6 A 750 TOKENS/S EN JULIO 🚀
Entrada: $170 🔥
La confirmación de Serenity de que OpenAI implementará el modelo Sol GPT-5.6 de vanguardia en hardware de Cerebras es un catalizador directo para la acción. La velocidad de inferencia de 750 tokens/segundo crea una ventaja competitiva tangible frente a arquitecturas basadas en GPU. La compra de Serenity en $170 muestra convicción, pero también advierten que la valoración actual está ligeramente elevada frente a pares como JBL.
La pregunta clave es si el mercado ya ha descontado por completo la prima de la asociación o si un volumen sostenido puede impulsar la acción a un nuevo rango. ¿Cuál es tu objetivo aquí — $200 o primero una corrección?
No es asesoramiento financiero. Gestiona siempre tu riesgo.
#CRBR #AI #Hardware #Inference #Breakout
🎯
17
$NVDA La demanda de inferencia de IA sigue en auge ⚡
Citigroup dice que la escasez ya no se trata solo de los chips más nuevos. Ahora también afecta a las GPUs más antiguas, centros de datos, acceso a energía y la capa de enrutamiento que decide qué modelo y hardware usar.
Esto es importante porque la próxima etapa del valor de IA puede no estar solo en el cómputo. El mercado está empezando a valorar toda la infraestructura, desde redes ópticas hasta capas de nube y aplicaciones.
No es asesoramiento financiero. Maneja tu riesgo.
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
16

AMAZON ELEVA EL CAPEX A $220B — LA DEMANDA DE INFERENCIA ES EL MOMENTO $FET 'S 🦈 💥
El ciclo de la IA acaba de cambiar de fase. El entrenamiento fue el calentamiento: la inferencia es donde el cómputo real se consume. El jefe de la nube de Amazon dice que los clientes ya terminaron de experimentar; están conectando modelos directamente en flujos de trabajo de producción. Esa es una curva de demanda que se dispara hacia arriba. 📊
Ahora AWS eleva su tope de capex a $220B para 2026. Esto no es un error de redondeo: es que los hyperscalers están haciendo la apuesta más grande de infraestructura de esta década para alimentar motores de inferencia. Cuando los gigantes de web2 compiten por la escasez de cómputo, la narrativa de la IA descentralizada gana un asiento en la mesa. 💡
El mercado todavía está revalorando qué tokens heredarán esta demanda. El impulso suele quedarse atrás de la narrativa hasta que el primer gran avance la confirme. 🔍 ¿Qué proyecto de IA en tu cartera tiene la historia de inferencia en el mundo real más sólida? 💬
⚠️ No es asesoramiento financiero. Siempre gestiona tu riesgo. 🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
135
EL AHORRO DEL 70% QUE CAMBIA LA PROGRAMACIÓN CON IA DE ALQUILER A ACTIVO PROPIO — $AMD 🦈 💥
AMD acaba de lanzar un paquete directo al mundo empresarial: silicio EPYC, GPUs Instinct, servidores Supermicro, PaletteAI de Spectro Cloud y GLM-5.2 — uno preintegrado en una caja como copiloto local. 🎯 La cifra clave que importa: hasta un 70% menos en el coste total frente a los modelos “frontier” en la nube, con recuperación de la inversión en capital tan rápida como en seis meses.
El movimiento es una ruta basada en políticas — PaletteAI cambia automáticamente entre inferencia en las instalaciones y modelos en la nube de Anthropic, OpenAI, Google o xAI bajo demanda, con cuotas de tokens, registros de auditoría y paneles de Grafana que muestran la diferencia real de costes en tiempo real. 🔍
Aquí, la programación con IA pasa de un alquiler medido a una infraestructura predecible — una jugada de soberanía que resuena con la mentalidad de autocustodia. 💬 ¿Las empresas seguirán alquilando modelos “frontier” o empezarán a poseer la capacidad de cómputo? 👇
⚠️ No es asesoramiento financiero. Gestiona siempre tu riesgo. 🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
90
·
--
🚨 $NVDA SHIFTS ENFOQUE INSTITUCIONAL HACIA LA INFERENCIA CON IA AGENTICA CON EFICIENCIA! 🧠
Nvidia ha activado oficialmente la producción en masa para el acelerador Groq 3 LPX, marcando una rotación estructural clave desde el entrenamiento puro de modelos hacia la ejecución continua. 🦈 Los principales operadores de infraestructura se están topando directamente con límites de potencia, obligando al capital inteligente a pivotar hacia arquitecturas de alta eficiencia para cargas de trabajo de IA agentica de múltiples pasos. 📊
Esta transición desplaza el punto de referencia operativo de la capacidad de procesamiento bruta a la eficiencia optimizada de cómputo por vatio. 🔍 A medida que la inferencia en vivo persistente reemplaza el entrenamiento de modelos estático, el diseño de hardware consciente de la energía se convierte en la ventaja definitoria para la escala institucional. 💡
🤔 ¿Las limitaciones de energía obligarán a una gran reevaluación de valoración en este año en los sectores de cómputo de alto rendimiento? 👇
⚠️ No es asesoramiento financiero. Administra siempre tu riesgo. 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
18
·
--
🚨 $AI INFERENCE SHIFT: €200M APUESTA CONTRA EL MONOPOLIO DE GPU ⚡
La Serie A de €200M de Euclyd, co-liderada por Samsung, EQT y Somerset, es un voto estructural a favor de la inferencia de IA como el próximo cuello de botella. 📊 Sus 16.384 procesadores en memoria y la hoja de ruta de exaescala para 2028 atacan la capa de eficiencia energética donde las GPU podrían ser vulnerables.
⚡ El problema: la eficiencia 100x de Nvidia que se afirma sigue siendo una proyección, no una prueba comercial. Esa brecha entre ambición y verificación es exactamente donde el dinero inteligente busca catalizadores. 💬 ¿Es este el comienzo de un nuevo ciclo de hardware de IA, o aún es una narrativa no probada? 👇
⚠️ No es asesoramiento financiero. Gestiona siempre tu riesgo. 🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
39
·
--
El próximo informe de SpaceX es más que una noticia corporativa; destaca el choque entre las cajas negras privadas y la $ETH y $BTC ethos.
Las empresas centralizadas exigen fe ciega en las matemáticas del consejo. Los protocolos descentralizados obligan al código a demostrar cada afirmación. Las auditorías independientes de tu propio balance son la única forma de garantizar la seguridad real en este mercado.
$ETH $BTC #Web3 #Inference #DeFi
65

·
--
⚡ $FET AI INFERENCE BOTTLENECK PIVOTS TO MEMORY BANDWIDTH AS INSTITUTIONS RESTRUCTURE INFRASTRUCTURE! 📊
Las demandas informáticas institucionales están cambiando drásticamente de la capacidad de memoria sin procesar a la orquestación de ancho de banda hipereficiente. 📊 A medida que domina la arquitectura MoE, la velocidad de enrutamiento entre las canalizaciones de Prefill y Decode se ha convertido en el principal cuello de botella para la infraestructura de hardware de próxima generación.
La programación del caché KV por niveles y el rendimiento de ancho de banda ahora determinan la eficiencia del clúster más que la densidad de hardware en bruto. 🔍 El capital inteligente se está posicionando en torno a protocolos de infraestructura que optimizan la sobrecarga del movimiento de datos antes de la próxima expansión de escalado.
💡 Las arquitecturas de nodos desacopladas están obligando a una revisión completa de las estrategias de asignación de hardware institucional. 💬 ¿Los protocolos de optimización de ancho de banda capturarán la próxima rotación estructural en la computación descentralizada? 👇
⚠️ No es asesoramiento financiero. Gestiona siempre tu riesgo. 🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
239

·
--
$AI Los costos de infraestructura están subiendo a medida que la demanda de inferencia se expande ⚡
Citigroup dice que la demanda de inferencia de IA sigue caliente, y la presión ya no se limita a los chips más nuevos. La escasez se está moviendo a través de GPUs, centros de datos, acceso a energía y capas de enrutamiento, lo que significa que el mercado ahora está valorando toda la pila, no solo los semiconductores.
La clave aquí es estructural: los proveedores de modelos están monetizando más rápido, mientras que los cuellos de botella en la infraestructura se están convirtiendo en la verdadera restricción. Si esta tendencia continúa, el valor puede seguir rotando hacia las capas que ayudan a reducir el costo de inferencia y asignar el cómputo de manera más eficiente.
No es asesoría financiera. Maneja tu riesgo.
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
64
Inicia sesión para explorar más contenidos
Únete a usuarios globales de criptomonedas en Binance Square
⚡️ Obtén información útil y actualizada sobre criptos.
💬 Avalado por el mayor exchange de criptomonedas en el mundo.
👍 Descubre perspectivas reales de creadores verificados.
Email/número de teléfono
Temas populares
1
#BinanceProcesses$4.65BWithdrawals
15,062 vistas
88 están debatiendo
2
#WithdrawalsBack: 15 networks live
6,444 vistas
114 están debatiendo
3
#BinanceUpdatesProofofReservesAddresses
105,885 vistas
1,421 están debatiendo
4
#BinanceToResumePhaseOneOfWithdrawals
145,075 vistas
1,524 están debatiendo
5
#BinanceHadAlreadyCovered$6BofHackLoss
9,750 vistas
132 están debatiendo
6
#FBIConfirmsNorthKoreaIsResponsibleForBinanceCryptoHack
47,979 vistas
146 están debatiendo
7
#CZDismissesClaimsBinanceHackWasPredicted
72,975 vistas
700 están debatiendo
8
#B14gReportsUnauthorizedTransferOfAbout97MCORE
25,498 vistas
344 están debatiendo
9
#USSpotETHETFsPost23StraightDaysOfNetOutflows
28,705 vistas
325 están debatiendo
10
#IntelHasItsWorstDaySince1974
121,306 vistas
939 están debatiendo