
空杯之心
13 Posts

空杯之心
Report
Block User
分享心得
Open Trade
High-Frequency Trader
9 Years
10 Following
9 Followers
2 Liked
Posts
Portfolio
·
--
Article
九个加密策略砍到三个:回撤过不了,收益再高也不留上一期结尾我写,下一期做三件事:给融合信号接上 buffer 和止损,跑验证期,再做 walk-forward。
这期没按这个顺序走。
数据补到 10 月 21 日之后,我先把九条策略一起拉到新的前向窗口上跑了一遍,同时把测试期的回撤结构重新排了一次。跑完的决定是:九条只留三条,另外六条连同策略文件、回测结果一起删掉。
被删的六条不是不赚钱。五条测试期收益超过 +115%,最高一条 +152.67%。但它们的最深回撤在 -21.8% 到 -54.8% 之间,水下时间最长 232 个交易日。这种曲线放在回测里能看,放进实盘账户,大部分人扛不到回本那天。
所以这期先做减法。下面讲清楚四件事:为什么改计划、按什么标准砍、砍完剩下什么、以及一个还没解决的问题。
一、上一期的计划,为什么先改了
上一期交付的是“能一键复现的九策略目录”:九个策略文件、六份信号、一个 notebook,9/9 逐项对账通过。那期的目标是让数字可信,不是判断哪个策略该上。
问题也出在这里。目录把九条策略并排放在一起,读者很容易理解成九个都是候选。实际上其中几条的回撤在 -50% 上下,资金曲线中间有半年不创新高。它们能留在目录里,是因为当时的任务是复现,不是筛选。
如果在这个状态下继续给融合加止损、做 walk-forward,等于在一堆不能用的策略上继续加功能。功能叠得越多,后面越难分清问题出在信号、风控还是执行。
另一个变化是数据。10 月 1 日到 21 日的数据到了。这是测试期之后第一段没有参与过任何选择的时间,虽然只有 21 天,但足够做一次体检。
顺序于是改成:先按测试期的风险结构筛一遍,砍到三条;再用 10 月做前向验证;最后才回到融合加止损和 walk-forward。维护的策略从九条变成三条,后面的工作反而更快。
验证期这次也没跑。VALID 参与了模型早停,只能算半样本内;论干净程度,它不如 10 月这 21 天。等 stop10 的成交问题解决,再把验证期和 walk-forward 一起补上。
二、Calmar 的两个算法,先对齐
上一期给融合写的 Calmar 是 7.49,这一期的筛选表里写的是 9.38。同一个策略两个数,先说清楚。
两个都对,算法不同。7.49 是年化口径:把 457 天的总收益按 365/457 折成年化,再除以最大回撤。9.38 是区间口径:457 天的总收益直接除以最大回撤。测试期比一年长,折年之后分子变小,所以 7.49 比 9.38 低。
这一期的门槛用的是区间口径,所以 9.38 对的是门槛 7。三条保留策略按年化口径分别是 7.49、6.43、6.33。
以后看到 Calmar,先问一句是哪种算法。混着比,策略会排错。
三、四条门槛:先看回撤,再看收益
筛选只看测试期,2025 年 7 月 1 日到 2026 年 9 月 30 日,457 天,1000 万本金。四条门槛:
- 最大回撤不超过 20%
- Calmar(区间总收益除以最大回撤)不低于 7
- Ulcer 指数不超过 8
- 最长水下天数不超过 110 个交易日
为什么是这四条。回撤决定这条策略能不能被拿住;Calmar 把收益和回撤放在一起看;Ulcer 不只看最深的那一次,还看回撤持续多久、反复多少次;水下天数最直观,就是账户从高点跌下去之后,多少天没回来。四个指标都在回答同一个问题:这条曲线,人能不能坐得住。
收益排名不在门槛里。原因很简单:收益高但回撤 -50% 的策略,实盘里通常活不到收益兑现。
10 月的数据不参与筛选。只有 21 天,拿它挑策略等于让裁判兼选手。10 月只用来验证,不用来选。
需要诚实说明一点:这四条门槛是我看完九条结果之后定的,属于事后标准,不是事先写好的规则。它能帮我做出一致的取舍,但不构成统计意义上的证明。
四、九条策略的成绩单
按 Calmar 从高到低排:
| 策略 | 收益 | 最大回撤 | Calmar | 夏普 | Ulcer | 水下天数 | 结论 |
|---|---:|---:|---:|---:|---:|---:|---|
| 融合 top5 | +172.93% | -18.44% | 9.38 | 2.076 | 7.59 | 107 | 保留 |
| 模型 buf4 止损10 | +130.86% | -16.25% | 8.05 | 1.906 | 6.10 | 96 | 保留 |
| 模型 多头buf5 止损10 | +114.01% | -14.39% | 7.92 | 1.846 | 4.84 | 75 | 保留 |
| mom10 top5 多头buf5 | +152.67% | -30.13% | 5.07 | 1.577 | 13.48 | 171 | 淘汰 |
| 模型 buf4 止损35 | +151.47% | -31.42% | 4.82 | 1.635 | 11.90 | 123 | 淘汰 |
| mom10 top5 | +134.22% | -39.03% | 3.44 | 1.385 | 13.93 | 171 | 淘汰 |
| mom10 top20 多头buf5 | +68.98% | -21.81% | 3.16 | 1.563 | 6.92 | 109 | 淘汰 |
| 模型 buf4 | +137.55% | -54.80% | 2.51 | 1.368 | 22.31 | 219 | 淘汰 |
| 模型 多头buf5 | +115.08% | -51.89% | 2.22 | 1.174 | 25.96 | 232 | 淘汰 |
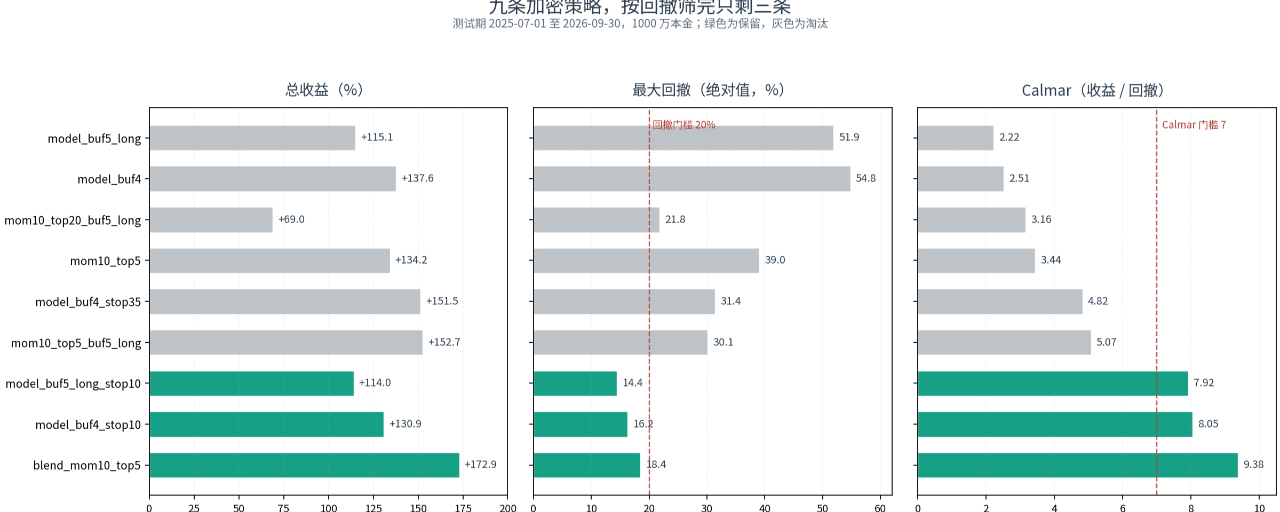
图 1:左边是收益,中间是最大回撤,右边是 Calmar,绿色保留,灰色淘汰。虚线是回撤 20% 和 Calmar 7 的门槛。
分界线很清楚。保留的三条 Calmar 都在 7.9 以上,Ulcer 不超过 7.6,水下天数不超过 107。淘汰的六条 Calmar 最高 5.07,Ulcer 最低 6.92。
注意 mom10 top20 这一条。它的回撤 -21.81%,只超门槛 1.8 个百分点;Ulcer 6.92,在 8 以内;水下 109 天,刚好在 110 以内。单看这三个指标,它离合格不远。但 Calmar 只有 3.16,收益被稀释得太厉害,还是过不了。
五、六条为什么被删
一条一条说。
模型 buf4,+137.55%,回撤 -54.80%。这是模型信号加双边 buffer4 的版本。buffer 把收益从负的做到 +137%,但回撤仍在 -54.80%;再调 buffer 档位,回撤几乎不动。这条最能说明 buffer 单独当不了风控:它改善的是换手和排名稳定性,压不住尾部。
模型多头 buf5,+115.08%,回撤 -51.89%。把多头 buffer 设成 5、空头不加 buffer,回撤只从 -54.80% 变到 -51.89%。Ulcer 25.96、水下 232 天,两项都是九条里最差。
模型 buf4 止损35,+151.47%,回撤 -31.42%。收益排第三,听起来应该留下。但回撤超过 30%,Calmar 4.82,水下 123 天。35% 的单币止损,对加密这种波动来说太松了,触发的时候已经亏了很多。
mom10 top5 多头 buf5,+152.67%,回撤 -30.13%。这是九条里收益第二高的策略,也是被删的六条里收益最高的。问题一样:回撤 30%,水下 171 天。收益排第二,照样过不了回撤这一关。
mom10 top5,+134.22%,回撤 -39.03%。纯动量 top5,没有 buffer,没有止损。动量因子的尾部本来就重,单日最差 -13.10%。
mom10 top20 多头 buf5,+68.98%,回撤 -21.81%。这是被删的六条里回撤最浅的一条。但 Calmar 只有 3.16,收益被分散稀释了一半。它证明的是另一件事:把仓位摊薄,不会让策略变好,只会让它变小。
六、三个能带走的结论
第一,止损是控回撤的第一杠杆,buffer 不是。
同一族模型信号,先固定对称 buffer4,做三组对照。什么都不加:+137.55%,回撤 -54.80%。加 35% 单币止损:+151.47%,回撤 -31.42%。加 10% 单币止损:+130.86%,回撤 -16.25%。再把 buffer 换成多头 5、空头 0,不加止损:回撤 -51.89%,几乎没变。
四条曲线放在一起,结论没有歧义。想压回撤,先上止损;buffer 主要管换手和排名稳定性,压不住尾部。
第二,触发次数少,不等于风险小。
35% 止损在测试期触发 121 次,10% 止损触发 646 次。看起来 35% 更省心,但回撤是 -31.42% 对 -16.25%。原因不复杂:触发少,是因为每次要亏到 35% 才砍,单次损失大;触发多,是因为亏 10% 就砍,单次损失小。评估止损不能只看触发次数,要看单次损失乘上压力窗口里可能连续触发几次。
先估压力窗口里会连续触发几次,再定阈值。10% 是在小损失时就切断,35% 更像心理止损,告诉自己“我已经设了止损”,但真到触发时,账户已经伤得不轻。
第三,分散只是等比例缩小,不提高风险调整后的效率。
mom10 top5 换成 top20,再加多头 buffer5:年化波动从 63.1% 降到 29.6%,回撤从 -39.03% 降到 -21.81%。看起来风险降了一半。但收益从 134.22% 掉到 68.98%,Calmar 从 3.44 降到 3.16。收益和风险一起缩小,效率反而更差。
如果目标是降风险,直接降杠杆更干净。分散适合解决“单币仓位太重”,不适合当成提高夏普的工具。
还有一条更朴素的:收益排名会骗人。按收益排,stop35 第三、mom10 多头 buf5 第二,都该留下;按 Calmar 和回撤排,它们连门槛都过不了。选策略先看能不能拿住,再看能赚多少。
七、留下的三条,是三个风险档位
| 策略 | 定位 | 收益 | 最大回撤 | Calmar | 夏普 | Ulcer | 水下天数 |
|---|---|---:|---:|---:|---:|---:|---:|
| 融合 top5 | 收益最高,无止损 | +172.93% | -18.44% | 9.38 | 2.076 | 7.59 | 107 |
| 模型 buf4 止损10 | 收益回撤均衡 | +130.86% | -16.25% | 8.05 | 1.906 | 6.10 | 96 |
| 模型 多头buf5 止损10 | 回撤最小,曲线最平滑 | +114.01% | -14.39% | 7.92 | 1.846 | 4.84 | 75 |
图 2:三条策略从 2025 年 7 月跑到 2026 年 10 月 21 日,1000 万本金。虚线右边是 10 月前向段。
这三条不是“同类里挑三个最好的”,是三种风险档位。
融合 top5 收益最高,风险调整后也最好,但它没有止损。10 月下跌月,它的回撤是三条里最深的,原因就在这里。上一期说好要给融合加止损,这期没做,后面会讲为什么。
模型 buf4 止损10 是中间档。双边 buffer4,加上 10% 单币止损,收益和回撤比较均衡。
模型多头 buf5 止损10 是防守档。多头 buffer5、空头不加 buffer,再加 10% 止损。回撤最小,Ulcer 4.84,水下只有 75 天,曲线最平滑,收益也最低。
如果只能选一条,要看资金属性和回撤容忍度。能扛 -20% 回撤、追求收益,选融合;要平滑,选多头 buf5 止损10;两者之间选 buf4 止损10。这是取舍,不是排名。
## 八、10 月前向:止损第一次在前向数据上起了作用
模型是冻结的。重训后 `best_iteration` 仍是 290,测试段预测和上一期发布的文件最大差 0.0,10 月的信号没有重新调参。
10 月 1 日到 21 日,信号池 122 个合约等权下跌 8.57%,中位数下跌 9.82%。$BTC 涨 0.57%,$ETH 跌 7.89%,$SOL 跌 9.45%。山寨普跌、BTC 横盘。
三条策略的结果:
| 策略 | 10 月盈亏 | 对 9/30 权益 | 对 1000 万 | 最大回撤 | 止损次数 | 多头/空头 |
|---|---:|---:|---:|---:|---:|---:|
| 模型 多头buf5 止损10 | +27.1 万 | +1.26% | +2.71% | -2.63% | 24 | +25.5 / +1.5 万 |
| 模型 buf4 止损10 | +6.1 万 | +0.27% | +0.61% | -3.11% | 22 | +6.1 / +0.1 万 |
| 融合 top5 | -43.9 万 | -1.61% | -4.39% | -4.39% | 0 | -53.7 / +9.8 万 |
收益口径有两个,都列出来。对 9/30 权益,是因为测试期已经复利,三条策略的权益在 2140 万到 2729 万之间;对 1000 万,是因为策略下单规模一直按 1000 万算,不随权益复利。前者是账户实际收益率,后者更接近策略本身的赚钱能力。21 天的数字不要按比例年化。
下跌月里,两条 stop10 都保住了正收益。融合没有止损,多头腿亏了 53.7 万,最差一天 -71.2 万,亏损直接落到净值上。这是三条策略分化的直接原因,也是止损第一次在前向数据上证明自己。
但 21 天太短,不能说明长期。而且这个正收益有几处水分,要挤掉。
第一,收益很集中。两条 stop10 持仓高度重合,GTC 一只赚 60.3 万,MAGMA 赚 22.9 万,AKE 赚 20.1 万。buf4 最好的一天赚 37.9 万,占全部正收益的 21.9%,最好三天占 56.9%。日胜率只有 38.1%,中位日亏 1.1 万。也就是说,正收益靠少数大阳日和少数合约,不能按“平均每天赚多少”去外推。
第二,仓位没有打满。每条策略 10 个仓位里有 1 个死仓:两条 stop10 是 OMNI 的空头,融合是 VANRY 的空头,合约退市后一直没平掉,占着 100 万名义敞口但不产生盈亏。两条模型策略 10 月的平均活跃名义敞口只有 647 到 657 万,融合是 997 万。stop10 的正收益是在大约六成半仓位下拿到的。这是回测引擎的已知问题,不是这次数据更新造成的,已经列进待修清单。
第三,资金费没有算进主回测。事后按日末持仓估算,融合收 7.2 万,两条 stop10 各付 8.8 到 8.9 万,对 1000 万都在 1 个百分点以内。方向清楚,但这不是精确成本。
第四,IC 强,不等于尾部能赚钱。前向 20 日 IC 均值 0.0760,90% 的交易日为正,位于测试期滚动窗口的 91.1 分位。但把同一个分数换成原始 2 日收益来排序,10 月的截面并不单调:按策略实际选币口径,p5 多头前五平均 -3.59%/2 日,p0 空头后五 -0.49%/2 日,多空价差 -3.10%,t 值 -2.07。模型排的是按波动归一后的 2 日收益标签,不等于原始收益的尾部预测。10 月的 p5 多头尾部主要被 10 月 4 日和 10 月 19 日两个暴跌日拖累,策略靠 buffer、止损、空头腿和少数赢家把结果拉回来。尾部诊断只有 19 个信号日,样本太短,只能得出“继续观察”,不能据此判断模型失效,更不能加杠杆。
## 九、最不舒服的一段:2% 止损滑点
回测假设止损能在止损价附近成交。把止损滑点加到 2% 重跑:
| 策略 | 基准盈亏 | 2% 滑点盈亏 | 基准权益收益 | 2% 滑点权益收益 | 基准回撤 | 2% 滑点回撤 |
|---|---:|---:|---:|---:|---:|---:|
| 模型 buf4 止损10 | +6.1 万 | -38.5 万 | +0.27% | -3.80% | -3.11% | -8.85% |
| 模型 多头buf5 止损10 | +27.1 万 | -21.9 万 | +1.26% | -2.65% | -2.63% | -7.93% |
正收益直接没了。
这个结果可以用算术解释。每触发一次止损,对应一个 100 万的仓位,2% 滑点就是 2 万。10 月触发 22 到 24 次,合计四五十万,足以把 +6 万和 +27 万打成负数。
反过来看,这也说明 stop10 的收益来源不是“选币更准”,而是“亏损截断得早”。一旦止损成交质量变差,这个优势会迅速消失。
2% 是压力测试,不是预测。真实滑点可能更小,也可能更大,取决于币的流动性、止损单类型和当时的行情。但在用真实盘口和成交量验证之前,两条 stop10 策略的正收益只能算纸面上的。
这也是为什么这期没给融合加止损。上一期说过,带止损的策略只支持 p5/p0 选币,融合选币要先把分数接口抽出来。更要紧的是,如果 stop10 的成交质量还没验证,就给融合套一个同样依赖成交的止损,等于把同一个问题复制一份。先解决成交,再加功能。
十、清理、边界和下一期
六条策略的文件和回测结果已经删掉:6 个策略 py、6 份测试期回测、6 份 10 月回测、6 份根目录回测结果,一共 24 个文件。删之前备份到了临时目录 `/tmp/eliminated_strategies_2026-10-22/`,机器重启会没,长期记录以仓库里的 `策略筛选记录.md` 为准。逐日净值 parquet 没有单独备份。
为什么不留着?因为留下来的文件会继续以“候选策略”的身份存在。过两周回来,看到九条策略,很容易在一条已经证明回撤过大的策略上继续调参。删除是治理动作,不是洁癖。
同步做的清理:notebook 从九条改成三条,重跑通过;测试期和前向汇总各 3 行;10 月明细 CSV 也是 3 行;报告重写成三策略版本;筛选记录里写清每一条的淘汰数字和理由。
边界也要说清楚。筛选标准是事后定的;测试期已经用于选参,457 天不是干净样本外;10 月只有 21 天;主回测是日线,不含资金费、强平、保证金和真实滑点;止损是日线事后近似。这些限制不会因为结果好看就消失。
下一期按顺序做三件事。第一,解决 stop10 的成交质量:真实盘口、分层滑点、止损单类型,至少要给出一个可信的滑点区间。第二,修死仓问题,重跑 10 月,看有效敞口补齐后结果怎么变。第三,再回到融合加止损和 walk-forward。如果 stop10 的成交质量过不了关,两条模型的保留策略要重新设计,不能靠回测里的止损价活着。另外还有一个名单误杀要复核:GRAM 被静态非加密名单排除,但它其实是加密永续。
本文是回测研究记录,不是交易信号,也不构成投资建议。这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #因子研究 #Alpha策略 #Beta中性 #加密货币
九个加密策略砍到三个:回撤过不了,收益再高也不留
上一期结尾我写,下一期做三件事:给融合信号接上 buffer 和止损,跑验证期,再做 walk-forward。
这期没按这个顺序走。
数据补到 10 月 21 日之后,我先把九条策略一起拉到新的前向窗口上跑了一遍,同时把测试期的回撤结构重新排了一次。跑完的决定是:九条只留三条,另外六条连同策略文件、回测结果一起删掉。
被删的六条不是不赚钱。五条测试期收益超过 +115%,最高一条 +152.67%。但它们的最深回撤在 -21.8% 到 -54.8% 之间,水下时间最长 232 个交易日。这种曲线放在回测里能看,放进实盘账户,大部分人扛不到回本那天。
所以这期先做减法。下面讲清楚四件事:为什么改计划、按什么标准砍、砍完剩下什么、以及一个还没解决的问题。
一、上一期的计划,为什么先改了
上一期交付的是“能一键复现的九策略目录”:九个策略文件、六份信号、一个 notebook,9/9 逐项对账通过。那期的目标是让数字可信,不是判断哪个策略该上。
问题也出在这里。目录把九条策略并排放在一起,读者很容易理解成九个都是候选。实际上其中几条的回撤在 -50% 上下,资金曲线中间有半年不创新高。它们能留在目录里,是因为当时的任务是复现,不是筛选。
如果在这个状态下继续给融合加止损、做 walk-forward,等于在一堆不能用的策略上继续加功能。功能叠得越多,后面越难分清问题出在信号、风控还是执行。
另一个变化是数据。10 月 1 日到 21 日的数据到了。这是测试期之后第一段没有参与过任何选择的时间,虽然只有 21 天,但足够做一次体检。
顺序于是改成:先按测试期的风险结构筛一遍,砍到三条;再用 10 月做前向验证;最后才回到融合加止损和 walk-forward。维护的策略从九条变成三条,后面的工作反而更快。
验证期这次也没跑。VALID 参与了模型早停,只能算半样本内;论干净程度,它不如 10 月这 21 天。等 stop10 的成交问题解决,再把验证期和 walk-forward 一起补上。
二、Calmar 的两个算法,先对齐
上一期给融合写的 Calmar 是 7.49,这一期的筛选表里写的是 9.38。同一个策略两个数,先说清楚。
两个都对,算法不同。7.49 是年化口径:把 457 天的总收益按 365/457 折成年化,再除以最大回撤。9.38 是区间口径:457 天的总收益直接除以最大回撤。测试期比一年长,折年之后分子变小,所以 7.49 比 9.38 低。
这一期的门槛用的是区间口径,所以 9.38 对的是门槛 7。三条保留策略按年化口径分别是 7.49、6.43、6.33。
以后看到 Calmar,先问一句是哪种算法。混着比,策略会排错。
三、四条门槛:先看回撤,再看收益
筛选只看测试期,2025 年 7 月 1 日到 2026 年 9 月 30 日,457 天,1000 万本金。四条门槛:
- 最大回撤不超过 20%
- Calmar(区间总收益除以最大回撤)不低于 7
- Ulcer 指数不超过 8
- 最长水下天数不超过 110 个交易日
为什么是这四条。回撤决定这条策略能不能被拿住;Calmar 把收益和回撤放在一起看;Ulcer 不只看最深的那一次,还看回撤持续多久、反复多少次;水下天数最直观,就是账户从高点跌下去之后,多少天没回来。四个指标都在回答同一个问题:这条曲线,人能不能坐得住。
收益排名不在门槛里。原因很简单:收益高但回撤 -50% 的策略,实盘里通常活不到收益兑现。
10 月的数据不参与筛选。只有 21 天,拿它挑策略等于让裁判兼选手。10 月只用来验证,不用来选。
需要诚实说明一点:这四条门槛是我看完九条结果之后定的,属于事后标准,不是事先写好的规则。它能帮我做出一致的取舍,但不构成统计意义上的证明。
四、九条策略的成绩单
按 Calmar 从高到低排:
| 策略 | 收益 | 最大回撤 | Calmar | 夏普 | Ulcer | 水下天数 | 结论 |
|---|---:|---:|---:|---:|---:|---:|---|
| 融合 top5 | +172.93% | -18.44% | 9.38 | 2.076 | 7.59 | 107 | 保留 |
| 模型 buf4 止损10 | +130.86% | -16.25% | 8.05 | 1.906 | 6.10 | 96 | 保留 |
| 模型 多头buf5 止损10 | +114.01% | -14.39% | 7.92 | 1.846 | 4.84 | 75 | 保留 |
| mom10 top5 多头buf5 | +152.67% | -30.13% | 5.07 | 1.577 | 13.48 | 171 | 淘汰 |
| 模型 buf4 止损35 | +151.47% | -31.42% | 4.82 | 1.635 | 11.90 | 123 | 淘汰 |
| mom10 top5 | +134.22% | -39.03% | 3.44 | 1.385 | 13.93 | 171 | 淘汰 |
| mom10 top20 多头buf5 | +68.98% | -21.81% | 3.16 | 1.563 | 6.92 | 109 | 淘汰 |
| 模型 buf4 | +137.55% | -54.80% | 2.51 | 1.368 | 22.31 | 219 | 淘汰 |
| 模型 多头buf5 | +115.08% | -51.89% | 2.22 | 1.174 | 25.96 | 232 | 淘汰 |
图 1:左边是收益,中间是最大回撤,右边是 Calmar,绿色保留,灰色淘汰。虚线是回撤 20% 和 Calmar 7 的门槛。
分界线很清楚。保留的三条 Calmar 都在 7.9 以上,Ulcer 不超过 7.6,水下天数不超过 107。淘汰的六条 Calmar 最高 5.07,Ulcer 最低 6.92。
注意 mom10 top20 这一条。它的回撤 -21.81%,只超门槛 1.8 个百分点;Ulcer 6.92,在 8 以内;水下 109 天,刚好在 110 以内。单看这三个指标,它离合格不远。但 Calmar 只有 3.16,收益被稀释得太厉害,还是过不了。
五、六条为什么被删
一条一条说。
模型 buf4,+137.55%,回撤 -54.80%。这是模型信号加双边 buffer4 的版本。buffer 把收益从负的做到 +137%,但回撤仍在 -54.80%;再调 buffer 档位,回撤几乎不动。这条最能说明 buffer 单独当不了风控:它改善的是换手和排名稳定性,压不住尾部。
模型多头 buf5,+115.08%,回撤 -51.89%。把多头 buffer 设成 5、空头不加 buffer,回撤只从 -54.80% 变到 -51.89%。Ulcer 25.96、水下 232 天,两项都是九条里最差。
模型 buf4 止损35,+151.47%,回撤 -31.42%。收益排第三,听起来应该留下。但回撤超过 30%,Calmar 4.82,水下 123 天。35% 的单币止损,对加密这种波动来说太松了,触发的时候已经亏了很多。
mom10 top5 多头 buf5,+152.67%,回撤 -30.13%。这是九条里收益第二高的策略,也是被删的六条里收益最高的。问题一样:回撤 30%,水下 171 天。收益排第二,照样过不了回撤这一关。
mom10 top5,+134.22%,回撤 -39.03%。纯动量 top5,没有 buffer,没有止损。动量因子的尾部本来就重,单日最差 -13.10%。
mom10 top20 多头 buf5,+68.98%,回撤 -21.81%。这是被删的六条里回撤最浅的一条。但 Calmar 只有 3.16,收益被分散稀释了一半。它证明的是另一件事:把仓位摊薄,不会让策略变好,只会让它变小。
六、三个能带走的结论
第一,止损是控回撤的第一杠杆,buffer 不是。
同一族模型信号,先固定对称 buffer4,做三组对照。什么都不加:+137.55%,回撤 -54.80%。加 35% 单币止损:+151.47%,回撤 -31.42%。加 10% 单币止损:+130.86%,回撤 -16.25%。再把 buffer 换成多头 5、空头 0,不加止损:回撤 -51.89%,几乎没变。
四条曲线放在一起,结论没有歧义。想压回撤,先上止损;buffer 主要管换手和排名稳定性,压不住尾部。
第二,触发次数少,不等于风险小。
35% 止损在测试期触发 121 次,10% 止损触发 646 次。看起来 35% 更省心,但回撤是 -31.42% 对 -16.25%。原因不复杂:触发少,是因为每次要亏到 35% 才砍,单次损失大;触发多,是因为亏 10% 就砍,单次损失小。评估止损不能只看触发次数,要看单次损失乘上压力窗口里可能连续触发几次。
先估压力窗口里会连续触发几次,再定阈值。10% 是在小损失时就切断,35% 更像心理止损,告诉自己“我已经设了止损”,但真到触发时,账户已经伤得不轻。
第三,分散只是等比例缩小,不提高风险调整后的效率。
mom10 top5 换成 top20,再加多头 buffer5:年化波动从 63.1% 降到 29.6%,回撤从 -39.03% 降到 -21.81%。看起来风险降了一半。但收益从 134.22% 掉到 68.98%,Calmar 从 3.44 降到 3.16。收益和风险一起缩小,效率反而更差。
如果目标是降风险,直接降杠杆更干净。分散适合解决“单币仓位太重”,不适合当成提高夏普的工具。
还有一条更朴素的:收益排名会骗人。按收益排,stop35 第三、mom10 多头 buf5 第二,都该留下;按 Calmar 和回撤排,它们连门槛都过不了。选策略先看能不能拿住,再看能赚多少。
七、留下的三条,是三个风险档位
| 策略 | 定位 | 收益 | 最大回撤 | Calmar | 夏普 | Ulcer | 水下天数 |
|---|---|---:|---:|---:|---:|---:|---:|
| 融合 top5 | 收益最高,无止损 | +172.93% | -18.44% | 9.38 | 2.076 | 7.59 | 107 |
| 模型 buf4 止损10 | 收益回撤均衡 | +130.86% | -16.25% | 8.05 | 1.906 | 6.10 | 96 |
| 模型 多头buf5 止损10 | 回撤最小,曲线最平滑 | +114.01% | -14.39% | 7.92 | 1.846 | 4.84 | 75 |
图 2:三条策略从 2025 年 7 月跑到 2026 年 10 月 21 日,1000 万本金。虚线右边是 10 月前向段。
这三条不是“同类里挑三个最好的”,是三种风险档位。
融合 top5 收益最高,风险调整后也最好,但它没有止损。10 月下跌月,它的回撤是三条里最深的,原因就在这里。上一期说好要给融合加止损,这期没做,后面会讲为什么。
模型 buf4 止损10 是中间档。双边 buffer4,加上 10% 单币止损,收益和回撤比较均衡。
模型多头 buf5 止损10 是防守档。多头 buffer5、空头不加 buffer,再加 10% 止损。回撤最小,Ulcer 4.84,水下只有 75 天,曲线最平滑,收益也最低。
如果只能选一条,要看资金属性和回撤容忍度。能扛 -20% 回撤、追求收益,选融合;要平滑,选多头 buf5 止损10;两者之间选 buf4 止损10。这是取舍,不是排名。
## 八、10 月前向:止损第一次在前向数据上起了作用
模型是冻结的。重训后 `best_iteration` 仍是 290,测试段预测和上一期发布的文件最大差 0.0,10 月的信号没有重新调参。
10 月 1 日到 21 日,信号池 122 个合约等权下跌 8.57%,中位数下跌 9.82%。$BTC 涨 0.57%,$ETH 跌 7.89%,$SOL 跌 9.45%。山寨普跌、BTC 横盘。
三条策略的结果:
| 策略 | 10 月盈亏 | 对 9/30 权益 | 对 1000 万 | 最大回撤 | 止损次数 | 多头/空头 |
|---|---:|---:|---:|---:|---:|---:|
| 模型 多头buf5 止损10 | +27.1 万 | +1.26% | +2.71% | -2.63% | 24 | +25.5 / +1.5 万 |
| 模型 buf4 止损10 | +6.1 万 | +0.27% | +0.61% | -3.11% | 22 | +6.1 / +0.1 万 |
| 融合 top5 | -43.9 万 | -1.61% | -4.39% | -4.39% | 0 | -53.7 / +9.8 万 |
收益口径有两个,都列出来。对 9/30 权益,是因为测试期已经复利,三条策略的权益在 2140 万到 2729 万之间;对 1000 万,是因为策略下单规模一直按 1000 万算,不随权益复利。前者是账户实际收益率,后者更接近策略本身的赚钱能力。21 天的数字不要按比例年化。
下跌月里,两条 stop10 都保住了正收益。融合没有止损,多头腿亏了 53.7 万,最差一天 -71.2 万,亏损直接落到净值上。这是三条策略分化的直接原因,也是止损第一次在前向数据上证明自己。
但 21 天太短,不能说明长期。而且这个正收益有几处水分,要挤掉。
第一,收益很集中。两条 stop10 持仓高度重合,GTC 一只赚 60.3 万,MAGMA 赚 22.9 万,AKE 赚 20.1 万。buf4 最好的一天赚 37.9 万,占全部正收益的 21.9%,最好三天占 56.9%。日胜率只有 38.1%,中位日亏 1.1 万。也就是说,正收益靠少数大阳日和少数合约,不能按“平均每天赚多少”去外推。
第二,仓位没有打满。每条策略 10 个仓位里有 1 个死仓:两条 stop10 是 OMNI 的空头,融合是 VANRY 的空头,合约退市后一直没平掉,占着 100 万名义敞口但不产生盈亏。两条模型策略 10 月的平均活跃名义敞口只有 647 到 657 万,融合是 997 万。stop10 的正收益是在大约六成半仓位下拿到的。这是回测引擎的已知问题,不是这次数据更新造成的,已经列进待修清单。
第三,资金费没有算进主回测。事后按日末持仓估算,融合收 7.2 万,两条 stop10 各付 8.8 到 8.9 万,对 1000 万都在 1 个百分点以内。方向清楚,但这不是精确成本。
第四,IC 强,不等于尾部能赚钱。前向 20 日 IC 均值 0.0760,90% 的交易日为正,位于测试期滚动窗口的 91.1 分位。但把同一个分数换成原始 2 日收益来排序,10 月的截面并不单调:按策略实际选币口径,p5 多头前五平均 -3.59%/2 日,p0 空头后五 -0.49%/2 日,多空价差 -3.10%,t 值 -2.07。模型排的是按波动归一后的 2 日收益标签,不等于原始收益的尾部预测。10 月的 p5 多头尾部主要被 10 月 4 日和 10 月 19 日两个暴跌日拖累,策略靠 buffer、止损、空头腿和少数赢家把结果拉回来。尾部诊断只有 19 个信号日,样本太短,只能得出“继续观察”,不能据此判断模型失效,更不能加杠杆。
## 九、最不舒服的一段:2% 止损滑点
回测假设止损能在止损价附近成交。把止损滑点加到 2% 重跑:
| 策略 | 基准盈亏 | 2% 滑点盈亏 | 基准权益收益 | 2% 滑点权益收益 | 基准回撤 | 2% 滑点回撤 |
|---|---:|---:|---:|---:|---:|---:|
| 模型 buf4 止损10 | +6.1 万 | -38.5 万 | +0.27% | -3.80% | -3.11% | -8.85% |
| 模型 多头buf5 止损10 | +27.1 万 | -21.9 万 | +1.26% | -2.65% | -2.63% | -7.93% |
正收益直接没了。
这个结果可以用算术解释。每触发一次止损,对应一个 100 万的仓位,2% 滑点就是 2 万。10 月触发 22 到 24 次,合计四五十万,足以把 +6 万和 +27 万打成负数。
反过来看,这也说明 stop10 的收益来源不是“选币更准”,而是“亏损截断得早”。一旦止损成交质量变差,这个优势会迅速消失。
2% 是压力测试,不是预测。真实滑点可能更小,也可能更大,取决于币的流动性、止损单类型和当时的行情。但在用真实盘口和成交量验证之前,两条 stop10 策略的正收益只能算纸面上的。
这也是为什么这期没给融合加止损。上一期说过,带止损的策略只支持 p5/p0 选币,融合选币要先把分数接口抽出来。更要紧的是,如果 stop10 的成交质量还没验证,就给融合套一个同样依赖成交的止损,等于把同一个问题复制一份。先解决成交,再加功能。
十、清理、边界和下一期
六条策略的文件和回测结果已经删掉:6 个策略 py、6 份测试期回测、6 份 10 月回测、6 份根目录回测结果,一共 24 个文件。删之前备份到了临时目录 `/tmp/eliminated_strategies_2026-10-22/`,机器重启会没,长期记录以仓库里的 `策略筛选记录.md` 为准。逐日净值 parquet 没有单独备份。
为什么不留着?因为留下来的文件会继续以“候选策略”的身份存在。过两周回来,看到九条策略,很容易在一条已经证明回撤过大的策略上继续调参。删除是治理动作,不是洁癖。
同步做的清理:notebook 从九条改成三条,重跑通过;测试期和前向汇总各 3 行;10 月明细 CSV 也是 3 行;报告重写成三策略版本;筛选记录里写清每一条的淘汰数字和理由。
边界也要说清楚。筛选标准是事后定的;测试期已经用于选参,457 天不是干净样本外;10 月只有 21 天;主回测是日线,不含资金费、强平、保证金和真实滑点;止损是日线事后近似。这些限制不会因为结果好看就消失。
下一期按顺序做三件事。第一,解决 stop10 的成交质量:真实盘口、分层滑点、止损单类型,至少要给出一个可信的滑点区间。第二,修死仓问题,重跑 10 月,看有效敞口补齐后结果怎么变。第三,再回到融合加止损和 walk-forward。如果 stop10 的成交质量过不了关,两条模型的保留策略要重新设计,不能靠回测里的止损价活着。另外还有一个名单误杀要复核:GRAM 被静态非加密名单排除,但它其实是加密永续。
本文是回测研究记录,不是交易信号,也不构成投资建议。这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #因子研究 #Alpha策略 #Beta中性 #加密货币
这期没按这个顺序走。
数据补到 10 月 21 日之后,我先把九条策略一起拉到新的前向窗口上跑了一遍,同时把测试期的回撤结构重新排了一次。跑完的决定是:九条只留三条,另外六条连同策略文件、回测结果一起删掉。
被删的六条不是不赚钱。五条测试期收益超过 +115%,最高一条 +152.67%。但它们的最深回撤在 -21.8% 到 -54.8% 之间,水下时间最长 232 个交易日。这种曲线放在回测里能看,放进实盘账户,大部分人扛不到回本那天。
所以这期先做减法。下面讲清楚四件事:为什么改计划、按什么标准砍、砍完剩下什么、以及一个还没解决的问题。
一、上一期的计划,为什么先改了
上一期交付的是“能一键复现的九策略目录”:九个策略文件、六份信号、一个 notebook,9/9 逐项对账通过。那期的目标是让数字可信,不是判断哪个策略该上。
问题也出在这里。目录把九条策略并排放在一起,读者很容易理解成九个都是候选。实际上其中几条的回撤在 -50% 上下,资金曲线中间有半年不创新高。它们能留在目录里,是因为当时的任务是复现,不是筛选。
如果在这个状态下继续给融合加止损、做 walk-forward,等于在一堆不能用的策略上继续加功能。功能叠得越多,后面越难分清问题出在信号、风控还是执行。
另一个变化是数据。10 月 1 日到 21 日的数据到了。这是测试期之后第一段没有参与过任何选择的时间,虽然只有 21 天,但足够做一次体检。
顺序于是改成:先按测试期的风险结构筛一遍,砍到三条;再用 10 月做前向验证;最后才回到融合加止损和 walk-forward。维护的策略从九条变成三条,后面的工作反而更快。
验证期这次也没跑。VALID 参与了模型早停,只能算半样本内;论干净程度,它不如 10 月这 21 天。等 stop10 的成交问题解决,再把验证期和 walk-forward 一起补上。
二、Calmar 的两个算法,先对齐
上一期给融合写的 Calmar 是 7.49,这一期的筛选表里写的是 9.38。同一个策略两个数,先说清楚。
两个都对,算法不同。7.49 是年化口径:把 457 天的总收益按 365/457 折成年化,再除以最大回撤。9.38 是区间口径:457 天的总收益直接除以最大回撤。测试期比一年长,折年之后分子变小,所以 7.49 比 9.38 低。
这一期的门槛用的是区间口径,所以 9.38 对的是门槛 7。三条保留策略按年化口径分别是 7.49、6.43、6.33。
以后看到 Calmar,先问一句是哪种算法。混着比,策略会排错。
三、四条门槛:先看回撤,再看收益
筛选只看测试期,2025 年 7 月 1 日到 2026 年 9 月 30 日,457 天,1000 万本金。四条门槛:
- 最大回撤不超过 20%
- Calmar(区间总收益除以最大回撤)不低于 7
- Ulcer 指数不超过 8
- 最长水下天数不超过 110 个交易日
为什么是这四条。回撤决定这条策略能不能被拿住;Calmar 把收益和回撤放在一起看;Ulcer 不只看最深的那一次,还看回撤持续多久、反复多少次;水下天数最直观,就是账户从高点跌下去之后,多少天没回来。四个指标都在回答同一个问题:这条曲线,人能不能坐得住。
收益排名不在门槛里。原因很简单:收益高但回撤 -50% 的策略,实盘里通常活不到收益兑现。
10 月的数据不参与筛选。只有 21 天,拿它挑策略等于让裁判兼选手。10 月只用来验证,不用来选。
需要诚实说明一点:这四条门槛是我看完九条结果之后定的,属于事后标准,不是事先写好的规则。它能帮我做出一致的取舍,但不构成统计意义上的证明。
四、九条策略的成绩单
按 Calmar 从高到低排:
| 策略 | 收益 | 最大回撤 | Calmar | 夏普 | Ulcer | 水下天数 | 结论 |
|---|---:|---:|---:|---:|---:|---:|---|
| 融合 top5 | +172.93% | -18.44% | 9.38 | 2.076 | 7.59 | 107 | 保留 |
| 模型 buf4 止损10 | +130.86% | -16.25% | 8.05 | 1.906 | 6.10 | 96 | 保留 |
| 模型 多头buf5 止损10 | +114.01% | -14.39% | 7.92 | 1.846 | 4.84 | 75 | 保留 |
| mom10 top5 多头buf5 | +152.67% | -30.13% | 5.07 | 1.577 | 13.48 | 171 | 淘汰 |
| 模型 buf4 止损35 | +151.47% | -31.42% | 4.82 | 1.635 | 11.90 | 123 | 淘汰 |
| mom10 top5 | +134.22% | -39.03% | 3.44 | 1.385 | 13.93 | 171 | 淘汰 |
| mom10 top20 多头buf5 | +68.98% | -21.81% | 3.16 | 1.563 | 6.92 | 109 | 淘汰 |
| 模型 buf4 | +137.55% | -54.80% | 2.51 | 1.368 | 22.31 | 219 | 淘汰 |
| 模型 多头buf5 | +115.08% | -51.89% | 2.22 | 1.174 | 25.96 | 232 | 淘汰 |
图 1:左边是收益,中间是最大回撤,右边是 Calmar,绿色保留,灰色淘汰。虚线是回撤 20% 和 Calmar 7 的门槛。
分界线很清楚。保留的三条 Calmar 都在 7.9 以上,Ulcer 不超过 7.6,水下天数不超过 107。淘汰的六条 Calmar 最高 5.07,Ulcer 最低 6.92。
注意 mom10 top20 这一条。它的回撤 -21.81%,只超门槛 1.8 个百分点;Ulcer 6.92,在 8 以内;水下 109 天,刚好在 110 以内。单看这三个指标,它离合格不远。但 Calmar 只有 3.16,收益被稀释得太厉害,还是过不了。
五、六条为什么被删
一条一条说。
模型 buf4,+137.55%,回撤 -54.80%。这是模型信号加双边 buffer4 的版本。buffer 把收益从负的做到 +137%,但回撤仍在 -54.80%;再调 buffer 档位,回撤几乎不动。这条最能说明 buffer 单独当不了风控:它改善的是换手和排名稳定性,压不住尾部。
模型多头 buf5,+115.08%,回撤 -51.89%。把多头 buffer 设成 5、空头不加 buffer,回撤只从 -54.80% 变到 -51.89%。Ulcer 25.96、水下 232 天,两项都是九条里最差。
模型 buf4 止损35,+151.47%,回撤 -31.42%。收益排第三,听起来应该留下。但回撤超过 30%,Calmar 4.82,水下 123 天。35% 的单币止损,对加密这种波动来说太松了,触发的时候已经亏了很多。
mom10 top5 多头 buf5,+152.67%,回撤 -30.13%。这是九条里收益第二高的策略,也是被删的六条里收益最高的。问题一样:回撤 30%,水下 171 天。收益排第二,照样过不了回撤这一关。
mom10 top5,+134.22%,回撤 -39.03%。纯动量 top5,没有 buffer,没有止损。动量因子的尾部本来就重,单日最差 -13.10%。
mom10 top20 多头 buf5,+68.98%,回撤 -21.81%。这是被删的六条里回撤最浅的一条。但 Calmar 只有 3.16,收益被分散稀释了一半。它证明的是另一件事:把仓位摊薄,不会让策略变好,只会让它变小。
六、三个能带走的结论
第一,止损是控回撤的第一杠杆,buffer 不是。
同一族模型信号,先固定对称 buffer4,做三组对照。什么都不加:+137.55%,回撤 -54.80%。加 35% 单币止损:+151.47%,回撤 -31.42%。加 10% 单币止损:+130.86%,回撤 -16.25%。再把 buffer 换成多头 5、空头 0,不加止损:回撤 -51.89%,几乎没变。
四条曲线放在一起,结论没有歧义。想压回撤,先上止损;buffer 主要管换手和排名稳定性,压不住尾部。
第二,触发次数少,不等于风险小。
35% 止损在测试期触发 121 次,10% 止损触发 646 次。看起来 35% 更省心,但回撤是 -31.42% 对 -16.25%。原因不复杂:触发少,是因为每次要亏到 35% 才砍,单次损失大;触发多,是因为亏 10% 就砍,单次损失小。评估止损不能只看触发次数,要看单次损失乘上压力窗口里可能连续触发几次。
先估压力窗口里会连续触发几次,再定阈值。10% 是在小损失时就切断,35% 更像心理止损,告诉自己“我已经设了止损”,但真到触发时,账户已经伤得不轻。
第三,分散只是等比例缩小,不提高风险调整后的效率。
mom10 top5 换成 top20,再加多头 buffer5:年化波动从 63.1% 降到 29.6%,回撤从 -39.03% 降到 -21.81%。看起来风险降了一半。但收益从 134.22% 掉到 68.98%,Calmar 从 3.44 降到 3.16。收益和风险一起缩小,效率反而更差。
如果目标是降风险,直接降杠杆更干净。分散适合解决“单币仓位太重”,不适合当成提高夏普的工具。
还有一条更朴素的:收益排名会骗人。按收益排,stop35 第三、mom10 多头 buf5 第二,都该留下;按 Calmar 和回撤排,它们连门槛都过不了。选策略先看能不能拿住,再看能赚多少。
七、留下的三条,是三个风险档位
| 策略 | 定位 | 收益 | 最大回撤 | Calmar | 夏普 | Ulcer | 水下天数 |
|---|---|---:|---:|---:|---:|---:|---:|
| 融合 top5 | 收益最高,无止损 | +172.93% | -18.44% | 9.38 | 2.076 | 7.59 | 107 |
| 模型 buf4 止损10 | 收益回撤均衡 | +130.86% | -16.25% | 8.05 | 1.906 | 6.10 | 96 |
| 模型 多头buf5 止损10 | 回撤最小,曲线最平滑 | +114.01% | -14.39% | 7.92 | 1.846 | 4.84 | 75 |
图 2:三条策略从 2025 年 7 月跑到 2026 年 10 月 21 日,1000 万本金。虚线右边是 10 月前向段。
这三条不是“同类里挑三个最好的”,是三种风险档位。
融合 top5 收益最高,风险调整后也最好,但它没有止损。10 月下跌月,它的回撤是三条里最深的,原因就在这里。上一期说好要给融合加止损,这期没做,后面会讲为什么。
模型 buf4 止损10 是中间档。双边 buffer4,加上 10% 单币止损,收益和回撤比较均衡。
模型多头 buf5 止损10 是防守档。多头 buffer5、空头不加 buffer,再加 10% 止损。回撤最小,Ulcer 4.84,水下只有 75 天,曲线最平滑,收益也最低。
如果只能选一条,要看资金属性和回撤容忍度。能扛 -20% 回撤、追求收益,选融合;要平滑,选多头 buf5 止损10;两者之间选 buf4 止损10。这是取舍,不是排名。
## 八、10 月前向:止损第一次在前向数据上起了作用
模型是冻结的。重训后 `best_iteration` 仍是 290,测试段预测和上一期发布的文件最大差 0.0,10 月的信号没有重新调参。
10 月 1 日到 21 日,信号池 122 个合约等权下跌 8.57%,中位数下跌 9.82%。$BTC 涨 0.57%,$ETH 跌 7.89%,$SOL 跌 9.45%。山寨普跌、BTC 横盘。
三条策略的结果:
| 策略 | 10 月盈亏 | 对 9/30 权益 | 对 1000 万 | 最大回撤 | 止损次数 | 多头/空头 |
|---|---:|---:|---:|---:|---:|---:|
| 模型 多头buf5 止损10 | +27.1 万 | +1.26% | +2.71% | -2.63% | 24 | +25.5 / +1.5 万 |
| 模型 buf4 止损10 | +6.1 万 | +0.27% | +0.61% | -3.11% | 22 | +6.1 / +0.1 万 |
| 融合 top5 | -43.9 万 | -1.61% | -4.39% | -4.39% | 0 | -53.7 / +9.8 万 |
收益口径有两个,都列出来。对 9/30 权益,是因为测试期已经复利,三条策略的权益在 2140 万到 2729 万之间;对 1000 万,是因为策略下单规模一直按 1000 万算,不随权益复利。前者是账户实际收益率,后者更接近策略本身的赚钱能力。21 天的数字不要按比例年化。
下跌月里,两条 stop10 都保住了正收益。融合没有止损,多头腿亏了 53.7 万,最差一天 -71.2 万,亏损直接落到净值上。这是三条策略分化的直接原因,也是止损第一次在前向数据上证明自己。
但 21 天太短,不能说明长期。而且这个正收益有几处水分,要挤掉。
第一,收益很集中。两条 stop10 持仓高度重合,GTC 一只赚 60.3 万,MAGMA 赚 22.9 万,AKE 赚 20.1 万。buf4 最好的一天赚 37.9 万,占全部正收益的 21.9%,最好三天占 56.9%。日胜率只有 38.1%,中位日亏 1.1 万。也就是说,正收益靠少数大阳日和少数合约,不能按“平均每天赚多少”去外推。
第二,仓位没有打满。每条策略 10 个仓位里有 1 个死仓:两条 stop10 是 OMNI 的空头,融合是 VANRY 的空头,合约退市后一直没平掉,占着 100 万名义敞口但不产生盈亏。两条模型策略 10 月的平均活跃名义敞口只有 647 到 657 万,融合是 997 万。stop10 的正收益是在大约六成半仓位下拿到的。这是回测引擎的已知问题,不是这次数据更新造成的,已经列进待修清单。
第三,资金费没有算进主回测。事后按日末持仓估算,融合收 7.2 万,两条 stop10 各付 8.8 到 8.9 万,对 1000 万都在 1 个百分点以内。方向清楚,但这不是精确成本。
第四,IC 强,不等于尾部能赚钱。前向 20 日 IC 均值 0.0760,90% 的交易日为正,位于测试期滚动窗口的 91.1 分位。但把同一个分数换成原始 2 日收益来排序,10 月的截面并不单调:按策略实际选币口径,p5 多头前五平均 -3.59%/2 日,p0 空头后五 -0.49%/2 日,多空价差 -3.10%,t 值 -2.07。模型排的是按波动归一后的 2 日收益标签,不等于原始收益的尾部预测。10 月的 p5 多头尾部主要被 10 月 4 日和 10 月 19 日两个暴跌日拖累,策略靠 buffer、止损、空头腿和少数赢家把结果拉回来。尾部诊断只有 19 个信号日,样本太短,只能得出“继续观察”,不能据此判断模型失效,更不能加杠杆。
## 九、最不舒服的一段:2% 止损滑点
回测假设止损能在止损价附近成交。把止损滑点加到 2% 重跑:
| 策略 | 基准盈亏 | 2% 滑点盈亏 | 基准权益收益 | 2% 滑点权益收益 | 基准回撤 | 2% 滑点回撤 |
|---|---:|---:|---:|---:|---:|---:|
| 模型 buf4 止损10 | +6.1 万 | -38.5 万 | +0.27% | -3.80% | -3.11% | -8.85% |
| 模型 多头buf5 止损10 | +27.1 万 | -21.9 万 | +1.26% | -2.65% | -2.63% | -7.93% |
正收益直接没了。
这个结果可以用算术解释。每触发一次止损,对应一个 100 万的仓位,2% 滑点就是 2 万。10 月触发 22 到 24 次,合计四五十万,足以把 +6 万和 +27 万打成负数。
反过来看,这也说明 stop10 的收益来源不是“选币更准”,而是“亏损截断得早”。一旦止损成交质量变差,这个优势会迅速消失。
2% 是压力测试,不是预测。真实滑点可能更小,也可能更大,取决于币的流动性、止损单类型和当时的行情。但在用真实盘口和成交量验证之前,两条 stop10 策略的正收益只能算纸面上的。
这也是为什么这期没给融合加止损。上一期说过,带止损的策略只支持 p5/p0 选币,融合选币要先把分数接口抽出来。更要紧的是,如果 stop10 的成交质量还没验证,就给融合套一个同样依赖成交的止损,等于把同一个问题复制一份。先解决成交,再加功能。
十、清理、边界和下一期
六条策略的文件和回测结果已经删掉:6 个策略 py、6 份测试期回测、6 份 10 月回测、6 份根目录回测结果,一共 24 个文件。删之前备份到了临时目录 `/tmp/eliminated_strategies_2026-10-22/`,机器重启会没,长期记录以仓库里的 `策略筛选记录.md` 为准。逐日净值 parquet 没有单独备份。
为什么不留着?因为留下来的文件会继续以“候选策略”的身份存在。过两周回来,看到九条策略,很容易在一条已经证明回撤过大的策略上继续调参。删除是治理动作,不是洁癖。
同步做的清理:notebook 从九条改成三条,重跑通过;测试期和前向汇总各 3 行;10 月明细 CSV 也是 3 行;报告重写成三策略版本;筛选记录里写清每一条的淘汰数字和理由。
边界也要说清楚。筛选标准是事后定的;测试期已经用于选参,457 天不是干净样本外;10 月只有 21 天;主回测是日线,不含资金费、强平、保证金和真实滑点;止损是日线事后近似。这些限制不会因为结果好看就消失。
下一期按顺序做三件事。第一,解决 stop10 的成交质量:真实盘口、分层滑点、止损单类型,至少要给出一个可信的滑点区间。第二,修死仓问题,重跑 10 月,看有效敞口补齐后结果怎么变。第三,再回到融合加止损和 walk-forward。如果 stop10 的成交质量过不了关,两条模型的保留策略要重新设计,不能靠回测里的止损价活着。另外还有一个名单误杀要复核:GRAM 被静态非加密名单排除,但它其实是加密永续。
本文是回测研究记录,不是交易信号,也不构成投资建议。这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #因子研究 #Alpha策略 #Beta中性 #加密货币
402
·
--
# 九个策略,一个 notebook:+172.93% 的回测必须能一键复现上一期把模型分数和动量各取一半,测试期做到 +172.93% 收益、-18.44% 回撤、夏普 2.076。结尾我说,下一期把融合接上 buffer 和止损,再跑验证期。
真开始做之前,我先停了一下。九个表现较好的策略,结果散在不同的消融脚本和缓存目录里,参数写在配置字典,信号文件命名不统一。如果换一台机器,或者过两周再回来,这九个数字还能不能原样跑出来?答案是不能。
所以这一期不继续追收益,先把九个策略固化成能一键复现的目录。一个不能复现的回测,和编故事没有区别。
这次交付三样东西:九个策略文件、六份信号文件、一个统一 notebook。九个策略全部跑通,9/9 与预期值逐项对上。
一、为什么先做复现,而不是继续调参
这个系列前两期,一期在清洗币池,一期在修选币接口。到这一期,策略数量已经有九个,继续加参数很容易,但每加一个,复现难度就高一分。
之前的九个策略来自 `robust_ablation.py` 和 `risk_guard_ablation.py` 的配置字典。同样的选币逻辑抄在不同配置里,参数写死。改一个信号,你分不清是信号变了,还是代码路径变了。更麻烦的是,别人看到一个数字,没有办法判断它是哪版代码、哪份信号、哪套参数跑出来的。
复现不是形式主义。它把策略从一次性的脚本输出,变成可以引用、可以对比、可以传给别人检查的文件。后面不管加资金费、加滑点,还是做 walk-forward,都需要一个稳定的起点。
二、九个策略文件:只固定参数,不复制逻辑
新建目录 `alpha/crypto/strategy_catalog/`,九个策略文件放在里面。每个文件对应一个策略:
- 融合 top5
- 模型 buf4 止损35
- mom10 top5 多头 buf5
- 模型 buf4 止损10
- 模型 多头 buf5 止损10
- mom10 top5
- 模型 buf4
- 模型 多头 buf5
- mom10 top20 多头 buf5
九个文件都是薄子类,不复制基类逻辑。选币、排名缓冲区、止损状态机仍然在 `CryptoRobustStrategy` 和 `CryptoRobustGuardedStrategy` 里,子类只固定参数。
每个文件统一导出六个对象:策略名、信号族、策略类、回测参数、测试期预期指标、验证期对照值。验证期对照值只有三个 mom10 策略有,模型和融合暂时留空。notebook 靠这些对象自动组装,不需要手写九段回测代码。
为什么不做成九个独立实现?因为九个文件如果各抄一份选币逻辑,就是九个潜在的 bug。改基类只改一处,九个策略同时受益;改参数只改一个文件,不会影响其他八个。
文件头的中文说明写清楚四件事:多空两端怎么选、需要哪族信号和哪些列、固定参数是什么意思、什么情况下这个策略会失效。最后一条很重要。一个策略文件如果只写怎么赚钱,不写什么时候会亏,下次很容易在一个已经坏掉的策略上继续调参。
这里有一个具体的坑。三个止损策略的 `stop_pct` 和 `stop_cooldown` 必须同时写进 `BACKTEST_SETTING`。因为回测 runner 读的是 `setting.get("stop_pct")`,不是类属性。只写在类上,策略自己仍会判止损,但 runner 不会做事后盈亏校正,回测照常出结果,止损日的账却是错的。notebook 里加了断言,类属性和 setting 必须一致,不一致直接报错。
另一个限制是,`CryptoRobustGuardedStrategy` 的 `on_bars` 硬编码了 p5 和 p0,只支持 level 选币,不支持融合选币。九个策略里没有融合加止损,所以这次不改基类,只在三个止损文件的说明里写清楚。以后要做融合加止损,得先把基类的选币接口抽出来。
三、六份信号:三族信号,测试和验证各一份
九个策略共用三族信号,不需要复制九份:
- 模型信号:p5、p0、score,来自 LightGBM 五分类模型
- mom10 信号:过去 10 个交易日的动量
- 融合信号:模型分数排名和动量排名各取一半
每族信号有测试段和验证段两份,一共六份文件。
为什么不给每个策略复制一份信号?因为信号是输入,策略是消费方式。同一份模型信号,top5、buffer4、止损10 都是不同的消费方式。复制九份会让 hash 校验失去意义,也容易改了一处忘了另一处。
所有信号共用一套 schema,融合文件多三列诊断列:
| 列 | 类型 | 含义 |
|---|---|---|
| datetime | Datetime("us") | 交易日午夜,naive 时间 |
| vt_symbol | String | 合约代码 |
| signal | Array(Float64, 6) | 五分类概率 |
| p5 | Float64 | signal[5],进入最高一档的概率 |
| p0 | Float64 | signal[0],进入最低一档的概率 |
| score | Float64 | p5 减 p0 |
| mom_return_10 | Float64 | 10 日动量 |
| score_rank_pct | Float64 | 模型分数的截面排名分位,仅融合文件 |
| mom_rank_pct | Float64 | 动量的截面排名分位,仅融合文件 |
| blend_score | Float64 | 两列各半,仅融合文件 |
写入前检查四件事:主键日期加合约唯一;合约与纯加密排除名单交集为空;`signal` 仍然是 `Array(Float64, 6)`,不能变成 `List`;p5、p0、score 三者自洽。
还有一个容易被忽略的点:行序不能动。
选币时如果排名在边界上并列,稳定排序会按原始行序决定谁进谁出。把信号文件按日期或合约排一次序,持仓就可能变,收益也跟着变。所以所有投影和补列都保留源文件行序,禁止排序。这不是代码风格问题,是结果能不能复现的问题。
图 1:测试段每份 8.4 万行,验证段的模型和融合是 8.6 万行,mom10 验证段是 12.0 万行。mom10 验证段行数多,不是币更多,是编码口径不同。
四、mom10 的测试段和验证段,不能互换
这是这次最容易踩的坑。
mom10 测试段用的是数据集裁剪过的 `mom_return_10`,范围压在正负 3 之间。mom10 验证段用的是 risk table 里未裁剪的 `mom10`。两个文件看起来是同一个信号,其实编码不一样。
不能互换,也不能拿其中一个重算另一个。跨段比较之前必须先看口径。把两段结果直接拼在一起,看起来都是 mom10,实际上衡量的不是同一件事。
模型验证段还有另一层限制。VALID 参与了每日 IC 早停,所以 `model_valid` 只能算半样本内。这次模型 `best_iteration` 是 290,验证段每日 IC 是 0.0373。这个数字不能当成干净样本外,后面做验证期结论时要打折。
为了保证训练和投影没有漂移,notebook 里加了一道 test parity 闸门:重新预测测试段,和已经保存的 `model_test` 逐行比较,最大绝对差必须小于 `1e-6`。这次实际差值是 0.0。
五、一个 notebook:校验、加载、回测、对账
统一入口是 `strategy_catalog_backtest.ipynb`。四个开关控制运行方式:
- `RUN_SEGMENTS=["test"]`:先只跑测试段
- `FORCE_REBUILD_SIGNALS=False`:信号缺了才重建
- `RETRAIN_MODEL=False`:默认不重训,直接用缓存模型
- `ALLOW_MODEL_MISMATCH=False`:模型对不上就中止,不静默继续
流程分六步:
1. 加载 AlphaLab、CRYPTO.LOCAL 成分和纯加密过滤
2. 校验或生成六份信号
3. 动态导入九个策略模块,组装策略目录
4. 每段加载三族信号和 OHLC,逐个调用回测 runner
5. 写出每个策略的 JSON 指标和逐日净值 parquet
6. 生成对账表,实际值、预期值、差值、通过与否放在一起
回测复用 `risk_guard_ablation.run_config`,不新写 runner。它已经包含止损触发日盈亏替换、次日残余清零、手续费保留和指标重算。如果为了这次目录再写一套回测,两套引擎迟早会跑出两套数字。
对账标准是固定的:
- 收益和最大回撤误差不超过 0.01 个百分点
- 夏普误差不超过 0.001
- Calmar 误差不超过 0.01
- 成交数和止损次数精确相等
这次 9/9 全部通过。每个策略的逐日净值都是 457 行,期末权益等于 1000 万乘以 1 加收益率。三个止损策略的止损次数分别是 121、646、652,和策略端记录的止损次数完全一致。
不是差不多,是逐项对上。
六、九个策略的成绩单
把九个策略放在同一张表里,按收益从高到低:
| 策略 | 信号 | 收益 | 最大回撤 | 夏普 | 成交数 | 止损次数 |
|---|---|---:|---:|---:|---:|---:|
| 融合 top5 | 融合 | +172.93% | -18.44% | 2.076 | 7251 | 0 |
| mom10 top5 多头 buf5 | mom10 | +152.67% | -30.13% | 1.577 | 5879 | 0 |
| 模型 buf4 止损35 | 模型 | +151.47% | -31.42% | 1.635 | 4787 | 121 |
| 模型 buf4 | 模型 | +137.55% | -54.80% | 1.368 | 4745 | 0 |
| mom10 top5 | mom10 | +134.22% | -39.03% | 1.385 | 6201 | 0 |
| 模型 buf4 止损10 | 模型 | +130.86% | -16.25% | 1.906 | 4719 | 646 |
| 模型 多头 buf5 | 模型 | +115.08% | -51.89% | 1.174 | 4855 | 0 |
| 模型 多头 buf5 止损10 | 模型 | +114.01% | -14.39% | 1.846 | 4743 | 652 |
| mom10 top20 多头 buf5 | mom10 | +68.98% | -21.81% | 1.563 | 22474 | 0 |
图 2:左边是收益,右边是回撤绝对值,同一个顺序。橙色是带止损的模型策略,灰色是不带止损的模型策略,蓝色是 mom10,紫色是融合。
图 3:九个策略在同一段测试期、同样 1000 万本金下的净值曲线,共用纵轴。标题里的两个数字是总收益和最大回撤。
几个观察:
第一,融合仍然是第一。收益 +172.93%、回撤 -18.44%、夏普 2.076,三项都是九个策略里最好的。Calmar 7.49,也是唯一一个收益、回撤、夏普同时跑赢 mom10 最好变体的配置。只和 mom10 top5 比的话,模型 buf4 止损35 也能三项都赢,但它跑不过 mom10 多头 buffer5 的 +152.67%。
第二,止损能压回撤,但不能免费。两个 stop10 变体把回撤压到 -14.39% 和 -16.25%,夏普做到 1.846 和 1.906,但上一期已经验证过,stop10 对滑点极敏感,2% 滑点下收益几乎归零。stop35 收益 +151.47%、回撤 -31.42%,更稳,适合滑点不确定的场景。
第三,模型基线变体的回撤还在 -52% 到 -55%。buffer 把收益从负的做到 +115% 到 +137%,但没有解决尾部风险。收益改善和风险改善是两件事,不能因为收益变正就忽略回撤。
第四,mom10 top20 的收益最低,只有 +68.98%,成交 22474 次,是九个策略里交易最频繁的。持仓放宽不等于更好,交易成本会吃掉一部分收益。这也是后面必须把成本算进去的原因。
这个目录展示的是取舍,不是只有一个赢家。选哪个,取决于资金规模、滑点水平、回撤容忍度和调仓成本。
七、复现记录:commit、版本、hash
每次运行都会在 notebook 里生成一份复现记录,这次的内容是:
- 运行时间:2026-10-20T09:39:45
- git commit:`261a7147ed6810bd4e7a76397a9149f7353a6470`
- 工作区状态:有未提交改动
- Python 3.13.13,polars 1.41.2,lightgbm 4.6.0,vnpy 4.4.0
- 模型 `best_iteration`:290
- 验证段每日 IC:0.03727
- 测试段 parity 最大绝对差:0.0
六份信号的 SHA256 也全部记录:
| 信号文件 | SHA256 前 12 位 |
|---|---|
| model_test | c8e9e5642a78 |
| model_valid | 77e53a0a794b |
| mom10_test | d59cf2be7a10 |
| mom10_valid | 70e25941c252 |
| blend_mom10_test | 1d5b40457ab2 |
| blend_mom10_valid | c379b7b1bab9 |
工作区状态是有未提交改动,这一点要诚实写出来。它意味着这次结果对应的代码不是干净的 commit,严格来说,别人拿到 commit 号还不一定能完全还原。下次跑之前应该先提交,或者把 diff 一起存下来。复现记录的价值不在于好看,而在于把差异留在可追踪的地方。
下次有人问这个数字怎么来的,不用解释,把运行记录、信号 hash 和 notebook 一起给他。
八、边界和下一期
先把水分挤掉。
九个结果全部是测试期单段,2025 年 7 月到 2026 年 9 月,457 天。参数也是在这段测试期里反复选的,不是干净样本外。9/9 复现只证明代码和信号能复现这个数字,不证明这个数字能复现到未来。
模型验证段是半样本内,因为 VALID 参与了早停。mom10 验证段的币池和模型验证段不一样,跨族结果不能直接比较。资金费、强平、真实滑点、新币和低流动性过滤,这次都还没算。
下一期做三件事:把融合信号接上 buffer 和止损,跑验证期,再做 walk-forward。如果验证期站不住,+172.93% 就只是一个好看的测试期数字,得回来改。
复现不是终点,是起点。先把地基打完,再盖楼。
这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #因子研究 #Alpha策略 #Beta中性 #加密货币
# 九个策略,一个 notebook:+172.93% 的回测必须能一键复现
上一期把模型分数和动量各取一半,测试期做到 +172.93% 收益、-18.44% 回撤、夏普 2.076。结尾我说,下一期把融合接上 buffer 和止损,再跑验证期。
真开始做之前,我先停了一下。九个表现较好的策略,结果散在不同的消融脚本和缓存目录里,参数写在配置字典,信号文件命名不统一。如果换一台机器,或者过两周再回来,这九个数字还能不能原样跑出来?答案是不能。
所以这一期不继续追收益,先把九个策略固化成能一键复现的目录。一个不能复现的回测,和编故事没有区别。
这次交付三样东西:九个策略文件、六份信号文件、一个统一 notebook。九个策略全部跑通,9/9 与预期值逐项对上。
一、为什么先做复现,而不是继续调参
这个系列前两期,一期在清洗币池,一期在修选币接口。到这一期,策略数量已经有九个,继续加参数很容易,但每加一个,复现难度就高一分。
之前的九个策略来自 `robust_ablation.py` 和 `risk_guard_ablation.py` 的配置字典。同样的选币逻辑抄在不同配置里,参数写死。改一个信号,你分不清是信号变了,还是代码路径变了。更麻烦的是,别人看到一个数字,没有办法判断它是哪版代码、哪份信号、哪套参数跑出来的。
复现不是形式主义。它把策略从一次性的脚本输出,变成可以引用、可以对比、可以传给别人检查的文件。后面不管加资金费、加滑点,还是做 walk-forward,都需要一个稳定的起点。
二、九个策略文件:只固定参数,不复制逻辑
新建目录 `alpha/crypto/strategy_catalog/`,九个策略文件放在里面。每个文件对应一个策略:
- 融合 top5
- 模型 buf4 止损35
- mom10 top5 多头 buf5
- 模型 buf4 止损10
- 模型 多头 buf5 止损10
- mom10 top5
- 模型 buf4
- 模型 多头 buf5
- mom10 top20 多头 buf5
九个文件都是薄子类,不复制基类逻辑。选币、排名缓冲区、止损状态机仍然在 `CryptoRobustStrategy` 和 `CryptoRobustGuardedStrategy` 里,子类只固定参数。
每个文件统一导出六个对象:策略名、信号族、策略类、回测参数、测试期预期指标、验证期对照值。验证期对照值只有三个 mom10 策略有,模型和融合暂时留空。notebook 靠这些对象自动组装,不需要手写九段回测代码。
为什么不做成九个独立实现?因为九个文件如果各抄一份选币逻辑,就是九个潜在的 bug。改基类只改一处,九个策略同时受益;改参数只改一个文件,不会影响其他八个。
文件头的中文说明写清楚四件事:多空两端怎么选、需要哪族信号和哪些列、固定参数是什么意思、什么情况下这个策略会失效。最后一条很重要。一个策略文件如果只写怎么赚钱,不写什么时候会亏,下次很容易在一个已经坏掉的策略上继续调参。
这里有一个具体的坑。三个止损策略的 `stop_pct` 和 `stop_cooldown` 必须同时写进 `BACKTEST_SETTING`。因为回测 runner 读的是 `setting.get("stop_pct")`,不是类属性。只写在类上,策略自己仍会判止损,但 runner 不会做事后盈亏校正,回测照常出结果,止损日的账却是错的。notebook 里加了断言,类属性和 setting 必须一致,不一致直接报错。
另一个限制是,`CryptoRobustGuardedStrategy` 的 `on_bars` 硬编码了 p5 和 p0,只支持 level 选币,不支持融合选币。九个策略里没有融合加止损,所以这次不改基类,只在三个止损文件的说明里写清楚。以后要做融合加止损,得先把基类的选币接口抽出来。
三、六份信号:三族信号,测试和验证各一份
九个策略共用三族信号,不需要复制九份:
- 模型信号:p5、p0、score,来自 LightGBM 五分类模型
- mom10 信号:过去 10 个交易日的动量
- 融合信号:模型分数排名和动量排名各取一半
每族信号有测试段和验证段两份,一共六份文件。
为什么不给每个策略复制一份信号?因为信号是输入,策略是消费方式。同一份模型信号,top5、buffer4、止损10 都是不同的消费方式。复制九份会让 hash 校验失去意义,也容易改了一处忘了另一处。
所有信号共用一套 schema,融合文件多三列诊断列:
| 列 | 类型 | 含义 |
|---|---|---|
| datetime | Datetime("us") | 交易日午夜,naive 时间 |
| vt_symbol | String | 合约代码 |
| signal | Array(Float64, 6) | 五分类概率 |
| p5 | Float64 | signal[5],进入最高一档的概率 |
| p0 | Float64 | signal[0],进入最低一档的概率 |
| score | Float64 | p5 减 p0 |
| mom_return_10 | Float64 | 10 日动量 |
| score_rank_pct | Float64 | 模型分数的截面排名分位,仅融合文件 |
| mom_rank_pct | Float64 | 动量的截面排名分位,仅融合文件 |
| blend_score | Float64 | 两列各半,仅融合文件 |
写入前检查四件事:主键日期加合约唯一;合约与纯加密排除名单交集为空;`signal` 仍然是 `Array(Float64, 6)`,不能变成 `List`;p5、p0、score 三者自洽。
还有一个容易被忽略的点:行序不能动。
选币时如果排名在边界上并列,稳定排序会按原始行序决定谁进谁出。把信号文件按日期或合约排一次序,持仓就可能变,收益也跟着变。所以所有投影和补列都保留源文件行序,禁止排序。这不是代码风格问题,是结果能不能复现的问题。
图 1:测试段每份 8.4 万行,验证段的模型和融合是 8.6 万行,mom10 验证段是 12.0 万行。mom10 验证段行数多,不是币更多,是编码口径不同。
四、mom10 的测试段和验证段,不能互换
这是这次最容易踩的坑。
mom10 测试段用的是数据集裁剪过的 `mom_return_10`,范围压在正负 3 之间。mom10 验证段用的是 risk table 里未裁剪的 `mom10`。两个文件看起来是同一个信号,其实编码不一样。
不能互换,也不能拿其中一个重算另一个。跨段比较之前必须先看口径。把两段结果直接拼在一起,看起来都是 mom10,实际上衡量的不是同一件事。
模型验证段还有另一层限制。VALID 参与了每日 IC 早停,所以 `model_valid` 只能算半样本内。这次模型 `best_iteration` 是 290,验证段每日 IC 是 0.0373。这个数字不能当成干净样本外,后面做验证期结论时要打折。
为了保证训练和投影没有漂移,notebook 里加了一道 test parity 闸门:重新预测测试段,和已经保存的 `model_test` 逐行比较,最大绝对差必须小于 `1e-6`。这次实际差值是 0.0。
五、一个 notebook:校验、加载、回测、对账
统一入口是 `strategy_catalog_backtest.ipynb`。四个开关控制运行方式:
- `RUN_SEGMENTS=["test"]`:先只跑测试段
- `FORCE_REBUILD_SIGNALS=False`:信号缺了才重建
- `RETRAIN_MODEL=False`:默认不重训,直接用缓存模型
- `ALLOW_MODEL_MISMATCH=False`:模型对不上就中止,不静默继续
流程分六步:
1. 加载 AlphaLab、CRYPTO.LOCAL 成分和纯加密过滤
2. 校验或生成六份信号
3. 动态导入九个策略模块,组装策略目录
4. 每段加载三族信号和 OHLC,逐个调用回测 runner
5. 写出每个策略的 JSON 指标和逐日净值 parquet
6. 生成对账表,实际值、预期值、差值、通过与否放在一起
回测复用 `risk_guard_ablation.run_config`,不新写 runner。它已经包含止损触发日盈亏替换、次日残余清零、手续费保留和指标重算。如果为了这次目录再写一套回测,两套引擎迟早会跑出两套数字。
对账标准是固定的:
- 收益和最大回撤误差不超过 0.01 个百分点
- 夏普误差不超过 0.001
- Calmar 误差不超过 0.01
- 成交数和止损次数精确相等
这次 9/9 全部通过。每个策略的逐日净值都是 457 行,期末权益等于 1000 万乘以 1 加收益率。三个止损策略的止损次数分别是 121、646、652,和策略端记录的止损次数完全一致。
不是差不多,是逐项对上。
六、九个策略的成绩单
把九个策略放在同一张表里,按收益从高到低:
| 策略 | 信号 | 收益 | 最大回撤 | 夏普 | 成交数 | 止损次数 |
|---|---|---:|---:|---:|---:|---:|
| 融合 top5 | 融合 | +172.93% | -18.44% | 2.076 | 7251 | 0 |
| mom10 top5 多头 buf5 | mom10 | +152.67% | -30.13% | 1.577 | 5879 | 0 |
| 模型 buf4 止损35 | 模型 | +151.47% | -31.42% | 1.635 | 4787 | 121 |
| 模型 buf4 | 模型 | +137.55% | -54.80% | 1.368 | 4745 | 0 |
| mom10 top5 | mom10 | +134.22% | -39.03% | 1.385 | 6201 | 0 |
| 模型 buf4 止损10 | 模型 | +130.86% | -16.25% | 1.906 | 4719 | 646 |
| 模型 多头 buf5 | 模型 | +115.08% | -51.89% | 1.174 | 4855 | 0 |
| 模型 多头 buf5 止损10 | 模型 | +114.01% | -14.39% | 1.846 | 4743 | 652 |
| mom10 top20 多头 buf5 | mom10 | +68.98% | -21.81% | 1.563 | 22474 | 0 |
图 2:左边是收益,右边是回撤绝对值,同一个顺序。橙色是带止损的模型策略,灰色是不带止损的模型策略,蓝色是 mom10,紫色是融合。
图 3:九个策略在同一段测试期、同样 1000 万本金下的净值曲线,共用纵轴。标题里的两个数字是总收益和最大回撤。
几个观察:
第一,融合仍然是第一。收益 +172.93%、回撤 -18.44%、夏普 2.076,三项都是九个策略里最好的。Calmar 7.49,也是唯一一个收益、回撤、夏普同时跑赢 mom10 最好变体的配置。只和 mom10 top5 比的话,模型 buf4 止损35 也能三项都赢,但它跑不过 mom10 多头 buffer5 的 +152.67%。
第二,止损能压回撤,但不能免费。两个 stop10 变体把回撤压到 -14.39% 和 -16.25%,夏普做到 1.846 和 1.906,但上一期已经验证过,stop10 对滑点极敏感,2% 滑点下收益几乎归零。stop35 收益 +151.47%、回撤 -31.42%,更稳,适合滑点不确定的场景。
第三,模型基线变体的回撤还在 -52% 到 -55%。buffer 把收益从负的做到 +115% 到 +137%,但没有解决尾部风险。收益改善和风险改善是两件事,不能因为收益变正就忽略回撤。
第四,mom10 top20 的收益最低,只有 +68.98%,成交 22474 次,是九个策略里交易最频繁的。持仓放宽不等于更好,交易成本会吃掉一部分收益。这也是后面必须把成本算进去的原因。
这个目录展示的是取舍,不是只有一个赢家。选哪个,取决于资金规模、滑点水平、回撤容忍度和调仓成本。
七、复现记录:commit、版本、hash
每次运行都会在 notebook 里生成一份复现记录,这次的内容是:
- 运行时间:2026-10-20T09:39:45
- git commit:`261a7147ed6810bd4e7a76397a9149f7353a6470`
- 工作区状态:有未提交改动
- Python 3.13.13,polars 1.41.2,lightgbm 4.6.0,vnpy 4.4.0
- 模型 `best_iteration`:290
- 验证段每日 IC:0.03727
- 测试段 parity 最大绝对差:0.0
六份信号的 SHA256 也全部记录:
| 信号文件 | SHA256 前 12 位 |
|---|---|
| model_test | c8e9e5642a78 |
| model_valid | 77e53a0a794b |
| mom10_test | d59cf2be7a10 |
| mom10_valid | 70e25941c252 |
| blend_mom10_test | 1d5b40457ab2 |
| blend_mom10_valid | c379b7b1bab9 |
工作区状态是有未提交改动,这一点要诚实写出来。它意味着这次结果对应的代码不是干净的 commit,严格来说,别人拿到 commit 号还不一定能完全还原。下次跑之前应该先提交,或者把 diff 一起存下来。复现记录的价值不在于好看,而在于把差异留在可追踪的地方。
下次有人问这个数字怎么来的,不用解释,把运行记录、信号 hash 和 notebook 一起给他。
八、边界和下一期
先把水分挤掉。
九个结果全部是测试期单段,2025 年 7 月到 2026 年 9 月,457 天。参数也是在这段测试期里反复选的,不是干净样本外。9/9 复现只证明代码和信号能复现这个数字,不证明这个数字能复现到未来。
模型验证段是半样本内,因为 VALID 参与了早停。mom10 验证段的币池和模型验证段不一样,跨族结果不能直接比较。资金费、强平、真实滑点、新币和低流动性过滤,这次都还没算。
下一期做三件事:把融合信号接上 buffer 和止损,跑验证期,再做 walk-forward。如果验证期站不住,+172.93% 就只是一个好看的测试期数字,得回来改。
复现不是终点,是起点。先把地基打完,再盖楼。
这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #因子研究 #Alpha策略 #Beta中性 #加密货币
真开始做之前,我先停了一下。九个表现较好的策略,结果散在不同的消融脚本和缓存目录里,参数写在配置字典,信号文件命名不统一。如果换一台机器,或者过两周再回来,这九个数字还能不能原样跑出来?答案是不能。
所以这一期不继续追收益,先把九个策略固化成能一键复现的目录。一个不能复现的回测,和编故事没有区别。
这次交付三样东西:九个策略文件、六份信号文件、一个统一 notebook。九个策略全部跑通,9/9 与预期值逐项对上。
一、为什么先做复现,而不是继续调参
这个系列前两期,一期在清洗币池,一期在修选币接口。到这一期,策略数量已经有九个,继续加参数很容易,但每加一个,复现难度就高一分。
之前的九个策略来自 `robust_ablation.py` 和 `risk_guard_ablation.py` 的配置字典。同样的选币逻辑抄在不同配置里,参数写死。改一个信号,你分不清是信号变了,还是代码路径变了。更麻烦的是,别人看到一个数字,没有办法判断它是哪版代码、哪份信号、哪套参数跑出来的。
复现不是形式主义。它把策略从一次性的脚本输出,变成可以引用、可以对比、可以传给别人检查的文件。后面不管加资金费、加滑点,还是做 walk-forward,都需要一个稳定的起点。
二、九个策略文件:只固定参数,不复制逻辑
新建目录 `alpha/crypto/strategy_catalog/`,九个策略文件放在里面。每个文件对应一个策略:
- 融合 top5
- 模型 buf4 止损35
- mom10 top5 多头 buf5
- 模型 buf4 止损10
- 模型 多头 buf5 止损10
- mom10 top5
- 模型 buf4
- 模型 多头 buf5
- mom10 top20 多头 buf5
九个文件都是薄子类,不复制基类逻辑。选币、排名缓冲区、止损状态机仍然在 `CryptoRobustStrategy` 和 `CryptoRobustGuardedStrategy` 里,子类只固定参数。
每个文件统一导出六个对象:策略名、信号族、策略类、回测参数、测试期预期指标、验证期对照值。验证期对照值只有三个 mom10 策略有,模型和融合暂时留空。notebook 靠这些对象自动组装,不需要手写九段回测代码。
为什么不做成九个独立实现?因为九个文件如果各抄一份选币逻辑,就是九个潜在的 bug。改基类只改一处,九个策略同时受益;改参数只改一个文件,不会影响其他八个。
文件头的中文说明写清楚四件事:多空两端怎么选、需要哪族信号和哪些列、固定参数是什么意思、什么情况下这个策略会失效。最后一条很重要。一个策略文件如果只写怎么赚钱,不写什么时候会亏,下次很容易在一个已经坏掉的策略上继续调参。
这里有一个具体的坑。三个止损策略的 `stop_pct` 和 `stop_cooldown` 必须同时写进 `BACKTEST_SETTING`。因为回测 runner 读的是 `setting.get("stop_pct")`,不是类属性。只写在类上,策略自己仍会判止损,但 runner 不会做事后盈亏校正,回测照常出结果,止损日的账却是错的。notebook 里加了断言,类属性和 setting 必须一致,不一致直接报错。
另一个限制是,`CryptoRobustGuardedStrategy` 的 `on_bars` 硬编码了 p5 和 p0,只支持 level 选币,不支持融合选币。九个策略里没有融合加止损,所以这次不改基类,只在三个止损文件的说明里写清楚。以后要做融合加止损,得先把基类的选币接口抽出来。
三、六份信号:三族信号,测试和验证各一份
九个策略共用三族信号,不需要复制九份:
- 模型信号:p5、p0、score,来自 LightGBM 五分类模型
- mom10 信号:过去 10 个交易日的动量
- 融合信号:模型分数排名和动量排名各取一半
每族信号有测试段和验证段两份,一共六份文件。
为什么不给每个策略复制一份信号?因为信号是输入,策略是消费方式。同一份模型信号,top5、buffer4、止损10 都是不同的消费方式。复制九份会让 hash 校验失去意义,也容易改了一处忘了另一处。
所有信号共用一套 schema,融合文件多三列诊断列:
| 列 | 类型 | 含义 |
|---|---|---|
| datetime | Datetime("us") | 交易日午夜,naive 时间 |
| vt_symbol | String | 合约代码 |
| signal | Array(Float64, 6) | 五分类概率 |
| p5 | Float64 | signal[5],进入最高一档的概率 |
| p0 | Float64 | signal[0],进入最低一档的概率 |
| score | Float64 | p5 减 p0 |
| mom_return_10 | Float64 | 10 日动量 |
| score_rank_pct | Float64 | 模型分数的截面排名分位,仅融合文件 |
| mom_rank_pct | Float64 | 动量的截面排名分位,仅融合文件 |
| blend_score | Float64 | 两列各半,仅融合文件 |
写入前检查四件事:主键日期加合约唯一;合约与纯加密排除名单交集为空;`signal` 仍然是 `Array(Float64, 6)`,不能变成 `List`;p5、p0、score 三者自洽。
还有一个容易被忽略的点:行序不能动。
选币时如果排名在边界上并列,稳定排序会按原始行序决定谁进谁出。把信号文件按日期或合约排一次序,持仓就可能变,收益也跟着变。所以所有投影和补列都保留源文件行序,禁止排序。这不是代码风格问题,是结果能不能复现的问题。
图 1:测试段每份 8.4 万行,验证段的模型和融合是 8.6 万行,mom10 验证段是 12.0 万行。mom10 验证段行数多,不是币更多,是编码口径不同。
四、mom10 的测试段和验证段,不能互换
这是这次最容易踩的坑。
mom10 测试段用的是数据集裁剪过的 `mom_return_10`,范围压在正负 3 之间。mom10 验证段用的是 risk table 里未裁剪的 `mom10`。两个文件看起来是同一个信号,其实编码不一样。
不能互换,也不能拿其中一个重算另一个。跨段比较之前必须先看口径。把两段结果直接拼在一起,看起来都是 mom10,实际上衡量的不是同一件事。
模型验证段还有另一层限制。VALID 参与了每日 IC 早停,所以 `model_valid` 只能算半样本内。这次模型 `best_iteration` 是 290,验证段每日 IC 是 0.0373。这个数字不能当成干净样本外,后面做验证期结论时要打折。
为了保证训练和投影没有漂移,notebook 里加了一道 test parity 闸门:重新预测测试段,和已经保存的 `model_test` 逐行比较,最大绝对差必须小于 `1e-6`。这次实际差值是 0.0。
五、一个 notebook:校验、加载、回测、对账
统一入口是 `strategy_catalog_backtest.ipynb`。四个开关控制运行方式:
- `RUN_SEGMENTS=["test"]`:先只跑测试段
- `FORCE_REBUILD_SIGNALS=False`:信号缺了才重建
- `RETRAIN_MODEL=False`:默认不重训,直接用缓存模型
- `ALLOW_MODEL_MISMATCH=False`:模型对不上就中止,不静默继续
流程分六步:
1. 加载 AlphaLab、CRYPTO.LOCAL 成分和纯加密过滤
2. 校验或生成六份信号
3. 动态导入九个策略模块,组装策略目录
4. 每段加载三族信号和 OHLC,逐个调用回测 runner
5. 写出每个策略的 JSON 指标和逐日净值 parquet
6. 生成对账表,实际值、预期值、差值、通过与否放在一起
回测复用 `risk_guard_ablation.run_config`,不新写 runner。它已经包含止损触发日盈亏替换、次日残余清零、手续费保留和指标重算。如果为了这次目录再写一套回测,两套引擎迟早会跑出两套数字。
对账标准是固定的:
- 收益和最大回撤误差不超过 0.01 个百分点
- 夏普误差不超过 0.001
- Calmar 误差不超过 0.01
- 成交数和止损次数精确相等
这次 9/9 全部通过。每个策略的逐日净值都是 457 行,期末权益等于 1000 万乘以 1 加收益率。三个止损策略的止损次数分别是 121、646、652,和策略端记录的止损次数完全一致。
不是差不多,是逐项对上。
六、九个策略的成绩单
把九个策略放在同一张表里,按收益从高到低:
| 策略 | 信号 | 收益 | 最大回撤 | 夏普 | 成交数 | 止损次数 |
|---|---|---:|---:|---:|---:|---:|
| 融合 top5 | 融合 | +172.93% | -18.44% | 2.076 | 7251 | 0 |
| mom10 top5 多头 buf5 | mom10 | +152.67% | -30.13% | 1.577 | 5879 | 0 |
| 模型 buf4 止损35 | 模型 | +151.47% | -31.42% | 1.635 | 4787 | 121 |
| 模型 buf4 | 模型 | +137.55% | -54.80% | 1.368 | 4745 | 0 |
| mom10 top5 | mom10 | +134.22% | -39.03% | 1.385 | 6201 | 0 |
| 模型 buf4 止损10 | 模型 | +130.86% | -16.25% | 1.906 | 4719 | 646 |
| 模型 多头 buf5 | 模型 | +115.08% | -51.89% | 1.174 | 4855 | 0 |
| 模型 多头 buf5 止损10 | 模型 | +114.01% | -14.39% | 1.846 | 4743 | 652 |
| mom10 top20 多头 buf5 | mom10 | +68.98% | -21.81% | 1.563 | 22474 | 0 |
图 2:左边是收益,右边是回撤绝对值,同一个顺序。橙色是带止损的模型策略,灰色是不带止损的模型策略,蓝色是 mom10,紫色是融合。
图 3:九个策略在同一段测试期、同样 1000 万本金下的净值曲线,共用纵轴。标题里的两个数字是总收益和最大回撤。
几个观察:
第一,融合仍然是第一。收益 +172.93%、回撤 -18.44%、夏普 2.076,三项都是九个策略里最好的。Calmar 7.49,也是唯一一个收益、回撤、夏普同时跑赢 mom10 最好变体的配置。只和 mom10 top5 比的话,模型 buf4 止损35 也能三项都赢,但它跑不过 mom10 多头 buffer5 的 +152.67%。
第二,止损能压回撤,但不能免费。两个 stop10 变体把回撤压到 -14.39% 和 -16.25%,夏普做到 1.846 和 1.906,但上一期已经验证过,stop10 对滑点极敏感,2% 滑点下收益几乎归零。stop35 收益 +151.47%、回撤 -31.42%,更稳,适合滑点不确定的场景。
第三,模型基线变体的回撤还在 -52% 到 -55%。buffer 把收益从负的做到 +115% 到 +137%,但没有解决尾部风险。收益改善和风险改善是两件事,不能因为收益变正就忽略回撤。
第四,mom10 top20 的收益最低,只有 +68.98%,成交 22474 次,是九个策略里交易最频繁的。持仓放宽不等于更好,交易成本会吃掉一部分收益。这也是后面必须把成本算进去的原因。
这个目录展示的是取舍,不是只有一个赢家。选哪个,取决于资金规模、滑点水平、回撤容忍度和调仓成本。
七、复现记录:commit、版本、hash
每次运行都会在 notebook 里生成一份复现记录,这次的内容是:
- 运行时间:2026-10-20T09:39:45
- git commit:`261a7147ed6810bd4e7a76397a9149f7353a6470`
- 工作区状态:有未提交改动
- Python 3.13.13,polars 1.41.2,lightgbm 4.6.0,vnpy 4.4.0
- 模型 `best_iteration`:290
- 验证段每日 IC:0.03727
- 测试段 parity 最大绝对差:0.0
六份信号的 SHA256 也全部记录:
| 信号文件 | SHA256 前 12 位 |
|---|---|
| model_test | c8e9e5642a78 |
| model_valid | 77e53a0a794b |
| mom10_test | d59cf2be7a10 |
| mom10_valid | 70e25941c252 |
| blend_mom10_test | 1d5b40457ab2 |
| blend_mom10_valid | c379b7b1bab9 |
工作区状态是有未提交改动,这一点要诚实写出来。它意味着这次结果对应的代码不是干净的 commit,严格来说,别人拿到 commit 号还不一定能完全还原。下次跑之前应该先提交,或者把 diff 一起存下来。复现记录的价值不在于好看,而在于把差异留在可追踪的地方。
下次有人问这个数字怎么来的,不用解释,把运行记录、信号 hash 和 notebook 一起给他。
八、边界和下一期
先把水分挤掉。
九个结果全部是测试期单段,2025 年 7 月到 2026 年 9 月,457 天。参数也是在这段测试期里反复选的,不是干净样本外。9/9 复现只证明代码和信号能复现这个数字,不证明这个数字能复现到未来。
模型验证段是半样本内,因为 VALID 参与了早停。mom10 验证段的币池和模型验证段不一样,跨族结果不能直接比较。资金费、强平、真实滑点、新币和低流动性过滤,这次都还没算。
下一期做三件事:把融合信号接上 buffer 和止损,跑验证期,再做 walk-forward。如果验证期站不住,+172.93% 就只是一个好看的测试期数字,得回来改。
复现不是终点,是起点。先把地基打完,再盖楼。
这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #因子研究 #Alpha策略 #Beta中性 #加密货币
58
·
--
上一期基线还是 -5.5%,这一期我让模型和动量各取一半,做到 +172.93%上一期基线还是 -5.5%,这一期我让模型和动量各取一半,做到 +172.93%
上一期结尾我说,下一集补资金费和滑点。写完那篇之后我先停了一下,因为有一个更基本的问题没解决:模型的每日 IC 是正的,为什么按它选币还是亏。这个问题不解决,补资金费只是在给一个错误的策略算成本。
这一期先回答这个问题。答案不在模型,在选币规则。把规则改对之后,模型和动量各取一半,测试期做到 +172.93% 收益、-18.44% 回撤、夏普 2.076。先别急着高兴,后面会讲这个数字有多少水分。
一、一个矛盾:IC 正,策略亏
上一期全链路重建之后,干净基线是 -5.52% 收益、-91.61% 回撤。但同一版模型在测试集的每日 IC 是 +0.0336,ICIR 5.91。IC 为正,说明预测分数和未来收益的排序是有关系的。策略却亏钱,说明我把分数变成持仓的那一步出了问题。
这不是模型不行,是接口错了。
二、根因:训练用 score,选币用 p5 和 p0
模型是五分类,p5 是未来收益进入最高一档的概率,p0 是进入最低一档的概率。训练和 IC 评估用的是 score = p5 − p0。
但策略做多按 p5 从高到低选,做空按 p0 从高到低选。
问题在于,p5 和 p0 的逐日截面相关高达 +0.82。一个币完全可以同时 p5 很高、p0 也很高。它表达的不是这个币会涨,而是这个币会剧烈波动。按 p5 绝对值选多,选出来的是极端币,不是看涨币。
所以模型在预测方向,策略在选波动。IC 为正和策略亏钱,在这里并不矛盾。
图 1:左边是全部 8.4 万个样本的 p5 和 p0,点云明显贴着对角线;右边是模型分数和动量的排名相关,一个正一个负。
三、score 单独排序,权益穿零
第一反应很直接,既然训练用 score,那选币也按 score 排。多头选 score 最高的 5 个,空头选最低的 5 个。
结果更糟:
- 多空都按 score:-110.67% 收益,-154.83% 回撤
- 只改多头:-75.08% 收益,-114.98% 回撤
- 只改空头:-43.20% 收益,-109.29% 回撤
三组权益都穿零,指标已经失真,实盘就是爆仓。放宽到 top10 稍微好一点,但仍然亏,-18.77% 收益、-53.34% 回撤。给 score 多头加 buffer5,也是 -83.11%,权益穿零。
score 单独排序不是解药。score 和 mom10 的截面排名相关是 -0.41,它本质上偏反转,在测试期这种动量占优的行情里,单独用就是逆势。
四、组合构建:topN 没用,buffer 有用
既然选币方向不是唯一问题,就把组合构建也扫一遍。
放宽持仓数没有用。模型 top10 是 -27.85% 收益、-54.89% 回撤,top20 是 -4.48% 收益、-38.06% 回撤。放宽只是稀释,不能把负 alpha 变正。
排名缓冲区有效。buffer4 是 +137.55% 收益、-54.80% 回撤、夏普 1.368。buffer3 到 buffer15 是一段宽正平台,buffer3 +72.36%,buffer5 +119.82%,buffer6 +103.74%,buffer7 +94.12%,buffer8 +99.20%,buffer10 +86.25%,buffer15 +86.38%。
原因在方向拆解里。模型 top5 的多头腿是 -87.7 万,空头腿是 +32.5 万,多头在慢性失血。缓冲区让已经持有的赢家多拿一段,不因为排名在边界附近来回换手。对称 buffer5 的多头腿做到 +1240.7 万。
但缓冲区只能用在多头。空头单边 buffer5 的权益穿零,2026 年 3 月最低 -70.9 万,实盘已经爆仓。空头端不能靠缓冲区。
安慰剂测试也做了。打乱信号之后,top5 是 -33.25%,buffer4 是 -47.65%,说明缓冲区不是从噪声里造 alpha。但随机分数也能跑出 +33.41% 和 +45.79%,所以单期正收益的方差很大,不能看到一个好看的数字就下结论。
五、泼一盆冷水:mom10 单因子跑赢模型
在继续调模型之前,先用同口径跑了一个单因子基准,mom10,也就是过去 10 个交易日的动量。
mom10 top5 是 +134.22% 收益、-39.03% 回撤、夏普 1.385。再加多头 buffer5 是 +152.67% 收益、-30.13% 回撤、夏普 1.577。
模型基线是 -5.52%。模型 p5 和 mom10 的截面排名相关只有 +0.31,top5 日重合 23.3%。
也就是说,模型和动量有一部分重合,但重合不多,单独用还不如动量。模型的正 IC 可能主要来自中间档,极端多空两端没有可交易的 alpha。模型还没有证明自己有增量价值。
把前面这些配置放到一张收益回撤图上,位置很清楚。越往左上越好:score 多空在右下角,融合在左上角。
图 2:每个点是一个配置,横轴是最大回撤,纵轴是总收益。score 多空权益穿零,指标已经失真。
六、融合:两个几乎相反的信号各取一半
真正有意思的是两者的关系。score 和 mom10 的截面排名相关是 -0.41,一个偏反转,一个偏动量,几乎在打架。
既然单独用都不够好,那就各取一半。每天把 score 的截面排名分位和 mom10 的截面排名分位各乘 0.5,相加得到融合分,多头选融合分最高的 5 个,空头选最低的 5 个。其余口径不变。
结果:
- 收益 +172.93%
- 最大回撤 -18.44%
- 夏普 2.076
- Calmar 7.49
- 五个季度全部为正,分别是 +53.9 万、+373.4 万、+535.8 万、+97.2 万、+669.0 万
多空腿拆开看,融合多头 +704.0 万,空头 +1025.3 万。mom10 自己的多头腿是 -184.9 万,融合把这条亏损的多头腿翻正了,空头端仍然靠动量。
融合多头和 mom10 多头的持仓重合只有 7.0%,和 score 多头重合 19.3%。融合空头和 mom10 空头重合 25.2%,和 score 空头只重合 5.8%。它不是动量策略的变体,是把两条不同的腿拼在一起。
收益、回撤、夏普三项都跑赢 mom10,这是目前唯一做到的配置。
图 3:左边是融合的季度净盈亏,五个季度全部为正;右边是三条策略的多空腿对比,融合把 mom10 亏损的多头腿翻正了。
图 4:同一段测试期,1000 万本金。融合的终值是 2729 万,回撤明显比模型 buffer4 和 mom10 更浅。
七、加上 buffer 和止损
在模型信号上,buffer 和止损的组合也跑了一轮。
- buffer4 加 stop10:+130.86% 收益、-16.25% 回撤、夏普 1.906、Calmar 6.43,646 次止损
- buffer4 加 stop35:+151.47% 收益、-31.42% 回撤、夏普 1.635、Calmar 3.85,121 次止损
止损对滑点很敏感。buffer4 加 stop10 在 1% 滑点下是 +66.10% 收益、-22.76% 回撤,2% 滑点只剩 +1.35% 收益、-48.76% 回撤。buffer4 加 stop35 在 2% 滑点下还有 +126.40% 收益、-37.00% 回撤。
所以低滑点用 stop10,滑点不确定用 stop35。
还有一个反直觉的点。止损触发日多数是亏钱的,收益改善主要来自触发后的换仓路径,不是当天少亏。这一点和上一期的结论一致,止损的价值在于截断之后的路径,不在触发那一刻的账。
注意,这一层是在模型信号上做的,不是融合信号。融合加 buffer、止损还没跑。
图 5:stop10 的收益从 131% 掉到 1%,stop35 从 151% 只掉到 126%。触发次数越多,滑点侵蚀越重。
八、边界和下一期
先把水分挤掉。
全部是测试期单段结果,2025 年 7 月到 2026 年 9 月,457 天。参数也是在这段测试期里反复选的,不是干净样本外。融合的 50/50 权重和 mom10 窗口没做敏感性。融合还没和 buffer、止损组合。重复止损没量化。新币和低流动性过滤没做。资金费、强平、真实滑点都没算。
融合的收益也很集中,前 10 个交易日贡献 65.7% 的净盈亏。这个集中度意味着,换一段样本,结果可能差很多。
下一集把融合信号接上 buffer 和止损,跑验证期和 walk-forward。验证期站不住,+172.93% 就只是一个好看的测试期数字。
如果你也在做 $BTC、$ETH 这类永续策略,可以先检查一件事:训练用的分数和选币用的分数是不是同一个。如果不是,先别调参,先把接口对齐。
这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #因子研究 #Alpha策略 #Beta中性
上一期基线还是 -5.5%,这一期我让模型和动量各取一半,做到 +172.93%
上一期基线还是 -5.5%,这一期我让模型和动量各取一半,做到 +172.93%
上一期结尾我说,下一集补资金费和滑点。写完那篇之后我先停了一下,因为有一个更基本的问题没解决:模型的每日 IC 是正的,为什么按它选币还是亏。这个问题不解决,补资金费只是在给一个错误的策略算成本。
这一期先回答这个问题。答案不在模型,在选币规则。把规则改对之后,模型和动量各取一半,测试期做到 +172.93% 收益、-18.44% 回撤、夏普 2.076。先别急着高兴,后面会讲这个数字有多少水分。
一、一个矛盾:IC 正,策略亏
上一期全链路重建之后,干净基线是 -5.52% 收益、-91.61% 回撤。但同一版模型在测试集的每日 IC 是 +0.0336,ICIR 5.91。IC 为正,说明预测分数和未来收益的排序是有关系的。策略却亏钱,说明我把分数变成持仓的那一步出了问题。
这不是模型不行,是接口错了。
二、根因:训练用 score,选币用 p5 和 p0
模型是五分类,p5 是未来收益进入最高一档的概率,p0 是进入最低一档的概率。训练和 IC 评估用的是 score = p5 − p0。
但策略做多按 p5 从高到低选,做空按 p0 从高到低选。
问题在于,p5 和 p0 的逐日截面相关高达 +0.82。一个币完全可以同时 p5 很高、p0 也很高。它表达的不是这个币会涨,而是这个币会剧烈波动。按 p5 绝对值选多,选出来的是极端币,不是看涨币。
所以模型在预测方向,策略在选波动。IC 为正和策略亏钱,在这里并不矛盾。
图 1:左边是全部 8.4 万个样本的 p5 和 p0,点云明显贴着对角线;右边是模型分数和动量的排名相关,一个正一个负。
三、score 单独排序,权益穿零
第一反应很直接,既然训练用 score,那选币也按 score 排。多头选 score 最高的 5 个,空头选最低的 5 个。
结果更糟:
- 多空都按 score:-110.67% 收益,-154.83% 回撤
- 只改多头:-75.08% 收益,-114.98% 回撤
- 只改空头:-43.20% 收益,-109.29% 回撤
三组权益都穿零,指标已经失真,实盘就是爆仓。放宽到 top10 稍微好一点,但仍然亏,-18.77% 收益、-53.34% 回撤。给 score 多头加 buffer5,也是 -83.11%,权益穿零。
score 单独排序不是解药。score 和 mom10 的截面排名相关是 -0.41,它本质上偏反转,在测试期这种动量占优的行情里,单独用就是逆势。
四、组合构建:topN 没用,buffer 有用
既然选币方向不是唯一问题,就把组合构建也扫一遍。
放宽持仓数没有用。模型 top10 是 -27.85% 收益、-54.89% 回撤,top20 是 -4.48% 收益、-38.06% 回撤。放宽只是稀释,不能把负 alpha 变正。
排名缓冲区有效。buffer4 是 +137.55% 收益、-54.80% 回撤、夏普 1.368。buffer3 到 buffer15 是一段宽正平台,buffer3 +72.36%,buffer5 +119.82%,buffer6 +103.74%,buffer7 +94.12%,buffer8 +99.20%,buffer10 +86.25%,buffer15 +86.38%。
原因在方向拆解里。模型 top5 的多头腿是 -87.7 万,空头腿是 +32.5 万,多头在慢性失血。缓冲区让已经持有的赢家多拿一段,不因为排名在边界附近来回换手。对称 buffer5 的多头腿做到 +1240.7 万。
但缓冲区只能用在多头。空头单边 buffer5 的权益穿零,2026 年 3 月最低 -70.9 万,实盘已经爆仓。空头端不能靠缓冲区。
安慰剂测试也做了。打乱信号之后,top5 是 -33.25%,buffer4 是 -47.65%,说明缓冲区不是从噪声里造 alpha。但随机分数也能跑出 +33.41% 和 +45.79%,所以单期正收益的方差很大,不能看到一个好看的数字就下结论。
五、泼一盆冷水:mom10 单因子跑赢模型
在继续调模型之前,先用同口径跑了一个单因子基准,mom10,也就是过去 10 个交易日的动量。
mom10 top5 是 +134.22% 收益、-39.03% 回撤、夏普 1.385。再加多头 buffer5 是 +152.67% 收益、-30.13% 回撤、夏普 1.577。
模型基线是 -5.52%。模型 p5 和 mom10 的截面排名相关只有 +0.31,top5 日重合 23.3%。
也就是说,模型和动量有一部分重合,但重合不多,单独用还不如动量。模型的正 IC 可能主要来自中间档,极端多空两端没有可交易的 alpha。模型还没有证明自己有增量价值。
把前面这些配置放到一张收益回撤图上,位置很清楚。越往左上越好:score 多空在右下角,融合在左上角。
图 2:每个点是一个配置,横轴是最大回撤,纵轴是总收益。score 多空权益穿零,指标已经失真。
六、融合:两个几乎相反的信号各取一半
真正有意思的是两者的关系。score 和 mom10 的截面排名相关是 -0.41,一个偏反转,一个偏动量,几乎在打架。
既然单独用都不够好,那就各取一半。每天把 score 的截面排名分位和 mom10 的截面排名分位各乘 0.5,相加得到融合分,多头选融合分最高的 5 个,空头选最低的 5 个。其余口径不变。
结果:
- 收益 +172.93%
- 最大回撤 -18.44%
- 夏普 2.076
- Calmar 7.49
- 五个季度全部为正,分别是 +53.9 万、+373.4 万、+535.8 万、+97.2 万、+669.0 万
多空腿拆开看,融合多头 +704.0 万,空头 +1025.3 万。mom10 自己的多头腿是 -184.9 万,融合把这条亏损的多头腿翻正了,空头端仍然靠动量。
融合多头和 mom10 多头的持仓重合只有 7.0%,和 score 多头重合 19.3%。融合空头和 mom10 空头重合 25.2%,和 score 空头只重合 5.8%。它不是动量策略的变体,是把两条不同的腿拼在一起。
收益、回撤、夏普三项都跑赢 mom10,这是目前唯一做到的配置。
图 3:左边是融合的季度净盈亏,五个季度全部为正;右边是三条策略的多空腿对比,融合把 mom10 亏损的多头腿翻正了。
图 4:同一段测试期,1000 万本金。融合的终值是 2729 万,回撤明显比模型 buffer4 和 mom10 更浅。
七、加上 buffer 和止损
在模型信号上,buffer 和止损的组合也跑了一轮。
- buffer4 加 stop10:+130.86% 收益、-16.25% 回撤、夏普 1.906、Calmar 6.43,646 次止损
- buffer4 加 stop35:+151.47% 收益、-31.42% 回撤、夏普 1.635、Calmar 3.85,121 次止损
止损对滑点很敏感。buffer4 加 stop10 在 1% 滑点下是 +66.10% 收益、-22.76% 回撤,2% 滑点只剩 +1.35% 收益、-48.76% 回撤。buffer4 加 stop35 在 2% 滑点下还有 +126.40% 收益、-37.00% 回撤。
所以低滑点用 stop10,滑点不确定用 stop35。
还有一个反直觉的点。止损触发日多数是亏钱的,收益改善主要来自触发后的换仓路径,不是当天少亏。这一点和上一期的结论一致,止损的价值在于截断之后的路径,不在触发那一刻的账。
注意,这一层是在模型信号上做的,不是融合信号。融合加 buffer、止损还没跑。
图 5:stop10 的收益从 131% 掉到 1%,stop35 从 151% 只掉到 126%。触发次数越多,滑点侵蚀越重。
八、边界和下一期
先把水分挤掉。
全部是测试期单段结果,2025 年 7 月到 2026 年 9 月,457 天。参数也是在这段测试期里反复选的,不是干净样本外。融合的 50/50 权重和 mom10 窗口没做敏感性。融合还没和 buffer、止损组合。重复止损没量化。新币和低流动性过滤没做。资金费、强平、真实滑点都没算。
融合的收益也很集中,前 10 个交易日贡献 65.7% 的净盈亏。这个集中度意味着,换一段样本,结果可能差很多。
下一集把融合信号接上 buffer 和止损,跑验证期和 walk-forward。验证期站不住,+172.93% 就只是一个好看的测试期数字。
如果你也在做 $BTC、$ETH 这类永续策略,可以先检查一件事:训练用的分数和选币用的分数是不是同一个。如果不是,先别调参,先把接口对齐。
这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #因子研究 #Alpha策略 #Beta中性
上一期结尾我说,下一集补资金费和滑点。写完那篇之后我先停了一下,因为有一个更基本的问题没解决:模型的每日 IC 是正的,为什么按它选币还是亏。这个问题不解决,补资金费只是在给一个错误的策略算成本。
这一期先回答这个问题。答案不在模型,在选币规则。把规则改对之后,模型和动量各取一半,测试期做到 +172.93% 收益、-18.44% 回撤、夏普 2.076。先别急着高兴,后面会讲这个数字有多少水分。
一、一个矛盾:IC 正,策略亏
上一期全链路重建之后,干净基线是 -5.52% 收益、-91.61% 回撤。但同一版模型在测试集的每日 IC 是 +0.0336,ICIR 5.91。IC 为正,说明预测分数和未来收益的排序是有关系的。策略却亏钱,说明我把分数变成持仓的那一步出了问题。
这不是模型不行,是接口错了。
二、根因:训练用 score,选币用 p5 和 p0
模型是五分类,p5 是未来收益进入最高一档的概率,p0 是进入最低一档的概率。训练和 IC 评估用的是 score = p5 − p0。
但策略做多按 p5 从高到低选,做空按 p0 从高到低选。
问题在于,p5 和 p0 的逐日截面相关高达 +0.82。一个币完全可以同时 p5 很高、p0 也很高。它表达的不是这个币会涨,而是这个币会剧烈波动。按 p5 绝对值选多,选出来的是极端币,不是看涨币。
所以模型在预测方向,策略在选波动。IC 为正和策略亏钱,在这里并不矛盾。
图 1:左边是全部 8.4 万个样本的 p5 和 p0,点云明显贴着对角线;右边是模型分数和动量的排名相关,一个正一个负。
三、score 单独排序,权益穿零
第一反应很直接,既然训练用 score,那选币也按 score 排。多头选 score 最高的 5 个,空头选最低的 5 个。
结果更糟:
- 多空都按 score:-110.67% 收益,-154.83% 回撤
- 只改多头:-75.08% 收益,-114.98% 回撤
- 只改空头:-43.20% 收益,-109.29% 回撤
三组权益都穿零,指标已经失真,实盘就是爆仓。放宽到 top10 稍微好一点,但仍然亏,-18.77% 收益、-53.34% 回撤。给 score 多头加 buffer5,也是 -83.11%,权益穿零。
score 单独排序不是解药。score 和 mom10 的截面排名相关是 -0.41,它本质上偏反转,在测试期这种动量占优的行情里,单独用就是逆势。
四、组合构建:topN 没用,buffer 有用
既然选币方向不是唯一问题,就把组合构建也扫一遍。
放宽持仓数没有用。模型 top10 是 -27.85% 收益、-54.89% 回撤,top20 是 -4.48% 收益、-38.06% 回撤。放宽只是稀释,不能把负 alpha 变正。
排名缓冲区有效。buffer4 是 +137.55% 收益、-54.80% 回撤、夏普 1.368。buffer3 到 buffer15 是一段宽正平台,buffer3 +72.36%,buffer5 +119.82%,buffer6 +103.74%,buffer7 +94.12%,buffer8 +99.20%,buffer10 +86.25%,buffer15 +86.38%。
原因在方向拆解里。模型 top5 的多头腿是 -87.7 万,空头腿是 +32.5 万,多头在慢性失血。缓冲区让已经持有的赢家多拿一段,不因为排名在边界附近来回换手。对称 buffer5 的多头腿做到 +1240.7 万。
但缓冲区只能用在多头。空头单边 buffer5 的权益穿零,2026 年 3 月最低 -70.9 万,实盘已经爆仓。空头端不能靠缓冲区。
安慰剂测试也做了。打乱信号之后,top5 是 -33.25%,buffer4 是 -47.65%,说明缓冲区不是从噪声里造 alpha。但随机分数也能跑出 +33.41% 和 +45.79%,所以单期正收益的方差很大,不能看到一个好看的数字就下结论。
五、泼一盆冷水:mom10 单因子跑赢模型
在继续调模型之前,先用同口径跑了一个单因子基准,mom10,也就是过去 10 个交易日的动量。
mom10 top5 是 +134.22% 收益、-39.03% 回撤、夏普 1.385。再加多头 buffer5 是 +152.67% 收益、-30.13% 回撤、夏普 1.577。
模型基线是 -5.52%。模型 p5 和 mom10 的截面排名相关只有 +0.31,top5 日重合 23.3%。
也就是说,模型和动量有一部分重合,但重合不多,单独用还不如动量。模型的正 IC 可能主要来自中间档,极端多空两端没有可交易的 alpha。模型还没有证明自己有增量价值。
把前面这些配置放到一张收益回撤图上,位置很清楚。越往左上越好:score 多空在右下角,融合在左上角。
图 2:每个点是一个配置,横轴是最大回撤,纵轴是总收益。score 多空权益穿零,指标已经失真。
六、融合:两个几乎相反的信号各取一半
真正有意思的是两者的关系。score 和 mom10 的截面排名相关是 -0.41,一个偏反转,一个偏动量,几乎在打架。
既然单独用都不够好,那就各取一半。每天把 score 的截面排名分位和 mom10 的截面排名分位各乘 0.5,相加得到融合分,多头选融合分最高的 5 个,空头选最低的 5 个。其余口径不变。
结果:
- 收益 +172.93%
- 最大回撤 -18.44%
- 夏普 2.076
- Calmar 7.49
- 五个季度全部为正,分别是 +53.9 万、+373.4 万、+535.8 万、+97.2 万、+669.0 万
多空腿拆开看,融合多头 +704.0 万,空头 +1025.3 万。mom10 自己的多头腿是 -184.9 万,融合把这条亏损的多头腿翻正了,空头端仍然靠动量。
融合多头和 mom10 多头的持仓重合只有 7.0%,和 score 多头重合 19.3%。融合空头和 mom10 空头重合 25.2%,和 score 空头只重合 5.8%。它不是动量策略的变体,是把两条不同的腿拼在一起。
收益、回撤、夏普三项都跑赢 mom10,这是目前唯一做到的配置。
图 3:左边是融合的季度净盈亏,五个季度全部为正;右边是三条策略的多空腿对比,融合把 mom10 亏损的多头腿翻正了。
图 4:同一段测试期,1000 万本金。融合的终值是 2729 万,回撤明显比模型 buffer4 和 mom10 更浅。
七、加上 buffer 和止损
在模型信号上,buffer 和止损的组合也跑了一轮。
- buffer4 加 stop10:+130.86% 收益、-16.25% 回撤、夏普 1.906、Calmar 6.43,646 次止损
- buffer4 加 stop35:+151.47% 收益、-31.42% 回撤、夏普 1.635、Calmar 3.85,121 次止损
止损对滑点很敏感。buffer4 加 stop10 在 1% 滑点下是 +66.10% 收益、-22.76% 回撤,2% 滑点只剩 +1.35% 收益、-48.76% 回撤。buffer4 加 stop35 在 2% 滑点下还有 +126.40% 收益、-37.00% 回撤。
所以低滑点用 stop10,滑点不确定用 stop35。
还有一个反直觉的点。止损触发日多数是亏钱的,收益改善主要来自触发后的换仓路径,不是当天少亏。这一点和上一期的结论一致,止损的价值在于截断之后的路径,不在触发那一刻的账。
注意,这一层是在模型信号上做的,不是融合信号。融合加 buffer、止损还没跑。
图 5:stop10 的收益从 131% 掉到 1%,stop35 从 151% 只掉到 126%。触发次数越多,滑点侵蚀越重。
八、边界和下一期
先把水分挤掉。
全部是测试期单段结果,2025 年 7 月到 2026 年 9 月,457 天。参数也是在这段测试期里反复选的,不是干净样本外。融合的 50/50 权重和 mom10 窗口没做敏感性。融合还没和 buffer、止损组合。重复止损没量化。新币和低流动性过滤没做。资金费、强平、真实滑点都没算。
融合的收益也很集中,前 10 个交易日贡献 65.7% 的净盈亏。这个集中度意味着,换一段样本,结果可能差很多。
下一集把融合信号接上 buffer 和止损,跑验证期和 walk-forward。验证期站不住,+172.93% 就只是一个好看的测试期数字。
如果你也在做 $BTC、$ETH 这类永续策略,可以先检查一件事:训练用的分数和选币用的分数是不是同一个。如果不是,先别调参,先把接口对齐。
这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #因子研究 #Alpha策略 #Beta中性
172
·
--
上一期我说 25% 是止损甜点,这一期要收回:加密池里混着 AAPL、TSLA 和黄金上一期我写了一版加密永续风控的复盘。一个收益 62% 的策略,最大回撤 73%,加了一条 25% 的单币止损后,收益做到 109%,回撤压到 27%。当时的结论是,25% 是止损宽度的甜点,少即是多。
发完之后我没有马上写下一期,而是回头查了一件事,这些合约到底是什么。结果发现,币安的加密永续池里混着代币化美股、ETF、黄金、原油和稳定币。AAPL、TSLA、NVDA、SPY、XAU、USDC 都在里面,7×24 交易,日线结构和永续没有任何区别。
这一期要把上一期的结论收回。把池子和截面全部洗干净之后,同一套流程、同一套参数,模型在干净数据上重新训练,基线是 -5.52% 收益、-91.61% 回撤。25% 的甜点不成立了。
一、上一期我们停在哪里
先给没看过上一期的朋友补一下背景。
策略做币安 USDT-M 永续,日线,多空各取 5 个币等权,每天调仓,手续费按 5bp 算,资金费成本还没进回测。1000 万模拟资金,2025 年 7 月到 2026 年 9 月,457 个交易日。
基线是 62% 收益、73% 回撤。把每天每个币的盈亏拉出来归因,回撤不是慢慢磨出来的,是九笔单币单日突袭,八笔加起来亏掉 873 万,比整段利润还多。
加了一条 25% 的单币止损后,收益 109%,回撤 27%,夏普从 0.88 到 1.50,Calmar 从 0.68 到 3.2,一共触发 192 次。1% 和 2% 滑点下收益还有 89.6% 和 69.9%。15% 触发太频繁,383 次,1% 滑点下只剩 66.9%。30% 和 35% 太松,回撤反弹到 34% 和 40%。所以我当时说,25% 是甜点。
这一期要在这个结论上打一个问号。如果池子本身不干净,止损宽度的排序还有意义吗。
二、池子里混进了什么
币安 895 个日线合约里,217 个不是加密货币。
包括代币化美股 AAPL、TSLA、NVDA,代币化 ETF SPY、QQQ、SOXL,还有黄金 XAU、原油 CL、外汇、pre-IPO 股权和稳定币 USDC。它们和永续合约共用一套撮合,7×24 交易,日线结构完全一样。建池脚本只按成交额筛选,没有做资产类型过滤,所以根本分不出来。
其中 73 个真的进了候选池,31 个被选进过持仓,占了 295 个持仓日。总共 3208 个持仓日,比例 9.2%。
这些合约不是利润来源,合计还亏了 29.6 万。但它们占了近一成槽位,改变了选币路径、止损触发和冷静期。参数排序是路径依赖的,路径被改写,25% 这个甜点就可能是假的。
三、第一轮清洗,我差点就发了
第一轮的做法很直接,只在信号层按行删掉这些合约,标的从 734 个降到 661 个,重跑。
结果是基线 +62.86% / -68.32%,止损 15% +96.31% / -25.43%,止损 35% +120.89% / -36.31%。
25% 不再是甜点,15% 和 35% 两端都更好。我写好了一版发布稿,准备说池子洗干净后结论变了。
但发之前我又逐日核对了一遍,发现不对。
四、为什么只删行不够
非加密合约不只在 2026 年的测试段:
- TRAIN 段有 USDC,50 个符号日
- VALID 段有 PAXG 77 个符号日,加 USDC 31 个,共 108 个
- TEST 段有 73 个非加密符号,7847 个符号日
TRAIN 加 VALID 一共 158 个符号日,看起来像噪声。但我的标签是每日截面分位,特征也做了每日截面 robust 归一化,用的是当天全市场的中位数和 MAD。
多一个低波动的稳定币或者黄金合约,当天的中位数和 MAD 就变了,所有币的标签分位和归一化后的特征值也跟着变。一个合约就能把当天所有币的分数重排。
所以污染的不是那 158 行,是这些符号日里所有币的截面。只按行删数据,行删干净了,数值还是脏的。等于把用混合截面算出来的数,留在了干净的行上。
这也解释了为什么第一轮的 +62.9% 不能信。它不是策略真变好了,而是数据集里还留着脏数值。
五、全链路重建做了什么
这次没有只改信号层,而是从原始数据一路重建。
清掉的层包括:
- daily 895 个 parquet 降到 678
- contract.json 895 个键降到 678
- component/CRYPTO.LOCAL 从 735 个符号降到 662 个,2473 个交易日
- parsed klines 从 610916 行降到 586158 行
- parsed funding 和 funding_df 从 625566 行降到 602221 行
- signal 从 92235 行、582 个符号降到 84388 行、509 个符号
- risk table 从 610916 行降到 586158 行
- symbols 从 895 降到 678,pool_union 从 735 降到 662
- 数据集各表只剩 661 个纯加密符号
然后重算 r/σ 标签,重置 learn_df 和 infer_df,重跑 process_replace_inf、process_fill_na、process_cs_norm,最后原子替换 pickle。只删行不重算截面,等于没洗。
重训后的模型:
- 训练集 191138 行
- 验证集 85954 行
- 测试集 84388 行
- 661 个纯加密符号
- 早停 290 轮
- 验证集每日 IC +0.0373
- 测试集每日 IC +0.0336,ICIR +5.91
干净口径的回测:
- 基线 -5.52% / -91.61%
- 止损 10% +37.84% / -24.10%
- 止损 35% +36.12% / -47.38%
同一套流程,同一套参数,只换了数据,收益从 +62.9% 变成 -5.5%。
六、这一期推翻了上一期的什么
上一期的 62% 到 109%、回撤 73% 到 27%、25% 是止损甜点、192 次触发、滑点测试的结论,全部作废。上一期那篇长文也一起作废。
这不是模型突然变差了,是之前的数据不干净。上一期看到的是混合池的回测,这一期看到的是纯加密池加干净截面的回测。两版差了一位数,差的不是策略,是数据。
参数排序对交易路径极其敏感。数据口径一变,25% 的甜点直接消失。所以不要在一个脏口径上反复调参,调出来的甜点可能只是路径依赖。
这也是这个系列第一次自己推翻自己。上一期以为的答案,这一期只是中间站。把每一次打脸公开记录下来,比守住一个漂亮数字更有用。
七、三条教训
第一,做加密策略,先检查池子里有没有代币化股票。它们和永续合约长得一样,7×24 交易,日线结构也一样。只看成交额和代码后缀,很容易漏。
第二,只要 pipeline 里有截面归一化或者截面分位标签,按行删数据不够。必须重算标签、重做归一化、重建整个截面。一个脏合约可以通过中位数和 MAD 影响当天所有币。
第三,洗干净后的数字再丑也要报。+62.9% 看起来像能力,其实只是池子没洗干净。把 -5.5% 说出来,才知道下一步该修什么。
还有一条附带的,不要在脏数据上做参数选择。参数曲面不平滑,脏口径上的甜点,换个池子就没了。
八、边界和下一期
以上全部是回测,不是实盘业绩。资金费成本还没算,强平规则没建模,日线看不到盘中路径,滑点也需要实盘校准。457 天只有一段测试期,而且参数是在这段测试期里反复选的,不是干净样本外。
下一期我会补资金费成本、实盘滑点校准和 walk-forward,再决定止损参数要不要保留。如果你也在做 $BTC、$ETH 这类永续合约策略,先花十分钟检查一下池子里有没有 AAPL、TSLA、XAU 和 USDC,可能比继续调参更值。
这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #风险管理 #加密货币 #回测 #数据质量
上一期我说 25% 是止损甜点,这一期要收回:加密池里混着 AAPL、TSLA 和黄金
上一期我写了一版加密永续风控的复盘。一个收益 62% 的策略,最大回撤 73%,加了一条 25% 的单币止损后,收益做到 109%,回撤压到 27%。当时的结论是,25% 是止损宽度的甜点,少即是多。
发完之后我没有马上写下一期,而是回头查了一件事,这些合约到底是什么。结果发现,币安的加密永续池里混着代币化美股、ETF、黄金、原油和稳定币。AAPL、TSLA、NVDA、SPY、XAU、USDC 都在里面,7×24 交易,日线结构和永续没有任何区别。
这一期要把上一期的结论收回。把池子和截面全部洗干净之后,同一套流程、同一套参数,模型在干净数据上重新训练,基线是 -5.52% 收益、-91.61% 回撤。25% 的甜点不成立了。
一、上一期我们停在哪里
先给没看过上一期的朋友补一下背景。
策略做币安 USDT-M 永续,日线,多空各取 5 个币等权,每天调仓,手续费按 5bp 算,资金费成本还没进回测。1000 万模拟资金,2025 年 7 月到 2026 年 9 月,457 个交易日。
基线是 62% 收益、73% 回撤。把每天每个币的盈亏拉出来归因,回撤不是慢慢磨出来的,是九笔单币单日突袭,八笔加起来亏掉 873 万,比整段利润还多。
加了一条 25% 的单币止损后,收益 109%,回撤 27%,夏普从 0.88 到 1.50,Calmar 从 0.68 到 3.2,一共触发 192 次。1% 和 2% 滑点下收益还有 89.6% 和 69.9%。15% 触发太频繁,383 次,1% 滑点下只剩 66.9%。30% 和 35% 太松,回撤反弹到 34% 和 40%。所以我当时说,25% 是甜点。
这一期要在这个结论上打一个问号。如果池子本身不干净,止损宽度的排序还有意义吗。
二、池子里混进了什么
币安 895 个日线合约里,217 个不是加密货币。
包括代币化美股 AAPL、TSLA、NVDA,代币化 ETF SPY、QQQ、SOXL,还有黄金 XAU、原油 CL、外汇、pre-IPO 股权和稳定币 USDC。它们和永续合约共用一套撮合,7×24 交易,日线结构完全一样。建池脚本只按成交额筛选,没有做资产类型过滤,所以根本分不出来。
其中 73 个真的进了候选池,31 个被选进过持仓,占了 295 个持仓日。总共 3208 个持仓日,比例 9.2%。
这些合约不是利润来源,合计还亏了 29.6 万。但它们占了近一成槽位,改变了选币路径、止损触发和冷静期。参数排序是路径依赖的,路径被改写,25% 这个甜点就可能是假的。
三、第一轮清洗,我差点就发了
第一轮的做法很直接,只在信号层按行删掉这些合约,标的从 734 个降到 661 个,重跑。
结果是基线 +62.86% / -68.32%,止损 15% +96.31% / -25.43%,止损 35% +120.89% / -36.31%。
25% 不再是甜点,15% 和 35% 两端都更好。我写好了一版发布稿,准备说池子洗干净后结论变了。
但发之前我又逐日核对了一遍,发现不对。
四、为什么只删行不够
非加密合约不只在 2026 年的测试段:
- TRAIN 段有 USDC,50 个符号日
- VALID 段有 PAXG 77 个符号日,加 USDC 31 个,共 108 个
- TEST 段有 73 个非加密符号,7847 个符号日
TRAIN 加 VALID 一共 158 个符号日,看起来像噪声。但我的标签是每日截面分位,特征也做了每日截面 robust 归一化,用的是当天全市场的中位数和 MAD。
多一个低波动的稳定币或者黄金合约,当天的中位数和 MAD 就变了,所有币的标签分位和归一化后的特征值也跟着变。一个合约就能把当天所有币的分数重排。
所以污染的不是那 158 行,是这些符号日里所有币的截面。只按行删数据,行删干净了,数值还是脏的。等于把用混合截面算出来的数,留在了干净的行上。
这也解释了为什么第一轮的 +62.9% 不能信。它不是策略真变好了,而是数据集里还留着脏数值。
五、全链路重建做了什么
这次没有只改信号层,而是从原始数据一路重建。
清掉的层包括:
- daily 895 个 parquet 降到 678
- contract.json 895 个键降到 678
- component/CRYPTO.LOCAL 从 735 个符号降到 662 个,2473 个交易日
- parsed klines 从 610916 行降到 586158 行
- parsed funding 和 funding_df 从 625566 行降到 602221 行
- signal 从 92235 行、582 个符号降到 84388 行、509 个符号
- risk table 从 610916 行降到 586158 行
- symbols 从 895 降到 678,pool_union 从 735 降到 662
- 数据集各表只剩 661 个纯加密符号
然后重算 r/σ 标签,重置 learn_df 和 infer_df,重跑 process_replace_inf、process_fill_na、process_cs_norm,最后原子替换 pickle。只删行不重算截面,等于没洗。
重训后的模型:
- 训练集 191138 行
- 验证集 85954 行
- 测试集 84388 行
- 661 个纯加密符号
- 早停 290 轮
- 验证集每日 IC +0.0373
- 测试集每日 IC +0.0336,ICIR +5.91
干净口径的回测:
- 基线 -5.52% / -91.61%
- 止损 10% +37.84% / -24.10%
- 止损 35% +36.12% / -47.38%
同一套流程,同一套参数,只换了数据,收益从 +62.9% 变成 -5.5%。
六、这一期推翻了上一期的什么
上一期的 62% 到 109%、回撤 73% 到 27%、25% 是止损甜点、192 次触发、滑点测试的结论,全部作废。上一期那篇长文也一起作废。
这不是模型突然变差了,是之前的数据不干净。上一期看到的是混合池的回测,这一期看到的是纯加密池加干净截面的回测。两版差了一位数,差的不是策略,是数据。
参数排序对交易路径极其敏感。数据口径一变,25% 的甜点直接消失。所以不要在一个脏口径上反复调参,调出来的甜点可能只是路径依赖。
这也是这个系列第一次自己推翻自己。上一期以为的答案,这一期只是中间站。把每一次打脸公开记录下来,比守住一个漂亮数字更有用。
七、三条教训
第一,做加密策略,先检查池子里有没有代币化股票。它们和永续合约长得一样,7×24 交易,日线结构也一样。只看成交额和代码后缀,很容易漏。
第二,只要 pipeline 里有截面归一化或者截面分位标签,按行删数据不够。必须重算标签、重做归一化、重建整个截面。一个脏合约可以通过中位数和 MAD 影响当天所有币。
第三,洗干净后的数字再丑也要报。+62.9% 看起来像能力,其实只是池子没洗干净。把 -5.5% 说出来,才知道下一步该修什么。
还有一条附带的,不要在脏数据上做参数选择。参数曲面不平滑,脏口径上的甜点,换个池子就没了。
八、边界和下一期
以上全部是回测,不是实盘业绩。资金费成本还没算,强平规则没建模,日线看不到盘中路径,滑点也需要实盘校准。457 天只有一段测试期,而且参数是在这段测试期里反复选的,不是干净样本外。
下一期我会补资金费成本、实盘滑点校准和 walk-forward,再决定止损参数要不要保留。如果你也在做 $BTC、$ETH 这类永续合约策略,先花十分钟检查一下池子里有没有 AAPL、TSLA、XAU 和 USDC,可能比继续调参更值。
这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #风险管理 #加密货币 #回测 #数据质量
发完之后我没有马上写下一期,而是回头查了一件事,这些合约到底是什么。结果发现,币安的加密永续池里混着代币化美股、ETF、黄金、原油和稳定币。AAPL、TSLA、NVDA、SPY、XAU、USDC 都在里面,7×24 交易,日线结构和永续没有任何区别。
这一期要把上一期的结论收回。把池子和截面全部洗干净之后,同一套流程、同一套参数,模型在干净数据上重新训练,基线是 -5.52% 收益、-91.61% 回撤。25% 的甜点不成立了。
一、上一期我们停在哪里
先给没看过上一期的朋友补一下背景。
策略做币安 USDT-M 永续,日线,多空各取 5 个币等权,每天调仓,手续费按 5bp 算,资金费成本还没进回测。1000 万模拟资金,2025 年 7 月到 2026 年 9 月,457 个交易日。
基线是 62% 收益、73% 回撤。把每天每个币的盈亏拉出来归因,回撤不是慢慢磨出来的,是九笔单币单日突袭,八笔加起来亏掉 873 万,比整段利润还多。
加了一条 25% 的单币止损后,收益 109%,回撤 27%,夏普从 0.88 到 1.50,Calmar 从 0.68 到 3.2,一共触发 192 次。1% 和 2% 滑点下收益还有 89.6% 和 69.9%。15% 触发太频繁,383 次,1% 滑点下只剩 66.9%。30% 和 35% 太松,回撤反弹到 34% 和 40%。所以我当时说,25% 是甜点。
这一期要在这个结论上打一个问号。如果池子本身不干净,止损宽度的排序还有意义吗。
二、池子里混进了什么
币安 895 个日线合约里,217 个不是加密货币。
包括代币化美股 AAPL、TSLA、NVDA,代币化 ETF SPY、QQQ、SOXL,还有黄金 XAU、原油 CL、外汇、pre-IPO 股权和稳定币 USDC。它们和永续合约共用一套撮合,7×24 交易,日线结构完全一样。建池脚本只按成交额筛选,没有做资产类型过滤,所以根本分不出来。
其中 73 个真的进了候选池,31 个被选进过持仓,占了 295 个持仓日。总共 3208 个持仓日,比例 9.2%。
这些合约不是利润来源,合计还亏了 29.6 万。但它们占了近一成槽位,改变了选币路径、止损触发和冷静期。参数排序是路径依赖的,路径被改写,25% 这个甜点就可能是假的。
三、第一轮清洗,我差点就发了
第一轮的做法很直接,只在信号层按行删掉这些合约,标的从 734 个降到 661 个,重跑。
结果是基线 +62.86% / -68.32%,止损 15% +96.31% / -25.43%,止损 35% +120.89% / -36.31%。
25% 不再是甜点,15% 和 35% 两端都更好。我写好了一版发布稿,准备说池子洗干净后结论变了。
但发之前我又逐日核对了一遍,发现不对。
四、为什么只删行不够
非加密合约不只在 2026 年的测试段:
- TRAIN 段有 USDC,50 个符号日
- VALID 段有 PAXG 77 个符号日,加 USDC 31 个,共 108 个
- TEST 段有 73 个非加密符号,7847 个符号日
TRAIN 加 VALID 一共 158 个符号日,看起来像噪声。但我的标签是每日截面分位,特征也做了每日截面 robust 归一化,用的是当天全市场的中位数和 MAD。
多一个低波动的稳定币或者黄金合约,当天的中位数和 MAD 就变了,所有币的标签分位和归一化后的特征值也跟着变。一个合约就能把当天所有币的分数重排。
所以污染的不是那 158 行,是这些符号日里所有币的截面。只按行删数据,行删干净了,数值还是脏的。等于把用混合截面算出来的数,留在了干净的行上。
这也解释了为什么第一轮的 +62.9% 不能信。它不是策略真变好了,而是数据集里还留着脏数值。
五、全链路重建做了什么
这次没有只改信号层,而是从原始数据一路重建。
清掉的层包括:
- daily 895 个 parquet 降到 678
- contract.json 895 个键降到 678
- component/CRYPTO.LOCAL 从 735 个符号降到 662 个,2473 个交易日
- parsed klines 从 610916 行降到 586158 行
- parsed funding 和 funding_df 从 625566 行降到 602221 行
- signal 从 92235 行、582 个符号降到 84388 行、509 个符号
- risk table 从 610916 行降到 586158 行
- symbols 从 895 降到 678,pool_union 从 735 降到 662
- 数据集各表只剩 661 个纯加密符号
然后重算 r/σ 标签,重置 learn_df 和 infer_df,重跑 process_replace_inf、process_fill_na、process_cs_norm,最后原子替换 pickle。只删行不重算截面,等于没洗。
重训后的模型:
- 训练集 191138 行
- 验证集 85954 行
- 测试集 84388 行
- 661 个纯加密符号
- 早停 290 轮
- 验证集每日 IC +0.0373
- 测试集每日 IC +0.0336,ICIR +5.91
干净口径的回测:
- 基线 -5.52% / -91.61%
- 止损 10% +37.84% / -24.10%
- 止损 35% +36.12% / -47.38%
同一套流程,同一套参数,只换了数据,收益从 +62.9% 变成 -5.5%。
六、这一期推翻了上一期的什么
上一期的 62% 到 109%、回撤 73% 到 27%、25% 是止损甜点、192 次触发、滑点测试的结论,全部作废。上一期那篇长文也一起作废。
这不是模型突然变差了,是之前的数据不干净。上一期看到的是混合池的回测,这一期看到的是纯加密池加干净截面的回测。两版差了一位数,差的不是策略,是数据。
参数排序对交易路径极其敏感。数据口径一变,25% 的甜点直接消失。所以不要在一个脏口径上反复调参,调出来的甜点可能只是路径依赖。
这也是这个系列第一次自己推翻自己。上一期以为的答案,这一期只是中间站。把每一次打脸公开记录下来,比守住一个漂亮数字更有用。
七、三条教训
第一,做加密策略,先检查池子里有没有代币化股票。它们和永续合约长得一样,7×24 交易,日线结构也一样。只看成交额和代码后缀,很容易漏。
第二,只要 pipeline 里有截面归一化或者截面分位标签,按行删数据不够。必须重算标签、重做归一化、重建整个截面。一个脏合约可以通过中位数和 MAD 影响当天所有币。
第三,洗干净后的数字再丑也要报。+62.9% 看起来像能力,其实只是池子没洗干净。把 -5.5% 说出来,才知道下一步该修什么。
还有一条附带的,不要在脏数据上做参数选择。参数曲面不平滑,脏口径上的甜点,换个池子就没了。
八、边界和下一期
以上全部是回测,不是实盘业绩。资金费成本还没算,强平规则没建模,日线看不到盘中路径,滑点也需要实盘校准。457 天只有一段测试期,而且参数是在这段测试期里反复选的,不是干净样本外。
下一期我会补资金费成本、实盘滑点校准和 walk-forward,再决定止损参数要不要保留。如果你也在做 $BTC、$ETH 这类永续合约策略,先花十分钟检查一下池子里有没有 AAPL、TSLA、XAU 和 USDC,可能比继续调参更值。
这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。
#量化交易 #风险管理 #加密货币 #回测 #数据质量
275
·
--
Article
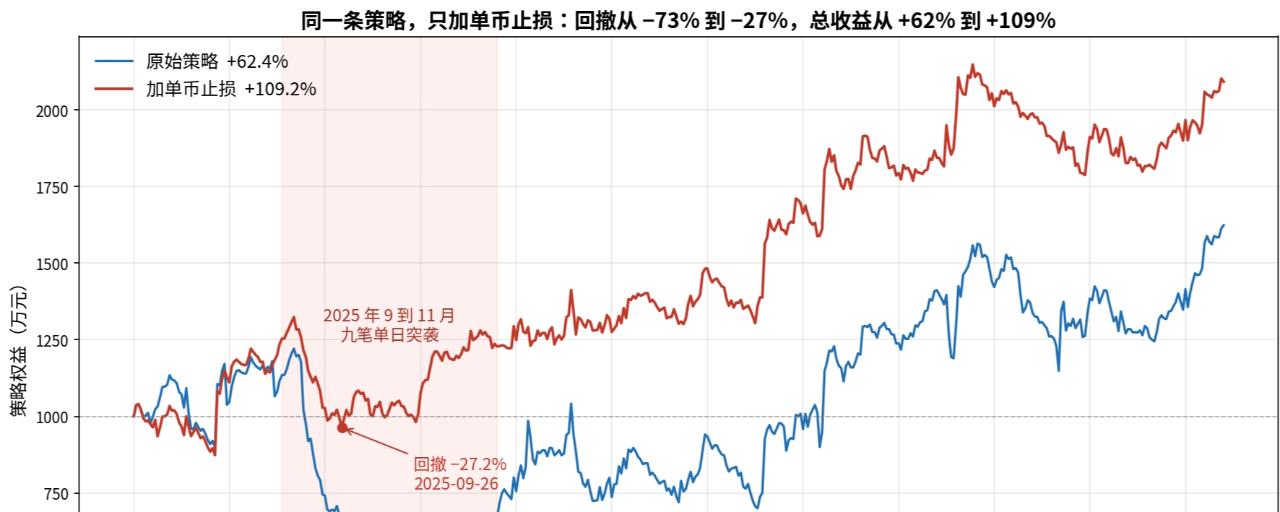
回测收益 62% 回撤 73%,我只加了一条止损,回撤砍到 27% 收益翻倍一、先看清楚钱是怎么亏掉的
过去两周我在搭一个加密永续的多空策略,1000 万模拟资金,457 天样本外测试。净值曲线像过山车,赚和亏都大得离谱。
把每天每个币的盈亏拉出来归因,真相很集中。回撤不是慢慢磨出来的,是九笔单币单日突袭,八笔亏损合计 873 万,比整段利润还多。五笔是做空撞上垂直拉升,三笔是做多追进抛物线。集中在 2025 年 9 到 11 月,但 2026 年同款事件还在反复出现,AKE、KAT、PLAY、DEXE、ZKJ 都是一样的模式,不是一次性事故。
二、第一层尝试,波动率缩放,失败
第一个想法很自然,波动大的币仓位小一点。按过去 20 日波动率相对市场中位数缩放仓位。
结果总收益从 62% 砍到 8.5%,回撤只从 73% 降到 56%。原因很扎心,出事前这些币的波动率并不高,BAS 和 ALPINE 甚至低于市场中位数,缩放比例 1.0,一分钱都没减,第二天单日爆掉。波动率缩放只能压已经处于高波动的币,对安静币突然爆没有识别力。
归一化版本更糟,把省下来的仓位移给安静币,ALPINE 从亏 121 万恶化到亏 154 万。这一层直接弃用。
三、第二层尝试,禁止开空暴涨币,被数据证伪
第二个想法更直接,刚暴涨的币不许开空。五笔空头事故的币看起来都是刚涨过一大截。
数据打脸。出事币在入场前五天的涨幅只有 6% 到 55%,而正常空头候选的中位数就有 20%,两者根本没有区分度。之前看到的暴涨 130% 到 270% 是出事当天的行情,属于事后视角,不是入场前的状态。
更要命的是,这个策略的 alpha 本来就来自做空刚被拉过的币,均值回归逻辑。禁止做空暴涨币等于把赚钱逻辑掐死。实测总收益负 18.8%,回撤 63%,直接淘汰。我原本以为这条会是最终答案。
四、真正的解药,25% 单币止损
最后回到最朴素的做法。按持仓均价设线,做多跌 25% 平仓,做空涨 25% 平仓,触发后冷静 3 天不碰这个币。用日线最低最高价判定,第二天开盘平仓。
全窗口一共触发 192 次。持仓均价用逐笔成交维护,加仓摊薄、减仓不变,策略端和回测端用同一个函数复算,保证不会有两套账。
结果
- 总收益从 62% 到 109%
- 最大回撤从 73% 到 27%
- 夏普从 0.88 到 1.50
- Calmar 从 0.68 到 3.2
八笔事故的合计亏损从 873 万压到 153 万,全部封在单币 25 万上下。最惨的一笔 TA 从亏 159 万变成亏 28 万。唯一没被误伤的是那笔赚 63 万的盈利仓,原样保留。2026 年的 AKE 等一串事件同样被封顶,说明止损在测试期全程有效,不是只救了那九笔。
五、为什么收益反而变高了
这里有个反直觉的点。止损当天其实是亏钱的,192 次触发合计还多认了 179 万亏损,因为有些币盘中插针触线,收盘又拉回去。
它真正赚钱的地方在触发之后。原来会扛着单一路亏下去,截断后不再流血,同时把仓位腾给新信号。这部分贡献约 290 万,比触发日当天的账更值钱,也更稳定。
六、滑点和参数稳健性
止损市价单不可能刚好成交在止损价。我按 1% 和 2% 滑点各重跑一遍,总收益还有 89.6% 和 69.9%,回撤压缩基本不受影响。防突袭不依赖理想成交,这是最关键的稳健性。
止损宽度也扫了一遍
- 15% 触发太频繁,383 次,1% 滑点下总收益掉到 66.9%
- 30% 回撤反弹到 34%
- 35% 回撤反弹到 40%
- 25% 是甜点,收益和回撤同时最优
触发频率是滑点敏感度的乘数,触发越多,实盘磨损越大。
七、一个反常识的发现
禁止追高做多的规则,单独用能精确挡掉 HIFI 和 AIA 两笔事故,总收益 65.6%,略好于基线。但叠加在止损之上,收益反而从 109% 掉到 76%。
原因是止损已经把事故兜住了,额外规则只剩下换仓成本,被拦的候选里还混着后来真正大涨的币。少即是多,风控规则不是越多越好。
八、结论和边界
这个策略最大的敌人不是选币不准,是单币单日爆仓式回撤。一条按持仓均价触发的 25% 单币止损,把回撤压掉三分之二,收益还翻倍。
但必须说清楚边界。以上全部是回测数字,1000 万模拟资金跑 457 天样本外,资金费成本还没算进去,滑点也需要实盘校准。策略仍在验证阶段,不是实盘业绩,别照抄。
下一步我会补资金费成本测试和实盘滑点校准,继续公开记录这个量化实验室的搭建过程,从数据、因子到风控。感兴趣可以关注,后面会持续更新。
#量化交易 #合约交易 #回测 #加密货币
回测收益 62% 回撤 73%,我只加了一条止损,回撤砍到 27% 收益翻倍
一、先看清楚钱是怎么亏掉的
过去两周我在搭一个加密永续的多空策略,1000 万模拟资金,457 天样本外测试。净值曲线像过山车,赚和亏都大得离谱。
把每天每个币的盈亏拉出来归因,真相很集中。回撤不是慢慢磨出来的,是九笔单币单日突袭,八笔亏损合计 873 万,比整段利润还多。五笔是做空撞上垂直拉升,三笔是做多追进抛物线。集中在 2025 年 9 到 11 月,但 2026 年同款事件还在反复出现,AKE、KAT、PLAY、DEXE、ZKJ 都是一样的模式,不是一次性事故。
二、第一层尝试,波动率缩放,失败
第一个想法很自然,波动大的币仓位小一点。按过去 20 日波动率相对市场中位数缩放仓位。
结果总收益从 62% 砍到 8.5%,回撤只从 73% 降到 56%。原因很扎心,出事前这些币的波动率并不高,BAS 和 ALPINE 甚至低于市场中位数,缩放比例 1.0,一分钱都没减,第二天单日爆掉。波动率缩放只能压已经处于高波动的币,对安静币突然爆没有识别力。
归一化版本更糟,把省下来的仓位移给安静币,ALPINE 从亏 121 万恶化到亏 154 万。这一层直接弃用。
三、第二层尝试,禁止开空暴涨币,被数据证伪
第二个想法更直接,刚暴涨的币不许开空。五笔空头事故的币看起来都是刚涨过一大截。
数据打脸。出事币在入场前五天的涨幅只有 6% 到 55%,而正常空头候选的中位数就有 20%,两者根本没有区分度。之前看到的暴涨 130% 到 270% 是出事当天的行情,属于事后视角,不是入场前的状态。
更要命的是,这个策略的 alpha 本来就来自做空刚被拉过的币,均值回归逻辑。禁止做空暴涨币等于把赚钱逻辑掐死。实测总收益负 18.8%,回撤 63%,直接淘汰。我原本以为这条会是最终答案。
四、真正的解药,25% 单币止损
最后回到最朴素的做法。按持仓均价设线,做多跌 25% 平仓,做空涨 25% 平仓,触发后冷静 3 天不碰这个币。用日线最低最高价判定,第二天开盘平仓。
全窗口一共触发 192 次。持仓均价用逐笔成交维护,加仓摊薄、减仓不变,策略端和回测端用同一个函数复算,保证不会有两套账。
结果
- 总收益从 62% 到 109%
- 最大回撤从 73% 到 27%
- 夏普从 0.88 到 1.50
- Calmar 从 0.68 到 3.2
八笔事故的合计亏损从 873 万压到 153 万,全部封在单币 25 万上下。最惨的一笔 TA 从亏 159 万变成亏 28 万。唯一没被误伤的是那笔赚 63 万的盈利仓,原样保留。2026 年的 AKE 等一串事件同样被封顶,说明止损在测试期全程有效,不是只救了那九笔。
五、为什么收益反而变高了
这里有个反直觉的点。止损当天其实是亏钱的,192 次触发合计还多认了 179 万亏损,因为有些币盘中插针触线,收盘又拉回去。
它真正赚钱的地方在触发之后。原来会扛着单一路亏下去,截断后不再流血,同时把仓位腾给新信号。这部分贡献约 290 万,比触发日当天的账更值钱,也更稳定。
六、滑点和参数稳健性
止损市价单不可能刚好成交在止损价。我按 1% 和 2% 滑点各重跑一遍,总收益还有 89.6% 和 69.9%,回撤压缩基本不受影响。防突袭不依赖理想成交,这是最关键的稳健性。
止损宽度也扫了一遍
- 15% 触发太频繁,383 次,1% 滑点下总收益掉到 66.9%
- 30% 回撤反弹到 34%
- 35% 回撤反弹到 40%
- 25% 是甜点,收益和回撤同时最优
触发频率是滑点敏感度的乘数,触发越多,实盘磨损越大。
七、一个反常识的发现
禁止追高做多的规则,单独用能精确挡掉 HIFI 和 AIA 两笔事故,总收益 65.6%,略好于基线。但叠加在止损之上,收益反而从 109% 掉到 76%。
原因是止损已经把事故兜住了,额外规则只剩下换仓成本,被拦的候选里还混着后来真正大涨的币。少即是多,风控规则不是越多越好。
八、结论和边界
这个策略最大的敌人不是选币不准,是单币单日爆仓式回撤。一条按持仓均价触发的 25% 单币止损,把回撤压掉三分之二,收益还翻倍。
但必须说清楚边界。以上全部是回测数字,1000 万模拟资金跑 457 天样本外,资金费成本还没算进去,滑点也需要实盘校准。策略仍在验证阶段,不是实盘业绩,别照抄。
下一步我会补资金费成本测试和实盘滑点校准,继续公开记录这个量化实验室的搭建过程,从数据、因子到风控。感兴趣可以关注,后面会持续更新。
#量化交易 #合约交易 #回测 #加密货币
过去两周我在搭一个加密永续的多空策略,1000 万模拟资金,457 天样本外测试。净值曲线像过山车,赚和亏都大得离谱。
把每天每个币的盈亏拉出来归因,真相很集中。回撤不是慢慢磨出来的,是九笔单币单日突袭,八笔亏损合计 873 万,比整段利润还多。五笔是做空撞上垂直拉升,三笔是做多追进抛物线。集中在 2025 年 9 到 11 月,但 2026 年同款事件还在反复出现,AKE、KAT、PLAY、DEXE、ZKJ 都是一样的模式,不是一次性事故。
二、第一层尝试,波动率缩放,失败
第一个想法很自然,波动大的币仓位小一点。按过去 20 日波动率相对市场中位数缩放仓位。
结果总收益从 62% 砍到 8.5%,回撤只从 73% 降到 56%。原因很扎心,出事前这些币的波动率并不高,BAS 和 ALPINE 甚至低于市场中位数,缩放比例 1.0,一分钱都没减,第二天单日爆掉。波动率缩放只能压已经处于高波动的币,对安静币突然爆没有识别力。
归一化版本更糟,把省下来的仓位移给安静币,ALPINE 从亏 121 万恶化到亏 154 万。这一层直接弃用。
三、第二层尝试,禁止开空暴涨币,被数据证伪
第二个想法更直接,刚暴涨的币不许开空。五笔空头事故的币看起来都是刚涨过一大截。
数据打脸。出事币在入场前五天的涨幅只有 6% 到 55%,而正常空头候选的中位数就有 20%,两者根本没有区分度。之前看到的暴涨 130% 到 270% 是出事当天的行情,属于事后视角,不是入场前的状态。
更要命的是,这个策略的 alpha 本来就来自做空刚被拉过的币,均值回归逻辑。禁止做空暴涨币等于把赚钱逻辑掐死。实测总收益负 18.8%,回撤 63%,直接淘汰。我原本以为这条会是最终答案。
四、真正的解药,25% 单币止损
最后回到最朴素的做法。按持仓均价设线,做多跌 25% 平仓,做空涨 25% 平仓,触发后冷静 3 天不碰这个币。用日线最低最高价判定,第二天开盘平仓。
全窗口一共触发 192 次。持仓均价用逐笔成交维护,加仓摊薄、减仓不变,策略端和回测端用同一个函数复算,保证不会有两套账。
结果
- 总收益从 62% 到 109%
- 最大回撤从 73% 到 27%
- 夏普从 0.88 到 1.50
- Calmar 从 0.68 到 3.2
八笔事故的合计亏损从 873 万压到 153 万,全部封在单币 25 万上下。最惨的一笔 TA 从亏 159 万变成亏 28 万。唯一没被误伤的是那笔赚 63 万的盈利仓,原样保留。2026 年的 AKE 等一串事件同样被封顶,说明止损在测试期全程有效,不是只救了那九笔。
五、为什么收益反而变高了
这里有个反直觉的点。止损当天其实是亏钱的,192 次触发合计还多认了 179 万亏损,因为有些币盘中插针触线,收盘又拉回去。
它真正赚钱的地方在触发之后。原来会扛着单一路亏下去,截断后不再流血,同时把仓位腾给新信号。这部分贡献约 290 万,比触发日当天的账更值钱,也更稳定。
六、滑点和参数稳健性
止损市价单不可能刚好成交在止损价。我按 1% 和 2% 滑点各重跑一遍,总收益还有 89.6% 和 69.9%,回撤压缩基本不受影响。防突袭不依赖理想成交,这是最关键的稳健性。
止损宽度也扫了一遍
- 15% 触发太频繁,383 次,1% 滑点下总收益掉到 66.9%
- 30% 回撤反弹到 34%
- 35% 回撤反弹到 40%
- 25% 是甜点,收益和回撤同时最优
触发频率是滑点敏感度的乘数,触发越多,实盘磨损越大。
七、一个反常识的发现
禁止追高做多的规则,单独用能精确挡掉 HIFI 和 AIA 两笔事故,总收益 65.6%,略好于基线。但叠加在止损之上,收益反而从 109% 掉到 76%。
原因是止损已经把事故兜住了,额外规则只剩下换仓成本,被拦的候选里还混着后来真正大涨的币。少即是多,风控规则不是越多越好。
八、结论和边界
这个策略最大的敌人不是选币不准,是单币单日爆仓式回撤。一条按持仓均价触发的 25% 单币止损,把回撤压掉三分之二,收益还翻倍。
但必须说清楚边界。以上全部是回测数字,1000 万模拟资金跑 457 天样本外,资金费成本还没算进去,滑点也需要实盘校准。策略仍在验证阶段,不是实盘业绩,别照抄。
下一步我会补资金费成本测试和实盘滑点校准,继续公开记录这个量化实验室的搭建过程,从数据、因子到风控。感兴趣可以关注,后面会持续更新。
#量化交易 #合约交易 #回测 #加密货币
1.6k
·
--
$BTC
{spot}(BTCUSDT)
破了一下8万又被迅速拉回,昨日日线收阳,8万支撑还是很坚挺,这里是非常好的加仓点位。
$HYPE
{spot}(HYPEUSDT)
80刀支撑也非常强,在76-80加仓是不错的选择。
牛市中日线回调加仓,三倍杠杆贯穿牛市!
$BTC
破了一下8万又被迅速拉回,昨日日线收阳,8万支撑还是很坚挺,这里是非常好的加仓点位。
$HYPE
80刀支撑也非常强,在76-80加仓是不错的选择。
牛市中日线回调加仓,三倍杠杆贯穿牛市!
破了一下8万又被迅速拉回,昨日日线收阳,8万支撑还是很坚挺,这里是非常好的加仓点位。
$HYPE
80刀支撑也非常强,在76-80加仓是不错的选择。
牛市中日线回调加仓,三倍杠杆贯穿牛市!
120
·
--
翻了 4936 笔成交记录,我的选币中性策略 -73% 回撤,真凶不是大盘下跌15 个月总收益 +62% 的加密合约策略,中途有一段 -73% 的最大回撤,权益从 1221 万峰值跌到 325 万。
我原以为是被 BTC 见顶带崩的。把 4936 笔成交逐笔拆完,结论出乎意料。组合和 BTC 的日收益相关性只有 -0.02。从策略见顶的 9/6 到回撤最深的 10/27,BTC 同期甚至还涨了 4%。
真正打崩账户的,是 7 个交易日,和 7 个没人听过的小币。这篇把每个数字都摊开。
发布时此处附交易晒单卡片或实盘主页链接。本文是回测复盘,数据全部来自币安公开历史存档,可复现。
一、回撤全貌
策略设定,日线频率,多空各持 5 个币,每天调仓,单币固定仓位 100 万,总资金 1000 万。
9/6,权益冲到 1221 万。10/27,只剩 325 万,跌掉 73.41%。其中 81% 的伤害来自仅 3 个交易周。
二、把亏损按单币单日排序,画面瞬间清晰
9-11 月只有 7 天出现单币单日亏损超 50 万,这 7 天合计亏掉 714 万。刨掉这 7 天,其余 80 多个交易日合计净赚约 227 万。
回撤不是慢性失血,是几次重击。
三、三种死法,全部来自极端波动
一是空单被暴力拉升,共 4 天。XPIN 当日涨 150%,NAORIS 涨 145%,BAS 涨 134%。策略把走势最弱的币排进做空名单,第二天开盘 100 万空单刚成交,币价当天翻倍级跳涨,单笔亏 130 到 150 万,约本金的 15%。
二是翻仓自残。ALPINE 当天涨 121%。9/26 早上策略按信号卖出多单 474,226 枚,约 100 万,反手再开空 471,209 枚,约 100 万,当天收盘 4.69,前一日约 2.12。做多本来是对的,翻仓后变成双倍做空,单日净亏 121 万。
三是多头接飞刀,共 3 天。HIFI 单日跌 60%,B2 跌 52%,AIA 跌 52%,全是策略当时选中的最强标的。
共同点是,这些币爆发前一天走势平平,日线走完时损失已经全部打完,日线策略连止损的机会都没有。
四、反直觉发现,这次和 大盘无关
亏损最狠的 7 天里,BTC 几乎走平,组合持有的币平均却动了 9% 到 13%。这不是大盘风险,是小币的尾部风险。你的合约策略可能没暴露给 BTC,却暴露给了极端行情。
五、为什么偏偏是那两个月
全市场统计显示,2025 年 10 月,单日涨跌超 30% 的行情占比 2.5%,平时只有 0.2%,整整 10 倍。11 月出现 17 次单日翻倍,是我样本里最多的一个月。极端波动月,撞上了毫无保护、满仓暴露的策略。
六、病根不是看错行情,是结构没有保护
单币固定 100 万,没有波动缩放。币一天翻倍,仓位原样吃满。
没有单币上限,没有尾部风控。多空两头选中的,恰好都是波动最野的币。
日线频率,极端行情下没有盘中止损的机会。
7 次这样的日子,账户没了七成。
七、结论
-73% 不是行情判断错误,是极端行情下没有保护。同一套逻辑,12 月把钱赚了回来,回撤从 -73% 修复到 -15%。要补的是风控,不是猜行情。正在做三件事,按波动缩放仓位,给单币设上限,加极端行情检测。
如果你也在跑合约策略,翻一下自己的回测,把亏损按单币单日排个序。如果你的伤害也集中在少数几天,那你要解决的不是信号,是仓位。
建议标签 $BTC $ALPINE #量化交易 #风控 #Write2Earn
翻了 4936 笔成交记录,我的选币中性策略 -73% 回撤,真凶不是大盘下跌
15 个月总收益 +62% 的加密合约策略,中途有一段 -73% 的最大回撤,权益从 1221 万峰值跌到 325 万。
我原以为是被 BTC 见顶带崩的。把 4936 笔成交逐笔拆完,结论出乎意料。组合和 BTC 的日收益相关性只有 -0.02。从策略见顶的 9/6 到回撤最深的 10/27,BTC 同期甚至还涨了 4%。
真正打崩账户的,是 7 个交易日,和 7 个没人听过的小币。这篇把每个数字都摊开。
发布时此处附交易晒单卡片或实盘主页链接。本文是回测复盘,数据全部来自币安公开历史存档,可复现。
一、回撤全貌
策略设定,日线频率,多空各持 5 个币,每天调仓,单币固定仓位 100 万,总资金 1000 万。
9/6,权益冲到 1221 万。10/27,只剩 325 万,跌掉 73.41%。其中 81% 的伤害来自仅 3 个交易周。
二、把亏损按单币单日排序,画面瞬间清晰
9-11 月只有 7 天出现单币单日亏损超 50 万,这 7 天合计亏掉 714 万。刨掉这 7 天,其余 80 多个交易日合计净赚约 227 万。
回撤不是慢性失血,是几次重击。
三、三种死法,全部来自极端波动
一是空单被暴力拉升,共 4 天。XPIN 当日涨 150%,NAORIS 涨 145%,BAS 涨 134%。策略把走势最弱的币排进做空名单,第二天开盘 100 万空单刚成交,币价当天翻倍级跳涨,单笔亏 130 到 150 万,约本金的 15%。
二是翻仓自残。ALPINE 当天涨 121%。9/26 早上策略按信号卖出多单 474,226 枚,约 100 万,反手再开空 471,209 枚,约 100 万,当天收盘 4.69,前一日约 2.12。做多本来是对的,翻仓后变成双倍做空,单日净亏 121 万。
三是多头接飞刀,共 3 天。HIFI 单日跌 60%,B2 跌 52%,AIA 跌 52%,全是策略当时选中的最强标的。
共同点是,这些币爆发前一天走势平平,日线走完时损失已经全部打完,日线策略连止损的机会都没有。
四、反直觉发现,这次和 大盘无关
亏损最狠的 7 天里,BTC 几乎走平,组合持有的币平均却动了 9% 到 13%。这不是大盘风险,是小币的尾部风险。你的合约策略可能没暴露给 BTC,却暴露给了极端行情。
五、为什么偏偏是那两个月
全市场统计显示,2025 年 10 月,单日涨跌超 30% 的行情占比 2.5%,平时只有 0.2%,整整 10 倍。11 月出现 17 次单日翻倍,是我样本里最多的一个月。极端波动月,撞上了毫无保护、满仓暴露的策略。
六、病根不是看错行情,是结构没有保护
单币固定 100 万,没有波动缩放。币一天翻倍,仓位原样吃满。
没有单币上限,没有尾部风控。多空两头选中的,恰好都是波动最野的币。
日线频率,极端行情下没有盘中止损的机会。
7 次这样的日子,账户没了七成。
七、结论
-73% 不是行情判断错误,是极端行情下没有保护。同一套逻辑,12 月把钱赚了回来,回撤从 -73% 修复到 -15%。要补的是风控,不是猜行情。正在做三件事,按波动缩放仓位,给单币设上限,加极端行情检测。
如果你也在跑合约策略,翻一下自己的回测,把亏损按单币单日排个序。如果你的伤害也集中在少数几天,那你要解决的不是信号,是仓位。
建议标签 $BTC $ALPINE #量化交易 #风控 #Write2Earn
我原以为是被 BTC 见顶带崩的。把 4936 笔成交逐笔拆完,结论出乎意料。组合和 BTC 的日收益相关性只有 -0.02。从策略见顶的 9/6 到回撤最深的 10/27,BTC 同期甚至还涨了 4%。
真正打崩账户的,是 7 个交易日,和 7 个没人听过的小币。这篇把每个数字都摊开。
发布时此处附交易晒单卡片或实盘主页链接。本文是回测复盘,数据全部来自币安公开历史存档,可复现。
一、回撤全貌
策略设定,日线频率,多空各持 5 个币,每天调仓,单币固定仓位 100 万,总资金 1000 万。
9/6,权益冲到 1221 万。10/27,只剩 325 万,跌掉 73.41%。其中 81% 的伤害来自仅 3 个交易周。
二、把亏损按单币单日排序,画面瞬间清晰
9-11 月只有 7 天出现单币单日亏损超 50 万,这 7 天合计亏掉 714 万。刨掉这 7 天,其余 80 多个交易日合计净赚约 227 万。
回撤不是慢性失血,是几次重击。
三、三种死法,全部来自极端波动
一是空单被暴力拉升,共 4 天。XPIN 当日涨 150%,NAORIS 涨 145%,BAS 涨 134%。策略把走势最弱的币排进做空名单,第二天开盘 100 万空单刚成交,币价当天翻倍级跳涨,单笔亏 130 到 150 万,约本金的 15%。
二是翻仓自残。ALPINE 当天涨 121%。9/26 早上策略按信号卖出多单 474,226 枚,约 100 万,反手再开空 471,209 枚,约 100 万,当天收盘 4.69,前一日约 2.12。做多本来是对的,翻仓后变成双倍做空,单日净亏 121 万。
三是多头接飞刀,共 3 天。HIFI 单日跌 60%,B2 跌 52%,AIA 跌 52%,全是策略当时选中的最强标的。
共同点是,这些币爆发前一天走势平平,日线走完时损失已经全部打完,日线策略连止损的机会都没有。
四、反直觉发现,这次和 大盘无关
亏损最狠的 7 天里,BTC 几乎走平,组合持有的币平均却动了 9% 到 13%。这不是大盘风险,是小币的尾部风险。你的合约策略可能没暴露给 BTC,却暴露给了极端行情。
五、为什么偏偏是那两个月
全市场统计显示,2025 年 10 月,单日涨跌超 30% 的行情占比 2.5%,平时只有 0.2%,整整 10 倍。11 月出现 17 次单日翻倍,是我样本里最多的一个月。极端波动月,撞上了毫无保护、满仓暴露的策略。
六、病根不是看错行情,是结构没有保护
单币固定 100 万,没有波动缩放。币一天翻倍,仓位原样吃满。
没有单币上限,没有尾部风控。多空两头选中的,恰好都是波动最野的币。
日线频率,极端行情下没有盘中止损的机会。
7 次这样的日子,账户没了七成。
七、结论
-73% 不是行情判断错误,是极端行情下没有保护。同一套逻辑,12 月把钱赚了回来,回撤从 -73% 修复到 -15%。要补的是风控,不是猜行情。正在做三件事,按波动缩放仓位,给单币设上限,加极端行情检测。
如果你也在跑合约策略,翻一下自己的回测,把亏损按单币单日排个序。如果你的伤害也集中在少数几天,那你要解决的不是信号,是仓位。
建议标签 $BTC $ALPINE #量化交易 #风控 #Write2Earn
332
·
--
BTC8万这里非常坚挺,刚刚1小时K线放量下跌后又迅速拉回,收了一个下阴线,8万跌不穿就要V返。
{future}(BTCUSDT)
BTC8万这里非常坚挺,刚刚1小时K线放量下跌后又迅速拉回,收了一个下阴线,8万跌不穿就要V返。
170
·
--
9月CPI比预期高了0.1%,加息预期又增加了,BTC短线应声下跌,结合coinbase最近BTC持续负溢价、几大ETF连续多日净流出,说明美国市场最近一直在卖出,消化加息预期,但目前BTC价格依然在82000-84000震荡,并没走出下跌趋势,待加息预期消化的差不多了,自然会上涨。#BTC走势分析
9月CPI比预期高了0.1%,加息预期又增加了,BTC短线应声下跌,结合coinbase最近BTC持续负溢价、几大ETF连续多日净流出,说明美国市场最近一直在卖出,消化加息预期,但目前BTC价格依然在82000-84000震荡,并没走出下跌趋势,待加息预期消化的差不多了,自然会上涨。#BTC走势分析
184
·
--
昨天在调截面多因子选币策略的回测,跑完一看:收益率 0,夏普 0,最大回撤 0。
第一反应是策略根本没交易。
结果查出来是引擎在装死:457 天里有 178 天账户资金是负的,触发了爆仓保护,所有指标拒绝计算。
顺着这条线挖出两个 bug。
Bug 一号:最小报价单位,被设成了 0.01。
下单价格要按它取整。
池子里很多币不到 0.005 美元,挂单价(收盘价+1%)取整后直接变成 0。
后果:报 0 的买单永远不成交,卖单反而必成交。多头买不进、空头平不掉,账上从五五开变成 3.7 个多头对 9.7 个空头,等于天天裸空。
修之前先查了数据:池子里 829 个币,价格最多用到 8 位小数,最便宜的一笔是 0.0000034 美元。
于是把报价单位定成 1e-9(小数点后 9 位),留一个数量级的余量。
改完订单成交率回到 100%,报价归零的订单清零。
Bug 二号:杠杆。
策略参数是照抄期货示例的,默认 3 倍名义敞口。
加密波动大,3 倍下资金天天在零附近晃,随时触发爆仓保护。
降到 1 倍,再没爆过。
修完两个坑,回测终于出数了:
15 个月总收益 +62%,年化约 50%,夏普 0.88。
先别激动:最大回撤 -73%,光手续费就交了 180 万。
而且资金费、强平都还没建模,所以这只能说明管道通了,离"策略能用"还差得远。
还升级了模型:选股标签从"纯涨幅排名"换成"涨幅÷波动率再排名",训练早停也改成盯每日预测相关性。
昨天最大的体会:最花时间的不是写策略,是发现自己被自己的回测骗了。
今天把资金费成本补进去,再跑一轮。等我结果😤
#AIHarness投研工程 #量化交易员 #选币策略
昨天在调截面多因子选币策略的回测,跑完一看:收益率 0,夏普 0,最大回撤 0。
第一反应是策略根本没交易。
结果查出来是引擎在装死:457 天里有 178 天账户资金是负的,触发了爆仓保护,所有指标拒绝计算。
顺着这条线挖出两个 bug。
Bug 一号:最小报价单位,被设成了 0.01。
下单价格要按它取整。
池子里很多币不到 0.005 美元,挂单价(收盘价+1%)取整后直接变成 0。
后果:报 0 的买单永远不成交,卖单反而必成交。多头买不进、空头平不掉,账上从五五开变成 3.7 个多头对 9.7 个空头,等于天天裸空。
修之前先查了数据:池子里 829 个币,价格最多用到 8 位小数,最便宜的一笔是 0.0000034 美元。
于是把报价单位定成 1e-9(小数点后 9 位),留一个数量级的余量。
改完订单成交率回到 100%,报价归零的订单清零。
Bug 二号:杠杆。
策略参数是照抄期货示例的,默认 3 倍名义敞口。
加密波动大,3 倍下资金天天在零附近晃,随时触发爆仓保护。
降到 1 倍,再没爆过。
修完两个坑,回测终于出数了:
15 个月总收益 +62%,年化约 50%,夏普 0.88。
先别激动:最大回撤 -73%,光手续费就交了 180 万。
而且资金费、强平都还没建模,所以这只能说明管道通了,离"策略能用"还差得远。
还升级了模型:选股标签从"纯涨幅排名"换成"涨幅÷波动率再排名",训练早停也改成盯每日预测相关性。
昨天最大的体会:最花时间的不是写策略,是发现自己被自己的回测骗了。
今天把资金费成本补进去,再跑一轮。等我结果😤
#AIHarness投研工程 #量化交易员 #选币策略
第一反应是策略根本没交易。
结果查出来是引擎在装死:457 天里有 178 天账户资金是负的,触发了爆仓保护,所有指标拒绝计算。
顺着这条线挖出两个 bug。
Bug 一号:最小报价单位,被设成了 0.01。
下单价格要按它取整。
池子里很多币不到 0.005 美元,挂单价(收盘价+1%)取整后直接变成 0。
后果:报 0 的买单永远不成交,卖单反而必成交。多头买不进、空头平不掉,账上从五五开变成 3.7 个多头对 9.7 个空头,等于天天裸空。
修之前先查了数据:池子里 829 个币,价格最多用到 8 位小数,最便宜的一笔是 0.0000034 美元。
于是把报价单位定成 1e-9(小数点后 9 位),留一个数量级的余量。
改完订单成交率回到 100%,报价归零的订单清零。
Bug 二号:杠杆。
策略参数是照抄期货示例的,默认 3 倍名义敞口。
加密波动大,3 倍下资金天天在零附近晃,随时触发爆仓保护。
降到 1 倍,再没爆过。
修完两个坑,回测终于出数了:
15 个月总收益 +62%,年化约 50%,夏普 0.88。
先别激动:最大回撤 -73%,光手续费就交了 180 万。
而且资金费、强平都还没建模,所以这只能说明管道通了,离"策略能用"还差得远。
还升级了模型:选股标签从"纯涨幅排名"换成"涨幅÷波动率再排名",训练早停也改成盯每日预测相关性。
昨天最大的体会:最花时间的不是写策略,是发现自己被自己的回测骗了。
今天把资金费成本补进去,再跑一轮。等我结果😤
#AIHarness投研工程 #量化交易员 #选币策略
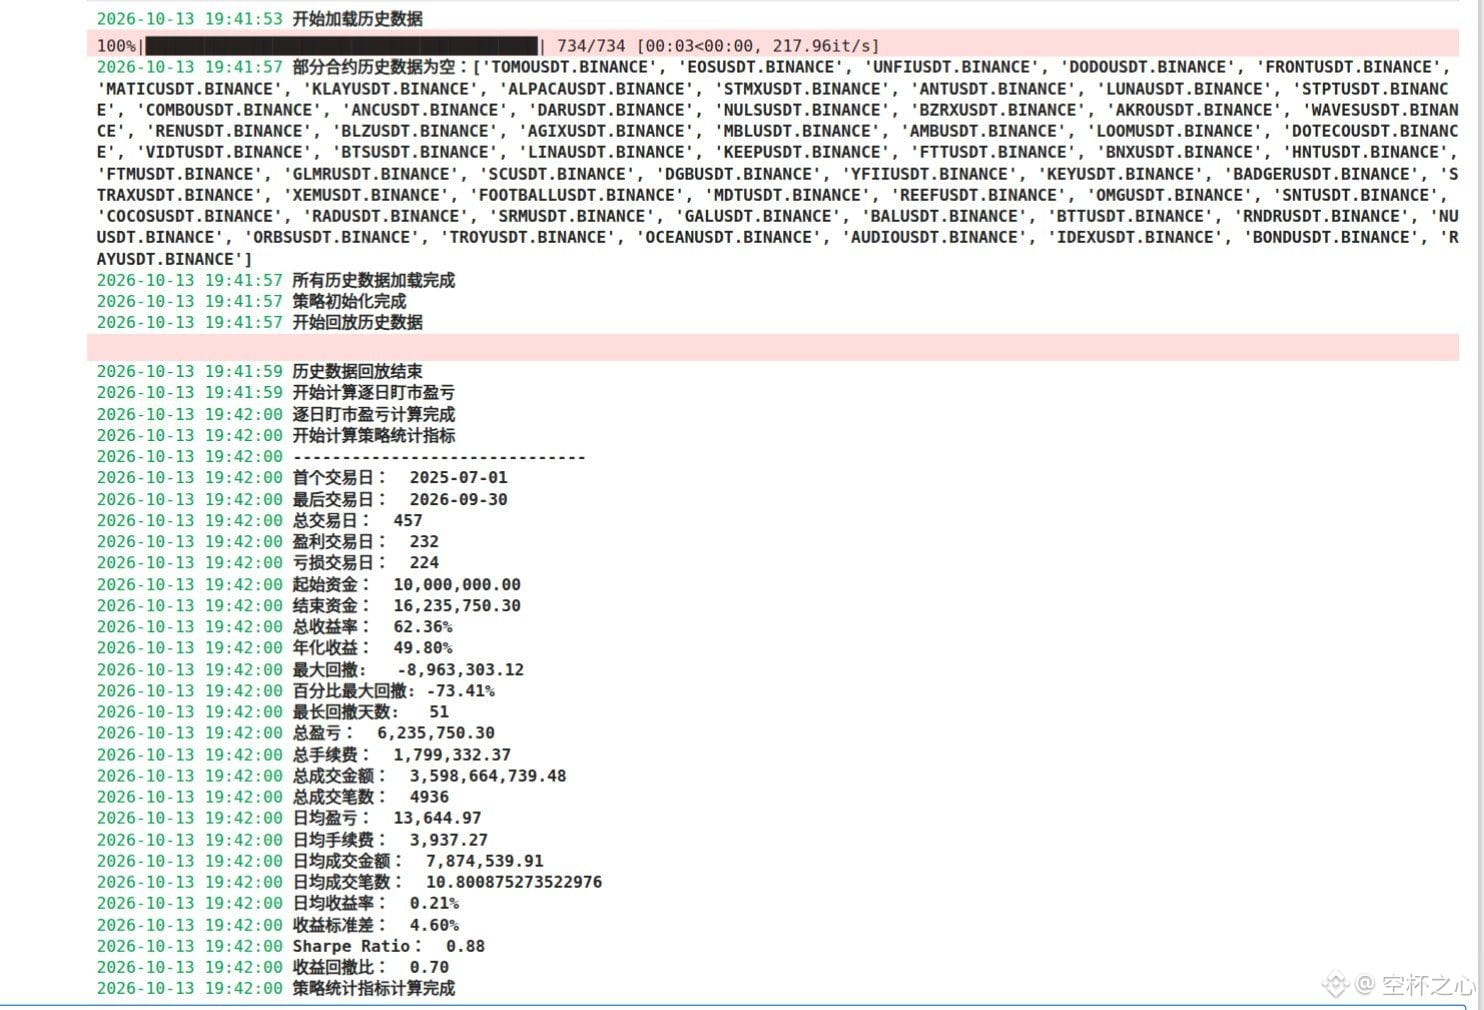
162
·
--
折腾挺久,把之前做商品期货的一套研究流程搬到了币安永续上,搞了个选币策略。
做法很简单:每天让模型给几百个币的涨跌排个序,做多前 5 个、做空后 5 个。模型吃 96 个量价指标加资金费率,预测未来两天谁涨谁跌。币的名单是从交易所官方存档里重建的,下架的币也算进去,不然只统计活到今天的币,纯属骗自己。
前几天第一次完整回测跑完了。
爆仓。
缓了缓,去翻了下明细,发现爆得还挺有道理。
币圈涨起来是没有上限的。回测那一年多里,好几次做空的币当天直接翻倍,最猛的一次涨了 3 倍多。做空最多赚 100%,亏起来没底,我的空头正好全埋在里面。
另外,模型特别爱空新币。它觉得要跌的币里,快一半是上线不到两个月的新币。可新币上市后经常先涨一波,模型拿老币的规律去套新币,被反复教育。
有意思的是,模型的排序本身是有用的,有点预测力,不是瞎猜。但排得准跟能赚到钱是两码事,尤其在暴涨容易、跌也就跌到零的市场里。
下一版先给空头加风控,至少别专门去空新币了。
还早,慢慢来。记录一下,别跟单。#选币策略 #AI #量化交易员
折腾挺久,把之前做商品期货的一套研究流程搬到了币安永续上,搞了个选币策略。
做法很简单:每天让模型给几百个币的涨跌排个序,做多前 5 个、做空后 5 个。模型吃 96 个量价指标加资金费率,预测未来两天谁涨谁跌。币的名单是从交易所官方存档里重建的,下架的币也算进去,不然只统计活到今天的币,纯属骗自己。
前几天第一次完整回测跑完了。
爆仓。
缓了缓,去翻了下明细,发现爆得还挺有道理。
币圈涨起来是没有上限的。回测那一年多里,好几次做空的币当天直接翻倍,最猛的一次涨了 3 倍多。做空最多赚 100%,亏起来没底,我的空头正好全埋在里面。
另外,模型特别爱空新币。它觉得要跌的币里,快一半是上线不到两个月的新币。可新币上市后经常先涨一波,模型拿老币的规律去套新币,被反复教育。
有意思的是,模型的排序本身是有用的,有点预测力,不是瞎猜。但排得准跟能赚到钱是两码事,尤其在暴涨容易、跌也就跌到零的市场里。
下一版先给空头加风控,至少别专门去空新币了。
还早,慢慢来。记录一下,别跟单。#选币策略 #AI #量化交易员
做法很简单:每天让模型给几百个币的涨跌排个序,做多前 5 个、做空后 5 个。模型吃 96 个量价指标加资金费率,预测未来两天谁涨谁跌。币的名单是从交易所官方存档里重建的,下架的币也算进去,不然只统计活到今天的币,纯属骗自己。
前几天第一次完整回测跑完了。
爆仓。
缓了缓,去翻了下明细,发现爆得还挺有道理。
币圈涨起来是没有上限的。回测那一年多里,好几次做空的币当天直接翻倍,最猛的一次涨了 3 倍多。做空最多赚 100%,亏起来没底,我的空头正好全埋在里面。
另外,模型特别爱空新币。它觉得要跌的币里,快一半是上线不到两个月的新币。可新币上市后经常先涨一波,模型拿老币的规律去套新币,被反复教育。
有意思的是,模型的排序本身是有用的,有点预测力,不是瞎猜。但排得准跟能赚到钱是两码事,尤其在暴涨容易、跌也就跌到零的市场里。
下一版先给空头加风控,至少别专门去空新币了。
还早,慢慢来。记录一下,别跟单。#选币策略 #AI #量化交易员
1
265
Log in to explore more content
Join global crypto users on Binance Square
⚡️ Get latest and useful information about crypto.
💬 Trusted by the world’s largest crypto exchange.
👍 Discover real insights from verified creators.
Email / Phone number
Trending Topics
NvidiaBeatsEstimatesWith$130BQ4Outlook
52,752 views
273 Discussing
Nvidia Beats With $115.8 Billion in Revenue, Guides to $130 Billion and Adds $150 Billion Buyback
Binance News
·73 Likes
·48.4k views
AnthropicIPOPriceCouldExceed$80
53,785 views
233 Discussing
RussiaCentralBankAddsAlfaBankToCryptoExchangeRegister
3,034 views
43 Discussing