

上一期结尾我写,下一期做三件事:给融合信号接上 buffer 和止损,跑验证期,再做 walk-forward。
这期没按这个顺序走。
数据补到 10 月 21 日之后,我先把九条策略一起拉到新的前向窗口上跑了一遍,同时把测试期的回撤结构重新排了一次。跑完的决定是:九条只留三条,另外六条连同策略文件、回测结果一起删掉。
被删的六条不是不赚钱。五条测试期收益超过 +115%,最高一条 +152.67%。但它们的最深回撤在 -21.8% 到 -54.8% 之间,水下时间最长 232 个交易日。这种曲线放在回测里能看,放进实盘账户,大部分人扛不到回本那天。
所以这期先做减法。下面讲清楚四件事:为什么改计划、按什么标准砍、砍完剩下什么、以及一个还没解决的问题。
一、上一期的计划,为什么先改了
上一期交付的是“能一键复现的九策略目录”:九个策略文件、六份信号、一个 notebook,9/9 逐项对账通过。那期的目标是让数字可信,不是判断哪个策略该上。
问题也出在这里。目录把九条策略并排放在一起,读者很容易理解成九个都是候选。实际上其中几条的回撤在 -50% 上下,资金曲线中间有半年不创新高。它们能留在目录里,是因为当时的任务是复现,不是筛选。
如果在这个状态下继续给融合加止损、做 walk-forward,等于在一堆不能用的策略上继续加功能。功能叠得越多,后面越难分清问题出在信号、风控还是执行。
另一个变化是数据。10 月 1 日到 21 日的数据到了。这是测试期之后第一段没有参与过任何选择的时间,虽然只有 21 天,但足够做一次体检。
顺序于是改成:先按测试期的风险结构筛一遍,砍到三条;再用 10 月做前向验证;最后才回到融合加止损和 walk-forward。维护的策略从九条变成三条,后面的工作反而更快。
验证期这次也没跑。VALID 参与了模型早停,只能算半样本内;论干净程度,它不如 10 月这 21 天。等 stop10 的成交问题解决,再把验证期和 walk-forward 一起补上。
二、Calmar 的两个算法,先对齐
上一期给融合写的 Calmar 是 7.49,这一期的筛选表里写的是 9.38。同一个策略两个数,先说清楚。
两个都对,算法不同。7.49 是年化口径:把 457 天的总收益按 365/457 折成年化,再除以最大回撤。9.38 是区间口径:457 天的总收益直接除以最大回撤。测试期比一年长,折年之后分子变小,所以 7.49 比 9.38 低。
这一期的门槛用的是区间口径,所以 9.38 对的是门槛 7。三条保留策略按年化口径分别是 7.49、6.43、6.33。
以后看到 Calmar,先问一句是哪种算法。混着比,策略会排错。
三、四条门槛:先看回撤,再看收益
筛选只看测试期,2025 年 7 月 1 日到 2026 年 9 月 30 日,457 天,1000 万本金。四条门槛:
- 最大回撤不超过 20%
- Calmar(区间总收益除以最大回撤)不低于 7
- Ulcer 指数不超过 8
- 最长水下天数不超过 110 个交易日
为什么是这四条。回撤决定这条策略能不能被拿住;Calmar 把收益和回撤放在一起看;Ulcer 不只看最深的那一次,还看回撤持续多久、反复多少次;水下天数最直观,就是账户从高点跌下去之后,多少天没回来。四个指标都在回答同一个问题:这条曲线,人能不能坐得住。
收益排名不在门槛里。原因很简单:收益高但回撤 -50% 的策略,实盘里通常活不到收益兑现。
10 月的数据不参与筛选。只有 21 天,拿它挑策略等于让裁判兼选手。10 月只用来验证,不用来选。
需要诚实说明一点:这四条门槛是我看完九条结果之后定的,属于事后标准,不是事先写好的规则。它能帮我做出一致的取舍,但不构成统计意义上的证明。
四、九条策略的成绩单
按 Calmar 从高到低排:
| 策略 | 收益 | 最大回撤 | Calmar | 夏普 | Ulcer | 水下天数 | 结论 |
|---|---:|---:|---:|---:|---:|---:|---|
| 融合 top5 | +172.93% | -18.44% | 9.38 | 2.076 | 7.59 | 107 | 保留 |
| 模型 buf4 止损10 | +130.86% | -16.25% | 8.05 | 1.906 | 6.10 | 96 | 保留 |
| 模型 多头buf5 止损10 | +114.01% | -14.39% | 7.92 | 1.846 | 4.84 | 75 | 保留 |
| mom10 top5 多头buf5 | +152.67% | -30.13% | 5.07 | 1.577 | 13.48 | 171 | 淘汰 |
| 模型 buf4 止损35 | +151.47% | -31.42% | 4.82 | 1.635 | 11.90 | 123 | 淘汰 |
| mom10 top5 | +134.22% | -39.03% | 3.44 | 1.385 | 13.93 | 171 | 淘汰 |
| mom10 top20 多头buf5 | +68.98% | -21.81% | 3.16 | 1.563 | 6.92 | 109 | 淘汰 |
| 模型 buf4 | +137.55% | -54.80% | 2.51 | 1.368 | 22.31 | 219 | 淘汰 |
| 模型 多头buf5 | +115.08% | -51.89% | 2.22 | 1.174 | 25.96 | 232 | 淘汰 |
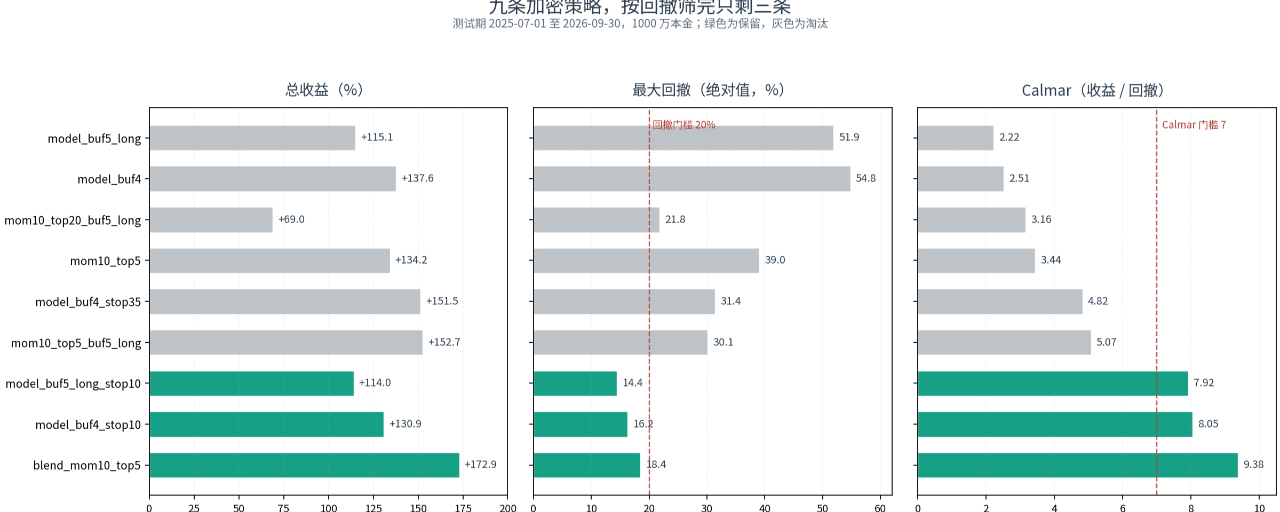
图 1:左边是收益,中间是最大回撤,右边是 Calmar,绿色保留,灰色淘汰。虚线是回撤 20% 和 Calmar 7 的门槛。
分界线很清楚。保留的三条 Calmar 都在 7.9 以上,Ulcer 不超过 7.6,水下天数不超过 107。淘汰的六条 Calmar 最高 5.07,Ulcer 最低 6.92。
注意 mom10 top20 这一条。它的回撤 -21.81%,只超门槛 1.8 个百分点;Ulcer 6.92,在 8 以内;水下 109 天,刚好在 110 以内。单看这三个指标,它离合格不远。但 Calmar 只有 3.16,收益被稀释得太厉害,还是过不了。
五、六条为什么被删
一条一条说。
模型 buf4,+137.55%,回撤 -54.80%。这是模型信号加双边 buffer4 的版本。buffer 把收益从负的做到 +137%,但回撤仍在 -54.80%;再调 buffer 档位,回撤几乎不动。这条最能说明 buffer 单独当不了风控:它改善的是换手和排名稳定性,压不住尾部。
模型多头 buf5,+115.08%,回撤 -51.89%。把多头 buffer 设成 5、空头不加 buffer,回撤只从 -54.80% 变到 -51.89%。Ulcer 25.96、水下 232 天,两项都是九条里最差。
模型 buf4 止损35,+151.47%,回撤 -31.42%。收益排第三,听起来应该留下。但回撤超过 30%,Calmar 4.82,水下 123 天。35% 的单币止损,对加密这种波动来说太松了,触发的时候已经亏了很多。
mom10 top5 多头 buf5,+152.67%,回撤 -30.13%。这是九条里收益第二高的策略,也是被删的六条里收益最高的。问题一样:回撤 30%,水下 171 天。收益排第二,照样过不了回撤这一关。
mom10 top5,+134.22%,回撤 -39.03%。纯动量 top5,没有 buffer,没有止损。动量因子的尾部本来就重,单日最差 -13.10%。
mom10 top20 多头 buf5,+68.98%,回撤 -21.81%。这是被删的六条里回撤最浅的一条。但 Calmar 只有 3.16,收益被分散稀释了一半。它证明的是另一件事:把仓位摊薄,不会让策略变好,只会让它变小。
六、三个能带走的结论
第一,止损是控回撤的第一杠杆,buffer 不是。
同一族模型信号,先固定对称 buffer4,做三组对照。什么都不加:+137.55%,回撤 -54.80%。加 35% 单币止损:+151.47%,回撤 -31.42%。加 10% 单币止损:+130.86%,回撤 -16.25%。再把 buffer 换成多头 5、空头 0,不加止损:回撤 -51.89%,几乎没变。
四条曲线放在一起,结论没有歧义。想压回撤,先上止损;buffer 主要管换手和排名稳定性,压不住尾部。
第二,触发次数少,不等于风险小。
35% 止损在测试期触发 121 次,10% 止损触发 646 次。看起来 35% 更省心,但回撤是 -31.42% 对 -16.25%。原因不复杂:触发少,是因为每次要亏到 35% 才砍,单次损失大;触发多,是因为亏 10% 就砍,单次损失小。评估止损不能只看触发次数,要看单次损失乘上压力窗口里可能连续触发几次。
先估压力窗口里会连续触发几次,再定阈值。10% 是在小损失时就切断,35% 更像心理止损,告诉自己“我已经设了止损”,但真到触发时,账户已经伤得不轻。
第三,分散只是等比例缩小,不提高风险调整后的效率。
mom10 top5 换成 top20,再加多头 buffer5:年化波动从 63.1% 降到 29.6%,回撤从 -39.03% 降到 -21.81%。看起来风险降了一半。但收益从 134.22% 掉到 68.98%,Calmar 从 3.44 降到 3.16。收益和风险一起缩小,效率反而更差。
如果目标是降风险,直接降杠杆更干净。分散适合解决“单币仓位太重”,不适合当成提高夏普的工具。
还有一条更朴素的:收益排名会骗人。按收益排,stop35 第三、mom10 多头 buf5 第二,都该留下;按 Calmar 和回撤排,它们连门槛都过不了。选策略先看能不能拿住,再看能赚多少。
七、留下的三条,是三个风险档位
| 策略 | 定位 | 收益 | 最大回撤 | Calmar | 夏普 | Ulcer | 水下天数 |
|---|---|---:|---:|---:|---:|---:|---:|
| 融合 top5 | 收益最高,无止损 | +172.93% | -18.44% | 9.38 | 2.076 | 7.59 | 107 |
| 模型 buf4 止损10 | 收益回撤均衡 | +130.86% | -16.25% | 8.05 | 1.906 | 6.10 | 96 |
| 模型 多头buf5 止损10 | 回撤最小,曲线最平滑 | +114.01% | -14.39% | 7.92 | 1.846 | 4.84 | 75 |
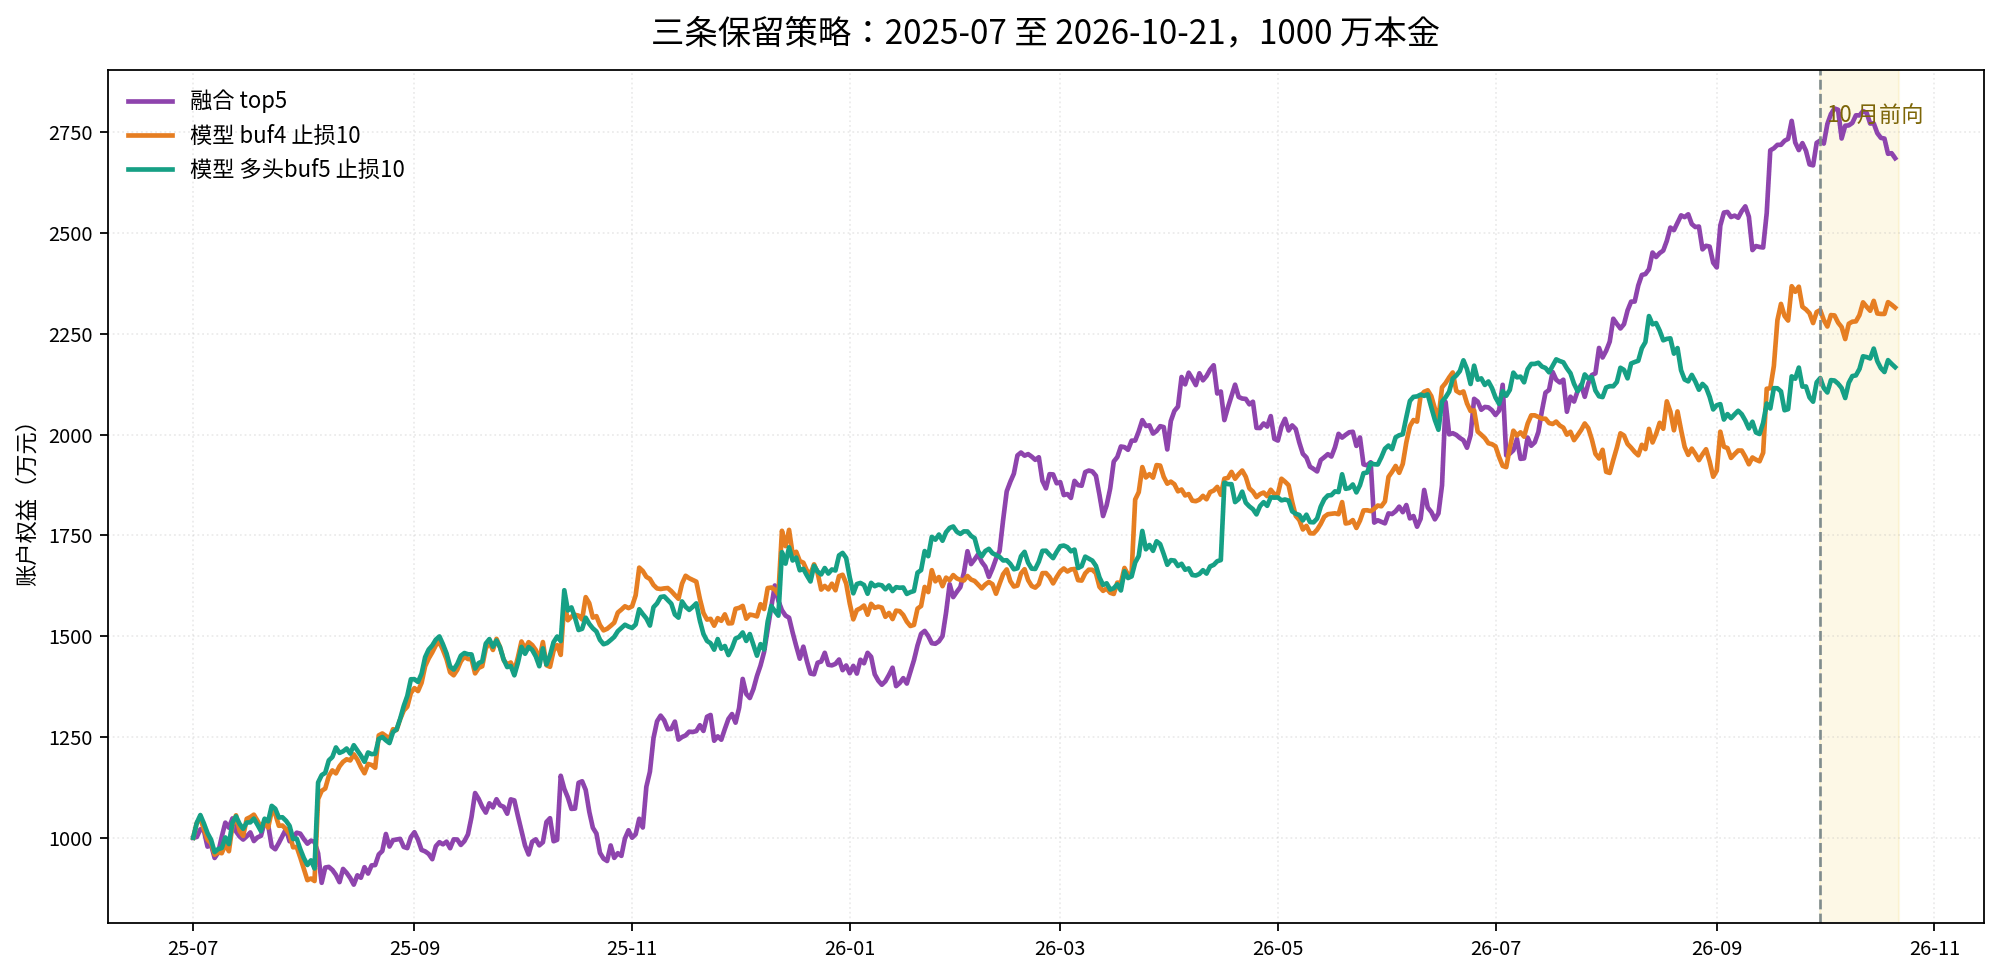
图 2:三条策略从 2025 年 7 月跑到 2026 年 10 月 21 日,1000 万本金。虚线右边是 10 月前向段。
这三条不是“同类里挑三个最好的”,是三种风险档位。
融合 top5 收益最高,风险调整后也最好,但它没有止损。10 月下跌月,它的回撤是三条里最深的,原因就在这里。上一期说好要给融合加止损,这期没做,后面会讲为什么。
模型 buf4 止损10 是中间档。双边 buffer4,加上 10% 单币止损,收益和回撤比较均衡。
模型多头 buf5 止损10 是防守档。多头 buffer5、空头不加 buffer,再加 10% 止损。回撤最小,Ulcer 4.84,水下只有 75 天,曲线最平滑,收益也最低。
如果只能选一条,要看资金属性和回撤容忍度。能扛 -20% 回撤、追求收益,选融合;要平滑,选多头 buf5 止损10;两者之间选 buf4 止损10。这是取舍,不是排名。
## 八、10 月前向:止损第一次在前向数据上起了作用
模型是冻结的。重训后 `best_iteration` 仍是 290,测试段预测和上一期发布的文件最大差 0.0,10 月的信号没有重新调参。
10 月 1 日到 21 日,信号池 122 个合约等权下跌 8.57%,中位数下跌 9.82%。$BTC 涨 0.57%,$ETH 跌 7.89%,$SOL 跌 9.45%。山寨普跌、BTC 横盘。
三条策略的结果:
| 策略 | 10 月盈亏 | 对 9/30 权益 | 对 1000 万 | 最大回撤 | 止损次数 | 多头/空头 |
|---|---:|---:|---:|---:|---:|---:|
| 模型 多头buf5 止损10 | +27.1 万 | +1.26% | +2.71% | -2.63% | 24 | +25.5 / +1.5 万 |
| 模型 buf4 止损10 | +6.1 万 | +0.27% | +0.61% | -3.11% | 22 | +6.1 / +0.1 万 |
| 融合 top5 | -43.9 万 | -1.61% | -4.39% | -4.39% | 0 | -53.7 / +9.8 万 |
收益口径有两个,都列出来。对 9/30 权益,是因为测试期已经复利,三条策略的权益在 2140 万到 2729 万之间;对 1000 万,是因为策略下单规模一直按 1000 万算,不随权益复利。前者是账户实际收益率,后者更接近策略本身的赚钱能力。21 天的数字不要按比例年化。
下跌月里,两条 stop10 都保住了正收益。融合没有止损,多头腿亏了 53.7 万,最差一天 -71.2 万,亏损直接落到净值上。这是三条策略分化的直接原因,也是止损第一次在前向数据上证明自己。
但 21 天太短,不能说明长期。而且这个正收益有几处水分,要挤掉。
第一,收益很集中。两条 stop10 持仓高度重合,GTC 一只赚 60.3 万,MAGMA 赚 22.9 万,AKE 赚 20.1 万。buf4 最好的一天赚 37.9 万,占全部正收益的 21.9%,最好三天占 56.9%。日胜率只有 38.1%,中位日亏 1.1 万。也就是说,正收益靠少数大阳日和少数合约,不能按“平均每天赚多少”去外推。
第二,仓位没有打满。每条策略 10 个仓位里有 1 个死仓:两条 stop10 是 OMNI 的空头,融合是 VANRY 的空头,合约退市后一直没平掉,占着 100 万名义敞口但不产生盈亏。两条模型策略 10 月的平均活跃名义敞口只有 647 到 657 万,融合是 997 万。stop10 的正收益是在大约六成半仓位下拿到的。这是回测引擎的已知问题,不是这次数据更新造成的,已经列进待修清单。
第三,资金费没有算进主回测。事后按日末持仓估算,融合收 7.2 万,两条 stop10 各付 8.8 到 8.9 万,对 1000 万都在 1 个百分点以内。方向清楚,但这不是精确成本。
第四,IC 强,不等于尾部能赚钱。前向 20 日 IC 均值 0.0760,90% 的交易日为正,位于测试期滚动窗口的 91.1 分位。但把同一个分数换成原始 2 日收益来排序,10 月的截面并不单调:按策略实际选币口径,p5 多头前五平均 -3.59%/2 日,p0 空头后五 -0.49%/2 日,多空价差 -3.10%,t 值 -2.07。模型排的是按波动归一后的 2 日收益标签,不等于原始收益的尾部预测。10 月的 p5 多头尾部主要被 10 月 4 日和 10 月 19 日两个暴跌日拖累,策略靠 buffer、止损、空头腿和少数赢家把结果拉回来。尾部诊断只有 19 个信号日,样本太短,只能得出“继续观察”,不能据此判断模型失效,更不能加杠杆。
## 九、最不舒服的一段:2% 止损滑点
回测假设止损能在止损价附近成交。把止损滑点加到 2% 重跑:
| 策略 | 基准盈亏 | 2% 滑点盈亏 | 基准权益收益 | 2% 滑点权益收益 | 基准回撤 | 2% 滑点回撤 |
|---|---:|---:|---:|---:|---:|---:|
| 模型 buf4 止损10 | +6.1 万 | -38.5 万 | +0.27% | -3.80% | -3.11% | -8.85% |
| 模型 多头buf5 止损10 | +27.1 万 | -21.9 万 | +1.26% | -2.65% | -2.63% | -7.93% |
正收益直接没了。
这个结果可以用算术解释。每触发一次止损,对应一个 100 万的仓位,2% 滑点就是 2 万。10 月触发 22 到 24 次,合计四五十万,足以把 +6 万和 +27 万打成负数。
反过来看,这也说明 stop10 的收益来源不是“选币更准”,而是“亏损截断得早”。一旦止损成交质量变差,这个优势会迅速消失。
2% 是压力测试,不是预测。真实滑点可能更小,也可能更大,取决于币的流动性、止损单类型和当时的行情。但在用真实盘口和成交量验证之前,两条 stop10 策略的正收益只能算纸面上的。
这也是为什么这期没给融合加止损。上一期说过,带止损的策略只支持 p5/p0 选币,融合选币要先把分数接口抽出来。更要紧的是,如果 stop10 的成交质量还没验证,就给融合套一个同样依赖成交的止损,等于把同一个问题复制一份。先解决成交,再加功能。
十、清理、边界和下一期
六条策略的文件和回测结果已经删掉:6 个策略 py、6 份测试期回测、6 份 10 月回测、6 份根目录回测结果,一共 24 个文件。删之前备份到了临时目录 `/tmp/eliminated_strategies_2026-10-22/`,机器重启会没,长期记录以仓库里的 `策略筛选记录.md` 为准。逐日净值 parquet 没有单独备份。
为什么不留着?因为留下来的文件会继续以“候选策略”的身份存在。过两周回来,看到九条策略,很容易在一条已经证明回撤过大的策略上继续调参。删除是治理动作,不是洁癖。
同步做的清理:notebook 从九条改成三条,重跑通过;测试期和前向汇总各 3 行;10 月明细 CSV 也是 3 行;报告重写成三策略版本;筛选记录里写清每一条的淘汰数字和理由。
边界也要说清楚。筛选标准是事后定的;测试期已经用于选参,457 天不是干净样本外;10 月只有 21 天;主回测是日线,不含资金费、强平、保证金和真实滑点;止损是日线事后近似。这些限制不会因为结果好看就消失。
下一期按顺序做三件事。第一,解决 stop10 的成交质量:真实盘口、分层滑点、止损单类型,至少要给出一个可信的滑点区间。第二,修死仓问题,重跑 10 月,看有效敞口补齐后结果怎么变。第三,再回到融合加止损和 walk-forward。如果 stop10 的成交质量过不了关,两条模型的保留策略要重新设计,不能靠回测里的止损价活着。另外还有一个名单误杀要复核:GRAM 被静态非加密名单排除,但它其实是加密永续。
本文是回测研究记录,不是交易信号,也不构成投资建议。这个量化实验室会继续公开记录,从数据、因子到风控。觉得有用可以收藏,下一期见。