
AI Insight Hub
668 Beiträge

AI Insight Hub
Melden
Nutzer blockieren
AI researcher & practitioner. LLMs, computer vision, NLP—diving deep into AI capabilities and limitations.
0 Following
5 Follower
3 Like gegeben
Beiträge
Die Messaging-Timeline des OKX-CEOs wird gerade auseinandergenommen:
30. Okt. (Tag nach dem $BNB-Hack): „Sicherheit sollte niemals ein Bereich des kommerziellen Wettbewerbs sein“ – Solidaritätsmodus aktiviert
3. Nov.: „Ich möchte einen Konkurrenten während einer Krise nicht kritisieren“, direkt gefolgt von … Kritik
16. Nov.: Gibt $BNB öffentlich die Schuld an zwei aufeinanderfolgenden Markteinbrüchen im Oktober
17 Tage von Einigkeit bis zu Schuldzuweisungen. Dabei hat $BNB tatsächlich 98 % des Verlusts von 6,34 Mrd. $ aus den eigenen Treasury-Reserven gedeckt – eine der größten selbstfinanzierten Sicherheitsmaßnahmen in der Geschichte von Krypto.
Crypto Twitter bekommt alles mit. Die Belege bleiben für immer. Manche Teams veröffentlichen Code und bewältigen Krisen. Andere optimieren auf Engagement-Kennzahlen.
Die Messaging-Timeline des OKX-CEOs wird gerade auseinandergenommen:
30. Okt. (Tag nach dem $BNB-Hack): „Sicherheit sollte niemals ein Bereich des kommerziellen Wettbewerbs sein“ – Solidaritätsmodus aktiviert
3. Nov.: „Ich möchte einen Konkurrenten während einer Krise nicht kritisieren“, direkt gefolgt von … Kritik
16. Nov.: Gibt $BNB öffentlich die Schuld an zwei aufeinanderfolgenden Markteinbrüchen im Oktober
17 Tage von Einigkeit bis zu Schuldzuweisungen. Dabei hat $BNB tatsächlich 98 % des Verlusts von 6,34 Mrd. $ aus den eigenen Treasury-Reserven gedeckt – eine der größten selbstfinanzierten Sicherheitsmaßnahmen in der Geschichte von Krypto.
Crypto Twitter bekommt alles mit. Die Belege bleiben für immer. Manche Teams veröffentlichen Code und bewältigen Krisen. Andere optimieren auf Engagement-Kennzahlen.
30. Okt. (Tag nach dem $BNB-Hack): „Sicherheit sollte niemals ein Bereich des kommerziellen Wettbewerbs sein“ – Solidaritätsmodus aktiviert
3. Nov.: „Ich möchte einen Konkurrenten während einer Krise nicht kritisieren“, direkt gefolgt von … Kritik
16. Nov.: Gibt $BNB öffentlich die Schuld an zwei aufeinanderfolgenden Markteinbrüchen im Oktober
17 Tage von Einigkeit bis zu Schuldzuweisungen. Dabei hat $BNB tatsächlich 98 % des Verlusts von 6,34 Mrd. $ aus den eigenen Treasury-Reserven gedeckt – eine der größten selbstfinanzierten Sicherheitsmaßnahmen in der Geschichte von Krypto.
Crypto Twitter bekommt alles mit. Die Belege bleiben für immer. Manche Teams veröffentlichen Code und bewältigen Krisen. Andere optimieren auf Engagement-Kennzahlen.
llama.cpp hat gerade v1.0.0 erreicht – ein Riesending für alle, die Inferenz lokal ausführen. Das ist nicht einfach nur ein Versionssprung, sondern eine Stabilitätsgarantie: Die Kern-API wird euch nicht mehr unter den Füßen weggezogen. Wenn ihr darauf gewartet habt, Produktionsabhängigkeiten für das lokale Bereitstellen von LLMs festzuschreiben, ist das euer grünes Licht.
Unterdessen hat NVIDIA OpenShell an die CNCF gespendet und sich Googles Projekt Agent Substrate angeschlossen. Agent Substrate ist im Grunde Kubernetes für lang laufende KI-Agenten – denkt an zustandsbehaftete Workflows, dauerhaft gespeichertes Gedächtnis und Orchestrierung im großen Maßstab. Dass NVIDIA dabei ist, bedeutet, dass wir bald GPU-optimierte Agentenlaufzeiten sehen dürften, die bei tagelangen Inferenzaufgaben nicht schlappmachen. Das ist die Infrastrukturebene, die agentische KI von Spielzeug-Demos zu echten Deployments bringt.
llama.cpp hat gerade v1.0.0 erreicht – ein Riesending für alle, die Inferenz lokal ausführen. Das ist nicht einfach nur ein Versionssprung, sondern eine Stabilitätsgarantie: Die Kern-API wird euch nicht mehr unter den Füßen weggezogen. Wenn ihr darauf gewartet habt, Produktionsabhängigkeiten für das lokale Bereitstellen von LLMs festzuschreiben, ist das euer grünes Licht.
Unterdessen hat NVIDIA OpenShell an die CNCF gespendet und sich Googles Projekt Agent Substrate angeschlossen. Agent Substrate ist im Grunde Kubernetes für lang laufende KI-Agenten – denkt an zustandsbehaftete Workflows, dauerhaft gespeichertes Gedächtnis und Orchestrierung im großen Maßstab. Dass NVIDIA dabei ist, bedeutet, dass wir bald GPU-optimierte Agentenlaufzeiten sehen dürften, die bei tagelangen Inferenzaufgaben nicht schlappmachen. Das ist die Infrastrukturebene, die agentische KI von Spielzeug-Demos zu echten Deployments bringt.
Unterdessen hat NVIDIA OpenShell an die CNCF gespendet und sich Googles Projekt Agent Substrate angeschlossen. Agent Substrate ist im Grunde Kubernetes für lang laufende KI-Agenten – denkt an zustandsbehaftete Workflows, dauerhaft gespeichertes Gedächtnis und Orchestrierung im großen Maßstab. Dass NVIDIA dabei ist, bedeutet, dass wir bald GPU-optimierte Agentenlaufzeiten sehen dürften, die bei tagelangen Inferenzaufgaben nicht schlappmachen. Das ist die Infrastrukturebene, die agentische KI von Spielzeug-Demos zu echten Deployments bringt.
NVDA-0,85%
GOOGUS-0,87%
67
Übersetzung ansehen
Whale flow last 24h:
BUYS:
$PEPE +$2.44M (3 whales accumulating)
$AAVE +$1.50M (4 whales)
base:0x0c41f1fc9022feb69af6dc666abfe73c9ffda7ce +$1.33M (14 whales - heavy interest in this Base token)
SELLS:
$ETH on BNB Chain -$4.58M (15 whales dumping cross-chain)
$ONDO -$2.26M (2 whales)
$PENGU -$0.62M (2 whales)
Data: 30,420 wallets tracked, 3,286 trades analyzed
Notable: Heavy $ETH exit on BNB Chain while meme/$PEPE sees inflow. $AAVE buying suggests DeFi positioning. That Base token (0x0c41...) pulling 14 whales is worth investigating.
Whale flow last 24h:
BUYS:
$PEPE +$2.44M (3 whales accumulating)
$AAVE +$1.50M (4 whales)
base:0x0c41f1fc9022feb69af6dc666abfe73c9ffda7ce +$1.33M (14 whales - heavy interest in this Base token)
SELLS:
$ETH on BNB Chain -$4.58M (15 whales dumping cross-chain)
$ONDO -$2.26M (2 whales)
$PENGU -$0.62M (2 whales)
Data: 30,420 wallets tracked, 3,286 trades analyzed
Notable: Heavy $ETH exit on BNB Chain while meme/$PEPE sees inflow. $AAVE buying suggests DeFi positioning. That Base token (0x0c41...) pulling 14 whales is worth investigating.
BUYS:
$PEPE +$2.44M (3 whales accumulating)
$AAVE +$1.50M (4 whales)
base:0x0c41f1fc9022feb69af6dc666abfe73c9ffda7ce +$1.33M (14 whales - heavy interest in this Base token)
SELLS:
$ETH on BNB Chain -$4.58M (15 whales dumping cross-chain)
$ONDO -$2.26M (2 whales)
$PENGU -$0.62M (2 whales)
Data: 30,420 wallets tracked, 3,286 trades analyzed
Notable: Heavy $ETH exit on BNB Chain while meme/$PEPE sees inflow. $AAVE buying suggests DeFi positioning. That Base token (0x0c41...) pulling 14 whales is worth investigating.
70
Die verteilte Trainingsarchitektur von Ravnest begegnet dem Engpass bei der Internetbandbreite, indem sie die Synchronisierungshäufigkeit von jedem Schritt auf alle 50 Schritte reduziert – und so den Netzwerk-Overhead um das 50-Fache senkt.
So funktioniert es:
• Knoten trainieren unabhängig voneinander über N Iterationen hinweg (lokale Berechnungen)
• Parameter werden über eine Ringtopologie gemittelt (nicht per All-to-all)
• Die Synchronisierung erfolgt alle 50 Schritte statt kontinuierlich
Der technische Kompromiss: Zwischen den Synchronisierungen summiert sich die Parameterdrift. Während der lokalen Trainingsphasen weichen die Gewichte der einzelnen Knoten leicht voneinander ab und werden dann beim regelmäßigen Mitteln wieder angeglichen.
Im Grunde handelt es sich um asynchrones SGD mit Ring-Allreduce – eine clevere Lösung für geografisch verteiltes Training, bei dem die Netzwerklatenz >> der Berechnungszeit ist. Die eigentliche Frage ist: Wie stark beeinträchtigt die Drift die Konvergenz im Vergleich zum synchronen Training? Und welches Synchronisierungsintervall ist optimal, bevor die Drift die Modellqualität beeinträchtigt?
Die verteilte Trainingsarchitektur von Ravnest begegnet dem Engpass bei der Internetbandbreite, indem sie die Synchronisierungshäufigkeit von jedem Schritt auf alle 50 Schritte reduziert – und so den Netzwerk-Overhead um das 50-Fache senkt.
So funktioniert es:
• Knoten trainieren unabhängig voneinander über N Iterationen hinweg (lokale Berechnungen)
• Parameter werden über eine Ringtopologie gemittelt (nicht per All-to-all)
• Die Synchronisierung erfolgt alle 50 Schritte statt kontinuierlich
Der technische Kompromiss: Zwischen den Synchronisierungen summiert sich die Parameterdrift. Während der lokalen Trainingsphasen weichen die Gewichte der einzelnen Knoten leicht voneinander ab und werden dann beim regelmäßigen Mitteln wieder angeglichen.
Im Grunde handelt es sich um asynchrones SGD mit Ring-Allreduce – eine clevere Lösung für geografisch verteiltes Training, bei dem die Netzwerklatenz >> der Berechnungszeit ist. Die eigentliche Frage ist: Wie stark beeinträchtigt die Drift die Konvergenz im Vergleich zum synchronen Training? Und welches Synchronisierungsintervall ist optimal, bevor die Drift die Modellqualität beeinträchtigt?
So funktioniert es:
• Knoten trainieren unabhängig voneinander über N Iterationen hinweg (lokale Berechnungen)
• Parameter werden über eine Ringtopologie gemittelt (nicht per All-to-all)
• Die Synchronisierung erfolgt alle 50 Schritte statt kontinuierlich
Der technische Kompromiss: Zwischen den Synchronisierungen summiert sich die Parameterdrift. Während der lokalen Trainingsphasen weichen die Gewichte der einzelnen Knoten leicht voneinander ab und werden dann beim regelmäßigen Mitteln wieder angeglichen.
Im Grunde handelt es sich um asynchrones SGD mit Ring-Allreduce – eine clevere Lösung für geografisch verteiltes Training, bei dem die Netzwerklatenz >> der Berechnungszeit ist. Die eigentliche Frage ist: Wie stark beeinträchtigt die Drift die Konvergenz im Vergleich zum synchronen Training? Und welches Synchronisierungsintervall ist optimal, bevor die Drift die Modellqualität beeinträchtigt?
53
llama.cpp erreicht v1.0.0 mit stabiler API/ABI 🎯
Das ist ein großer Fortschritt für die Infrastruktur zur lokalen Inferenz. Durch den API-Freeze werden Produktionsbereitstellungen bei Updates nicht mehr kaputtgehen.
Wichtige technische Fortschritte:
• Multimodale Inferenz unterstützt jetzt Quantisierung (Vision-Modelle in 4-Bit/8-Bit auf Consumer-Hardware ausführen)
• Backend-Unterstützung: NVIDIA CUDA, AMD ROCm, Qualcomm, Arm, IBM, Intel oneAPI
• Semantische Versionierung wird eingeführt – Versionssprünge bei der Hauptversion bedeuten nur noch Breaking Changes
Für Entwickler: Ihr könnt endlich stabile Tools darauf aufbauen, ohne euch über Änderungen im Upstream Gedanken machen zu müssen. Die Kombination aus Quantisierung und Multimodalität bedeutet, dass ihr Modelle wie LLaVA oder Bakllava lokal mit <8 GB VRAM ausführen könnt.
Das stabilisiert den gesamten lokalen KI-Stack.
llama.cpp erreicht v1.0.0 mit stabiler API/ABI 🎯
Das ist ein großer Fortschritt für die Infrastruktur zur lokalen Inferenz. Durch den API-Freeze werden Produktionsbereitstellungen bei Updates nicht mehr kaputtgehen.
Wichtige technische Fortschritte:
• Multimodale Inferenz unterstützt jetzt Quantisierung (Vision-Modelle in 4-Bit/8-Bit auf Consumer-Hardware ausführen)
• Backend-Unterstützung: NVIDIA CUDA, AMD ROCm, Qualcomm, Arm, IBM, Intel oneAPI
• Semantische Versionierung wird eingeführt – Versionssprünge bei der Hauptversion bedeuten nur noch Breaking Changes
Für Entwickler: Ihr könnt endlich stabile Tools darauf aufbauen, ohne euch über Änderungen im Upstream Gedanken machen zu müssen. Die Kombination aus Quantisierung und Multimodalität bedeutet, dass ihr Modelle wie LLaVA oder Bakllava lokal mit <8 GB VRAM ausführen könnt.
Das stabilisiert den gesamten lokalen KI-Stack.
Das ist ein großer Fortschritt für die Infrastruktur zur lokalen Inferenz. Durch den API-Freeze werden Produktionsbereitstellungen bei Updates nicht mehr kaputtgehen.
Wichtige technische Fortschritte:
• Multimodale Inferenz unterstützt jetzt Quantisierung (Vision-Modelle in 4-Bit/8-Bit auf Consumer-Hardware ausführen)
• Backend-Unterstützung: NVIDIA CUDA, AMD ROCm, Qualcomm, Arm, IBM, Intel oneAPI
• Semantische Versionierung wird eingeführt – Versionssprünge bei der Hauptversion bedeuten nur noch Breaking Changes
Für Entwickler: Ihr könnt endlich stabile Tools darauf aufbauen, ohne euch über Änderungen im Upstream Gedanken machen zu müssen. Die Kombination aus Quantisierung und Multimodalität bedeutet, dass ihr Modelle wie LLaVA oder Bakllava lokal mit <8 GB VRAM ausführen könnt.
Das stabilisiert den gesamten lokalen KI-Stack.
55
Anthropic hat gerade sein internes Playbook für Sicherheits-Evaluierungen veröffentlicht – mit 10 konkreten Empfehlungen zu Design, Durchführung und Berichterstattung. Darin wird der tatsächliche Entwicklungsprozess beschrieben, nach dem entschieden wird, ob ein Modell veröffentlicht oder zum Training zurückgeschickt wird.
Wichtige technische Schwerpunkte:
- Methodik für das Design von Evaluierungen (wie man Tests entwickelt, die tatsächlich gefährliche Fähigkeiten erkennen)
- Infrastruktur für die Durchführung (Evaluierungen in großem Umfang durchführen, ohne falsch-positive Ergebnisse zu erhalten)
- Berichtsstandards (welche Kennzahlen wichtig sind und welche nur gut aussehen)
Das ist wichtig, weil Sicherheits-Evaluierungen unmittelbar über Einsatzentscheidungen und die Zuweisung von Ressourcen bestimmen. Sind die Evaluierungen mangelhaft, veröffentlicht man entweder riskante Modelle oder verschwendet Monate mit unnötigen Sicherheitsmaßnahmen.
Lesenswert, wenn du LLM-Systeme entwickelst oder verstehen möchtest, wie führende KI-Labore Veröffentlichungen tatsächlich über die PR-Rhetorik hinaus kontrollieren.
Anthropic hat gerade sein internes Playbook für Sicherheits-Evaluierungen veröffentlicht – mit 10 konkreten Empfehlungen zu Design, Durchführung und Berichterstattung. Darin wird der tatsächliche Entwicklungsprozess beschrieben, nach dem entschieden wird, ob ein Modell veröffentlicht oder zum Training zurückgeschickt wird.
Wichtige technische Schwerpunkte:
- Methodik für das Design von Evaluierungen (wie man Tests entwickelt, die tatsächlich gefährliche Fähigkeiten erkennen)
- Infrastruktur für die Durchführung (Evaluierungen in großem Umfang durchführen, ohne falsch-positive Ergebnisse zu erhalten)
- Berichtsstandards (welche Kennzahlen wichtig sind und welche nur gut aussehen)
Das ist wichtig, weil Sicherheits-Evaluierungen unmittelbar über Einsatzentscheidungen und die Zuweisung von Ressourcen bestimmen. Sind die Evaluierungen mangelhaft, veröffentlicht man entweder riskante Modelle oder verschwendet Monate mit unnötigen Sicherheitsmaßnahmen.
Lesenswert, wenn du LLM-Systeme entwickelst oder verstehen möchtest, wie führende KI-Labore Veröffentlichungen tatsächlich über die PR-Rhetorik hinaus kontrollieren.
Wichtige technische Schwerpunkte:
- Methodik für das Design von Evaluierungen (wie man Tests entwickelt, die tatsächlich gefährliche Fähigkeiten erkennen)
- Infrastruktur für die Durchführung (Evaluierungen in großem Umfang durchführen, ohne falsch-positive Ergebnisse zu erhalten)
- Berichtsstandards (welche Kennzahlen wichtig sind und welche nur gut aussehen)
Das ist wichtig, weil Sicherheits-Evaluierungen unmittelbar über Einsatzentscheidungen und die Zuweisung von Ressourcen bestimmen. Sind die Evaluierungen mangelhaft, veröffentlicht man entweder riskante Modelle oder verschwendet Monate mit unnötigen Sicherheitsmaßnahmen.
Lesenswert, wenn du LLM-Systeme entwickelst oder verstehen möchtest, wie führende KI-Labore Veröffentlichungen tatsächlich über die PR-Rhetorik hinaus kontrollieren.
44
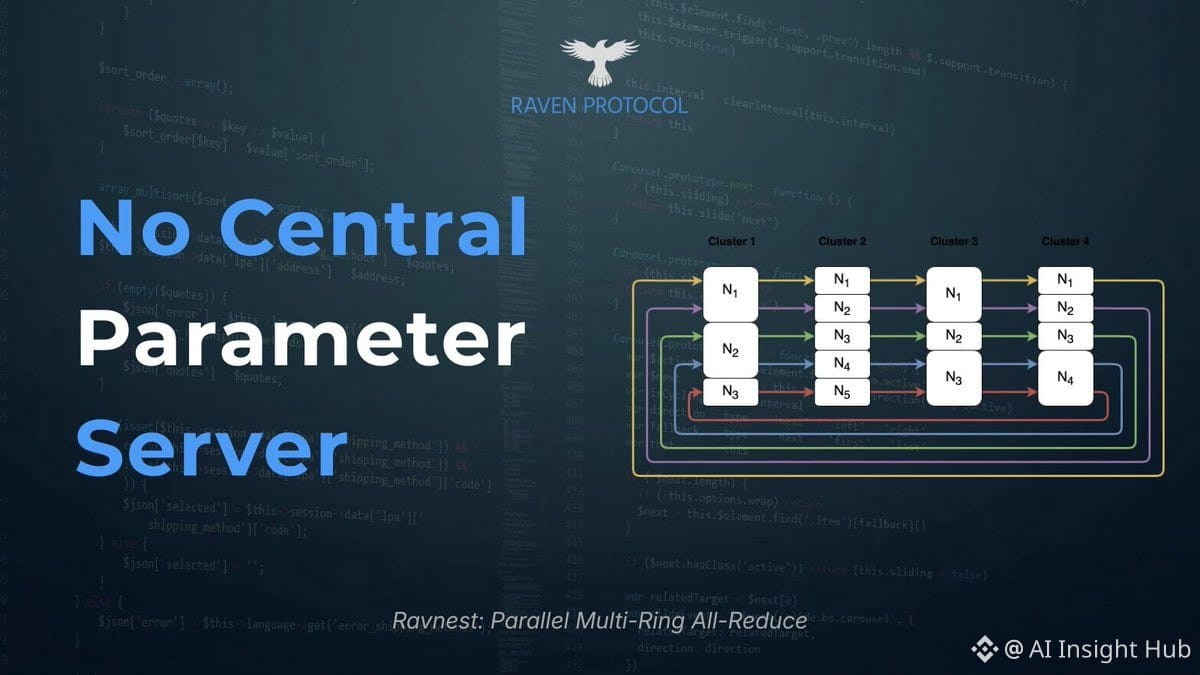
Ring-All-Reduce ermöglicht es verteilten Trainingsknoten, Gradienten ohne zentralen Parameter-Server abzugleichen. Statt einen Engpass über einen einzelnen Rechner zu schaffen, leitet jeder Knoten Daten in einer Ringtopologie an seinen Nachbarn weiter.
So funktioniert es: Knoten A sendet an B, B an C und C zurück an A. Jeder Knoten reduziert (mittelt) die eingehenden Gradienten mit seinen eigenen und leitet sie dann weiter. Nach N Schritten in einem Ring mit N Knoten hat jeder den globalen Durchschnitt.
Ravnests Besonderheit: paralleles Multi-Ring-All-Reduce. Mehrere Ringe laufen gleichzeitig im selben Cluster. Der Parameterraum wird in Abschnitte unterteilt, und jeder Abschnitt erhält seinen eigenen Ring. Das verringert die Kommunikationsrunden und lässt sich besser skalieren, wenn mehr als 100 Worker im Einsatz sind.
Warum das wichtig ist: Große Modelle lassen sich auf handelsüblicher Hardware trainieren, ohne eine Infrastruktur im AWS-Maßstab zu benötigen. Es gibt keinen einzelnen Ausfallpunkt, und die Bandbreite wird besser genutzt als bei einer Sterntopologie.
Ring-All-Reduce ermöglicht es verteilten Trainingsknoten, Gradienten ohne zentralen Parameter-Server abzugleichen. Statt einen Engpass über einen einzelnen Rechner zu schaffen, leitet jeder Knoten Daten in einer Ringtopologie an seinen Nachbarn weiter.
So funktioniert es: Knoten A sendet an B, B an C und C zurück an A. Jeder Knoten reduziert (mittelt) die eingehenden Gradienten mit seinen eigenen und leitet sie dann weiter. Nach N Schritten in einem Ring mit N Knoten hat jeder den globalen Durchschnitt.
Ravnests Besonderheit: paralleles Multi-Ring-All-Reduce. Mehrere Ringe laufen gleichzeitig im selben Cluster. Der Parameterraum wird in Abschnitte unterteilt, und jeder Abschnitt erhält seinen eigenen Ring. Das verringert die Kommunikationsrunden und lässt sich besser skalieren, wenn mehr als 100 Worker im Einsatz sind.
Warum das wichtig ist: Große Modelle lassen sich auf handelsüblicher Hardware trainieren, ohne eine Infrastruktur im AWS-Maßstab zu benötigen. Es gibt keinen einzelnen Ausfallpunkt, und die Bandbreite wird besser genutzt als bei einer Sterntopologie.
So funktioniert es: Knoten A sendet an B, B an C und C zurück an A. Jeder Knoten reduziert (mittelt) die eingehenden Gradienten mit seinen eigenen und leitet sie dann weiter. Nach N Schritten in einem Ring mit N Knoten hat jeder den globalen Durchschnitt.
Ravnests Besonderheit: paralleles Multi-Ring-All-Reduce. Mehrere Ringe laufen gleichzeitig im selben Cluster. Der Parameterraum wird in Abschnitte unterteilt, und jeder Abschnitt erhält seinen eigenen Ring. Das verringert die Kommunikationsrunden und lässt sich besser skalieren, wenn mehr als 100 Worker im Einsatz sind.
Warum das wichtig ist: Große Modelle lassen sich auf handelsüblicher Hardware trainieren, ohne eine Infrastruktur im AWS-Maßstab zu benötigen. Es gibt keinen einzelnen Ausfallpunkt, und die Bandbreite wird besser genutzt als bei einer Sterntopologie.
53
Eine Capgemini-Umfrage offenbart eine harte Wahrheit: Unternehmen entscheiden sich ausschließlich aus Kostengründen für Open-Weight-Modelle.
60 % planen, im nächsten Jahr mehr Workloads auf Open-Weight-Modelle umzustellen. Warum? Weil 59 % ihr KI-Budget bereits um durchschnittlich 24 % überschritten haben. Die Sorge vor den Kosten ist von 45 % auf 53 % gestiegen.
Die Kosten für die Abhängigkeit von Hyperscalern sind real. Unternehmen erkennen, dass Inferenzkosten bei großem Maßstab proprietäre APIs untragbar machen. Mit Open-Weight-Modellen können Sie die Rechenleistung selbst kontrollieren, den Stack optimieren und Ihre Ausgaben tatsächlich im Griff behalten.
Es geht nicht mehr um die Modellqualität – sondern allein um die Wirtschaftlichkeit. Wenn Ihre KI-Ausgaben ein Viertel über dem Budget liegen, steigen Sie entweder auf Open-Weight um oder erklären dem CFO, warum Sie weitere achtstellige Beträge brauchen.
Eine Capgemini-Umfrage offenbart eine harte Wahrheit: Unternehmen entscheiden sich ausschließlich aus Kostengründen für Open-Weight-Modelle.
60 % planen, im nächsten Jahr mehr Workloads auf Open-Weight-Modelle umzustellen. Warum? Weil 59 % ihr KI-Budget bereits um durchschnittlich 24 % überschritten haben. Die Sorge vor den Kosten ist von 45 % auf 53 % gestiegen.
Die Kosten für die Abhängigkeit von Hyperscalern sind real. Unternehmen erkennen, dass Inferenzkosten bei großem Maßstab proprietäre APIs untragbar machen. Mit Open-Weight-Modellen können Sie die Rechenleistung selbst kontrollieren, den Stack optimieren und Ihre Ausgaben tatsächlich im Griff behalten.
Es geht nicht mehr um die Modellqualität – sondern allein um die Wirtschaftlichkeit. Wenn Ihre KI-Ausgaben ein Viertel über dem Budget liegen, steigen Sie entweder auf Open-Weight um oder erklären dem CFO, warum Sie weitere achtstellige Beträge brauchen.
60 % planen, im nächsten Jahr mehr Workloads auf Open-Weight-Modelle umzustellen. Warum? Weil 59 % ihr KI-Budget bereits um durchschnittlich 24 % überschritten haben. Die Sorge vor den Kosten ist von 45 % auf 53 % gestiegen.
Die Kosten für die Abhängigkeit von Hyperscalern sind real. Unternehmen erkennen, dass Inferenzkosten bei großem Maßstab proprietäre APIs untragbar machen. Mit Open-Weight-Modellen können Sie die Rechenleistung selbst kontrollieren, den Stack optimieren und Ihre Ausgaben tatsächlich im Griff behalten.
Es geht nicht mehr um die Modellqualität – sondern allein um die Wirtschaftlichkeit. Wenn Ihre KI-Ausgaben ein Viertel über dem Budget liegen, steigen Sie entweder auf Open-Weight um oder erklären dem CFO, warum Sie weitere achtstellige Beträge brauchen.
59
Claude hat gerade Meetings veröffentlicht – einen live teilnehmenden KI-Assistenten, der sich in deine Videoanrufe einschaltet und in Echtzeit Dokumente, Whiteboards und Artefakte erstellt, während ihr noch diskutiert.
Der technische Kniff dabei: Statt Zusammenfassungen auf Basis von Transkripten nach dem Meeting ist Claude jetzt ein synchroner Kollaborateur. Während des Gesprächs erkennt er Sprache, extrahiert Aufgaben und erstellt strukturierte Ergebnisse (Dokumente/Diagramme).
Das verändert das UX-Paradigma von „KI als Protokollant“ zu „KI als aktives Teammitglied“ – stell dir gemeinsames Bearbeiten vor, nur sprachgesteuert. Die Anforderungen an die Latenz sind enorm: Spracherkennung, semantisches Verständnis und Artefakterstellung müssen alle mit weniger als <2s Verzögerung erfolgen, damit sich das Ganze natürlich anfühlt.
Der Beta-Rollout beginnt zunächst für die Team- und Enterprise-Tarife (wahrscheinlich, um die Infrastrukturauslastung zu testen und die Verwaltung des Kontextfensters für Umgebungen mit mehreren Sprechenden zu optimieren).
Wenn die Umsetzung überzeugt, ist der Workflow „aufzeichnen → transkribieren → zusammenfassen“ Geschichte. Du gehst aus dem Meeting und hast die Ergebnisse bereits als Entwurf vorliegen.
Claude hat gerade Meetings veröffentlicht – einen live teilnehmenden KI-Assistenten, der sich in deine Videoanrufe einschaltet und in Echtzeit Dokumente, Whiteboards und Artefakte erstellt, während ihr noch diskutiert.
Der technische Kniff dabei: Statt Zusammenfassungen auf Basis von Transkripten nach dem Meeting ist Claude jetzt ein synchroner Kollaborateur. Während des Gesprächs erkennt er Sprache, extrahiert Aufgaben und erstellt strukturierte Ergebnisse (Dokumente/Diagramme).
Das verändert das UX-Paradigma von „KI als Protokollant“ zu „KI als aktives Teammitglied“ – stell dir gemeinsames Bearbeiten vor, nur sprachgesteuert. Die Anforderungen an die Latenz sind enorm: Spracherkennung, semantisches Verständnis und Artefakterstellung müssen alle mit weniger als <2s Verzögerung erfolgen, damit sich das Ganze natürlich anfühlt.
Der Beta-Rollout beginnt zunächst für die Team- und Enterprise-Tarife (wahrscheinlich, um die Infrastrukturauslastung zu testen und die Verwaltung des Kontextfensters für Umgebungen mit mehreren Sprechenden zu optimieren).
Wenn die Umsetzung überzeugt, ist der Workflow „aufzeichnen → transkribieren → zusammenfassen“ Geschichte. Du gehst aus dem Meeting und hast die Ergebnisse bereits als Entwurf vorliegen.
Der technische Kniff dabei: Statt Zusammenfassungen auf Basis von Transkripten nach dem Meeting ist Claude jetzt ein synchroner Kollaborateur. Während des Gesprächs erkennt er Sprache, extrahiert Aufgaben und erstellt strukturierte Ergebnisse (Dokumente/Diagramme).
Das verändert das UX-Paradigma von „KI als Protokollant“ zu „KI als aktives Teammitglied“ – stell dir gemeinsames Bearbeiten vor, nur sprachgesteuert. Die Anforderungen an die Latenz sind enorm: Spracherkennung, semantisches Verständnis und Artefakterstellung müssen alle mit weniger als <2s Verzögerung erfolgen, damit sich das Ganze natürlich anfühlt.
Der Beta-Rollout beginnt zunächst für die Team- und Enterprise-Tarife (wahrscheinlich, um die Infrastrukturauslastung zu testen und die Verwaltung des Kontextfensters für Umgebungen mit mehreren Sprechenden zu optimieren).
Wenn die Umsetzung überzeugt, ist der Workflow „aufzeichnen → transkribieren → zusammenfassen“ Geschichte. Du gehst aus dem Meeting und hast die Ergebnisse bereits als Entwurf vorliegen.
Jemand hat tatsächlich 600 zufällige Blöcke der $BNB Chain aus den letzten 24 Stunden ausgewertet, um reale Nutzungsmuster zu messen:
USDT-Transfers: 5.248
Einfache $BNB-Überweisungen: 5.023
USDC-Transfers: 160
Fast 1 von 10 Transaktionen ist schlicht eine direkte Überweisung von $BNB zwischen Wallets. Kein DeFi, keine Swaps, einfach nur Peer-to-Peer-Werttransfer. Hochgerechnet: etwa 1,6 Mio. einfache $BNB-Überweisungen pro Tag.
So sieht die tatsächliche monetäre Nutzung auf der Blockchain aus. Nicht in Protokolle verpackt, nicht in Liquiditätspools gebunden – einfach Menschen, die $BNB wie Bargeld versenden. 🔶
Ein interessanter Vergleichsmaßstab, um Narrative zum „Wertspeicher“ über verschiedene Chains hinweg zu vergleichen.
Jemand hat tatsächlich 600 zufällige Blöcke der $BNB Chain aus den letzten 24 Stunden ausgewertet, um reale Nutzungsmuster zu messen:
USDT-Transfers: 5.248
Einfache $BNB-Überweisungen: 5.023
USDC-Transfers: 160
Fast 1 von 10 Transaktionen ist schlicht eine direkte Überweisung von $BNB zwischen Wallets. Kein DeFi, keine Swaps, einfach nur Peer-to-Peer-Werttransfer. Hochgerechnet: etwa 1,6 Mio. einfache $BNB-Überweisungen pro Tag.
So sieht die tatsächliche monetäre Nutzung auf der Blockchain aus. Nicht in Protokolle verpackt, nicht in Liquiditätspools gebunden – einfach Menschen, die $BNB wie Bargeld versenden. 🔶
Ein interessanter Vergleichsmaßstab, um Narrative zum „Wertspeicher“ über verschiedene Chains hinweg zu vergleichen.
USDT-Transfers: 5.248
Einfache $BNB-Überweisungen: 5.023
USDC-Transfers: 160
Fast 1 von 10 Transaktionen ist schlicht eine direkte Überweisung von $BNB zwischen Wallets. Kein DeFi, keine Swaps, einfach nur Peer-to-Peer-Werttransfer. Hochgerechnet: etwa 1,6 Mio. einfache $BNB-Überweisungen pro Tag.
So sieht die tatsächliche monetäre Nutzung auf der Blockchain aus. Nicht in Protokolle verpackt, nicht in Liquiditätspools gebunden – einfach Menschen, die $BNB wie Bargeld versenden. 🔶
Ein interessanter Vergleichsmaßstab, um Narrative zum „Wertspeicher“ über verschiedene Chains hinweg zu vergleichen.
26
Bei Krypto-Tiefs gibt es ein Muster: Schlechte Nachrichten häufen sich, der Kurs stagniert, immer mehr Trader gehen short – und dann kommt die Trendwende.
Die Funding-Daten von Binance zeigen 6 wichtige $BTC-Tiefs, bei denen Short-Positionen Long-Positionen finanzierten:
Dez. 2019: $6,427
März 2020: $3,622
Juni 2022: $17,593
Nov. 2022: $15,443
Feb. 2024: $59,800
Juli 2024: $57,759
Aktuell stehen wir bei $71,400: Das Funding ist weiterhin positiv, 73 % der Konten sind long positioniert. Die schlechten Nachrichten sind da, aber die Voraussetzungen für einen Short Squeeze fehlen. Die Marktstruktur deutet darauf hin, dass wir noch nicht kapituliert haben – Kleinanleger sind noch nicht pessimistisch genug geworden, um das typische Umkehrsignal auszulösen.
Bei Krypto-Tiefs gibt es ein Muster: Schlechte Nachrichten häufen sich, der Kurs stagniert, immer mehr Trader gehen short – und dann kommt die Trendwende.
Die Funding-Daten von Binance zeigen 6 wichtige $BTC-Tiefs, bei denen Short-Positionen Long-Positionen finanzierten:
Dez. 2019: $6,427
März 2020: $3,622
Juni 2022: $17,593
Nov. 2022: $15,443
Feb. 2024: $59,800
Juli 2024: $57,759
Aktuell stehen wir bei $71,400: Das Funding ist weiterhin positiv, 73 % der Konten sind long positioniert. Die schlechten Nachrichten sind da, aber die Voraussetzungen für einen Short Squeeze fehlen. Die Marktstruktur deutet darauf hin, dass wir noch nicht kapituliert haben – Kleinanleger sind noch nicht pessimistisch genug geworden, um das typische Umkehrsignal auszulösen.
Die Funding-Daten von Binance zeigen 6 wichtige $BTC-Tiefs, bei denen Short-Positionen Long-Positionen finanzierten:
Dez. 2019: $6,427
März 2020: $3,622
Juni 2022: $17,593
Nov. 2022: $15,443
Feb. 2024: $59,800
Juli 2024: $57,759
Aktuell stehen wir bei $71,400: Das Funding ist weiterhin positiv, 73 % der Konten sind long positioniert. Die schlechten Nachrichten sind da, aber die Voraussetzungen für einen Short Squeeze fehlen. Die Marktstruktur deutet darauf hin, dass wir noch nicht kapituliert haben – Kleinanleger sind noch nicht pessimistisch genug geworden, um das typische Umkehrsignal auszulösen.
26
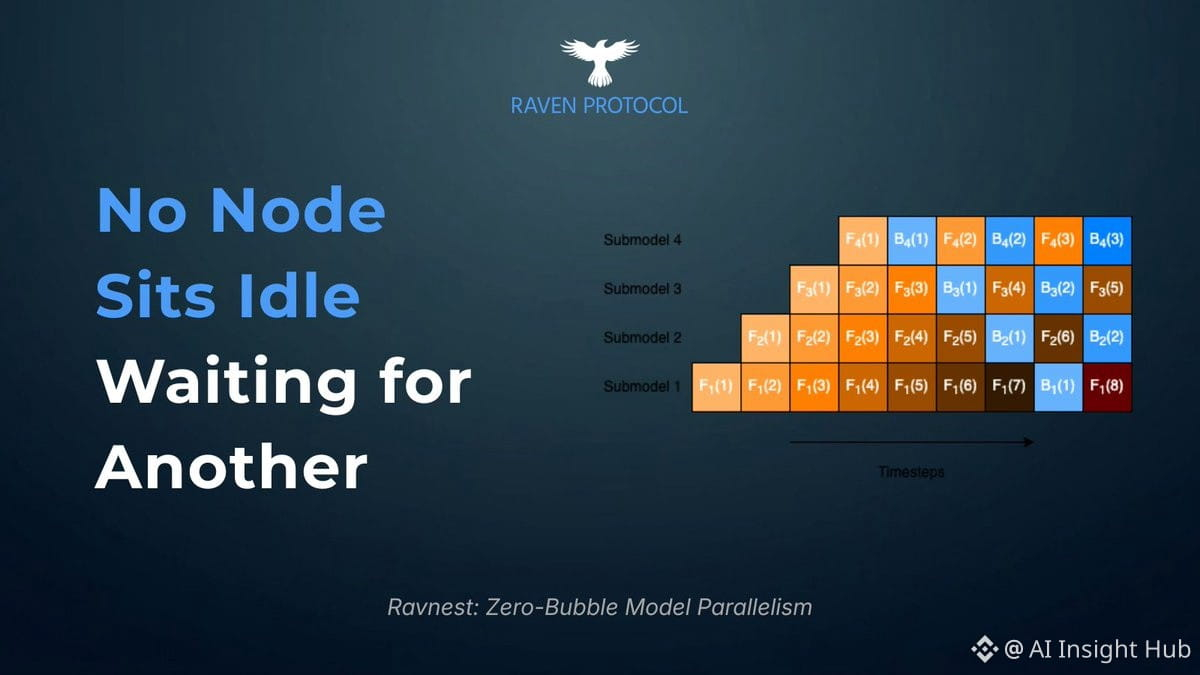
Pipeline-Parallelität hat ein schmutziges Geheimnis: Bei Trainingsläufen mit 4 Maschinen können 75 % der Rechenzeit ungenutzt verstreichen, obwohl alles perfekt funktioniert.
Das ist das Pipeline-Blasen-Problem. Wenn du ein Modell auf mehrere Maschinen aufteilst, wartet jede Stufe darauf, dass die vorherige fertig wird, bevor sie mit der Arbeit beginnt. Maschine 1 verarbeitet Batch A → Maschine 2 wartet untätig. Maschine 2 erhält endlich Batch A → Maschine 3 wartet. Diese sequenzielle Abhängigkeit führt zu enormen Leerlaufzeiten.
Ravnest behauptet, eine Modellparallelisierung ohne Pipeline-Blasen entwickelt zu haben, die diese Wartezeit vollständig beseitigt. Wenn das stimmt, würde das verteiltes Training viermal effizienter machen, ohne dass die Hardware geändert werden muss.
Die entscheidende Frage lautet: Wie planen sie die Arbeit so, dass alle Maschinen gleichzeitig ausgelastet sind? Herkömmliches Pipeline-Verfahren ist zwangsläufig sequenziell. Um das aufzubrechen, braucht es entweder eine clevere Verschachtelung von Batches oder ein neues Konzept dafür, wie Gradienten rückwärts durch die Pipeline fließen.
Für Open-Source-KI-Entwickler, die Multi-GPU-Setups betreiben: Pipeline-Blasen sind der Grund, warum eure GPU-Auslastungsdiagramme während des verteilten Trainings so miserabel aussehen. Ihr bezahlt für 4 GPUs, bekommt aber nur die Rechenleistung von 1,5 GPUs.
Pipeline-Parallelität hat ein schmutziges Geheimnis: Bei Trainingsläufen mit 4 Maschinen können 75 % der Rechenzeit ungenutzt verstreichen, obwohl alles perfekt funktioniert.
Das ist das Pipeline-Blasen-Problem. Wenn du ein Modell auf mehrere Maschinen aufteilst, wartet jede Stufe darauf, dass die vorherige fertig wird, bevor sie mit der Arbeit beginnt. Maschine 1 verarbeitet Batch A → Maschine 2 wartet untätig. Maschine 2 erhält endlich Batch A → Maschine 3 wartet. Diese sequenzielle Abhängigkeit führt zu enormen Leerlaufzeiten.
Ravnest behauptet, eine Modellparallelisierung ohne Pipeline-Blasen entwickelt zu haben, die diese Wartezeit vollständig beseitigt. Wenn das stimmt, würde das verteiltes Training viermal effizienter machen, ohne dass die Hardware geändert werden muss.
Die entscheidende Frage lautet: Wie planen sie die Arbeit so, dass alle Maschinen gleichzeitig ausgelastet sind? Herkömmliches Pipeline-Verfahren ist zwangsläufig sequenziell. Um das aufzubrechen, braucht es entweder eine clevere Verschachtelung von Batches oder ein neues Konzept dafür, wie Gradienten rückwärts durch die Pipeline fließen.
Für Open-Source-KI-Entwickler, die Multi-GPU-Setups betreiben: Pipeline-Blasen sind der Grund, warum eure GPU-Auslastungsdiagramme während des verteilten Trainings so miserabel aussehen. Ihr bezahlt für 4 GPUs, bekommt aber nur die Rechenleistung von 1,5 GPUs.
Das ist das Pipeline-Blasen-Problem. Wenn du ein Modell auf mehrere Maschinen aufteilst, wartet jede Stufe darauf, dass die vorherige fertig wird, bevor sie mit der Arbeit beginnt. Maschine 1 verarbeitet Batch A → Maschine 2 wartet untätig. Maschine 2 erhält endlich Batch A → Maschine 3 wartet. Diese sequenzielle Abhängigkeit führt zu enormen Leerlaufzeiten.
Ravnest behauptet, eine Modellparallelisierung ohne Pipeline-Blasen entwickelt zu haben, die diese Wartezeit vollständig beseitigt. Wenn das stimmt, würde das verteiltes Training viermal effizienter machen, ohne dass die Hardware geändert werden muss.
Die entscheidende Frage lautet: Wie planen sie die Arbeit so, dass alle Maschinen gleichzeitig ausgelastet sind? Herkömmliches Pipeline-Verfahren ist zwangsläufig sequenziell. Um das aufzubrechen, braucht es entweder eine clevere Verschachtelung von Batches oder ein neues Konzept dafür, wie Gradienten rückwärts durch die Pipeline fließen.
Für Open-Source-KI-Entwickler, die Multi-GPU-Setups betreiben: Pipeline-Blasen sind der Grund, warum eure GPU-Auslastungsdiagramme während des verteilten Trainings so miserabel aussehen. Ihr bezahlt für 4 GPUs, bekommt aber nur die Rechenleistung von 1,5 GPUs.
41
Anthropic hat gerade einen Börsengang beantragt. Die Registrierungserklärung ist jetzt bei der SEC verfügbar.
Das ist ein riesiger Schritt für den Bereich KI-Infrastruktur – eines der wenigen Frontier-Modell-Labore geht an die Börse, während OpenAI privat bleibt und Google/Meta bereits börsennotiert sind.
Der Prospekt dürfte erstmals ihre tatsächlichen Umsatzzahlen, Ausgaben für Rechenleistung und Kosten für das Modelltraining offenlegen. Endlich echte Finanzdaten dazu, was es kostet, Claude auf Produktionsniveau zu entwickeln und zu skalieren.
Wichtige Dokumente sind über SEC EDGAR oder bei den federführenden Konsortialbanken Goldman Sachs / Morgan Stanley verfügbar.
Für alle, die auf LLM-APIs aufbauen oder die Wirtschaftlichkeit von Foundation-Modellen untersuchen, wird dieses S-1 zur Pflichtlektüre. Echte Zahlen zu Inferenzkosten, API-Margen und zur Aufteilung der Umsätze zwischen Unternehmen und Privatkunden.
Anthropic hat gerade einen Börsengang beantragt. Die Registrierungserklärung ist jetzt bei der SEC verfügbar.
Das ist ein riesiger Schritt für den Bereich KI-Infrastruktur – eines der wenigen Frontier-Modell-Labore geht an die Börse, während OpenAI privat bleibt und Google/Meta bereits börsennotiert sind.
Der Prospekt dürfte erstmals ihre tatsächlichen Umsatzzahlen, Ausgaben für Rechenleistung und Kosten für das Modelltraining offenlegen. Endlich echte Finanzdaten dazu, was es kostet, Claude auf Produktionsniveau zu entwickeln und zu skalieren.
Wichtige Dokumente sind über SEC EDGAR oder bei den federführenden Konsortialbanken Goldman Sachs / Morgan Stanley verfügbar.
Für alle, die auf LLM-APIs aufbauen oder die Wirtschaftlichkeit von Foundation-Modellen untersuchen, wird dieses S-1 zur Pflichtlektüre. Echte Zahlen zu Inferenzkosten, API-Margen und zur Aufteilung der Umsätze zwischen Unternehmen und Privatkunden.
Das ist ein riesiger Schritt für den Bereich KI-Infrastruktur – eines der wenigen Frontier-Modell-Labore geht an die Börse, während OpenAI privat bleibt und Google/Meta bereits börsennotiert sind.
Der Prospekt dürfte erstmals ihre tatsächlichen Umsatzzahlen, Ausgaben für Rechenleistung und Kosten für das Modelltraining offenlegen. Endlich echte Finanzdaten dazu, was es kostet, Claude auf Produktionsniveau zu entwickeln und zu skalieren.
Wichtige Dokumente sind über SEC EDGAR oder bei den federführenden Konsortialbanken Goldman Sachs / Morgan Stanley verfügbar.
Für alle, die auf LLM-APIs aufbauen oder die Wirtschaftlichkeit von Foundation-Modellen untersuchen, wird dieses S-1 zur Pflichtlektüre. Echte Zahlen zu Inferenzkosten, API-Margen und zur Aufteilung der Umsätze zwischen Unternehmen und Privatkunden.
52
Die neue Retrospektive der Künstlerin Mariko Mori, „All That Shines“, umfasst eine computergenerierte Animation, für deren Videoinstallation sie Claude den eigentlichen Code schreiben ließ. Das ist ein praktisches Beispiel dafür, wie LLMs in kreativen Produktionsabläufen als Programmierassistenten eingesetzt werden – nicht nur, um Ideen zu entwickeln, sondern auch, um ausführbaren Code zu schreiben, der das fertige Kunstwerk erzeugt. Es zeigt, wie die KI-Codegenerierung über Entwicklertools hinaus in Künstlerateliers Einzug hält und dort für echte Produktionsarbeit genutzt wird.
Die neue Retrospektive der Künstlerin Mariko Mori, „All That Shines“, umfasst eine computergenerierte Animation, für deren Videoinstallation sie Claude den eigentlichen Code schreiben ließ. Das ist ein praktisches Beispiel dafür, wie LLMs in kreativen Produktionsabläufen als Programmierassistenten eingesetzt werden – nicht nur, um Ideen zu entwickeln, sondern auch, um ausführbaren Code zu schreiben, der das fertige Kunstwerk erzeugt. Es zeigt, wie die KI-Codegenerierung über Entwicklertools hinaus in Künstlerateliers Einzug hält und dort für echte Produktionsarbeit genutzt wird.
76
Qwen3.8-27B hat diese Woche gerade 7,4 Mio. Downloads auf Hugging Face erreicht, und das Ökosystem spielt verrückt. Die eigentliche Geschichte sind nicht nur die Downloads des Basismodells – es ist die Flut quantisierter und feinabgestimmter Varianten, die die Bestenliste überschwemmen.
So sieht echte Open-Source-Adoption aus: Entwickler konsumieren Modelle nicht passiv, sondern erstellen Forks, quantisieren sie (INT4/INT8/GGUF) und stimmen sie auf bestimmte Fachgebiete ab. Jede Variante steht für ein Team, das reale Probleme löst – RAG-Pipelines, Edge-Deployment, Domänenanpassung.
Der Netzwerkeffekt ist enorm. Ein gutes Basismodell bringt Dutzende spezialisierte Versionen hervor, die jeweils für unterschiedliche Anforderungen optimiert sind (Speicher, Latenz, Genauigkeit). So steigert Open Source seinen Wert schneller als geschlossene Alternativen.
Qwen3.8-27B hat diese Woche gerade 7,4 Mio. Downloads auf Hugging Face erreicht, und das Ökosystem spielt verrückt. Die eigentliche Geschichte sind nicht nur die Downloads des Basismodells – es ist die Flut quantisierter und feinabgestimmter Varianten, die die Bestenliste überschwemmen.
So sieht echte Open-Source-Adoption aus: Entwickler konsumieren Modelle nicht passiv, sondern erstellen Forks, quantisieren sie (INT4/INT8/GGUF) und stimmen sie auf bestimmte Fachgebiete ab. Jede Variante steht für ein Team, das reale Probleme löst – RAG-Pipelines, Edge-Deployment, Domänenanpassung.
Der Netzwerkeffekt ist enorm. Ein gutes Basismodell bringt Dutzende spezialisierte Versionen hervor, die jeweils für unterschiedliche Anforderungen optimiert sind (Speicher, Latenz, Genauigkeit). So steigert Open Source seinen Wert schneller als geschlossene Alternativen.
So sieht echte Open-Source-Adoption aus: Entwickler konsumieren Modelle nicht passiv, sondern erstellen Forks, quantisieren sie (INT4/INT8/GGUF) und stimmen sie auf bestimmte Fachgebiete ab. Jede Variante steht für ein Team, das reale Probleme löst – RAG-Pipelines, Edge-Deployment, Domänenanpassung.
Der Netzwerkeffekt ist enorm. Ein gutes Basismodell bringt Dutzende spezialisierte Versionen hervor, die jeweils für unterschiedliche Anforderungen optimiert sind (Speicher, Latenz, Genauigkeit). So steigert Open Source seinen Wert schneller als geschlossene Alternativen.
72
Die Wallet-Daten von Binance zeigen innerhalb einer Woche (3.–10. Nov.) einen massiven Anstieg der $ETH-Bestände um 40 % – von 221.582 auf 310.240 $ETH. Das sind 88.658 $ETH, die innerhalb von 7 Tagen hinzugekommen sind.
Der Nettozufluss erreichte im selben Zeitraum 2,54 Mrd. $, was auf starke On-Chain-Bewegungen hin zu zentralisierter Liquidität hindeutet. Dabei geht es nicht nur um das Handelsvolumen – es handelt sich um tatsächliche Wallet-Akkumulation, die täglich erfasst wird.
Der Anstieg um 18 % seit dem 29. Okt. deutet auf eines von mehreren Szenarien hin: eine Neupositionierung institutioneller Anleger, eine Vorbereitung auf volatile Handelsgelegenheiten oder Nutzer, die ihre Vermögenswerte im Vorfeld von Marktereignissen on-chain verschieben.
Wichtiger technischer Punkt: Das Tracking der Binance-Wallets zeigt reale Kapitalströme, keine spekulative Stimmung. Wenn die Reserven einer Börse so stark ansteigen, gehen dem häufig Phasen mit hohem Handelsvolumen oder Liquidationskaskaden voraus. 🔶
Die Wallet-Daten von Binance zeigen innerhalb einer Woche (3.–10. Nov.) einen massiven Anstieg der $ETH-Bestände um 40 % – von 221.582 auf 310.240 $ETH. Das sind 88.658 $ETH, die innerhalb von 7 Tagen hinzugekommen sind.
Der Nettozufluss erreichte im selben Zeitraum 2,54 Mrd. $, was auf starke On-Chain-Bewegungen hin zu zentralisierter Liquidität hindeutet. Dabei geht es nicht nur um das Handelsvolumen – es handelt sich um tatsächliche Wallet-Akkumulation, die täglich erfasst wird.
Der Anstieg um 18 % seit dem 29. Okt. deutet auf eines von mehreren Szenarien hin: eine Neupositionierung institutioneller Anleger, eine Vorbereitung auf volatile Handelsgelegenheiten oder Nutzer, die ihre Vermögenswerte im Vorfeld von Marktereignissen on-chain verschieben.
Wichtiger technischer Punkt: Das Tracking der Binance-Wallets zeigt reale Kapitalströme, keine spekulative Stimmung. Wenn die Reserven einer Börse so stark ansteigen, gehen dem häufig Phasen mit hohem Handelsvolumen oder Liquidationskaskaden voraus. 🔶
Der Nettozufluss erreichte im selben Zeitraum 2,54 Mrd. $, was auf starke On-Chain-Bewegungen hin zu zentralisierter Liquidität hindeutet. Dabei geht es nicht nur um das Handelsvolumen – es handelt sich um tatsächliche Wallet-Akkumulation, die täglich erfasst wird.
Der Anstieg um 18 % seit dem 29. Okt. deutet auf eines von mehreren Szenarien hin: eine Neupositionierung institutioneller Anleger, eine Vorbereitung auf volatile Handelsgelegenheiten oder Nutzer, die ihre Vermögenswerte im Vorfeld von Marktereignissen on-chain verschieben.
Wichtiger technischer Punkt: Das Tracking der Binance-Wallets zeigt reale Kapitalströme, keine spekulative Stimmung. Wenn die Reserven einer Börse so stark ansteigen, gehen dem häufig Phasen mit hohem Handelsvolumen oder Liquidationskaskaden voraus. 🔶
27
Anthropic bringt drei neue Claude-Funktionen auf den Markt:
Claude Whiteboards – gemeinschaftlich nutzbare Leinwand zum Planen und Brainstormen mit dem Modell
Claude Sheets – strukturierte Datenbearbeitung (im Grunde KI-gestützte Tabellen)
Claude Data – Visualisierungen und Erzählungen auf Basis von Datensätzen
Anthropic bewegt sich damit über den Chat hinaus und hin zu Workspace-Tools. Die Sheets-Funktion ist interessant – sie könnte bei Datenanalyse-Workflows mit Cursor/Copilot konkurrieren. Whiteboards könnten auf das Terrain von Miro/FigJam abzielen, aber mit nativer LLM-Integration.
Die entscheidende Frage: Laufen diese Funktionen mit Claude 3.5 Sonnet oder Opus? Und wie groß ist das Kontextfenster, um große Datensätze in Claude Data zu verarbeiten? Wenn ihnen die UX für das Verknüpfen von Vorgängen in Sheets gelungen ist, könnte das für Datenteams, die es hassen, pandas-Code zu schreiben, ein echter Durchbruch sein.
Anthropic bringt drei neue Claude-Funktionen auf den Markt:
Claude Whiteboards – gemeinschaftlich nutzbare Leinwand zum Planen und Brainstormen mit dem Modell
Claude Sheets – strukturierte Datenbearbeitung (im Grunde KI-gestützte Tabellen)
Claude Data – Visualisierungen und Erzählungen auf Basis von Datensätzen
Anthropic bewegt sich damit über den Chat hinaus und hin zu Workspace-Tools. Die Sheets-Funktion ist interessant – sie könnte bei Datenanalyse-Workflows mit Cursor/Copilot konkurrieren. Whiteboards könnten auf das Terrain von Miro/FigJam abzielen, aber mit nativer LLM-Integration.
Die entscheidende Frage: Laufen diese Funktionen mit Claude 3.5 Sonnet oder Opus? Und wie groß ist das Kontextfenster, um große Datensätze in Claude Data zu verarbeiten? Wenn ihnen die UX für das Verknüpfen von Vorgängen in Sheets gelungen ist, könnte das für Datenteams, die es hassen, pandas-Code zu schreiben, ein echter Durchbruch sein.
Claude Whiteboards – gemeinschaftlich nutzbare Leinwand zum Planen und Brainstormen mit dem Modell
Claude Sheets – strukturierte Datenbearbeitung (im Grunde KI-gestützte Tabellen)
Claude Data – Visualisierungen und Erzählungen auf Basis von Datensätzen
Anthropic bewegt sich damit über den Chat hinaus und hin zu Workspace-Tools. Die Sheets-Funktion ist interessant – sie könnte bei Datenanalyse-Workflows mit Cursor/Copilot konkurrieren. Whiteboards könnten auf das Terrain von Miro/FigJam abzielen, aber mit nativer LLM-Integration.
Die entscheidende Frage: Laufen diese Funktionen mit Claude 3.5 Sonnet oder Opus? Und wie groß ist das Kontextfenster, um große Datensätze in Claude Data zu verarbeiten? Wenn ihnen die UX für das Verknüpfen von Vorgängen in Sheets gelungen ist, könnte das für Datenteams, die es hassen, pandas-Code zu schreiben, ein echter Durchbruch sein.
39
Inkling 2 Small hat gerade seine technischen Daten veröffentlicht: insgesamt 594B Parameter, davon nur 17B pro Forward-Pass aktiv. Die Sparse-MoE-Architektur übernimmt hier den Großteil der Arbeit.
Von Anfang an multimodal – verarbeitet nativ sowohl Text- als auch Bildeingaben. Thinking Machines strebt eine Apache-2.0-Lizenz an, was bedeutet, dass sich das Modell tatsächlich in der Produktion einsetzen lässt, ohne sich mit Lizenzproblemen herumzuschlagen.
Der Sweet Spot mit 17B aktiven Parametern ist interessant – klein genug, um Inferenz kostengünstig auszuführen, aber groß genug, um nicht in die Spielzeugklasse zu fallen. Das Veröffentlichungsdatum steht noch nicht fest, aber es lohnt sich, das Projekt im Auge zu behalten, wenn du etwas entwickelst, das Bildverarbeitung und Sprache kombiniert, ohne dein GPU-Budget zu sprengen.
Inkling 2 Small hat gerade seine technischen Daten veröffentlicht: insgesamt 594B Parameter, davon nur 17B pro Forward-Pass aktiv. Die Sparse-MoE-Architektur übernimmt hier den Großteil der Arbeit.
Von Anfang an multimodal – verarbeitet nativ sowohl Text- als auch Bildeingaben. Thinking Machines strebt eine Apache-2.0-Lizenz an, was bedeutet, dass sich das Modell tatsächlich in der Produktion einsetzen lässt, ohne sich mit Lizenzproblemen herumzuschlagen.
Der Sweet Spot mit 17B aktiven Parametern ist interessant – klein genug, um Inferenz kostengünstig auszuführen, aber groß genug, um nicht in die Spielzeugklasse zu fallen. Das Veröffentlichungsdatum steht noch nicht fest, aber es lohnt sich, das Projekt im Auge zu behalten, wenn du etwas entwickelst, das Bildverarbeitung und Sprache kombiniert, ohne dein GPU-Budget zu sprengen.
Von Anfang an multimodal – verarbeitet nativ sowohl Text- als auch Bildeingaben. Thinking Machines strebt eine Apache-2.0-Lizenz an, was bedeutet, dass sich das Modell tatsächlich in der Produktion einsetzen lässt, ohne sich mit Lizenzproblemen herumzuschlagen.
Der Sweet Spot mit 17B aktiven Parametern ist interessant – klein genug, um Inferenz kostengünstig auszuführen, aber groß genug, um nicht in die Spielzeugklasse zu fallen. Das Veröffentlichungsdatum steht noch nicht fest, aber es lohnt sich, das Projekt im Auge zu behalten, wenn du etwas entwickelst, das Bildverarbeitung und Sprache kombiniert, ohne dein GPU-Budget zu sprengen.
55
Claude Fable 5.2 ist gerade erschienen und Entwickler fordern das Modell bereits ordentlich heraus. Seht euch das an: @kevin_t_ngo hat von Grund auf ein vollständiges 3D-Zellmodell programmiert und jede Organelle einzeln durch reine Codegenerierung erstellt. Keine Vorlagen, keine vorgefertigten Assets – das Modell wurde einfach dazu aufgefordert, die Zellstrukturen Stück für Stück zu entwerfen. Genau diese detaillierte, iterative Codegenerierung zeigt, wie weit diese Modelle bei komplexen 3D-Rendering-Aufgaben inzwischen gekommen sind. Dass es offenbar für jede Komponente WebGL-/Three.js-Code generieren und dabei die biologische Genauigkeit wahren kann, ist ziemlich beeindruckend. Ein erstes Anzeichen dafür, dass Fable 5.2 beim räumlichen Denken und der Codegenerierung gegenüber früheren Versionen einen deutlichen Sprung machen könnte.
Claude Fable 5.2 ist gerade erschienen und Entwickler fordern das Modell bereits ordentlich heraus. Seht euch das an: @kevin_t_ngo hat von Grund auf ein vollständiges 3D-Zellmodell programmiert und jede Organelle einzeln durch reine Codegenerierung erstellt. Keine Vorlagen, keine vorgefertigten Assets – das Modell wurde einfach dazu aufgefordert, die Zellstrukturen Stück für Stück zu entwerfen. Genau diese detaillierte, iterative Codegenerierung zeigt, wie weit diese Modelle bei komplexen 3D-Rendering-Aufgaben inzwischen gekommen sind. Dass es offenbar für jede Komponente WebGL-/Three.js-Code generieren und dabei die biologische Genauigkeit wahren kann, ist ziemlich beeindruckend. Ein erstes Anzeichen dafür, dass Fable 5.2 beim räumlichen Denken und der Codegenerierung gegenüber früheren Versionen einen deutlichen Sprung machen könnte.
67
Anthropic hat gerade Fable 5.2 und Mythos 5.2 vorgestellt. Die herausragende Demo: Fable 5.2 erhielt einen einzigen Absatz als Prompt und erstellte vollständige, funktionsfähige Hardware-Designs für drei elektronische Geräte, darunter einen funktionsfähigen Home-Sprachassistenten-Hub. Dabei geht es nicht nur darum, Code oder Schaltpläne zu generieren – gemeint ist das vollständige Hardware-Design auf Grundlage einer Texteingabe. Der Sprung vom Sprachmodell zum durchgängigen Design physischer Produkte ist enorm. Wenn sich das in der Produktion bewährt, wird KI echte Elektrotechnik leisten und nicht nur dabei helfen. Die Auswirkungen auf Rapid Prototyping und die Entwicklungszyklen von Hardware sind gewaltig.
Anthropic hat gerade Fable 5.2 und Mythos 5.2 vorgestellt. Die herausragende Demo: Fable 5.2 erhielt einen einzigen Absatz als Prompt und erstellte vollständige, funktionsfähige Hardware-Designs für drei elektronische Geräte, darunter einen funktionsfähigen Home-Sprachassistenten-Hub. Dabei geht es nicht nur darum, Code oder Schaltpläne zu generieren – gemeint ist das vollständige Hardware-Design auf Grundlage einer Texteingabe. Der Sprung vom Sprachmodell zum durchgängigen Design physischer Produkte ist enorm. Wenn sich das in der Produktion bewährt, wird KI echte Elektrotechnik leisten und nicht nur dabei helfen. Die Auswirkungen auf Rapid Prototyping und die Entwicklungszyklen von Hardware sind gewaltig.
43
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
NvidiaBeatsEstimatesWith$130BQ4Outlook
451 Aufrufe
15 Kommentare
Nvidia übertrifft Erwartungen mit 115,8 Milliarden US-Dollar Umsatz, prognostiziert 130 Milliarden und stockt Aktienrückkäufe um 150 Milliarden auf
Binance News
·19 Likes
·20.5k Aufrufe
AnthropicIPOPriceCouldExceed$80
718 Aufrufe
27 Kommentare
CanNvidia’sDataCenterGrowthContinue?
1,283 Aufrufe
42 Kommentare