

Womit ich angefangen habe
Ich bin in die CLI-Referenz von Newton gegangen und habe eine einzige Datenschutz-Mechanik erwartet – die sensiblen Inhalte verschlüsseln, vom öffentlichen Chain fernhalten, fertig. So ist es nicht. Die Dokumentation nennt drei unterschiedliche Datenschutzpfade: identity, confidential und ephemeral. Jeder davon hat seinen eigenen CLI-Befehl, ein eigenes Speicherverhalten und – das ist der Teil, der wirklich zählt – seine eigene Antwort auf eine Frage, die die Doku nicht direkt stellt: privat vor wem, wie lange, und wer darf es dort abgelegt haben.
Die drei Befehle, wie sie dastehen
Aufgeschält auf ihre tatsächlichen Aufrufe:
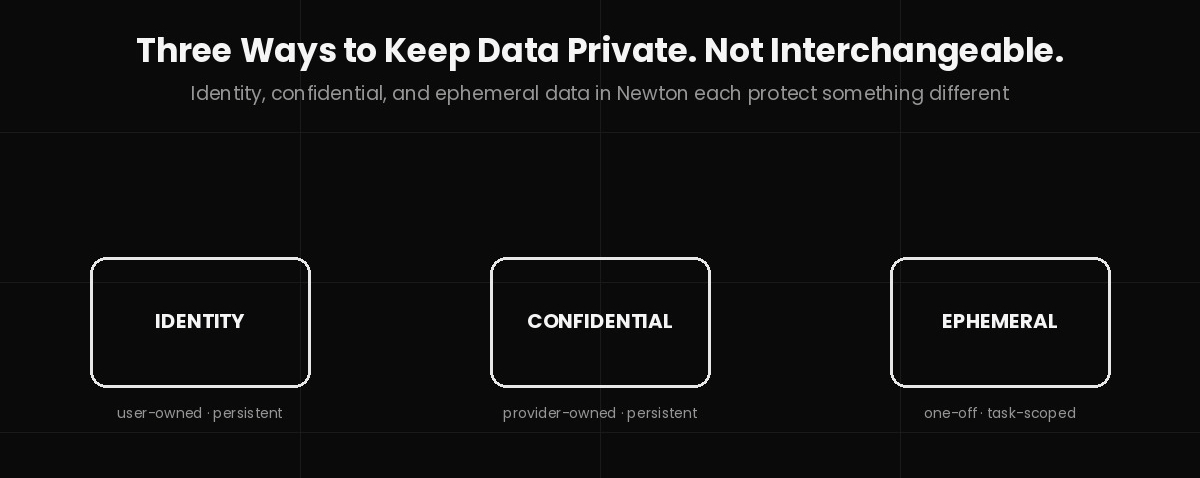
Identität — newton-cli privacy identity upload --data-file identity.json --domain kyc --policy-client 0x.... Die Doku beschreibt das als persistente Identitätsdaten – KYC, Credentials – und gibt an, dass sie nach dem Upload onchain mit einem Policy-Client verknüpft sind. Das sind Daten über eine bestimmte Person, einmal hochgeladen, um in zukünftigen Bewertungen dieser Person wiederholt referenziert zu werden.
Vertraulich — newton-cli privacy confidential upload --data-file blacklist.json --domain blacklist. Beschrieben als vom Anbieter verwaltete vertrauliche Daten – Blacklists, Allowlists. Achte darauf, was diesem Befehl im Vergleich zu Identität fehlt: kein --policy-client-Flag, das ihn an einen einzigen konkreten Client bindet. Das sind keine Daten über einen Nutzer. Das sind Daten, die ein Anbieter pflegt und auf beliebige Clients anwendet, die sie referenzieren.
Ephemeral — newton-cli privacy ephemeral encrypt --data '{"credit_score": 750}' --policy-client 0x.... Kein separater Upload-Schritt überhaupt – sie wird verschlüsselt und direkt an eine einzelne Task-Request angehängt. Sollte genau einmal verwendet werden, für genau eine Evaluation, und nicht als wiederverwendbarer Status persistiert werden.
Die Achse, die die Doku nicht benennt
Nachdem ich diese drei nebeneinander gelegt hatte, zeigte sich ein Muster, das nirgendwo explizit genannt wird: Diese drei Pfade trennen sich entlang zweier getrennter Fragen – wem gehören die Daten, und wie lange leben sie?
Identität ist benutzer- und persistent. Vertraulich ist anbieter- und persistent. Ephemeral ist (typischerweise) benutzer- und temporär. Es gibt eine offensichtliche vierte Kombination – anbieter- und temporär –, die keinen benannten Pfad in der Dokumentation hat, den ich finden konnte; das bedeutet entweder, dass es ein ungewöhnlich genuges Bedürfnis ist, um sich keinen eigenen Befehl zu lohnen, oder dass es auf andere Weise gelöst wird, die ich nicht gefunden habe.
Dieses 2x2 ist nicht nur eine Taxonomie-Übung. Es bestimmt, wer die Daten aktualisieren darf, wer verantwortlich ist, wenn sie falsch sind, und was „privat“ dich in jedem Fall tatsächlich vor dem schützt, was du schützen willst.
Warum „Vertraulich“ die eine Sache ist, mit der man sich beschäftigen sollte
Identität und ephemeral haben beide einen intuitiven Eigentümer: die Person, auf die sich die Daten beziehen, die vermutlich zugestimmt hat, dass sie hochgeladen oder angehängt werden. „Vertraulich“ funktioniert nicht auf diese Weise. Eine Blacklist wird vom Anbieter verwaltet – das heißt, irgendeine andere Partei (ein Compliance-Anbieter, ein Risk-Provider) pflegt sie, und sie wird auf Transaktionen angewendet, die Personen betreffen, die nie etwas hochgeladen haben und vermutlich auch nicht wissen, welche konkreten Inhalte der Liste gegen sie geprüft werden.
Das ist kein Makel – eine Sanktionsliste oder eine Fraud-Blacklist muss von jemand anderem als der Person gepflegt werden, auf die sie möglicherweise angewendet wird, sonst wäre sie nutzlos. Aber das bedeutet, dass die hier gegebene Datenschutz-Garantie etwas anderes leistet als für Identitätsdaten. Bei Identitätsdaten schützt die Verschlüsselung die eigenen Informationen des Nutzers vor öffentlicher Offenlegung – ein Datenschutzvorteil für die Person, die die Daten beschreiben. Bei vertraulichen Anbieterdaten schützt die Verschlüsselung dagegen die proprietäre Liste des Anbieters davor, abgekratzt oder rückentwickelt zu werden – ein Datenschutzvorteil für den Anbieter, nicht für die Person, gegen die sie geprüft wird.
Beides sind legitime Gründe, etwas zu verschlüsseln. Aber wenn man beides unter ein Wort zusammenfällt – „privacy“ – verdeckt das, dass das eine den Gegenstand schützt und das andere den Compiler der Liste, gegen die der Gegenstand bewertet wird.
Was das bedeutet, wenn du ein Allocator bist – nicht nur ein Entwickler
L
Wenn eine Vault-Policy sich auf eine vertrauliche Blacklist stützt, die von irgendeinem Dritten bereitgestellt wird, ist die Durchsetzbarkeit dieser Policy nur so gut wie die Liste dieses Anbieters – und per Design kannst du die tatsächlichen Inhalte der Liste nicht einsehen, um sie zu prüfen. Du kannst verifizieren, dass eine Prüfung gelaufen ist und gegen welche benannte Policy. Du kannst aber nicht verifizieren, dass die zugrunde liegende Blacklist selbst korrekt, aktuell oder fair zusammengestellt ist, denn der gesamte Sinn des vertraulichen Pfads ist, dass seine Inhalte nicht offengelegt werden – auch nicht gegenüber dem Auditor, der den Beleg danach prüft.
Das ist dieselbe Spannung, die überall dort auftaucht, wo ein Proof-of-Correct-Execution-Modell auf eine nicht verifizierbare Eingabe trifft: Der Proof sagt dir, dass die Prüfung wie spezifiziert erfolgt ist. Er kann dir weder sagen, ob die Spezifikation selbst, noch ob die Daten, die in sie einfließen, überhaupt dein Vertrauen verdient haben. Neutons Architektur verifiziert den Prozess. Sie war nie in der Lage, das Urteil dessen zu verifizieren, der eine private Blacklist kuratiert hat – kein kryptografisches System kann eine Wertentscheidung bezeugen, die es gar nicht treffen sollte.
Wo ich lande
Keines davon macht das Drei-Pfade-Design falsch. Im Gegenteil: Drei unterschiedliche Primitiven statt einer generischen „Verschlüsse es“-Schaltfläche ist ein Zeichen dafür, dass das Team die konkreten unterschiedlichen Anwendungsfälle durchdacht hat, statt nach einem einzigen Hammer zu greifen. Aber die Benennung – „privacy“ wird über alle drei hinweg einheitlich verwendet – glättet einen Unterschied, der in der Praxis sehr viel ausmacht: Manchmal schützt man die Person, auf die sich die Daten beziehen, und manchmal schützt man den Anbieter, der die Daten zusammengestellt hat, um diese Person anhand der verwendeten Daten zu beurteilen. Dafür braucht es unterschiedliche Prüfungen, und im Moment bekommen sie dieselbe Bezeichnung.