
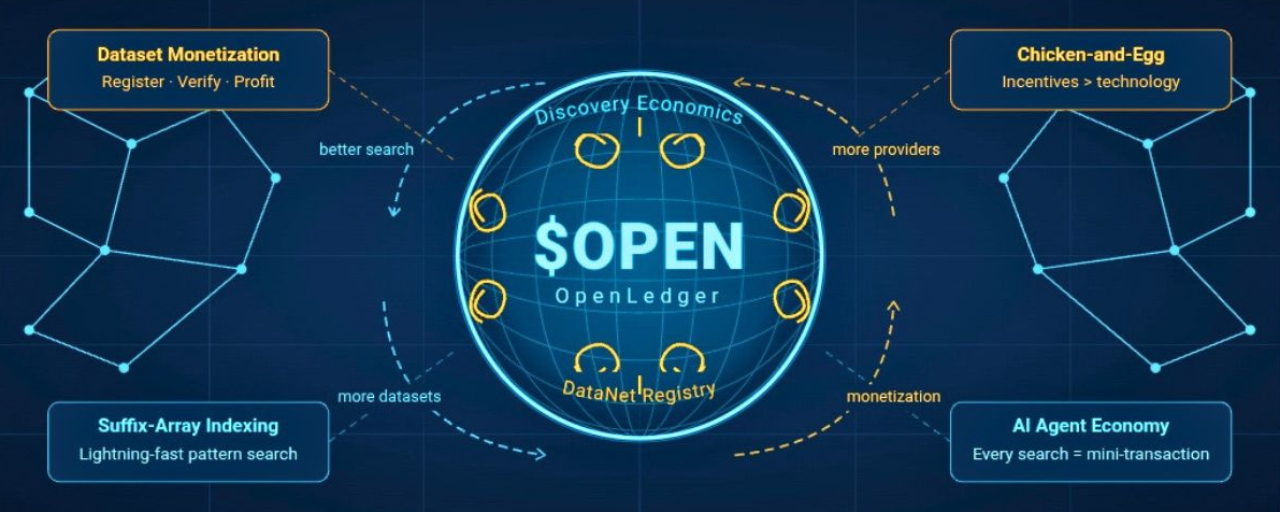


Das erste Mal, als ich das DataNet-Register von OpenLedger geöffnet habe, erwartete ich eine weitere Geschichte über KI-Infrastruktur. Stattdessen brachte es mich dazu, über Datenbanken nachzudenken.
Normalerweise, wenn Leute über KI-Infrastruktur sprechen, hört man von den Modellen. Größeren Modellen. Schnelleren Inferenzzeiten. Aufwendigeren Ergebnissen. Aber das, was ein KI-System wirklich zum Laufen bringt oder zum Scheitern bringt, sind nicht die Modelle; es ist, wie du die Daten im Hintergrund organisierst.
Der Unterschied, zumindest von dem, was ich sehen kann, ist der Fokus von OpenLedger auf Entdeckung – nicht nur auf Speicherung.
Nicht die tatsächlichen Daten. Nur… wie du sie findest.
Dieser Unterschied trifft härter, als die meisten Leute realisieren.
Je mehr ich darüber nachdachte, desto mehr fühlte es sich wie Entdeckungsoekonomie an – die Idee, dass das Finden von Daten wertvoller werden könnte als deren Speicherung.
Was mich wirklich fasziniert hat, war zu sehen, wie die Indexierung im Stil von Suffix-Arrays direkt in ihre Architektur integriert wurde. Wenn du dich noch nie mit Suffix-Arrays beschäftigt hast, bin ich vor Jahren darauf gestoßen, als ich mit Suchoptimierung experimentierte. Das Prinzip ist einfach, aber irgendwie verrückt – es ermöglicht dir, Informationen so zu organisieren, dass das Musterfinden blitzschnell in Gang kommt.
Klingt technisch, klar, aber die echte Auswirkung ist wirtschaftlich.
Denn wenn diese KI-Agenten anfangen, eigenständig herumzulaufen, wird jede Suche zu einer Mini-Transaktion. Jede zusätzliche Sekunde beim Suchen ist Reibung. Jeder Fehlversuch? Leere Berechnung, verschwendete Energie. Wenn Agenten beginnen, Entscheidungen in großem Maßstab zu treffen, häufen sich diese kleinen Ineffizienzen wie verrückt.
Da wurde das DataNet-Register für mich interessant.
Anstatt Datensätze einfach als statische Dateien ins Internet zu werfen, behandelt es sie mehr wie Vermögenswerte, die man entdecken und sogar monetarisieren kann. Das System steckt sie nicht einfach in eine Schublade – es bietet strukturierte Schienen für die Registrierung, Überprüfung, Auffindbarkeit und vielleicht sogar das Profitieren von Datensätzen. Alles unter einem Dach.
Bessere Sucheffizienz verbessert die Produktivität der Agenten. Produktivere Agenten konsumieren mehr Datensätze. Mehr Datensatznutzung schafft Monetarisierungsmöglichkeiten, was zusätzliche Anbieter anzieht und das Netzwerk stärkt. Das ist die grundlegende Logik hinter dem, was ich begonnen habe, als Entdeckungsoekonomie zu betrachten.
Ehrlich gesagt, wenn ich zurückblicke, haben Entdeckungsschichten eine Art, den tatsächlichen Inhalt zu überstrahlen. Suchmaschinen wurden größer als die Websites. App-Stores übertrafen die meisten einzelnen Apps. Marktplätze gewinnen, weil sie den Aufwand minimieren, das, was die Leute brauchen, mit dem, was die Leute anbieten, abzugleichen.
Ich frage mich immer wieder – könnte das auch mit KI-Datensätzen passieren? Besonders mit der aktuellen Verschiebung.
Man spürt, dass der Markt wieder in Richtung Infrastrukturgespräche tendiert. KI steht zweifellos im Rampenlicht, aber die Investoren scheinen mehr an den Rohren und der Infrastruktur interessiert zu sein, die sie unterstützen, nicht nur an den auffälligen Modellen. Krypto hatte diese Rotationen: zuerst wilder Begeisterung über Apps ... dann jagt jeder den Schienen darunter hinterher.
Manchmal? Diese zweite Phase schöpft viel mehr Wert aus als die erste.
Aber Datennetzwerke stehen vor diesem lästigen Bootstrap-Problem. Ein Register funktioniert nur, wenn genügend saftige Datensätze darin leben. Und saftige Datensätze erscheinen nur, wenn die Auffindbarkeit und das Geldverdienen damit bereits funktioniert.
Total Henne-Ei-Dilemma.
Krypto stolpert ständig über dieses Problem. Egal, ob es sich um Liquiditätspools, Oracle-Netzwerke oder dezentrale Speicherung handelt – alle stoßen auf Variationen des gleichen Kopfschmerzes.
Es sind die Anreize, die wichtiger sind als die Technologie.
Schönes Register? Das bedeutet nicht, dass die Leute massenhaft kommen. Die Leute wollen tatsächliche Gründe, um Daten zu teilen, sie sauber zu halten und dem System zu vertrauen. Andernfalls hast du nur ein schickes Regal für wertlose Informationen – eine digitale Geisterstadt.
Das ist ehrlich gesagt der Teil, mit dem ich noch kämpfe.
Die Architektur ist cool – sie verbindet alte Computerwissenschaft mit neuen Blockchain-Anreizrezepten. Aber die Geschichte erinnert mich immer wieder daran: Technische Brillanz und reale Nachhaltigkeit erscheinen nicht immer zusammen.
Vielleicht ist der wahre Funke nicht die Indexierungszauberei, sondern dass die Auffindbarkeit selbst ein nativer wirtschaftlicher Treiber für KI wird.
Oder vielleicht – es ist wirklich nur Rauch und Spiegel.
Es fühlt sich ehrlich gesagt an, als wären wir in den frühen Tagen. Schwer zu sagen, was echte Infrastruktur ist und was nur eine Geschichte in Infrastrukturoptik.
Die Ökonomie funktioniert nur, wenn die Qualität der Datensätze mit der Quantität der Datensätze skaliert. Wachstum allein reicht nicht aus.
Vielleicht ist das, was die Entdeckungsoekonomie wirklich testet – nicht, ob Daten Wert haben, sondern ob Auffindbarkeit zu einem eigenen Markt werden kann.
Wenn Auffindbarkeit zu einer eigenen wirtschaftlichen Schicht wird, könnte das DataNet-Register wichtiger werden als die Datensätze selbst. Andernfalls ist es nur ein weiteres Register, das niemand nutzt.
