

Schau dich im Web3-Bereich um, und du wirst ein sich wiederholendes, fast ermüdendes Muster bemerken: Krypto behandelt menschliche Verhaltensprobleme gerne als einfache Ingenieuraufgaben.
Ein neues Projekt taucht auf, wirft ein schweres Whitepaper voller architektonischem Fachjargon ab, und plötzlich tun alle so, als könnte sauberen Code die kaputten menschlichen Anreize magisch reparieren. Das hat es nie, und es wird es nie.
Die harte, hässliche Wahrheit über digitale Ökonomien ist viel einfacher, aber viel schwieriger zu lösen: Menschen schaffen ständig Wert, aber Systeme scheitern konstant daran, zu verfolgen, wer tatsächlich die Anerkennung verdient.
Web2 hat diese extraktive Beziehung gemeistert. Nutzer haben die Daten generiert, die Algorithmen mit ihren Klicks optimiert und die digitale Landschaft aufgebaut. Plattformen haben 99% des finanziellen Aufschwungs abgegriffen. Jetzt betritt die Künstliche Intelligenz den Raum, und sie macht diese Wertschöpfungskrise unendlich komplizierter.
Denn KI konsumiert nicht nur Daten. KI konsumiert menschlichen Beitrag.
Die Black Box der Maschinenintelligenz
Wenn du dir einen KI-Ausgang ansiehst – eine Codezeile, ein digitales Kunstwerk oder eine Handelsstrategie – siehst du ein poliertes Endprodukt. Was du nicht siehst, ist die chaotische, fragmentierte Maschine darunter.
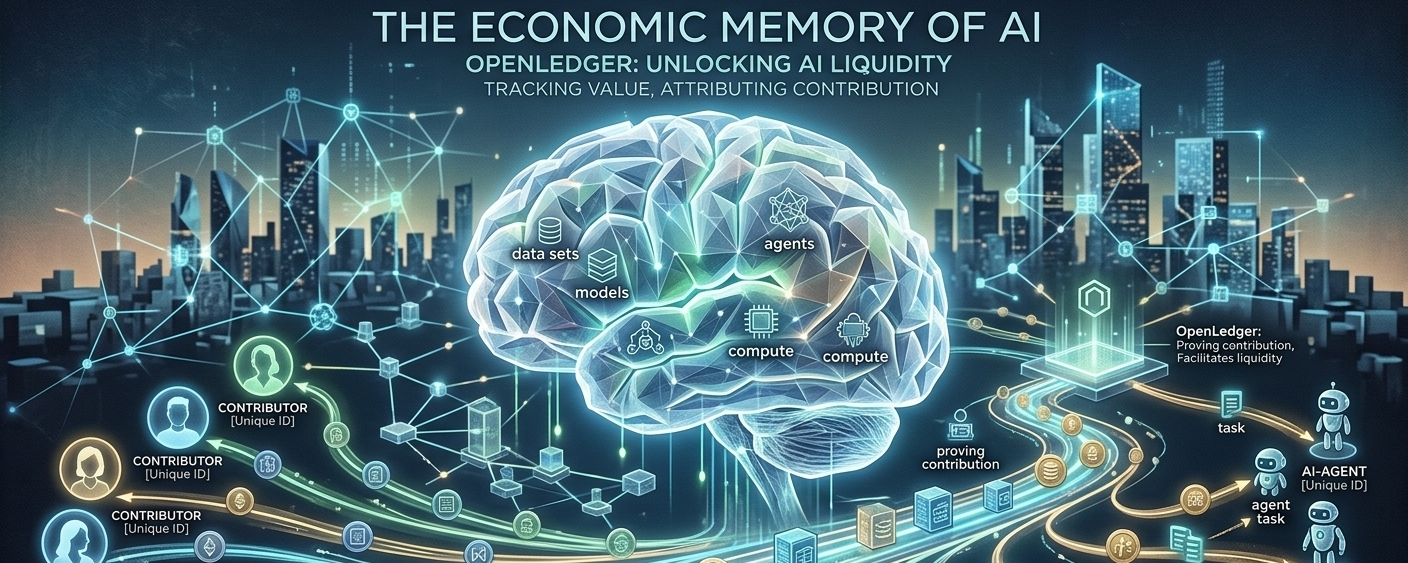
Ein KI-Ausgang ist eine Kollision separater Welten:
Dateninjektion: Massive Datensätze, die von Tausenden einzelner Hände kuratiert werden.
Modellarchitektur: Neuronale Netzwerke, die von Forschern entworfen wurden.
Recheninfrastruktur: Leistungsstarke Hardware, die Daten in immensem Maßstab verarbeitet.
Autonome Agenten: Spezialisierte Einheiten, die Mikroaufgaben ausführen.
In der traditionellen Fertigung haben wir Lieferketten. Ein Automobilhersteller weiß genau, wo jeder Schraube, jedes Stück Leder und jeder Mikrochip herkommt. Das Eigentum hat klare, rechtliche Grenzen.
KI verwischt diese Grenzen vollständig. Sie nimmt Daten von Quelle A, ein Modell von Ersteller B, Rechenleistung von Anbieter C und bietet eine makellose Benutzererfahrung, bei der alle ursprünglichen Beitragsleistenden unsichtbar gemacht werden.
Das ist nicht nur ein ethisches Problem; es ist ein massives wirtschaftliches Nadelöhr. Volkswirtschaften kommen zum Stillstand, wenn die Teilnehmer erkennen, dass ihr Input null rückverfolgbare Belohnungen abwirft.
Betritt OpenLedger: Aufbau einer Koordinationsschicht, nicht einer Erzählung
Das ist die genaue Wunde, die OpenLedger zu behandeln versucht. Sie starten nicht eine weitere leere KI-Erzählung oder versuchen, eine vorübergehende Token-Geschichte zu pumpen. Sie stellen eine viel langweiligere – aber völlig gefährliche – Frage:
Wie schaffst du wirtschaftliches Gedächtnis rund um die Intelligenz selbst?
Wenn man die Krypto-Buzzwords wegstreicht, ist die Kernthese von OpenLedger ganz einfach: KI-Systeme basieren auf Inputs. Diese Inputs kommen von echten Beitragsleistenden. Daher müssen diese Beitragsleistenden einen dauerhaften, messbaren Fußabdruck im wirtschaftlichen Lebenszyklus dieser KI haben.
Anstatt Datensätze, Modelle und Agenten in einer Unternehmensschwarzbox verschwinden zu lassen, positioniert sich OpenLedger als dezentrale Koordinationsschicht. Es behandelt diese Elemente nicht als isolierte Werkzeuge, sondern als aktive, sichtbare wirtschaftliche Teilnehmer.
Denk daran, wie Logistik vor modernen Lieferketten. Die Fabriken, Schiffe und Rohmaterialien haben immer existiert, aber die Koordination war kaputt. Der Wert sickerte überall aufgrund mangelnder Sichtbarkeit. OpenLedger versucht nicht, KI-Intelligenz zu erfinden; es versucht, sie zu organisieren.
Die Tokenomics-Falle: Bewegung von Traktion unterscheiden
Aber lass uns ganz offen sein. Die Umsetzung in diesem Bereich ist ein Minenfeld, und OpenLedger steht vor derselben existenziellen Bedrohung, die Dutzende von vielversprechenden Web3-Ökosystemen zerstört hat: die Gamifizierung von Anreizen.
Krypto hat die schlechte Angewohnheit, sich in oberflächliche Metriken zu verlieben. Wir starren auf Dune Dashboards, betrachten das Transaktionsvolumen, die aktiven Wallet-Zahlen und die explosive soziale Medienbeteiligung und überzeugen uns selbst, dass ein Projekt gewinnt.
Wir haben diesen Film schon einmal gesehen. Wir haben es beim DeFi-Liquiditäts-Mining gesehen. Wir haben es beim Play-to-Earn (P2E) Gaming gesehen. Ökosysteme schienen riesig, bis die Belohnungen versiegten – und dann verschwanden die Nutzer über Nacht. Sie haben Farming mit echter Marktnachfrage verwechselt.
In dem Moment, in dem du die Daten- und KI-Beiträge messbar machst, ändert sich die Denkweise der Nutzer. Sie hören auf zu fragen: "Wie kann ich etwas wirklich Nützliches beitragen?" und beginnen zu fragen: "Wie kann ich den Algorithmus ausspielen, um meine $OPEN Belohnungen zu maximieren?"
Auf einem Blockchain-Ledger können eine Sybil-Bot-Farm und ein hochwertiger menschlicher Datenbeitragsleistender erschreckend ähnlich aussehen. Fake-Volumen kann als Netzwerkgesundheit maskiert werden, während echte, organische Nützlichkeit vom Rauschen übertönt wird.
Die gnadenlosen Fragen, die OpenLedger beantworten muss
Überlegene Technologie gewinnt selten den Markt. Bequemlichkeit, Geschwindigkeit und Einfachheit tun es. Wenn OpenLedger über die anfängliche Anreizphase hinaus bestehen will, muss es die unglamourösen Fragen beantworten, die die meisten hypegetriebenen Projekte ignorieren:
Qualität vs. Rauschen: Wie filtert das Protokoll synthetische, wertlose Daten heraus, die ausschließlich darauf abzielen, Belohnungen zu farmen?
Granulare Attribution: Wenn ein KI-Modell 50.000 verschiedene Dateninputs nutzt, um einen einzigen wertvollen Output zu generieren, wie kannst du die MikBelohnungen fair aufteilen?
Privatsphäre vs. Herkunft: Wie kannst du die Datenlinie und Attribution verfolgen, ohne die Privatsphäre der Nutzer zu gefährden oder proprietäre Daten offenzulegen?
Externer Wertzufluss: Wie bringt das Ökosystem nachhaltige, externe Einnahmen herein, sodass der Wert nicht nur in einem geschlossenen, spekulativen Kreislauf dreht?
Die Quintessenz: Vergessen wird teuer sein
OpenLedger ist kein garantiertes Home Run, aber es ist auch keine leere Hype-Maschine. Es nimmt einen kritischen Mittelweg ein. Es geht eine langfristige makroökonomische Wette ein, dass im kommenden Jahrzehnt die Intelligenz selbst zu einer liquiden, handelbaren Anlageklasse wird.
Wenn diese Wette aufgeht, ist die traditionelle Art, KI-Daten zu handhaben, völlig unhaltbar. Wir können die Zukunft der globalen Intelligenz nicht auf einer Grundlage von nicht anerkannten, nicht nachverfolgten menschlichen Beiträgen aufbauen.
Letztlich könnte der Erfolg von OpenLedger hier nicht einmal die Hauptgeschichte sein. Die eigentliche Erkenntnis ist, dass zukünftige KI-Ökonomien absolut ein System verlangen werden, das sich erinnert, wer sie aufgebaut hat. Denn wenn Intelligenz der Haupttreiber des globalen Reichtums wird, wird das Vergessen, wer dazu beigetragen hat, einfach zu teuer werden.