

Geschrieben von $Qubic Scientific Team
Neuraxon Intelligence Academy — Band 4
Das Wort Netzwerk taucht ständig sowohl in der Neurowissenschaft als auch in der künstlichen Intelligenz auf. Aber trotz des gleichen Labels sind biologische neuronale Netzwerke und künstliche neuronale Netzwerke grundlegend unterschiedliche Systeme. Um zu verstehen, was jedes tatsächlich tut und wo ein dritter Ansatz passt, müssen wir die Architektur und das Verhalten von Netzwerken auf jeder Ebene betrachten.
Biologische Neuronale Netzwerke: Wie das Gehirn Informationen verarbeitet
Ein biologisches neuronales Netzwerk ist ein System aus miteinander verbundenen Neuronen, dessen Funktion darin besteht, Informationen zu verarbeiten und Verhalten zu erzeugen. Diese Netzwerke sind dynamisch. Sie bleiben über die Zeit aktiv, auch wenn wir uns nicht bewusst mit irgendeiner Aufgabe beschäftigen. Sie verursachen energetische Kosten – und im Fall des menschlichen Gehirns sind diese erstaunlich niedrig gemessen an der Komplexität, die sie erzeugen.
Biologische Netzwerke integrieren sowohl interne als auch externe Signale mithilfe ihrer eigenen Sprache: Zeit-Frequenz. Stell dir eine Musikband mit mehreren Instrumenten vor, die in unterschiedlichen Rhythmen spielen. Die Bassdrum trägt das Tempo, der Bass spielt zwei Noten pro Takt, und die Becken füllen die Sechzehntelnoten. Die Melodie bewegt sich frei, ohne den Takt zu verlieren. Die Musiker koppeln ihre Partituren in verschiedenen Rhythmen, die perfekt zusammenpassen. Das sind verschachtelte Frequenzen, und genau so funktionieren Gehirnnetzwerke. Die Zeit-Frequenz-Sprache unterschiedlicher Netzwerke verschachtelt sich in sich selbst – ein Konzept, das als Cross-Frequency Coupling bekannt ist.
Von einzelnen Neuronen zu massiven Netzwerken
Alles beginnt beim Neuron. Diese einzelne Nervenzelle erzeugt ein Aktionspotenzial: einen kurzen elektrischen Impuls, der sich entlang des Axons fortpflanzt. Das Neuron erhält Signale über die Dendriten, integriert sie im Soma und überträgt das Signal, wenn es einen Schwellenwert überschreitet. Wir haben diesen Prozess im Detail in NIA Band 1: Why Intelligence Is Not Computed in Steps, but in Time und in NIA Band 2: Ternary Dynamics as a Model of Living Intelligence behandelt.
Neuronen verbinden sich mit anderen Neuronen über chemische Synapsen, bei denen Neurotransmitter freigesetzt werden (siehe NIA Band 3: Neuromodulation und brain-inspirierte KI), oder über elektrische Synapsen, bei denen der Strom direkt zwischen Zellen fließt. Um Netzwerke zu bilden, interagieren viele Neuronen miteinander und erzeugen rekurrente Schaltkreise. Doch diese Integration ist nichtlinear: Das Antwortverhalten des Ganzen entspricht nicht der einfachen Summe seiner Teile. Das Ausmaß ist überwältigend: Das menschliche Gehirn enthält ungefähr 86 Milliarden Neuronen und irgendwo zwischen 10¹⁴ und 10¹⁵ Synapsen (Azevedo et al., 2009).
Small-World-Eigenschaften und Gleichgewicht zwischen Erregung und Hemmung
Auf topologischer Ebene zeigen diese Netzwerke Small-World-Eigenschaften: eine hohe lokale Clusterung kombiniert mit kurzen globalen Verbindungen. Diese Architektur ermöglicht eine effiziente Kommunikation über das Gehirn hinweg, während die spezialisierte lokale Verarbeitung erhalten bleibt.
Die Funktion biologischer neuronaler Netzwerke hängt vom Gleichgewicht zwischen Erregung und Hemmung ab. Wenn die Erregung dominiert, destabilisiert sich die Aktivität. Wenn die Hemmung dominiert, wird das Netzwerk still. Dynamische Stabilität entsteht aus dem Gleichgewicht zwischen beiden Kräften. Dieses Gleichgewicht wird durch synaptische Plastizität aufrechterhalten – dem Mechanismus, der es erlaubt, dass sich die Stärke von Verbindungen basierend auf Erfahrung verändert. Darüber hinaus passt die Neuromodulation die Verstärkung (Gain) von Schaltkreisen an und steuert damit, wie stark ein Input einen Output erzeugt (Marder, 2012). In einer bedrohlichen Situation erhöht Noradrenalin zum Beispiel die sensorische Empfindlichkeit und die Fähigkeit für schnelles Lernen.
Mehrere Zeitskalen und Gehirnfunktion des Großhirns (Zerebraler Kortex)
Netzwerke arbeiten gleichzeitig in mehreren Zeitskalen. Auf der neuronalen Ebene feuern Aktionspotenziale in Millisekunden. Neuronale Oszillationen entfalten sich in Sekunden. Synaptische Veränderungen entwickeln sich über Stunden oder Tage, und strukturelle Umorganisation geschieht über Jahre. Alles funktioniert in einem harmonischen, dynamischen und miteinander verflochtenen Muster.
Aber nicht alles kommuniziert mit allem ohne Struktur. Die Gehirnfunktion des Kortex ist in spezialisierte Netzwerke organisiert. Zu den wichtigsten gehören das Default-Mode-Netzwerk, verbunden mit Selbstbezug und dem Nachdenken über sich selbst und andere; das zentrale Exekutivnetzwerk, verbunden mit der direkten Aufgaben-Ausführung; das Salienz-Netzwerk, das erkennt, was in jedem Moment relevant ist, und das Umschalten zwischen verschiedenen Modi ermöglicht; das Sensorimotor-Netzwerk, das freiwillige Bewegungen aufrechterhält; sowie verschiedene Aufmerksamkeitsnetzwerke. Menschen besitzen außerdem ein ausgeprägtes Sprachnetzwerk, das sowohl das Verstehen als auch die Produktion von Sprache ermöglicht.
In biologischen Netzwerken gibt es keine isolierte Note, die eine Symphonie wäre. Die Symphonie entsteht aus dem dynamischen Beziehungs-muster zwischen den Noten. Das Gehirn enthält keine Dinge. Es speichert Erinnerungen nicht so, wie eine Festplatte Dateien speichert. Das Gehirn erzeugt dynamische Konfigurationen.
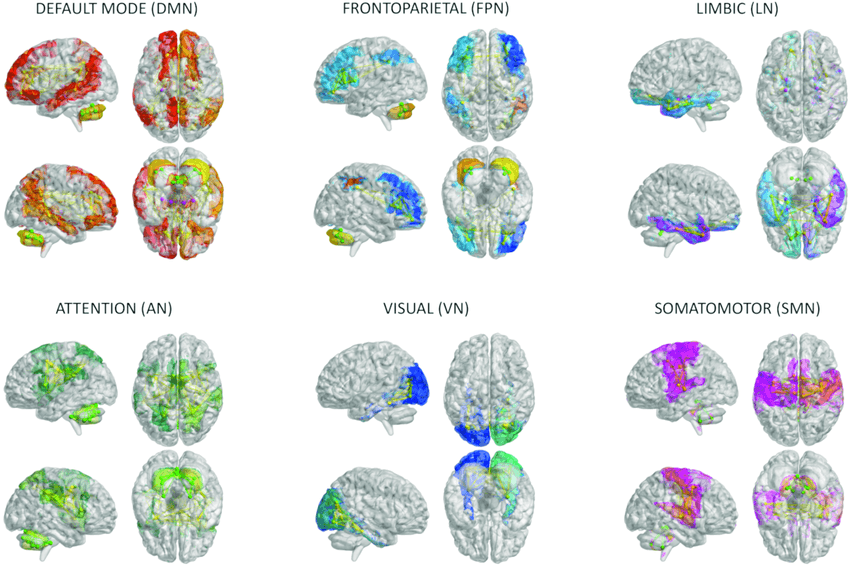 Mit freundlicher Genehmigung von DOI: 10.3389/fnagi.2023.1204134
Künstliche neuronale Netze: Wie Deep-Learning-Modelle funktionieren
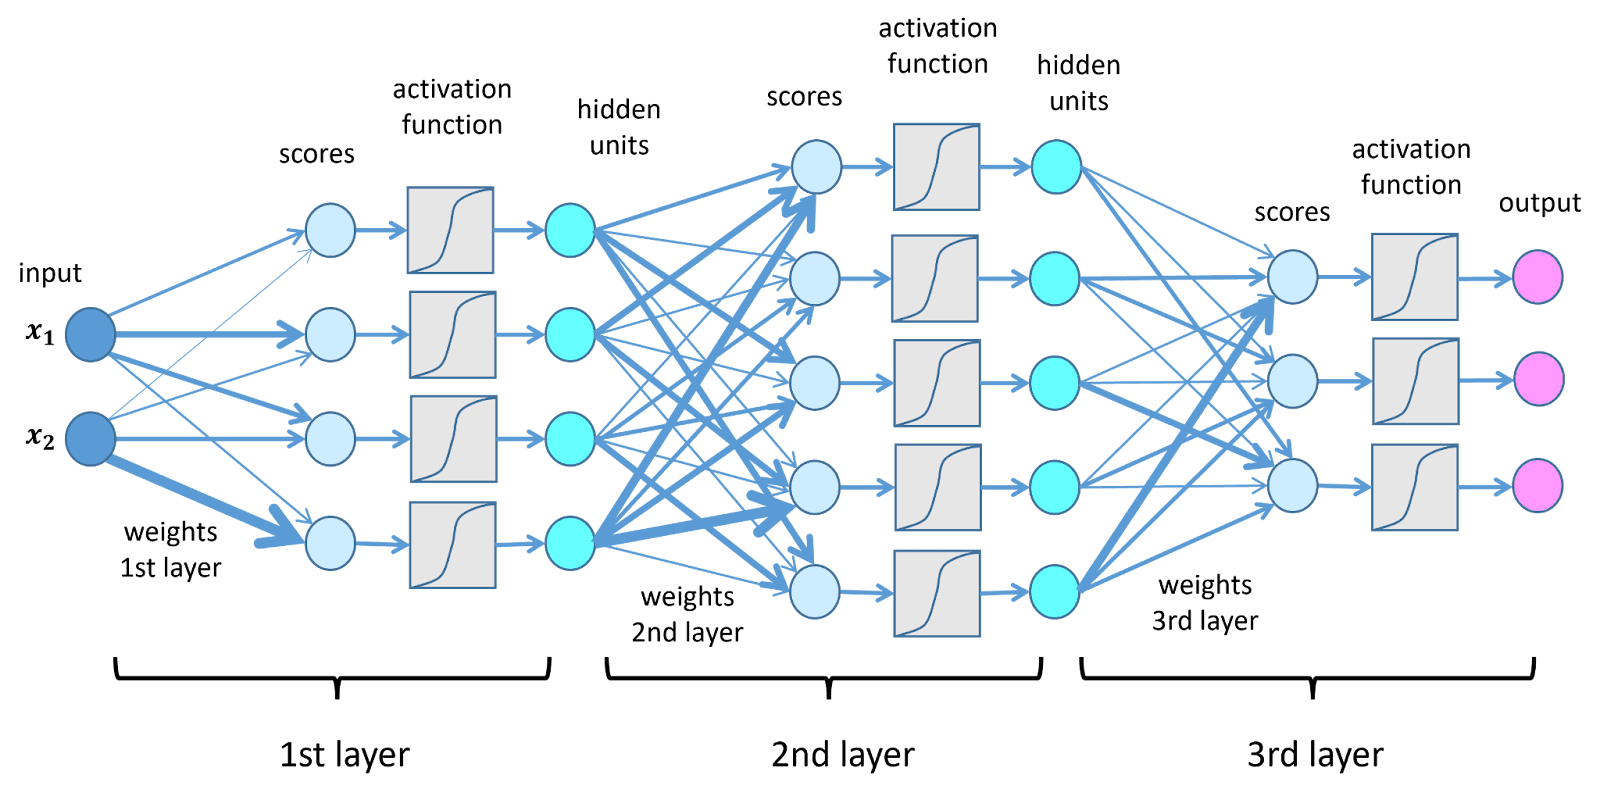
Ein künstliches neuronales Netz (ANN) ist ein mathematisches Modell, das entwickelt wurde, um komplexe Funktionen aus Daten zu approximieren. Es schöpft abstrakte Inspiration aus dem Gehirn: Es verwendet miteinander verbundene Einheiten namens „künstliche Neuronen“, aber das sind keine Zellen. Es sind algebraische Operationen. Eine algebraische Operation „Neuron“ zu nennen, ist vermutlich eine übertriebene Verallgemeinerung, und die Bezeichnung „Intelligenz“ für Sprachvorhersage könnte ebenso irreführend sein. Aber da es sich um etablierte Begriffe handelt, ist es wichtig, sie zu verstehen und Substanz von Hype zu trennen.
Wie ein künstliches Neuron funktioniert
Jedes künstliche Neuron führt drei Schritte aus. Zuerst erhält es eine Menge numerischer Eingaben. Dann multipliziert es jede Eingabe mit einem synaptischen Gewicht – einem einstellbaren Parameter. Schließlich summiert es die Ergebnisse und wendet eine Aktivierungsfunktion an, die Nichtlinearität einführt. Zu den gängigen Aktivierungsfunktionen gehört die Sigmoid-Funktion, die Werte zwischen 0 und 1 komprimiert, und ReLU (Rectified Linear Unit), die negative Werte aufhebt und positive durchlässt.
Ohne Nichtlinearität würde das Netzwerk einfach eine lineare Transformation durchführen – nicht in der Lage, komplexe Muster abzubilden. ANNs sind in Input-Layer organisiert, in die Daten eingehen; Hidden-Layer, in denen die Daten fortschreitend transformiert werden; und eine Output-Layer, die die Vorhersage erzeugt.
Vom Perceptron zum Deep Learning
Alle modernen Architekturen führen ihre Ursprünge auf das Perceptron zurück (Rosenblatt, 1958): ein einfaches lineares Neuron mit Schwelle. Moderne Deep-Learning-Netze können Hunderte von Schichten und Milliarden von Parametern enthalten. Aber im Kern funktioniert ein ANN wie eine enorme, automatisierte Tabellenkalkulation: Es passt Millionen numerischer Zellen an, bis der Output dem erwarteten Ergebnis entspricht.
Backpropagation und Gradientenabstieg: Wie künstliche Netzwerke lernen
Lernen in künstlichen Netzwerken funktioniert nicht so wie biologisches Lernen. Es gibt keine Anpassung von Neuromodulatoren oder synaptischer Intensität anhand gelebter Erfahrung. Stattdessen basiert Lernen auf dem Minimieren einer Fehlerfunktion, die die Differenz zwischen der Vorhersage des Netzwerks und der korrekten Lösung quantifiziert.
Betrachten wir ein einfaches Beispiel: Das Modell soll „Paris ist die Hauptstadt von …“ vervollständigen. Wenn die Vorhersage Italien ist, misst die Fehlerfunktion die Lücke zwischen Italien und Frankreich und passt dann die Gewichte entsprechend an. Das zentrale Prinzip hinter dieser Anpassung ist Backpropagation (Rumelhart et al., 1986). Dieser Algorithmus berechnet den Fehler am Ausgang, propagiert ihn schichtweise rückwärts und passt die Gewichte mit Gradientenabstieg an – einer mathematischen Methode, die Parameter in die Richtung verändert, die den Fehler reduziert.
Formal besteht Lernen darin, eine differenzierbare Funktion in einem Raum mit vielen Dimensionen zu optimieren. Wenn du an den physischen Raum denkst, sind die Dimensionen x, y und z. In Sprache stelle dir jedoch Dimensionen wie Singular, Plural, feminin, maskulin, Verb, Subjekt, Attribut, Nomen, Adjektiv, Intonation und Synonym vor. Führe Millionen solcher Dimensionen ein und genug Rechenleistung, und ein Modell kann lernen, dass Paris die Hauptstadt von Frankreich ist – ganz einfach, indem es während des Trainings die Vorhersagefehler reduziert.
Architekturen künstlicher neuronaler Netze
Obwohl die Terminologie sich mit der Neurowissenschaft überschneidet, ähnelt der Prozess nicht dem, wie ein lebendiges System lernt. In einem ANN hängt die Anpassung von einer globalen Berechnung und explizitem Wissen über den endgültigen Fehler ab. Das Netzwerk muss genau wissen, wie falsch es war.
Wenn ein Netzwerk lernt, Katzen zu erkennen, erhält es tausende oder Millionen beschrifteter Bilder. Jedes Mal, wenn es scheitert, passt es die Gewichte leicht an. Nach Millionen Iterationen stabilisiert sich das interne Muster in einer Konfiguration, die Katzen von anderen Objekten unterscheidet. Der Prozess ist rein statistisch. Das Netzwerk „versteht“ nicht, was eine Katze ist. Es erkennt numerische Korrelationen in Pixeln. Es hält kein „Weltmodell“ einer Katze – nur Matrizen aus Zahlen in massiven Maßstäben. Für einen tieferen Blick darauf, warum das wichtig ist, lies unsere Analyse dazu, warum Benchmarking-Weltmodelle lernen sollte.
Es gibt mehrere wichtige Architekturen künstlicher neuronaler Netze. Faltungsnetzwerke (CNNs) nutzen räumliche Filter, die Kanten, Texturen und hierarchische Muster erkennen, was sie für die Computer Vision unverzichtbar macht. Rekurrente Netzwerke (RNNs, LSTMs) integrieren zeitliche Erinnerung zur Verarbeitung von Sequenzen. Und die derzeit dominierenden Transformer verwenden Aufmerksamkeitsmechanismen, die dynamisch gewichten, welche Teile der Eingabe am relevantesten sind (Vaswani et al., 2017). Transformer treiben derzeit die meisten großen Sprachmodelle in der Verarbeitung natürlicher Sprache an.
Das Wachstum dieser Netzwerke geschieht nicht organisch wie in lebenden Systemen. Es geschieht durch explizites Design und Parameter-Skalierung mittels massiven Trainings in Hochleistungsrechenzentren. Anpassung ist auf den Trainingszeitraum beschränkt. Sobald das Netzwerk trainiert ist, reorganisiert es seine Architektur nicht spontan. Jede Änderung erfordert einen neuen Optimierungsprozess. Wie wir in That Static AI Is a Dead End untersucht haben, ist diese eingefrorene Natur eine grundlegende Einschränkung aktueller KI-Systeme.
Trotz der gemeinsamen Bezeichnung „Netzwerk“ ist die Ähnlichkeit zwischen künstlichen und biologischen neuronalen Netzen begrenzt. Die Analogie ist strukturell und abstrakt: Beide nutzen miteinander verbundene Einheiten und Lernen durch Anpassung der Verbindungen. Doch das Gehirn ist ein evolviertes, verkörpertes und selbstreguliertes System. Ein ANN ist ein Optimierer einer Funktion in einem numerischen Raum.
Zwischen biologischen und künstlichen Netzwerken: Wie Neuraxon Aigarth die Lücke überbrückt
Die Netzwerke, die in Neuraxon Aigarth simuliert werden, sind konzeptionell zwischen biologischen Netzwerken und konventionellen künstlichen neuronalen Netzwerken eingeordnet. Es handelt sich nicht um lebendiges Gewebe, aber auch nicht lediglich um mathematische Funktionen, die durch Gradienten optimiert werden. Ihr Ziel ist es, Dynamiken zu approximieren, die typisch für biologische Systeme sind – einschließlich mehrskaliger Plastizität, modulationsabhängiger Mechanismen je nach Kontext und Selbstorganisation – alles innerhalb eines rechnerischen Rahmens, der für Qubics dezentrale KI-Infrastruktur aufgebaut wurde.
Wenn wir in Band 1 selbstorganisierte metabolische Systeme beschrieben und in Band 2 differenzierbare Optimierungsfunktionen untersucht haben, versucht Neuraxon, die dynamischen Eigenschaften des ersteren zu integrieren, ohne die mathematische Formalisierung des letzteren aufzugeben.
Trivalente Zustände: Das Gleichgewicht zwischen Erregung und Hemmung abbilden
Anstelle typischer kontinuierlicher Aktivierungen (reelle Werte nach einer ReLU zum Beispiel) verwendet Neuraxon trivalente Zustände: -1, 0 und +1. Hier steht +1 für erregende Aktivierung, -1 für hemmende Aktivierung und 0 für Ruhe oder Inaktivität.
Dieses Schema versucht nicht, das biologische Aktionspotenzial zu kopieren. Stattdessen bildet es das funktionale Prinzip des Gleichgewichts zwischen Erregung und Hemmung ab, wie es im Abschnitt über biologische Netzwerke oben beschrieben ist. Im Gehirn entsteht Stabilität aus dem Gleichgewicht zwischen diesen Kräften. In Neuraxon erzwingt der diskrete Zustandsraum eine Dynamik, die näher an Zustands-Übergangssystemen liegt als an einfachen kontinuierlichen Transformationen.
Im Gegensatz zu klassischen künstlichen Netzwerken, bei denen die Aktivierung eine Gleitkommazahl ohne physiologische Bedeutung ist, erzwingt das trivalente System strukturelle Einschränkungen, die beeinflussen, wie sich Aktivität durch das Netzwerk ausbreitet.
Dual-Weight-Plastizität: Schnelles und langsames Lernen
Biologische neuronale Netze zeigen Plastizität in unterschiedlichen Zeitskalen: schnelle Veränderungen der synaptischen Wirksamkeit und eine langsamere Konsolidierung im Verlauf der Zeit. Neuraxon führt diese Idee über zwei Gewichtskomponenten ein:
w_fast: schnelle Veränderungen, die empfindlich auf die unmittelbare Umgebung reagieren.
w_slow: langsame Veränderungen, die wiederholte Muster über die Zeit stabilisieren.
Das verhindert, dass das System sich ausschließlich auf eine homogene Gewichtsaktualisierung verlässt wie bei standardmäßiger Backpropagation. Ein Teil des Lernens kann transient sein, während ein anderer Teil nach und nach konsolidiert wird. Dieser Mechanismus führt eine Dimension ein, die in den meisten künstlichen neuronalen Netzen fehlt: Die Lernrate ist nicht fest, sondern hängt vom globalen Zustand des Systems ab.
Kontextuelle Neuromodulation über die Meta-Variable
In biologischen Netzwerken übertragen Neuromodulatoren wie Noradrenalin und Dopamin keinen spezifischen Informationsgehalt. Stattdessen verändern sie die Verstärkung (Gain) und die Plastizität breiter Populationen von Neuronen. Wir haben das ausführlich in NIA Band 3: Neuromodulation und Brain-Inspired AI untersucht.
In Neuraxon spielt die Variable meta eine funktional analoge Rolle. Sie codiert keine spezifischen Informationen, sondern verändert die Größe (Amplitude) der synaptischen Aktualisierung. Das entspricht dem biologischen Prinzip, dass Lernen von motivationalen oder salienzbezogenen Kontexten abhängt. In einem konventionellen künstlichen Netzwerk wird der Gradient gleichmäßig basierend auf dem Fehler angewendet. In Neuraxon kann das Lernen je nach internem Zustand oder globalen externen Signalen verstärkt oder abgeschwächt werden.
Der konzeptionelle Unterschied ist erheblich. In klassischen Deep-Learning-Netzwerken treibt Fehler das Lernen an. In Neuraxon kann Fehler gleichzeitig mit einem kontextmodulatorischen Signal existieren, das beeinflusst, wie viel in jedem gegebenen Moment gelernt wird.
Selbstorganisierte Kritikalität und adaptives Verhalten
Biologische Netzwerke arbeiten nahe an einem Regime, das als selbstorganisierte Kritikalität bezeichnet wird, in dem das System ein Gleichgewicht zwischen Ordnung und Chaos aufrechterhält. Dieses Regime ermöglicht Flexibilität ohne Stabilitätsverlust.
Neuraxon modelliert diese Eigenschaft, indem es dem Netzwerk erlaubt, sich hin zu Zwischen-Zuständen dynamischer Stabilität zu entwickeln, in denen kleine Störungen breite Umorganisationen auslösen können, ohne das System zum Einsturz zu bringen.
In Modellen wie dem Game of Life, erweitert um Propriozeption, dass das Team aktuell entwickelt, kann das System externe Signale (Umgebung) und interne Signale (seinen eigenen Zustand, Energie, frühere Kollisionen) empfangen. Wenn ein Agent wiederholt mit einem Hindernis kollidiert, kann eine Erhöhung des Meta-Signals generiert werden – analog zu einer Erhöhung der Erregung. Dieses Signal erhöht vorübergehend die Plastizität und erleichtert eine strukturelle Umorganisation.
Hier lernt das Netzwerk nicht nur, weil es Fehler macht. Es lernt, weil die Umwelt eine adaptive Relevanz erhält. Die Ähnlichkeit mit dem Gehirn bleibt begrenzt: Neuraxon besitzt keine Biologie, keinen Stoffwechsel und keine subjektive Erfahrung. Allerdings führt es dynamische Dimensionen ein, die in den meisten konventionellen künstlichen neuronalen Netzen fehlen – und positioniert es als einen wirklich neuartigen Ansatz für brain-inspirierte KI auf dezentraler Infrastruktur.
Die Rechenleistung, die benötigt wird, um Neuraxon-Simulationen auszuführen, wird durch das globale Netzwerk von Minern von Qubic bereitgestellt – über Useful Proof of Work. So wird das Trainieren von KI selbst zum Konsensmechanismus.
Wissenschaftliche Referenzen
#Azevedo, F. A. C., et al. (2009). Gleiche Zahlen von neuronalen und nicht-neuronalen Zellen machen das menschliche Gehirn zu einem isometrisch vergrößerten Primatenhirn. Journal of Comparative Neurology, 513(5), 532-541. DOI: 10.1002/cne.21974
#Marder, E. (2012). Neuromodulation of neuronal circuits: Back to the future. Neuron, 76(1), 1-11. DOI: 10.1016/j.neuron.2012.09.010
#Rosenblatt, F. (1958). The Perceptron: A probabilistic model for information storage and organization in the brain. Psychological Review, 65(6), 386-408. DOI: 10.1037/h0042519
#Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323(6088), 533-536. DOI: 10.1038/323533a0
#Vaswani, A., et al. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30. arXiv: 1706.03762
Bilder von Gehirnnetzwerken mit freundlicher Genehmigung von: DOI: 10.3389/fnagi.2023.1204134