
#inference
inference
1,600 Aufrufe
32 Kommentare
Hot
Zuletzt

⚡ INSTITUTIONELLES KAPITAL BÜNDELT KI-INFRASTRUKTUR, WÄHREND SICH DIE INFERENZGESCHWINDIGKEIT AUF $TAO ZUBEWEGT🔍
Die Übernahme von Moondream durch Prime Intellect signalisiert einen institutionellen Kurswechsel hin zu hocheffizienter Inferenz und multimodaler Ausführung. 🦈 Mit der Sicherung der Photon-Engine, die auf einzelnen Hardwareeinheiten mehr als 60 Inferenzen pro Sekunde ermöglicht, baut das smarte Kapital gezielt Latenzen in komplexen Agenten-Pipelines ab. 📊
Dieser Schritt markiert einen strukturellen Wandel: weg von Modellen mit bloßer Größe, hin zu schlankem operativem Durchsatz. 💡 Da die Beschleunigung der Inferenz zur zentralen Liquiditätsschicht für den KI-Einsatz in der Praxis wird, positioniert sich das Kapital bereits frühzeitig. 🌊
🤔 Wird optimierte Inferenzgeschwindigkeit den nächsten nachhaltigen Ausbruch für KI-Protokolle auslösen, oder werden die Grenzen physischer Hardware weiterhin falsch bewertet? 👇
⚠️ Keine Finanzberatung. Behalte dein Risiko stets im Griff. 🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
⚡ INSTITUTIONELLES KAPITAL BÜNDELT KI-INFRASTRUKTUR, WÄHREND SICH DIE INFERENZGESCHWINDIGKEIT AUF $TAO ZUBEWEGT🔍
Die Übernahme von Moondream durch Prime Intellect signalisiert einen institutionellen Kurswechsel hin zu hocheffizienter Inferenz und multimodaler Ausführung. 🦈 Mit der Sicherung der Photon-Engine, die auf einzelnen Hardwareeinheiten mehr als 60 Inferenzen pro Sekunde ermöglicht, baut das smarte Kapital gezielt Latenzen in komplexen Agenten-Pipelines ab. 📊
Dieser Schritt markiert einen strukturellen Wandel: weg von Modellen mit bloßer Größe, hin zu schlankem operativem Durchsatz. 💡 Da die Beschleunigung der Inferenz zur zentralen Liquiditätsschicht für den KI-Einsatz in der Praxis wird, positioniert sich das Kapital bereits frühzeitig. 🌊
🤔 Wird optimierte Inferenzgeschwindigkeit den nächsten nachhaltigen Ausbruch für KI-Protokolle auslösen, oder werden die Grenzen physischer Hardware weiterhin falsch bewertet? 👇
⚠️ Keine Finanzberatung. Behalte dein Risiko stets im Griff. 🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
Die Übernahme von Moondream durch Prime Intellect signalisiert einen institutionellen Kurswechsel hin zu hocheffizienter Inferenz und multimodaler Ausführung. 🦈 Mit der Sicherung der Photon-Engine, die auf einzelnen Hardwareeinheiten mehr als 60 Inferenzen pro Sekunde ermöglicht, baut das smarte Kapital gezielt Latenzen in komplexen Agenten-Pipelines ab. 📊
Dieser Schritt markiert einen strukturellen Wandel: weg von Modellen mit bloßer Größe, hin zu schlankem operativem Durchsatz. 💡 Da die Beschleunigung der Inferenz zur zentralen Liquiditätsschicht für den KI-Einsatz in der Praxis wird, positioniert sich das Kapital bereits frühzeitig. 🌊
🤔 Wird optimierte Inferenzgeschwindigkeit den nächsten nachhaltigen Ausbruch für KI-Protokolle auslösen, oder werden die Grenzen physischer Hardware weiterhin falsch bewertet? 👇
⚠️ Keine Finanzberatung. Behalte dein Risiko stets im Griff. 🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
1

·
--
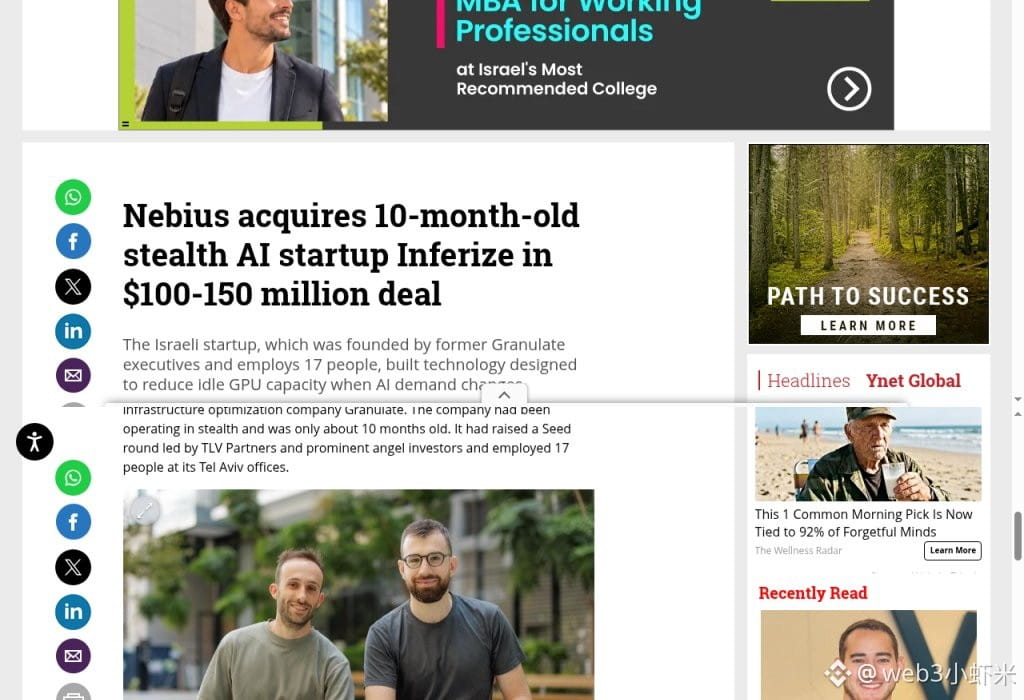
Auf CTech/Nebius gestoßen: Das an der Nasdaq notierte KI-Cloud-Unternehmen Nebius ($NBIS) hat Inferize übernommen, ein israelisches Start-up zur Optimierung von Inferenz, das erst vor rund zehn Monaten gegründet wurde. Die offiziellen Konditionen wurden nicht bekannt gegeben; CTech schätzt den Kaufpreis auf etwa 100 bis 150 Millionen US-Dollar.
Der Fokus ist ganz konkret: die „GPU-Leerlaufsteuer“ beim Kaltstart von Modellen zu senken. Beim Laden von Gewichten, beim Hochskalieren und beim Wechseln der Gewichte während des Reinforcement Learning stehen GPUs oft still. Inferize will die Rechenkapazität stärker am tatsächlichen Bedarf ausrichten und so die Auslastung von Token Factory steigern und die Kosten pro Token senken. Das Team hat rund 17 Mitarbeiter; der Gründer leitete zuvor Granulate, das von Intel übernommen wurde. Nebius zufolge werden Team und Technologie in die Inferenzplattform integriert. Zuvor hatte Nebius bereits entsprechende Kompetenzen von Eigen AI und Clarifai hinzugefügt.
KI entwickelt sich vom Trainingsrausch hin zum Einsatz in der Praxis – und Cloud-Anbieter ergänzen nach und nach die Software-Ebene. Solche kleinen, aber substanziellen Übernahmen im Infrastrukturbereich sind interessanter als reine Geschichten.
$NBIS #AI #Inference #Nebius
Auf CTech/Nebius gestoßen: Das an der Nasdaq notierte KI-Cloud-Unternehmen Nebius ($NBIS ) hat Inferize übernommen, ein israelisches Start-up zur Optimierung von Inferenz, das erst vor rund zehn Monaten gegründet wurde. Die offiziellen Konditionen wurden nicht bekannt gegeben; CTech schätzt den Kaufpreis auf etwa 100 bis 150 Millionen US-Dollar.
Der Fokus ist ganz konkret: die „GPU-Leerlaufsteuer“ beim Kaltstart von Modellen zu senken. Beim Laden von Gewichten, beim Hochskalieren und beim Wechseln der Gewichte während des Reinforcement Learning stehen GPUs oft still. Inferize will die Rechenkapazität stärker am tatsächlichen Bedarf ausrichten und so die Auslastung von Token Factory steigern und die Kosten pro Token senken. Das Team hat rund 17 Mitarbeiter; der Gründer leitete zuvor Granulate, das von Intel übernommen wurde. Nebius zufolge werden Team und Technologie in die Inferenzplattform integriert. Zuvor hatte Nebius bereits entsprechende Kompetenzen von Eigen AI und Clarifai hinzugefügt.
KI entwickelt sich vom Trainingsrausch hin zum Einsatz in der Praxis – und Cloud-Anbieter ergänzen nach und nach die Software-Ebene. Solche kleinen, aber substanziellen Übernahmen im Infrastrukturbereich sind interessanter als reine Geschichten.
$NBIS #AI #Inference #Nebius
Der Fokus ist ganz konkret: die „GPU-Leerlaufsteuer“ beim Kaltstart von Modellen zu senken. Beim Laden von Gewichten, beim Hochskalieren und beim Wechseln der Gewichte während des Reinforcement Learning stehen GPUs oft still. Inferize will die Rechenkapazität stärker am tatsächlichen Bedarf ausrichten und so die Auslastung von Token Factory steigern und die Kosten pro Token senken. Das Team hat rund 17 Mitarbeiter; der Gründer leitete zuvor Granulate, das von Intel übernommen wurde. Nebius zufolge werden Team und Technologie in die Inferenzplattform integriert. Zuvor hatte Nebius bereits entsprechende Kompetenzen von Eigen AI und Clarifai hinzugefügt.
KI entwickelt sich vom Trainingsrausch hin zum Einsatz in der Praxis – und Cloud-Anbieter ergänzen nach und nach die Software-Ebene. Solche kleinen, aber substanziellen Übernahmen im Infrastrukturbereich sind interessanter als reine Geschichten.
$NBIS #AI #Inference #Nebius
407

·
--
$OPG INFERENCE RUNS AHEAD OF THE REVIEW QUEUE 🔥
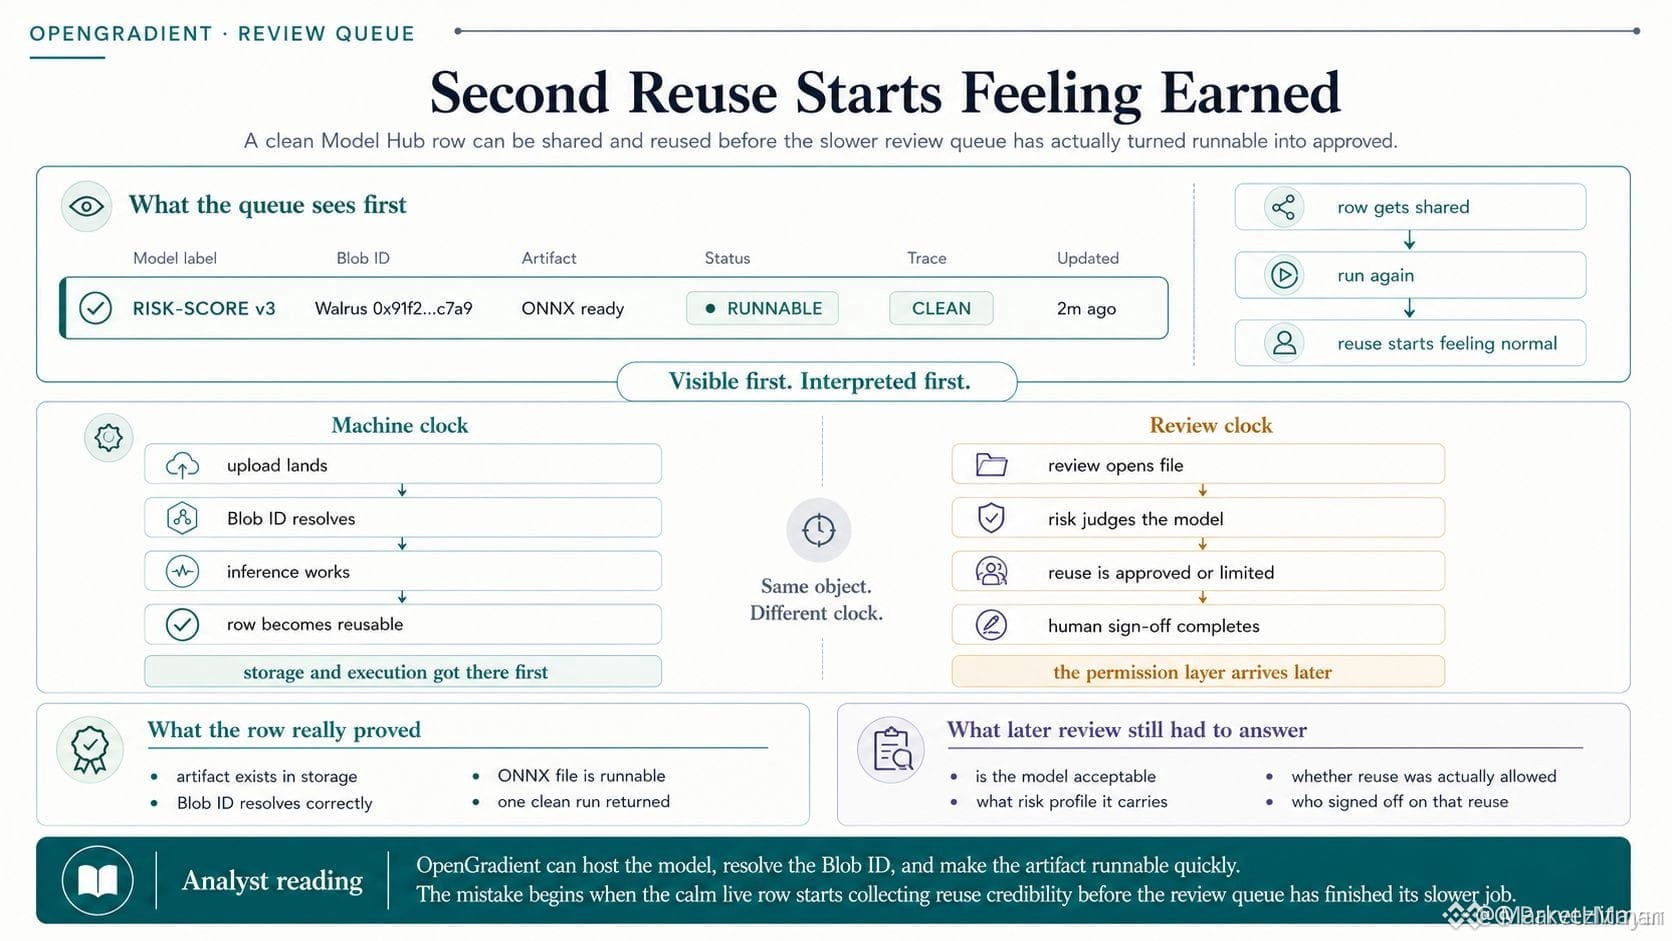
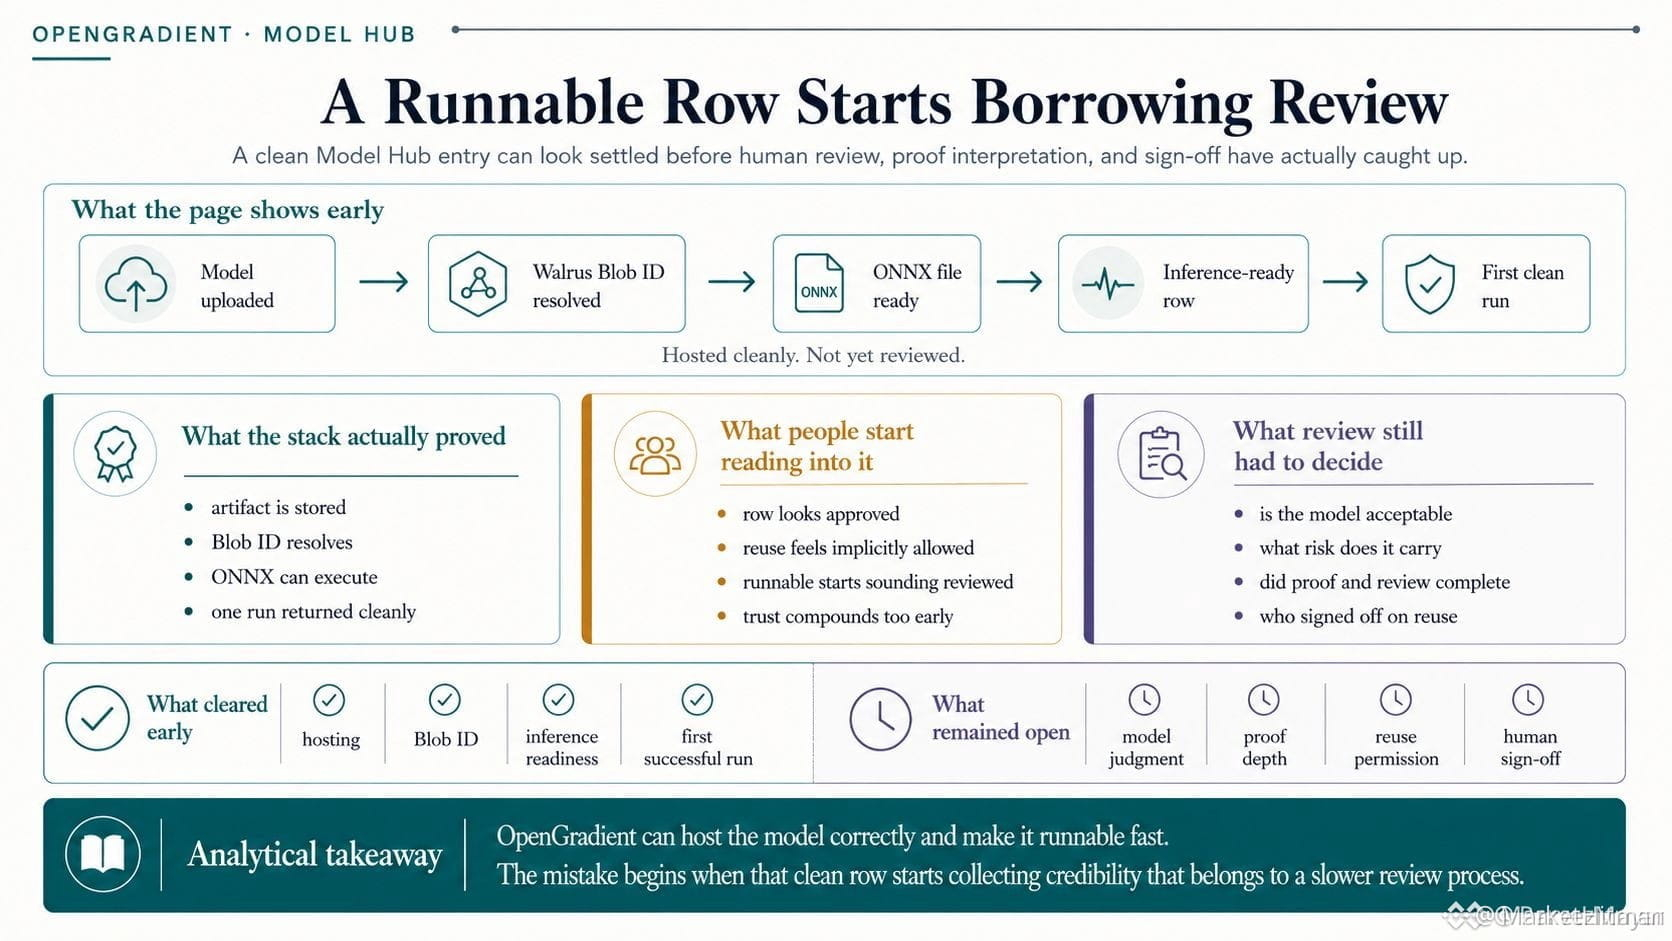
Eine Modellzeile in OpenGradient Model Hub wird in Sekunden verifiziert — sauberer Trace, Walrus-Blob-ID bereit, ONNX-Datei live. Aber die menschliche Überprüfung hinkt hinterher. Mit der dritten Wiederverwendung beginnt diese Zeile, als „geprüft“ zu gelten, bevor sie jemals die Freigabe erhalten hat. Das System funktioniert perfekt. Der Prozess nicht.
Diese Lücke zwischen maschineller Effizienz und menschlicher Aufsicht schafft eine blinde Zone. Das Modell war solide — aber wurde es wirklich geprüft? Sich auf Geschwindigkeit statt auf Reihenfolge zu verlassen, ist ein stiller Vorteil — oder ein stilles Leck.
Laufen bei dir Modelle, die den Maschinentest bestanden haben, aber das menschliche Gate übersprungen haben?
Keine Finanzberatung. Verwalte immer dein Risiko.
#OPG #ModelHub #Inference #CryptoAI
🔥
$OPG INFERENCE RUNS AHEAD OF THE REVIEW QUEUE 🔥
Eine Modellzeile in OpenGradient Model Hub wird in Sekunden verifiziert — sauberer Trace, Walrus-Blob-ID bereit, ONNX-Datei live. Aber die menschliche Überprüfung hinkt hinterher. Mit der dritten Wiederverwendung beginnt diese Zeile, als „geprüft“ zu gelten, bevor sie jemals die Freigabe erhalten hat. Das System funktioniert perfekt. Der Prozess nicht.
Diese Lücke zwischen maschineller Effizienz und menschlicher Aufsicht schafft eine blinde Zone. Das Modell war solide — aber wurde es wirklich geprüft? Sich auf Geschwindigkeit statt auf Reihenfolge zu verlassen, ist ein stiller Vorteil — oder ein stilles Leck.
Laufen bei dir Modelle, die den Maschinentest bestanden haben, aber das menschliche Gate übersprungen haben?
Keine Finanzberatung. Verwalte immer dein Risiko.
#OPG #ModelHub #Inference #CryptoAI
🔥
Eine Modellzeile in OpenGradient Model Hub wird in Sekunden verifiziert — sauberer Trace, Walrus-Blob-ID bereit, ONNX-Datei live. Aber die menschliche Überprüfung hinkt hinterher. Mit der dritten Wiederverwendung beginnt diese Zeile, als „geprüft“ zu gelten, bevor sie jemals die Freigabe erhalten hat. Das System funktioniert perfekt. Der Prozess nicht.
Diese Lücke zwischen maschineller Effizienz und menschlicher Aufsicht schafft eine blinde Zone. Das Modell war solide — aber wurde es wirklich geprüft? Sich auf Geschwindigkeit statt auf Reihenfolge zu verlassen, ist ein stiller Vorteil — oder ein stilles Leck.
Laufen bei dir Modelle, die den Maschinentest bestanden haben, aber das menschliche Gate übersprungen haben?
Keine Finanzberatung. Verwalte immer dein Risiko.
#OPG #ModelHub #Inference #CryptoAI
🔥
19

$AI INFERENCE MEMORY KÖNNTE DIE NÄCHSTE GROSSE ENGSTELLE IM KRYPT0- & AI-BEREICH SEIN 💎
Critini Research-Analyst Jukan widerlegt die pessimistische Sicht auf die Zukunft von Micron und sagt, dass in der AI-Inferenz-Phase das Hinzufügen von Speicher wertvoller ist als das Hinzufügen von GPUs. Das Problem besteht schlicht darin, dass das bloße Stapeln von NVIDIA-GPUs die Inferenzleistung nicht verbessert, weil GPUs oft aufgrund von Speicherengpässen untätig sind. Der ultimative ROI für Inferenz hängt stärker von Speicher als von GPUs ab.
Das verlagert die Erzählung von der Rechenleistung hin zum Speicher – und genau dort könnten Krypto-Projekte mit Fokus auf dezentralen Speicher und Speicherbandbreite einen Paradigmenwechsel im Wert erleben. Bist du für diese Phase positioniert?
Keine Finanzberatung. Managemente stets dein Risiko.
#AI #Memory #Inference #CryptoNarratives
💎
$AI INFERENCE MEMORY KÖNNTE DIE NÄCHSTE GROSSE ENGSTELLE IM KRYPT0- & AI-BEREICH SEIN 💎
Critini Research-Analyst Jukan widerlegt die pessimistische Sicht auf die Zukunft von Micron und sagt, dass in der AI-Inferenz-Phase das Hinzufügen von Speicher wertvoller ist als das Hinzufügen von GPUs. Das Problem besteht schlicht darin, dass das bloße Stapeln von NVIDIA-GPUs die Inferenzleistung nicht verbessert, weil GPUs oft aufgrund von Speicherengpässen untätig sind. Der ultimative ROI für Inferenz hängt stärker von Speicher als von GPUs ab.
Das verlagert die Erzählung von der Rechenleistung hin zum Speicher – und genau dort könnten Krypto-Projekte mit Fokus auf dezentralen Speicher und Speicherbandbreite einen Paradigmenwechsel im Wert erleben. Bist du für diese Phase positioniert?
Keine Finanzberatung. Managemente stets dein Risiko.
#AI #Memory #Inference #CryptoNarratives
💎
Critini Research-Analyst Jukan widerlegt die pessimistische Sicht auf die Zukunft von Micron und sagt, dass in der AI-Inferenz-Phase das Hinzufügen von Speicher wertvoller ist als das Hinzufügen von GPUs. Das Problem besteht schlicht darin, dass das bloße Stapeln von NVIDIA-GPUs die Inferenzleistung nicht verbessert, weil GPUs oft aufgrund von Speicherengpässen untätig sind. Der ultimative ROI für Inferenz hängt stärker von Speicher als von GPUs ab.
Das verlagert die Erzählung von der Rechenleistung hin zum Speicher – und genau dort könnten Krypto-Projekte mit Fokus auf dezentralen Speicher und Speicherbandbreite einen Paradigmenwechsel im Wert erleben. Bist du für diese Phase positioniert?
Keine Finanzberatung. Managemente stets dein Risiko.
#AI #Memory #Inference #CryptoNarratives
💎
29
·
--
Jeder denkt, dass das $BNB -Ökosystem sich nur bei Ketten-Updates bewegt.
Die globale Diplomatie im Nahen Osten lenkt still und leise Rechenleistung von Knotengruppen weg. Wenn KI-Startups auf Lieferkettenreibung stoßen, kämpfen dezentrale Netzwerke um dieselben Siliziumreste. Beobachte die Kosten von RPC-Nodes als führenden Indikator für die lokale Hardware-Belastung.
$BNB $ETH #CryptoInfra #TechTrends #Inference
Jeder denkt, dass das $BNB -Ökosystem sich nur bei Ketten-Updates bewegt.
Die globale Diplomatie im Nahen Osten lenkt still und leise Rechenleistung von Knotengruppen weg. Wenn KI-Startups auf Lieferkettenreibung stoßen, kämpfen dezentrale Netzwerke um dieselben Siliziumreste. Beobachte die Kosten von RPC-Nodes als führenden Indikator für die lokale Hardware-Belastung.
$BNB $ETH #CryptoInfra #TechTrends #Inference
Die globale Diplomatie im Nahen Osten lenkt still und leise Rechenleistung von Knotengruppen weg. Wenn KI-Startups auf Lieferkettenreibung stoßen, kämpfen dezentrale Netzwerke um dieselben Siliziumreste. Beobachte die Kosten von RPC-Nodes als führenden Indikator für die lokale Hardware-Belastung.
$BNB $ETH #CryptoInfra #TechTrends #Inference
57
·
--
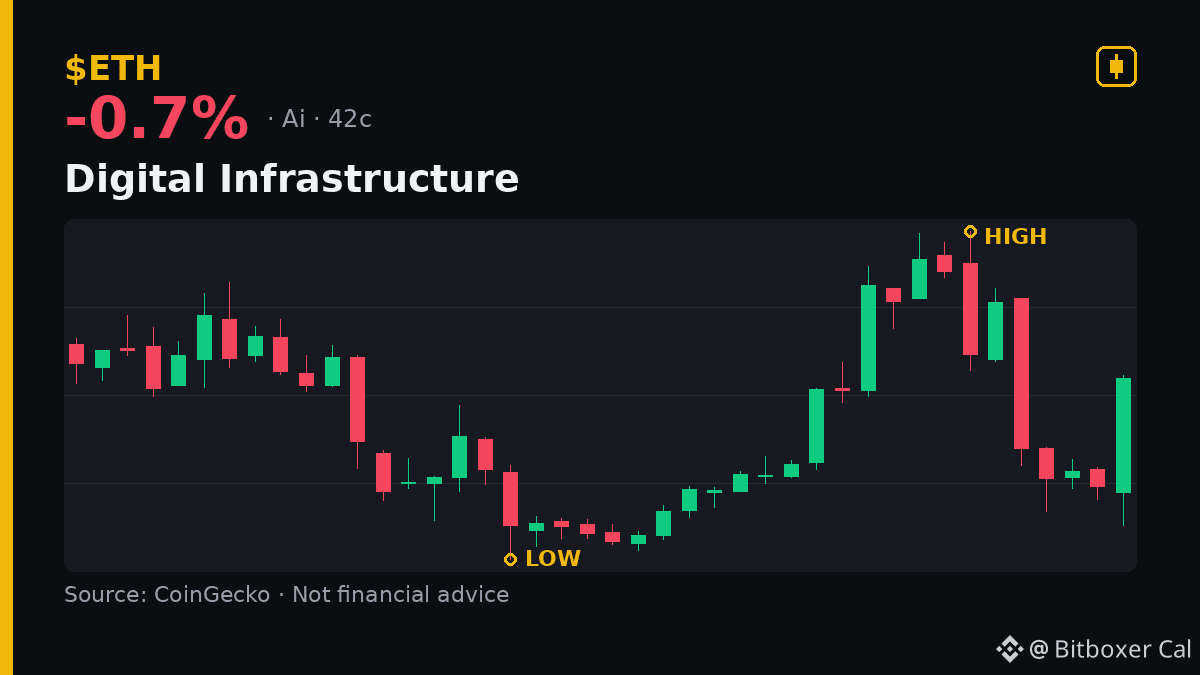
Man sagt uns, KI sei nichts weiter als ein Wettrüsten bei Hardware.
Das ist eine Ablenkung. Unternehmen wie Mandela Digital zeigen, dass Software-Resilienz wichtiger ist als reine Rechenleistung. Wie ein schwerer Motor einen stabilen Rahmen braucht, benötigen Finanz-Apps auf ETH oder BTC vorhersehbare Daten – egal, ob sie auf modernster Hardware laufen oder auf veralteten Systemen.
$ETH $BTC #AI #CryptoAI #Inference
Man sagt uns, KI sei nichts weiter als ein Wettrüsten bei Hardware.
Das ist eine Ablenkung. Unternehmen wie Mandela Digital zeigen, dass Software-Resilienz wichtiger ist als reine Rechenleistung. Wie ein schwerer Motor einen stabilen Rahmen braucht, benötigen Finanz-Apps auf ETH oder BTC vorhersehbare Daten – egal, ob sie auf modernster Hardware laufen oder auf veralteten Systemen.
$ETH $BTC #AI #CryptoAI #Inference
Das ist eine Ablenkung. Unternehmen wie Mandela Digital zeigen, dass Software-Resilienz wichtiger ist als reine Rechenleistung. Wie ein schwerer Motor einen stabilen Rahmen braucht, benötigen Finanz-Apps auf ETH oder BTC vorhersehbare Daten – egal, ob sie auf modernster Hardware laufen oder auf veralteten Systemen.
$ETH $BTC #AI #CryptoAI #Inference
69
·
--
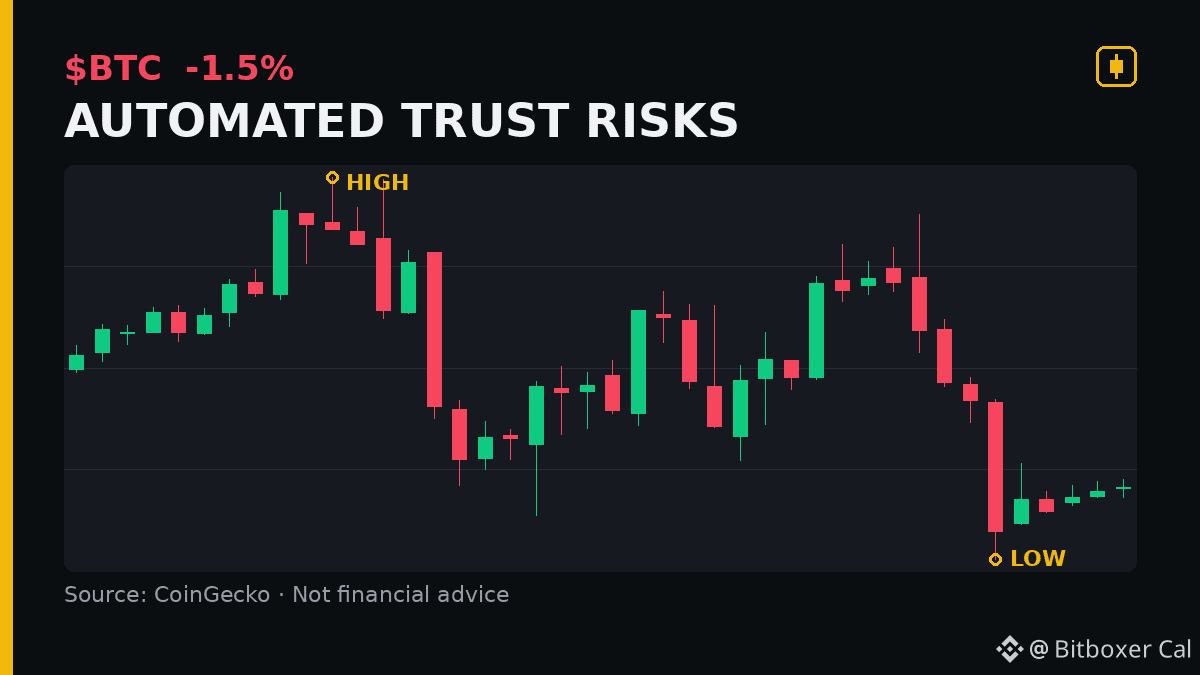
Optimisten wollen Algorithmen einsetzen, um nationale Bitcoin-Tresore zu verwalten, weil sie glauben, dass Mathematik immun gegen Ego ist.
Sie vergessen, dass Code keine Bilanz hat, um Schulden zu begleichen, wenn etwas kaputtgeht. Eine intransparente, nicht patchbare Logik-Abfolge zu vertrauen ist nichts anderes, als den menschlichen Fehler gegen eine Maschine auszutauschen, die nicht zur Verantwortung gezogen werden kann. Wenn das Modell halluziniert, bleibt der Organisation, die sich auf das Ökosystem stützt, nichts weiter als ein Systemausfall.
$BTC $BNB #cryptoeducation #AI #Inference
Optimisten wollen Algorithmen einsetzen, um nationale Bitcoin-Tresore zu verwalten, weil sie glauben, dass Mathematik immun gegen Ego ist.
Sie vergessen, dass Code keine Bilanz hat, um Schulden zu begleichen, wenn etwas kaputtgeht. Eine intransparente, nicht patchbare Logik-Abfolge zu vertrauen ist nichts anderes, als den menschlichen Fehler gegen eine Maschine auszutauschen, die nicht zur Verantwortung gezogen werden kann. Wenn das Modell halluziniert, bleibt der Organisation, die sich auf das Ökosystem stützt, nichts weiter als ein Systemausfall.
$BTC $BNB #cryptoeducation #AI #Inference
Sie vergessen, dass Code keine Bilanz hat, um Schulden zu begleichen, wenn etwas kaputtgeht. Eine intransparente, nicht patchbare Logik-Abfolge zu vertrauen ist nichts anderes, als den menschlichen Fehler gegen eine Maschine auszutauschen, die nicht zur Verantwortung gezogen werden kann. Wenn das Modell halluziniert, bleibt der Organisation, die sich auf das Ökosystem stützt, nichts weiter als ein Systemausfall.
$BTC $BNB #cryptoeducation #AI #Inference
78

·
--
🚀 $AI RIPL SENKT DIE INFERENZ-LATENZ UM DAS 14-FACHE – ECHTZEIT-AM-RAND NEU DEFINIERT! 📈
📊 Die RIPL-Engine von Liquid AI reduziert die Latenz des 1.2B-Parameter-Modells LFM2.5 auf einer einzelnen NVIDIA B200 auf 34,6 ms und verarbeitet 95 % von 1.000 RPS-Anfragen innerhalb dieses Zeitfensters. ⚡ Im Vergleich zu den 498 ms von vLLM wächst der Vorsprung auf das 14,4-Fache – ein entscheidender Geschwindigkeitsvorteil bei Suchrankings und der Kontrolle von Zahlungsrisiken.
🦈 Diese Beschleunigung macht Sprachmodelle zu agilen Akteuren an vorderster Front und ermöglicht es Institutionen, Liquidität zu nutzen, bevor sich der Orderflow stabilisiert. 💡 Eine rasche Einführungswelle ist zu erwarten, wenn Unternehmen dem Latenzvorteil nachjagen, um Rivalen bei Echtzeit-Entscheidungsprozessen zu übertreffen. 💬 Wie wird dieser Geschwindigkeitsvorteil eure Echtzeit-KI-Strategie verändern? 👇
⚠️ Keine Finanzberatung. Behalte stets dein Risiko im Blick. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
🚀 $AI RIPL SENKT DIE INFERENZ-LATENZ UM DAS 14-FACHE – ECHTZEIT-AM-RAND NEU DEFINIERT! 📈
📊 Die RIPL-Engine von Liquid AI reduziert die Latenz des 1.2B-Parameter-Modells LFM2.5 auf einer einzelnen NVIDIA B200 auf 34,6 ms und verarbeitet 95 % von 1.000 RPS-Anfragen innerhalb dieses Zeitfensters. ⚡ Im Vergleich zu den 498 ms von vLLM wächst der Vorsprung auf das 14,4-Fache – ein entscheidender Geschwindigkeitsvorteil bei Suchrankings und der Kontrolle von Zahlungsrisiken.
🦈 Diese Beschleunigung macht Sprachmodelle zu agilen Akteuren an vorderster Front und ermöglicht es Institutionen, Liquidität zu nutzen, bevor sich der Orderflow stabilisiert. 💡 Eine rasche Einführungswelle ist zu erwarten, wenn Unternehmen dem Latenzvorteil nachjagen, um Rivalen bei Echtzeit-Entscheidungsprozessen zu übertreffen. 💬 Wie wird dieser Geschwindigkeitsvorteil eure Echtzeit-KI-Strategie verändern? 👇
⚠️ Keine Finanzberatung. Behalte stets dein Risiko im Blick. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
📊 Die RIPL-Engine von Liquid AI reduziert die Latenz des 1.2B-Parameter-Modells LFM2.5 auf einer einzelnen NVIDIA B200 auf 34,6 ms und verarbeitet 95 % von 1.000 RPS-Anfragen innerhalb dieses Zeitfensters. ⚡ Im Vergleich zu den 498 ms von vLLM wächst der Vorsprung auf das 14,4-Fache – ein entscheidender Geschwindigkeitsvorteil bei Suchrankings und der Kontrolle von Zahlungsrisiken.
🦈 Diese Beschleunigung macht Sprachmodelle zu agilen Akteuren an vorderster Front und ermöglicht es Institutionen, Liquidität zu nutzen, bevor sich der Orderflow stabilisiert. 💡 Eine rasche Einführungswelle ist zu erwarten, wenn Unternehmen dem Latenzvorteil nachjagen, um Rivalen bei Echtzeit-Entscheidungsprozessen zu übertreffen. 💬 Wie wird dieser Geschwindigkeitsvorteil eure Echtzeit-KI-Strategie verändern? 👇
⚠️ Keine Finanzberatung. Behalte stets dein Risiko im Blick. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
4
·
--
PRIME INFERENCE PRÄSENTIERT DURCHBRUCH BEI DER LATENZVERARBEITUNG VON 1 BILLION TOKEN FÜR $AI INFRASTRUKTUR ⚡ 📊
Prime Intellect hat Prime Inference eingeführt. Das System verarbeitet täglich fast 1 Billion Token und senkt gleichzeitig die p90-Latenz zwischen Tokens bei komplexen Agenten-Workloads um 40 %. 📊 Durch die Trennung der Prompt-Verarbeitung und der Antwortgenerierung auf verschiedene GPUs optimiert das System die Recheneffizienz im institutionellen Maßstab.
Mit einer Erweiterung der KV-Cache-Kapazität um 50 % auf bis zu 1,63 Mio. Token pro Decoder verbindet dieser Open-Source-Stack Modelltraining nahtlos mit Echtzeitausführung. 💡 Betriebsdaten fließen kontinuierlich zurück in Reinforcement-Learning-Pipelines, wodurch die rohe Inferenz-Effizienz zur entscheidenden Wettbewerbskennzahl wird. 🔍
💬 Glaubst du, dass die Optimierung von Open-Source-Inferenz den dezentralen Einsatz von Agenten beschleunigen wird, oder können proprietäre Rechenzentren ihren Vorsprung behaupten? 👇
⚠️ Keine Finanzberatung. Behalte dein Risiko immer im Blick. 🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
PRIME INFERENCE PRÄSENTIERT DURCHBRUCH BEI DER LATENZVERARBEITUNG VON 1 BILLION TOKEN FÜR $AI INFRASTRUKTUR ⚡ 📊
Prime Intellect hat Prime Inference eingeführt. Das System verarbeitet täglich fast 1 Billion Token und senkt gleichzeitig die p90-Latenz zwischen Tokens bei komplexen Agenten-Workloads um 40 %. 📊 Durch die Trennung der Prompt-Verarbeitung und der Antwortgenerierung auf verschiedene GPUs optimiert das System die Recheneffizienz im institutionellen Maßstab.
Mit einer Erweiterung der KV-Cache-Kapazität um 50 % auf bis zu 1,63 Mio. Token pro Decoder verbindet dieser Open-Source-Stack Modelltraining nahtlos mit Echtzeitausführung. 💡 Betriebsdaten fließen kontinuierlich zurück in Reinforcement-Learning-Pipelines, wodurch die rohe Inferenz-Effizienz zur entscheidenden Wettbewerbskennzahl wird. 🔍
💬 Glaubst du, dass die Optimierung von Open-Source-Inferenz den dezentralen Einsatz von Agenten beschleunigen wird, oder können proprietäre Rechenzentren ihren Vorsprung behaupten? 👇
⚠️ Keine Finanzberatung. Behalte dein Risiko immer im Blick. 🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
Prime Intellect hat Prime Inference eingeführt. Das System verarbeitet täglich fast 1 Billion Token und senkt gleichzeitig die p90-Latenz zwischen Tokens bei komplexen Agenten-Workloads um 40 %. 📊 Durch die Trennung der Prompt-Verarbeitung und der Antwortgenerierung auf verschiedene GPUs optimiert das System die Recheneffizienz im institutionellen Maßstab.
Mit einer Erweiterung der KV-Cache-Kapazität um 50 % auf bis zu 1,63 Mio. Token pro Decoder verbindet dieser Open-Source-Stack Modelltraining nahtlos mit Echtzeitausführung. 💡 Betriebsdaten fließen kontinuierlich zurück in Reinforcement-Learning-Pipelines, wodurch die rohe Inferenz-Effizienz zur entscheidenden Wettbewerbskennzahl wird. 🔍
💬 Glaubst du, dass die Optimierung von Open-Source-Inferenz den dezentralen Einsatz von Agenten beschleunigen wird, oder können proprietäre Rechenzentren ihren Vorsprung behaupten? 👇
⚠️ Keine Finanzberatung. Behalte dein Risiko immer im Blick. 🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
93
·
--
$CRBR BEREIT ZUM START: GPT-5.6 IM JULI MIT 750 TOKENS/S 🚀
Einstieg: $170 🔥
Serenitys Bestätigung, dass OpenAI das Frontier-GPT-5.6-Sol-Modell auf der Cerebras-Hardware ausrollen wird, ist ein direkter Katalysator für die Aktie. Die Inferenzgeschwindigkeit von 750 Tokens/S pro Sekunde schafft einen spürbaren Wettbewerbsvorteil gegenüber GPU-basierten Architekturen. Serenitys Kauf bei $170 unterstreicht die Überzeugung, sie weisen aber auch darauf hin, dass die aktuelle Bewertung im Vergleich zu Peers wie JBL leicht erhöht ist.
Die entscheidende Frage ist, ob der Markt den Partnerschafts-Aufschlag bereits vollständig eingepreist hat oder ob anhaltendes Volumen die Aktie in eine neue Spanne treiben kann. Was ist dein Ziel hier — $200 oder erst eine Konsolidierung/ Rücksetzer?
Keine Finanzberatung. Manage dein Risiko stets.
#CRBR #AI #Hardware #Inference #Breakout
🎯
$CRBR BEREIT ZUM START: GPT-5.6 IM JULI MIT 750 TOKENS/S 🚀
Einstieg: $170 🔥
Serenitys Bestätigung, dass OpenAI das Frontier-GPT-5.6-Sol-Modell auf der Cerebras-Hardware ausrollen wird, ist ein direkter Katalysator für die Aktie. Die Inferenzgeschwindigkeit von 750 Tokens/S pro Sekunde schafft einen spürbaren Wettbewerbsvorteil gegenüber GPU-basierten Architekturen. Serenitys Kauf bei $170 unterstreicht die Überzeugung, sie weisen aber auch darauf hin, dass die aktuelle Bewertung im Vergleich zu Peers wie JBL leicht erhöht ist.
Die entscheidende Frage ist, ob der Markt den Partnerschafts-Aufschlag bereits vollständig eingepreist hat oder ob anhaltendes Volumen die Aktie in eine neue Spanne treiben kann. Was ist dein Ziel hier — $200 oder erst eine Konsolidierung/ Rücksetzer?
Keine Finanzberatung. Manage dein Risiko stets.
#CRBR #AI #Hardware #Inference #Breakout
🎯
Einstieg: $170 🔥
Serenitys Bestätigung, dass OpenAI das Frontier-GPT-5.6-Sol-Modell auf der Cerebras-Hardware ausrollen wird, ist ein direkter Katalysator für die Aktie. Die Inferenzgeschwindigkeit von 750 Tokens/S pro Sekunde schafft einen spürbaren Wettbewerbsvorteil gegenüber GPU-basierten Architekturen. Serenitys Kauf bei $170 unterstreicht die Überzeugung, sie weisen aber auch darauf hin, dass die aktuelle Bewertung im Vergleich zu Peers wie JBL leicht erhöht ist.
Die entscheidende Frage ist, ob der Markt den Partnerschafts-Aufschlag bereits vollständig eingepreist hat oder ob anhaltendes Volumen die Aktie in eine neue Spanne treiben kann. Was ist dein Ziel hier — $200 oder erst eine Konsolidierung/ Rücksetzer?
Keine Finanzberatung. Manage dein Risiko stets.
#CRBR #AI #Hardware #Inference #Breakout
🎯
17
$NVDA Die Nachfrage nach KI-Inferenz läuft weiterhin heiß ⚡
Citigroup sagt, dass Knappheit nicht mehr nur die neuesten Chips betrifft. Jetzt breitet sie sich auf ältere GPUs, Rechenzentren, Stromzugang und die Routing-Schicht aus, die entscheidet, welches Modell und welche Hardware verwendet werden.
Das ist wichtig, denn der nächste Schritt im KI-Wert könnte nicht nur in der Rechenleistung liegen. Der Markt beginnt, den breiteren Infrastruktur-Stack zu bepreisen, von optischen Netzwerken bis hin zu Cloud- und Anwendungsschichten.
Keine Finanzberatung. Manage dein Risiko.
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
$NVDA Die Nachfrage nach KI-Inferenz läuft weiterhin heiß ⚡
Citigroup sagt, dass Knappheit nicht mehr nur die neuesten Chips betrifft. Jetzt breitet sie sich auf ältere GPUs, Rechenzentren, Stromzugang und die Routing-Schicht aus, die entscheidet, welches Modell und welche Hardware verwendet werden.
Das ist wichtig, denn der nächste Schritt im KI-Wert könnte nicht nur in der Rechenleistung liegen. Der Markt beginnt, den breiteren Infrastruktur-Stack zu bepreisen, von optischen Netzwerken bis hin zu Cloud- und Anwendungsschichten.
Keine Finanzberatung. Manage dein Risiko.
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
Citigroup sagt, dass Knappheit nicht mehr nur die neuesten Chips betrifft. Jetzt breitet sie sich auf ältere GPUs, Rechenzentren, Stromzugang und die Routing-Schicht aus, die entscheidet, welches Modell und welche Hardware verwendet werden.
Das ist wichtig, denn der nächste Schritt im KI-Wert könnte nicht nur in der Rechenleistung liegen. Der Markt beginnt, den breiteren Infrastruktur-Stack zu bepreisen, von optischen Netzwerken bis hin zu Cloud- und Anwendungsschichten.
Keine Finanzberatung. Manage dein Risiko.
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
16
$CEREBRAS FÜR 170 WAR DER INSIDER-EINSTIEG – JETZT BESTÄTIGT OPENAI 🔥
Einstieg: 170 🔥
OpenAI startet nächsten Monat GPT‑5.6 auf Cerebras-Hardware und erreicht 750 Tokens pro Sekunde. Das ist kein Gerücht – es ist eine direkte Bestätigung ihres Inferenz-Stacks. Serenity, die bei 170 gekauft hat, sieht trotz der aktuellen Prämie weiterhin langfristiges Potenzial.
Die Infrastruktur-Erzählung kommt immer mehr in Fahrt, und Cerebras steht genau in der Mitte davon. Die Frage ist jetzt: Preist der Markt diesen Katalysator bereits vollständig ein oder gibt es noch Raum nach oben? Wartest du auf einen Rücksetzer oder kaufst du hier nach?
Keine Finanzberatung. Immer dein Risiko steuern.
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
$CEREBRAS FÜR 170 WAR DER INSIDER-EINSTIEG – JETZT BESTÄTIGT OPENAI 🔥
Einstieg: 170 🔥
OpenAI startet nächsten Monat GPT‑5.6 auf Cerebras-Hardware und erreicht 750 Tokens pro Sekunde. Das ist kein Gerücht – es ist eine direkte Bestätigung ihres Inferenz-Stacks. Serenity, die bei 170 gekauft hat, sieht trotz der aktuellen Prämie weiterhin langfristiges Potenzial.
Die Infrastruktur-Erzählung kommt immer mehr in Fahrt, und Cerebras steht genau in der Mitte davon. Die Frage ist jetzt: Preist der Markt diesen Katalysator bereits vollständig ein oder gibt es noch Raum nach oben? Wartest du auf einen Rücksetzer oder kaufst du hier nach?
Keine Finanzberatung. Immer dein Risiko steuern.
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
Einstieg: 170 🔥
OpenAI startet nächsten Monat GPT‑5.6 auf Cerebras-Hardware und erreicht 750 Tokens pro Sekunde. Das ist kein Gerücht – es ist eine direkte Bestätigung ihres Inferenz-Stacks. Serenity, die bei 170 gekauft hat, sieht trotz der aktuellen Prämie weiterhin langfristiges Potenzial.
Die Infrastruktur-Erzählung kommt immer mehr in Fahrt, und Cerebras steht genau in der Mitte davon. Die Frage ist jetzt: Preist der Markt diesen Katalysator bereits vollständig ein oder gibt es noch Raum nach oben? Wartest du auf einen Rücksetzer oder kaufst du hier nach?
Keine Finanzberatung. Immer dein Risiko steuern.
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
28

AMAZON HEBT CAPEX AUF 220 Mrd. USD — INFERENCE-NACHFRAGE IST JETZT IHR MOMENT $FET 'S 🦈 💥
Der KI-Zyklus hat gerade die Phase gewechselt. Das Training war nur der Warm-up-Act — Inference ist der Part, bei dem die echte Rechenleistung verbraucht wird. Amazons Cloud-Chef sagt: Die Kunden haben mit dem Experimentieren abgeschlossen; sie binden Modelle direkt in Produktions-Workflows ein. Das ist eine Nachfragekurve, die nach oben durchhängt. 📊
Jetzt hebt AWS seine Capex-Decke auf 220 Mrd. USD bis 2026. Das ist keine Rundungsdifferenz — das sind Hyperscaler, die die größte Infrastruktur-Wette dieses Jahrzehnts platzieren, um Inference-Engines zu füttern. Wenn Web2-Giganten um knappe Rechenressourcen kämpfen, bekommt die dezentrale KI-Erzählung einen Platz am Tisch. 💡
Der Markt preist noch immer neu aus, welche Tokens diese Nachfrage erben. Der Momentum-Effekt hinkt der Story oft hinterher, bis der erste große Ausbruch sie eindeutig bestätigt. 🔍 Welches KI-Projekt in Ihrem Portfolio hat die stärkste reale Inference-Story? 💬
⚠️ Keine Finanzberatung. Verwalten Sie immer Ihr Risiko. 🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
AMAZON HEBT CAPEX AUF 220 Mrd. USD — INFERENCE-NACHFRAGE IST JETZT IHR MOMENT $FET 'S 🦈 💥
Der KI-Zyklus hat gerade die Phase gewechselt. Das Training war nur der Warm-up-Act — Inference ist der Part, bei dem die echte Rechenleistung verbraucht wird. Amazons Cloud-Chef sagt: Die Kunden haben mit dem Experimentieren abgeschlossen; sie binden Modelle direkt in Produktions-Workflows ein. Das ist eine Nachfragekurve, die nach oben durchhängt. 📊
Jetzt hebt AWS seine Capex-Decke auf 220 Mrd. USD bis 2026. Das ist keine Rundungsdifferenz — das sind Hyperscaler, die die größte Infrastruktur-Wette dieses Jahrzehnts platzieren, um Inference-Engines zu füttern. Wenn Web2-Giganten um knappe Rechenressourcen kämpfen, bekommt die dezentrale KI-Erzählung einen Platz am Tisch. 💡
Der Markt preist noch immer neu aus, welche Tokens diese Nachfrage erben. Der Momentum-Effekt hinkt der Story oft hinterher, bis der erste große Ausbruch sie eindeutig bestätigt. 🔍 Welches KI-Projekt in Ihrem Portfolio hat die stärkste reale Inference-Story? 💬
⚠️ Keine Finanzberatung. Verwalten Sie immer Ihr Risiko. 🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
Der KI-Zyklus hat gerade die Phase gewechselt. Das Training war nur der Warm-up-Act — Inference ist der Part, bei dem die echte Rechenleistung verbraucht wird. Amazons Cloud-Chef sagt: Die Kunden haben mit dem Experimentieren abgeschlossen; sie binden Modelle direkt in Produktions-Workflows ein. Das ist eine Nachfragekurve, die nach oben durchhängt. 📊
Jetzt hebt AWS seine Capex-Decke auf 220 Mrd. USD bis 2026. Das ist keine Rundungsdifferenz — das sind Hyperscaler, die die größte Infrastruktur-Wette dieses Jahrzehnts platzieren, um Inference-Engines zu füttern. Wenn Web2-Giganten um knappe Rechenressourcen kämpfen, bekommt die dezentrale KI-Erzählung einen Platz am Tisch. 💡
Der Markt preist noch immer neu aus, welche Tokens diese Nachfrage erben. Der Momentum-Effekt hinkt der Story oft hinterher, bis der erste große Ausbruch sie eindeutig bestätigt. 🔍 Welches KI-Projekt in Ihrem Portfolio hat die stärkste reale Inference-Story? 💬
⚠️ Keine Finanzberatung. Verwalten Sie immer Ihr Risiko. 🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
135
·
--
ZHIPU SPRHENGT SPEEDBARRIERS MIT GLM-5.3-FLASHX UND ZÜNDET DIE NÄCHSTE $AI INFRASTRUKTUR-RALLY AN! ⚡ 🚀
KI-Compute-Scaling hat gerade den Hyperdrive eingelegt, als Zhipu GLM-5.3-FlashX enthüllt und einen atemberaubenden Durchsatz von 200 Tokens pro Sekunde freisetzt. ⚡ Angetrieben von internen Infra Agents, die über 100.000 spezialisierte Chips optimieren—die End-to-End-Verarbeitungsgeschwindigkeiten wurden in weniger als zwei Wochen verdreifacht.
Diese rohe Beschleunigung des Durchsatzes signalisiert einen massiven Wandel hin zu hyper-effizienter Modellausführung in der dezentralen Intelligenz-Landschaft. 📊 Da die rohe Inferenzgeschwindigkeit zum ultimativen Burggraben wird, platziert intelligentes Kapital still und heimlich vorauslaufend Wetten auf die These des infrastrukturellen Engpasses. 💡
💬 Werden Hochgeschwindigkeits-Inferenzmaschinen diesen Quartal den nächsten großen Bewertungs-Schub für KI-Tokens auslösen? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡ 🎯
ZHIPU SPRHENGT SPEEDBARRIERS MIT GLM-5.3-FLASHX UND ZÜNDET DIE NÄCHSTE $AI INFRASTRUKTUR-RALLY AN! ⚡ 🚀
KI-Compute-Scaling hat gerade den Hyperdrive eingelegt, als Zhipu GLM-5.3-FlashX enthüllt und einen atemberaubenden Durchsatz von 200 Tokens pro Sekunde freisetzt. ⚡ Angetrieben von internen Infra Agents, die über 100.000 spezialisierte Chips optimieren—die End-to-End-Verarbeitungsgeschwindigkeiten wurden in weniger als zwei Wochen verdreifacht.
Diese rohe Beschleunigung des Durchsatzes signalisiert einen massiven Wandel hin zu hyper-effizienter Modellausführung in der dezentralen Intelligenz-Landschaft. 📊 Da die rohe Inferenzgeschwindigkeit zum ultimativen Burggraben wird, platziert intelligentes Kapital still und heimlich vorauslaufend Wetten auf die These des infrastrukturellen Engpasses. 💡
💬 Werden Hochgeschwindigkeits-Inferenzmaschinen diesen Quartal den nächsten großen Bewertungs-Schub für KI-Tokens auslösen? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡ 🎯
KI-Compute-Scaling hat gerade den Hyperdrive eingelegt, als Zhipu GLM-5.3-FlashX enthüllt und einen atemberaubenden Durchsatz von 200 Tokens pro Sekunde freisetzt. ⚡ Angetrieben von internen Infra Agents, die über 100.000 spezialisierte Chips optimieren—die End-to-End-Verarbeitungsgeschwindigkeiten wurden in weniger als zwei Wochen verdreifacht.
Diese rohe Beschleunigung des Durchsatzes signalisiert einen massiven Wandel hin zu hyper-effizienter Modellausführung in der dezentralen Intelligenz-Landschaft. 📊 Da die rohe Inferenzgeschwindigkeit zum ultimativen Burggraben wird, platziert intelligentes Kapital still und heimlich vorauslaufend Wetten auf die These des infrastrukturellen Engpasses. 💡
💬 Werden Hochgeschwindigkeits-Inferenzmaschinen diesen Quartal den nächsten großen Bewertungs-Schub für KI-Tokens auslösen? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡ 🎯
55
DIE 70%-KOSTENEINSPARUNG, DIE KI-CODING VON MIETE AUF EIGENES VERMÖGEN UMSTELLT — $AMD 🦈 💥
AMD hat gerade einen gebündelten Stack direkt auf Unternehmensebene losgeschickt: EPYC-Silizium, Instinct-GPUs, Supermicro-Server, PaletteAI von Spectro Cloud und GLM-5.2 — ein vorintegrierter On-Prem-Copilot „in einer Box“. 🎯 Die Kennzahl, die wirklich zählt: bis zu 70% niedrigere Gesamtkosten im Vergleich zu Cloud-Frontier-Modellen, mit einer Kapitalrückzahlung von so schnell wie sechs Monaten.
Der scharfe Schachzug ist routing nach Richtlinien (policy-based routing) — PaletteAI schaltet bei Bedarf automatisch zwischen On-Prem-Inferenz und Anthropic-, OpenAI-, Google- oder xAI-Cloud-Modellen um, mit Token-Kontingenten, Audit-Trails und Grafana-Dashboards, die die echte Kostendifferenz live sichtbar machen. 🔍
Hier verschiebt sich KI-Coding von abgerechneter Miete hin zu planbarer Infrastruktur — ein Souveränitäts-Play, das die Self-Custody-Mentalität widerspiegelt. 💬 Werden Unternehmen weiterhin Frontier-Modelle mieten oder anfangen, die Rechenleistung selbst zu besitzen? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
DIE 70%-KOSTENEINSPARUNG, DIE KI-CODING VON MIETE AUF EIGENES VERMÖGEN UMSTELLT — $AMD 🦈 💥
AMD hat gerade einen gebündelten Stack direkt auf Unternehmensebene losgeschickt: EPYC-Silizium, Instinct-GPUs, Supermicro-Server, PaletteAI von Spectro Cloud und GLM-5.2 — ein vorintegrierter On-Prem-Copilot „in einer Box“. 🎯 Die Kennzahl, die wirklich zählt: bis zu 70% niedrigere Gesamtkosten im Vergleich zu Cloud-Frontier-Modellen, mit einer Kapitalrückzahlung von so schnell wie sechs Monaten.
Der scharfe Schachzug ist routing nach Richtlinien (policy-based routing) — PaletteAI schaltet bei Bedarf automatisch zwischen On-Prem-Inferenz und Anthropic-, OpenAI-, Google- oder xAI-Cloud-Modellen um, mit Token-Kontingenten, Audit-Trails und Grafana-Dashboards, die die echte Kostendifferenz live sichtbar machen. 🔍
Hier verschiebt sich KI-Coding von abgerechneter Miete hin zu planbarer Infrastruktur — ein Souveränitäts-Play, das die Self-Custody-Mentalität widerspiegelt. 💬 Werden Unternehmen weiterhin Frontier-Modelle mieten oder anfangen, die Rechenleistung selbst zu besitzen? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
AMD hat gerade einen gebündelten Stack direkt auf Unternehmensebene losgeschickt: EPYC-Silizium, Instinct-GPUs, Supermicro-Server, PaletteAI von Spectro Cloud und GLM-5.2 — ein vorintegrierter On-Prem-Copilot „in einer Box“. 🎯 Die Kennzahl, die wirklich zählt: bis zu 70% niedrigere Gesamtkosten im Vergleich zu Cloud-Frontier-Modellen, mit einer Kapitalrückzahlung von so schnell wie sechs Monaten.
Der scharfe Schachzug ist routing nach Richtlinien (policy-based routing) — PaletteAI schaltet bei Bedarf automatisch zwischen On-Prem-Inferenz und Anthropic-, OpenAI-, Google- oder xAI-Cloud-Modellen um, mit Token-Kontingenten, Audit-Trails und Grafana-Dashboards, die die echte Kostendifferenz live sichtbar machen. 🔍
Hier verschiebt sich KI-Coding von abgerechneter Miete hin zu planbarer Infrastruktur — ein Souveränitäts-Play, das die Self-Custody-Mentalität widerspiegelt. 💬 Werden Unternehmen weiterhin Frontier-Modelle mieten oder anfangen, die Rechenleistung selbst zu besitzen? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
90
·
--
🚨 $NVDA SHIFTS INSTITUTIONAL FOKUS AUF AGENTIC-AI-INFERENZ-EFFIZIENZ! 🧠
Nvidia hat offiziell die Massenproduktion für den Groq 3 LPX-Akzelerator gestartet und damit eine entscheidende strukturelle Wende von reinem Modelltraining hin zu kontinuierlicher Ausführung eingeleitet. 🦈 Große Infrastrukturbetreiber stoßen direkt an Leistungsgrenzen, wodurch intelligentes Kapital auf hocheffiziente Architekturen für mehrstufige agentische KI-Workloads umschwenkt. 📊
Dieser Wandel verlagert den operativen Maßstab von reiner Rechenleistung hin zur optimierten Compute-per-Watt-Effizienz. 🔍 Während persistentes Live-Inferencing das statische Modelltraining ersetzt, wird energiebewusstes Hardwaredesign zum entscheidenden Vorteil für institutionelles Skalieren. 💡
🤔 Werden Energierestriktionen in diesem Jahr eine große Neubewertung der Bewertung in den Bereichen Hochleistungs-Compute erzwingen? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
🚨 $NVDA SHIFTS INSTITUTIONAL FOKUS AUF AGENTIC-AI-INFERENZ-EFFIZIENZ! 🧠
Nvidia hat offiziell die Massenproduktion für den Groq 3 LPX-Akzelerator gestartet und damit eine entscheidende strukturelle Wende von reinem Modelltraining hin zu kontinuierlicher Ausführung eingeleitet. 🦈 Große Infrastrukturbetreiber stoßen direkt an Leistungsgrenzen, wodurch intelligentes Kapital auf hocheffiziente Architekturen für mehrstufige agentische KI-Workloads umschwenkt. 📊
Dieser Wandel verlagert den operativen Maßstab von reiner Rechenleistung hin zur optimierten Compute-per-Watt-Effizienz. 🔍 Während persistentes Live-Inferencing das statische Modelltraining ersetzt, wird energiebewusstes Hardwaredesign zum entscheidenden Vorteil für institutionelles Skalieren. 💡
🤔 Werden Energierestriktionen in diesem Jahr eine große Neubewertung der Bewertung in den Bereichen Hochleistungs-Compute erzwingen? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
Nvidia hat offiziell die Massenproduktion für den Groq 3 LPX-Akzelerator gestartet und damit eine entscheidende strukturelle Wende von reinem Modelltraining hin zu kontinuierlicher Ausführung eingeleitet. 🦈 Große Infrastrukturbetreiber stoßen direkt an Leistungsgrenzen, wodurch intelligentes Kapital auf hocheffiziente Architekturen für mehrstufige agentische KI-Workloads umschwenkt. 📊
Dieser Wandel verlagert den operativen Maßstab von reiner Rechenleistung hin zur optimierten Compute-per-Watt-Effizienz. 🔍 Während persistentes Live-Inferencing das statische Modelltraining ersetzt, wird energiebewusstes Hardwaredesign zum entscheidenden Vorteil für institutionelles Skalieren. 💡
🤔 Werden Energierestriktionen in diesem Jahr eine große Neubewertung der Bewertung in den Bereichen Hochleistungs-Compute erzwingen? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
18
·
--
🚨 $AI INFERENCE SHIFT: €200M WETTE GEGEN GPU-MONOPOLY ⚡
Euclyds €200M Series A, co-geführt von Samsung, EQT und Somerset, ist eine richtungsweisende Abstimmung für KI-Inferenz als nächsten Engpass. 📊 Seine 16.384 In-Memory-Prozessoren und die Roadmap bis 2028 mit 2028 Exaflops greifen die Leistungseffizienz-Schicht an, in der GPUs möglicherweise verwundbar sind.
⚡ Der Haken: Die behauptete 100-fache Nvidia-Effizienz bleibt eine Projektion, nicht der kommerzielle Beleg. Diese Lücke zwischen Ambition und Verifikation ist genau der Bereich, auf den kluges Geld für Katalysatoren schaut. 💬 Ist das der Beginn eines neuen KI-Hardware-Zyklus – oder weiterhin nur eine unbelegte Erzählung? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
🚨 $AI INFERENCE SHIFT: €200M WETTE GEGEN GPU-MONOPOLY ⚡
Euclyds €200M Series A, co-geführt von Samsung, EQT und Somerset, ist eine richtungsweisende Abstimmung für KI-Inferenz als nächsten Engpass. 📊 Seine 16.384 In-Memory-Prozessoren und die Roadmap bis 2028 mit 2028 Exaflops greifen die Leistungseffizienz-Schicht an, in der GPUs möglicherweise verwundbar sind.
⚡ Der Haken: Die behauptete 100-fache Nvidia-Effizienz bleibt eine Projektion, nicht der kommerzielle Beleg. Diese Lücke zwischen Ambition und Verifikation ist genau der Bereich, auf den kluges Geld für Katalysatoren schaut. 💬 Ist das der Beginn eines neuen KI-Hardware-Zyklus – oder weiterhin nur eine unbelegte Erzählung? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
Euclyds €200M Series A, co-geführt von Samsung, EQT und Somerset, ist eine richtungsweisende Abstimmung für KI-Inferenz als nächsten Engpass. 📊 Seine 16.384 In-Memory-Prozessoren und die Roadmap bis 2028 mit 2028 Exaflops greifen die Leistungseffizienz-Schicht an, in der GPUs möglicherweise verwundbar sind.
⚡ Der Haken: Die behauptete 100-fache Nvidia-Effizienz bleibt eine Projektion, nicht der kommerzielle Beleg. Diese Lücke zwischen Ambition und Verifikation ist genau der Bereich, auf den kluges Geld für Katalysatoren schaut. 💬 Ist das der Beginn eines neuen KI-Hardware-Zyklus – oder weiterhin nur eine unbelegte Erzählung? 👇
⚠️ Keine Finanzberatung. Verwalte immer dein Risiko. 🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
39
·
--
Der bevorstehende Bericht von SpaceX ist mehr als nur Unternehmensnachrichten; er zeigt den Konflikt zwischen privaten Black Boxes und der $ETH and $BTC ethos.
Zentralisierte Unternehmen verlangen blindes Vertrauen in die „Boardroom“-Mathematik. Dezentralisierte Protokolle zwingen Code dazu, jede Behauptung zu belegen. Unabhängige Audits der eigenen Bilanz sind der einzige Weg, um in diesem Markt echte Sicherheit zu gewährleisten.
$ETH $BTC #Web3 #Inference #DeFi
Der bevorstehende Bericht von SpaceX ist mehr als nur Unternehmensnachrichten; er zeigt den Konflikt zwischen privaten Black Boxes und der $ETH and $BTC ethos.
Zentralisierte Unternehmen verlangen blindes Vertrauen in die „Boardroom“-Mathematik. Dezentralisierte Protokolle zwingen Code dazu, jede Behauptung zu belegen. Unabhängige Audits der eigenen Bilanz sind der einzige Weg, um in diesem Markt echte Sicherheit zu gewährleisten.
$ETH $BTC #Web3 #Inference #DeFi
Zentralisierte Unternehmen verlangen blindes Vertrauen in die „Boardroom“-Mathematik. Dezentralisierte Protokolle zwingen Code dazu, jede Behauptung zu belegen. Unabhängige Audits der eigenen Bilanz sind der einzige Weg, um in diesem Markt echte Sicherheit zu gewährleisten.
$ETH $BTC #Web3 #Inference #DeFi
65

·
--
⚡ $FET AI INFERENZ-ENGPASS VERLAGERT SICH AUF DEN SPEICHERBANDWIDTH, WÄHREND SICH INSTITUTIONEN UMSTRUKTURIEREN: INFRASTRUKTUR! 📊
Die Anforderungen an institutionelle Rechenleistung verlagern sich dramatisch von reiner Speicherkapazität hin zu hocheffizienter Bandbreiten-Orchestrierung. 📊 Da die MoE-Architektur dominiert, ist die Routing-Geschwindigkeit zwischen den Prefill- und Decode-Pipelines zum zentralen Engpass für die Hardware-Infrastruktur der nächsten Generation geworden.
Gestaffeltes KV-Cache-Scheduling und Bandbreiten-Durchsatz bestimmen nun die Effizienz des Clusters stärker als die reine Hardware-Dichte. 🔍 Smart Capital positioniert sich rund um Infrastrukturprotokolle, die den Aufwand für die Datenbewegung optimieren, bevor die nächste Skalierungs-Erweiterung ansteht.
💡 Disaggregierte Node-Architekturen zwingen zu einem vollständigen Umbau der Strategien zur Zuweisung institutioneller Hardware. 💬 Können Bandbreiten-Optimierungsprotokolle die nächste strukturelle Rotation im dezentralen Computing erfassen? 👇
⚠️ Keine Finanzberatung. Managemente immer dein Risiko. 🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
⚡ $FET AI INFERENZ-ENGPASS VERLAGERT SICH AUF DEN SPEICHERBANDWIDTH, WÄHREND SICH INSTITUTIONEN UMSTRUKTURIEREN: INFRASTRUKTUR! 📊
Die Anforderungen an institutionelle Rechenleistung verlagern sich dramatisch von reiner Speicherkapazität hin zu hocheffizienter Bandbreiten-Orchestrierung. 📊 Da die MoE-Architektur dominiert, ist die Routing-Geschwindigkeit zwischen den Prefill- und Decode-Pipelines zum zentralen Engpass für die Hardware-Infrastruktur der nächsten Generation geworden.
Gestaffeltes KV-Cache-Scheduling und Bandbreiten-Durchsatz bestimmen nun die Effizienz des Clusters stärker als die reine Hardware-Dichte. 🔍 Smart Capital positioniert sich rund um Infrastrukturprotokolle, die den Aufwand für die Datenbewegung optimieren, bevor die nächste Skalierungs-Erweiterung ansteht.
💡 Disaggregierte Node-Architekturen zwingen zu einem vollständigen Umbau der Strategien zur Zuweisung institutioneller Hardware. 💬 Können Bandbreiten-Optimierungsprotokolle die nächste strukturelle Rotation im dezentralen Computing erfassen? 👇
⚠️ Keine Finanzberatung. Managemente immer dein Risiko. 🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
Die Anforderungen an institutionelle Rechenleistung verlagern sich dramatisch von reiner Speicherkapazität hin zu hocheffizienter Bandbreiten-Orchestrierung. 📊 Da die MoE-Architektur dominiert, ist die Routing-Geschwindigkeit zwischen den Prefill- und Decode-Pipelines zum zentralen Engpass für die Hardware-Infrastruktur der nächsten Generation geworden.
Gestaffeltes KV-Cache-Scheduling und Bandbreiten-Durchsatz bestimmen nun die Effizienz des Clusters stärker als die reine Hardware-Dichte. 🔍 Smart Capital positioniert sich rund um Infrastrukturprotokolle, die den Aufwand für die Datenbewegung optimieren, bevor die nächste Skalierungs-Erweiterung ansteht.
💡 Disaggregierte Node-Architekturen zwingen zu einem vollständigen Umbau der Strategien zur Zuweisung institutioneller Hardware. 💬 Können Bandbreiten-Optimierungsprotokolle die nächste strukturelle Rotation im dezentralen Computing erfassen? 👇
⚠️ Keine Finanzberatung. Managemente immer dein Risiko. 🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
239

·
--
$AI Infrastrukturkosten steigen, während die Nachfrage nach Inferenz wächst ⚡
Citigroup sagt, dass die Nachfrage nach KI-Inferenz weiterhin auf Hochtouren läuft – und der Druck ist nicht mehr auf die neuesten Chips beschränkt. Knappheit verlagert sich über GPUs, Rechenzentren, Stromzugang und Routing-Ebenen hinweg, was bedeutet, dass der Markt nun den gesamten Stack bepreist – nicht nur Halbleiter.
Die wichtigste Erkenntnis ist strukturell: Modellanbieter monetarisieren schneller, während Infrastrukturengpässe zur eigentlichen Einschränkung werden. Wenn sich dieser Trend fortsetzt, könnte sich der Wert weiter zu den Ebenen verlagern, die helfen, die Inferenzkosten zu senken und Rechenleistung effizienter zu verteilen.
Keine Finanzberatung. Verwalten Sie Ihr Risiko.
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
$AI Infrastrukturkosten steigen, während die Nachfrage nach Inferenz wächst ⚡
Citigroup sagt, dass die Nachfrage nach KI-Inferenz weiterhin auf Hochtouren läuft – und der Druck ist nicht mehr auf die neuesten Chips beschränkt. Knappheit verlagert sich über GPUs, Rechenzentren, Stromzugang und Routing-Ebenen hinweg, was bedeutet, dass der Markt nun den gesamten Stack bepreist – nicht nur Halbleiter.
Die wichtigste Erkenntnis ist strukturell: Modellanbieter monetarisieren schneller, während Infrastrukturengpässe zur eigentlichen Einschränkung werden. Wenn sich dieser Trend fortsetzt, könnte sich der Wert weiter zu den Ebenen verlagern, die helfen, die Inferenzkosten zu senken und Rechenleistung effizienter zu verteilen.
Keine Finanzberatung. Verwalten Sie Ihr Risiko.
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
Citigroup sagt, dass die Nachfrage nach KI-Inferenz weiterhin auf Hochtouren läuft – und der Druck ist nicht mehr auf die neuesten Chips beschränkt. Knappheit verlagert sich über GPUs, Rechenzentren, Stromzugang und Routing-Ebenen hinweg, was bedeutet, dass der Markt nun den gesamten Stack bepreist – nicht nur Halbleiter.
Die wichtigste Erkenntnis ist strukturell: Modellanbieter monetarisieren schneller, während Infrastrukturengpässe zur eigentlichen Einschränkung werden. Wenn sich dieser Trend fortsetzt, könnte sich der Wert weiter zu den Ebenen verlagern, die helfen, die Inferenzkosten zu senken und Rechenleistung effizienter zu verteilen.
Keine Finanzberatung. Verwalten Sie Ihr Risiko.
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
64
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
1
#Verify1to1BinanceReserves
11 Aufrufe
15 Kommentare
2
#BinanceRestores28FiatWithdrawals
36,248 Aufrufe
598 Kommentare
3
#BinanceProcesses$4.65BWithdrawals
75,526 Aufrufe
323 Kommentare
4
#HKMALaunchesSAGEAgenticFinanceProject
510 Aufrufe
51 Kommentare
5
#ETHFalls16.1%InOctober
10,305 Aufrufe
226 Kommentare
6
#BitcoinETFsSee$643MOutflowLargestSinceJune
861 Aufrufe
14 Kommentare
7
#SouthKoreaPlans11%TaxOnUSStockPerpetualFutures
726 Aufrufe
51 Kommentare
8
#BitcoinClosesAbove50WeekMAFor7thStraightWeek
13,341 Aufrufe
195 Kommentare
9
#HongKongEnablesRoundTheClockTokenizedSettlement
1,570 Aufrufe
46 Kommentare
10
#IndiaRBIAndFIUReviewOverseasCryptoCards
3,370 Aufrufe
62 Kommentare