

#aiinference
aiinference
1,212 Aufrufe
7 Kommentare
Hot
Zuletzt
·
--
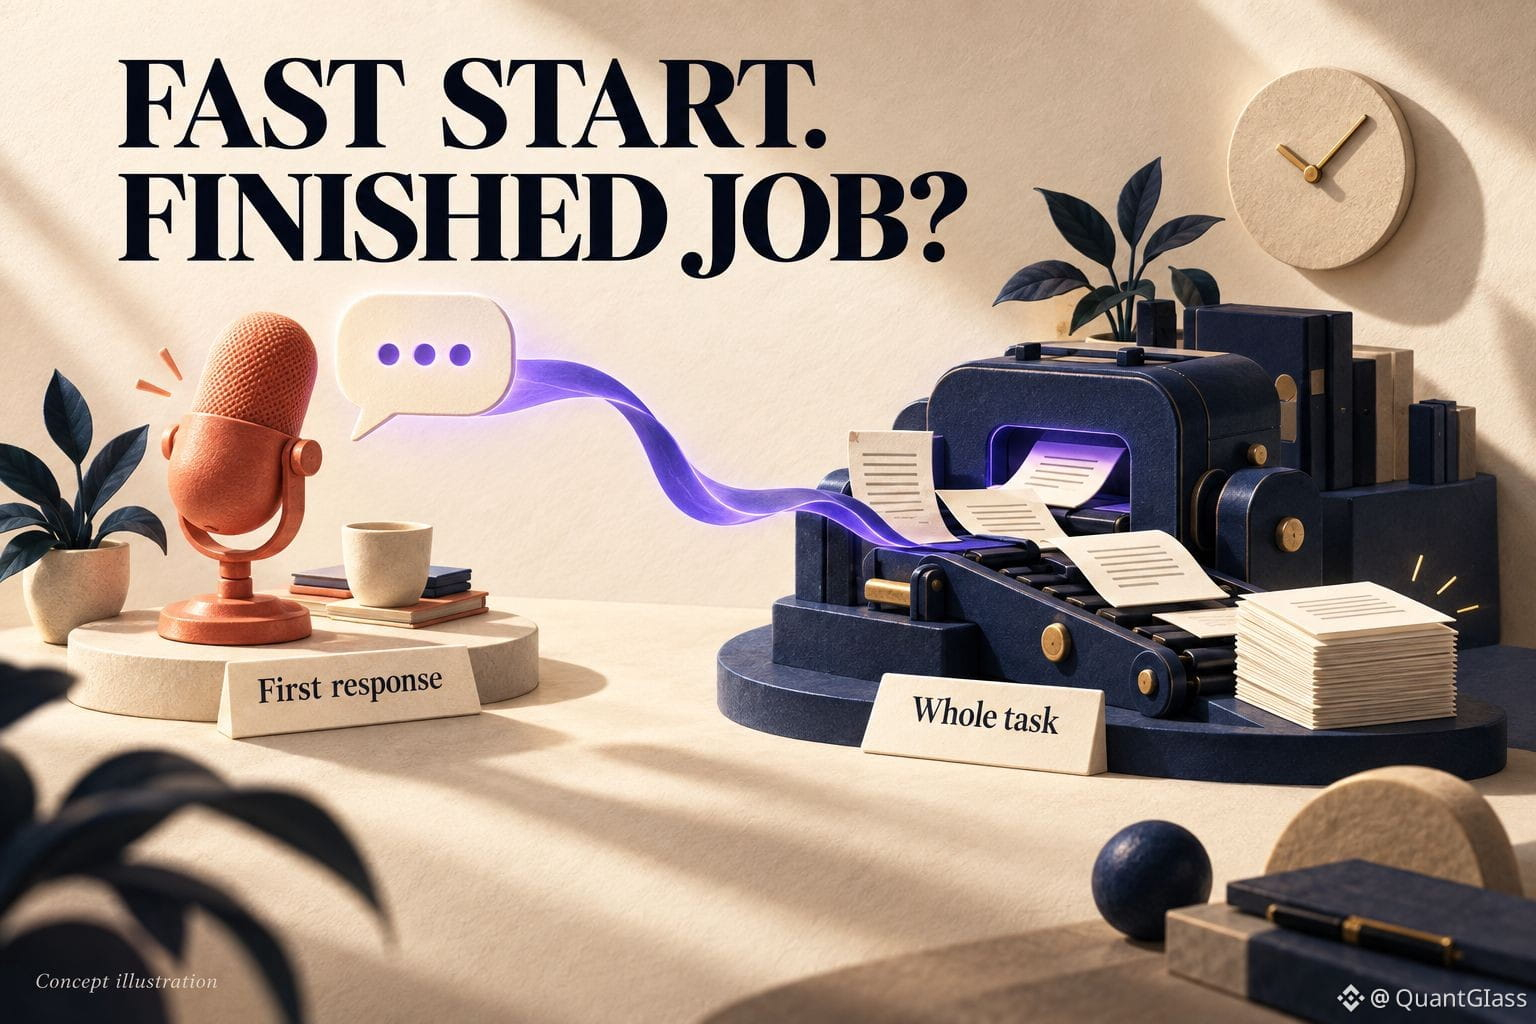
Eine KI, die schnell mit dem Antworten beginnt, kann trotzdem sehr lange brauchen, um die Aufgabe zu Ende zu bringen.
In seinem Artikel vom 18. September unterscheidet io.net zwischen Time-to-First-Token – der Wartezeit, bevor die Ausgabe beginnt – und Batch-Throughput. Es ordnet seine verteilten GPUs nach Kosten und Flexibilität ein, nicht danach, wer zuerst die erste Token ausgibt.
Mein Test für die $IO compute-Story: die gesamte Aufgabe messen. Ein Live-Voice-Assistant braucht eine schnelle Rückmeldung; ein Dokumentenjob über Nacht benötigt bis zum Abgabetermin genaue Ergebnisse zu insgesamt sinnvollen Kosten. Die Kostengrößen im Artikel dienen nur als anschauliche Beispiele, nicht als unabhängige Benchmarks. Reale Workloads müssen weiterhin getestet werden.
Was frustriert dich mehr: das Warten auf das erste Wort oder das Warten auf die fertige Antwort? #AIInference
167
·
--
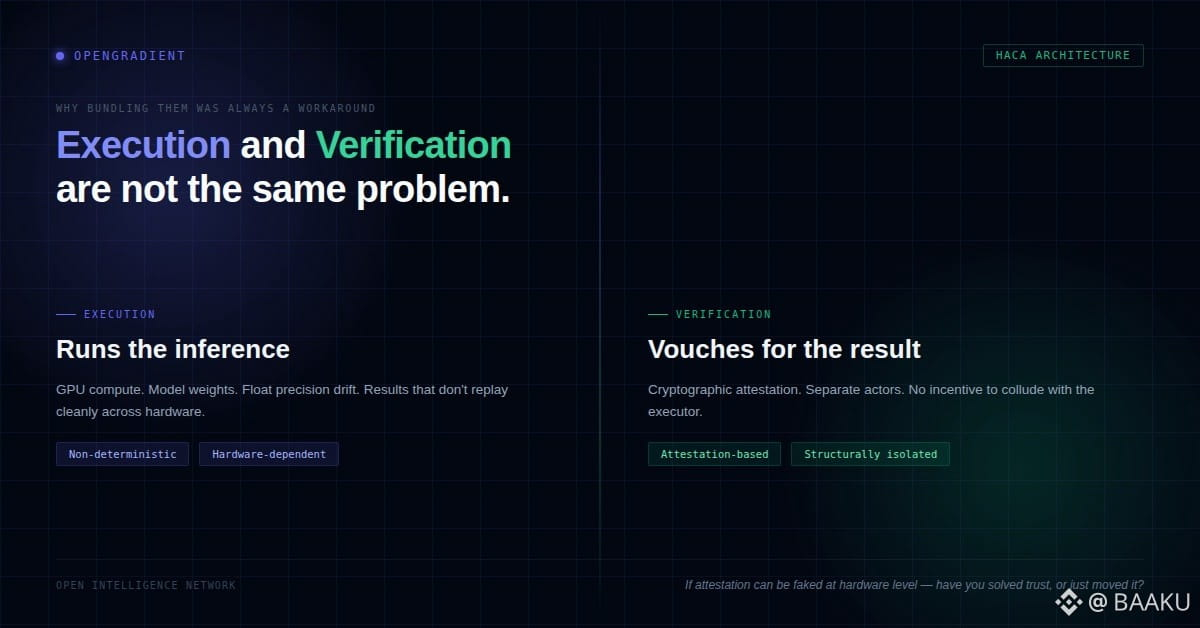
Die meisten Blockchains behandeln Ausführung und Verifizierung, als wären sie dasselbe Problem. Sind sie aber nicht.
Ausführung ist Berechnung. Verifizierung ist Vertrauen. Sie zusammenzupacken war immer nur ein Workaround — keine Designwahl. Und jahrelang hat niemand es bemerkt, weil die Modelle einfach genug waren, dass "nochmal ausführen und vergleichen" sich wie eine echte Lösung anfühlte.
Das ist es nicht mehr.
AI-Inferenz wird nicht sauber wiederholt. Führe dasselbe Modell zweimal auf unterschiedlicher Hardware aus, du könntest unterschiedliche Ausgaben erhalten. Fließkommapräzision, Temperaturvariationen, GPU-Spezifika — die Ergebnisse driften. Wenn deine Verifizierungsschicht also nur "neu ausführen und vergleichen" ist, hast du bereits verloren. Du überprüfst nicht die Wahrheit. Du überprüfst die Konsistenz unter idealen Bedingungen, was etwas völlig anderes ist.
Das ist die Lücke, die die meisten Leute überspringen, wenn sie von "verifizierbarer AI on-chain" sprechen.
Die HACA-Architektur von OpenGradient trennt tatsächlich diese beiden Schichten. Ausführungsnoten führen die Inferenz aus. Eine separate Verifizierungsschicht prüft das Ergebnis — mithilfe kryptografischer Bestätigungen, nicht durch redundante Wiederholung. Der Knoten, der das Modell ausgeführt hat, und das System, das dafür bürgt, sind strukturell unterschiedliche Akteure mit unterschiedlichen Anreizen.
Diese Trennung ist wichtiger, als die Leute realisieren. Wenn Ausführung und Verifizierung von derselben Logik behandelt werden, ist das Vertrauensmodell des Systems nur so gut wie die Ehrlichkeit des Ausführenden. Du überprüfst nicht die AI. Du vertraust dem Ausführenden, dass er sich selbst berichtet.
Trenne die Rollen, und die Anreizstruktur ändert sich tatsächlich. Verifizierungsnoten haben keinen Grund zur Kollusion mit den Ausführenden — sie haben das Modell nicht ausgeführt, sie überprüfen nur den Beweis. Das ist eine echte Vertrauensgrenze, keine theoretische.
Die ehrliche Einschränkung: Die verifikationsbasierte Bestätigung reift noch. Der kryptografische Overhead ist real, und "Beweis für korrekte Inferenz" bei großen Modellen ist kein gelöstes Problem. Die Designrichtung ist verteidigbar. Aber die tatsächlichen Sicherheitsannahmen leisten viel stille Arbeit im Hintergrund.
#OpenGradient #DecentralizedAI #AIInference #opg $OPG @OpenGradient
5
2
97
·
--
Die meisten Leute denken, dass die Abwicklung nur der langweilige Backend-Kram ist. Der Teil, der "einfach funktioniert."
Genau aus diesem Grund bricht es im schlimmsten Moment zusammen.
Hier ist, was tatsächlich passiert. Wenn ein KI-Modell eine Inferenz durchführt — ein Ergebnis generiert, eine Entscheidung trifft, ein Resultat bewertet — hast du keine Ahnung, ob dieses Ergebnis echt ist. Nicht in einem überprüfbaren Sinne. Du vertraust einer Black Box auf dem Server eines anderen, um dir die Wahrheit zu sagen. Und in 99% der aktuellen KI-Infrastruktur ist das das gesamte Sicherheitsmodell. Vertrau mir, Bro. In der Produktion. In großem Maßstab.
Die Abwicklung soll das beheben. Die Idee ist klar: du führst das Modell aus, beweist, dass es korrekt ausgeführt wurde, zeichnest diesen Beweis auf, und jetzt hat das Ergebnis Integrität. Einfach.
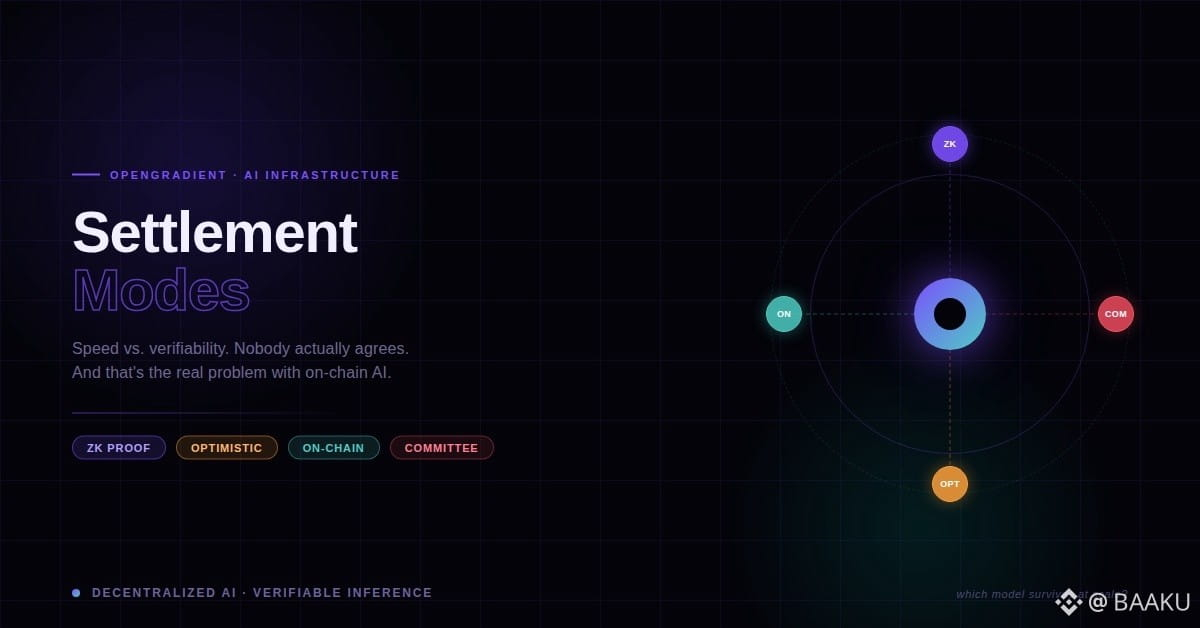
Außer in dem Moment, in dem du fragst, wie dieser Beweis abgewickelt wird — on-chain, off-chain, optimistisch, ZK, kommissionsbasiert — merkst du, dass niemand tatsächlich einverstanden ist. Und die Tradeoff-Matrix ist brutal.
On-chain-Abwicklung gibt dir echte Überprüfbarkeit, führt aber zu Latenz, die die Echtzeit-KI-Inferenz völlig unpraktisch macht. Du kannst nicht jedes Mal 12 Sekunden auf eine Blockbestätigung warten, wenn ein Modell einen Aufruf macht.
Optimistische Abwicklung ist schnell, schiebt aber das Integritätsproblem nach vorne — du gehst von Korrektheit aus, es sei denn, jemand fordert es heraus. Die meisten Nutzer werden niemals etwas herausfordern. Das ist einfach menschliches Verhalten.
#OpenGradient #AIInference #opg $OPG @OpenGradient
6
5
198

A16Z UNTERSTÜTZT DIE LOKALE KI-REVOLUTION VON AUF DEM GERÄT LÄUFTEN AGENSTEN, WÄHREND DIE $AI NARRATIVE ZÜNDET! ⚡ 🦈
📌 Silicon-Valley-Größen a16z und Khosla Ventures haben gerade institutionelles Kapital in Conways Researchs Underdog Local Agent gesteckt. Das Modell mit kompakter 4B-Parameterzahl läuft direkt auf Consumer-Hardware über MLX und schafft dabei 4,5-fache Geschwindigkeit – das signalisiert einen massiven strukturellen Wandel hin zur Zero-Cloud-Execution. 💡
Das kluge Geld ist dabei, den Shift von aufgeblähten Rechenzentrumsmodellen hin zu agiler On-Device-Intelligenz aggressiv vorwegzunehmen. 📊 Wenn Edge-Computing mit der Ausführung autonomer Agenten zusammenwächst, wird lokale KI-Infrastruktur rasch zum nächsten zentralen Narrativtreiber über alle Märkte hinweg. ⚡
🤔 Werden lokale KI-Agenten zentrale Cloud-Modelle für alltägliche Aufgaben überflüssig machen? 👇
⚠️ Keine Finanzberatung. Manage dein Risiko immer. 🛡️
🏷️ #AI #CryptoAI #TechTrends #Agents #AIInference
🔥 ⚡
120
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
1
#BitcoinRejectedAt$87K
32,974 Aufrufe
72 Kommentare
2
#FedOctoberRateHikeOddsFallTo17%
22,411 Aufrufe
365 Kommentare
3
#NvidiaHitsRecordHighUp2.4%
6,440 Aufrufe
231 Kommentare
4
#CanaryFilesAmendedS1ForPEPEETF
2,874 Aufrufe
163 Kommentare
5
#USRussiaUkraineTalksReportedlyIncludeLukoilOilDeal
12,787 Aufrufe
239 Kommentare
6
#BitcoinParesGainsAfterRallyTo$86.5K
37,850 Aufrufe
145 Kommentare
7
#CerebrasSinksNearly20%OnReportNvidiaToPowerOpenAI
83,427 Aufrufe
821 Kommentare
8
#SECProposesCryptoCustodyRules
108,600 Aufrufe
1,033 Kommentare
9
#SECApproves3xLongCryptoCommodityETPs
68,071 Aufrufe
702 Kommentare
10
#MASKHitsRecordMarketCapAbove$35M
4,258 Aufrufe
37 Kommentare