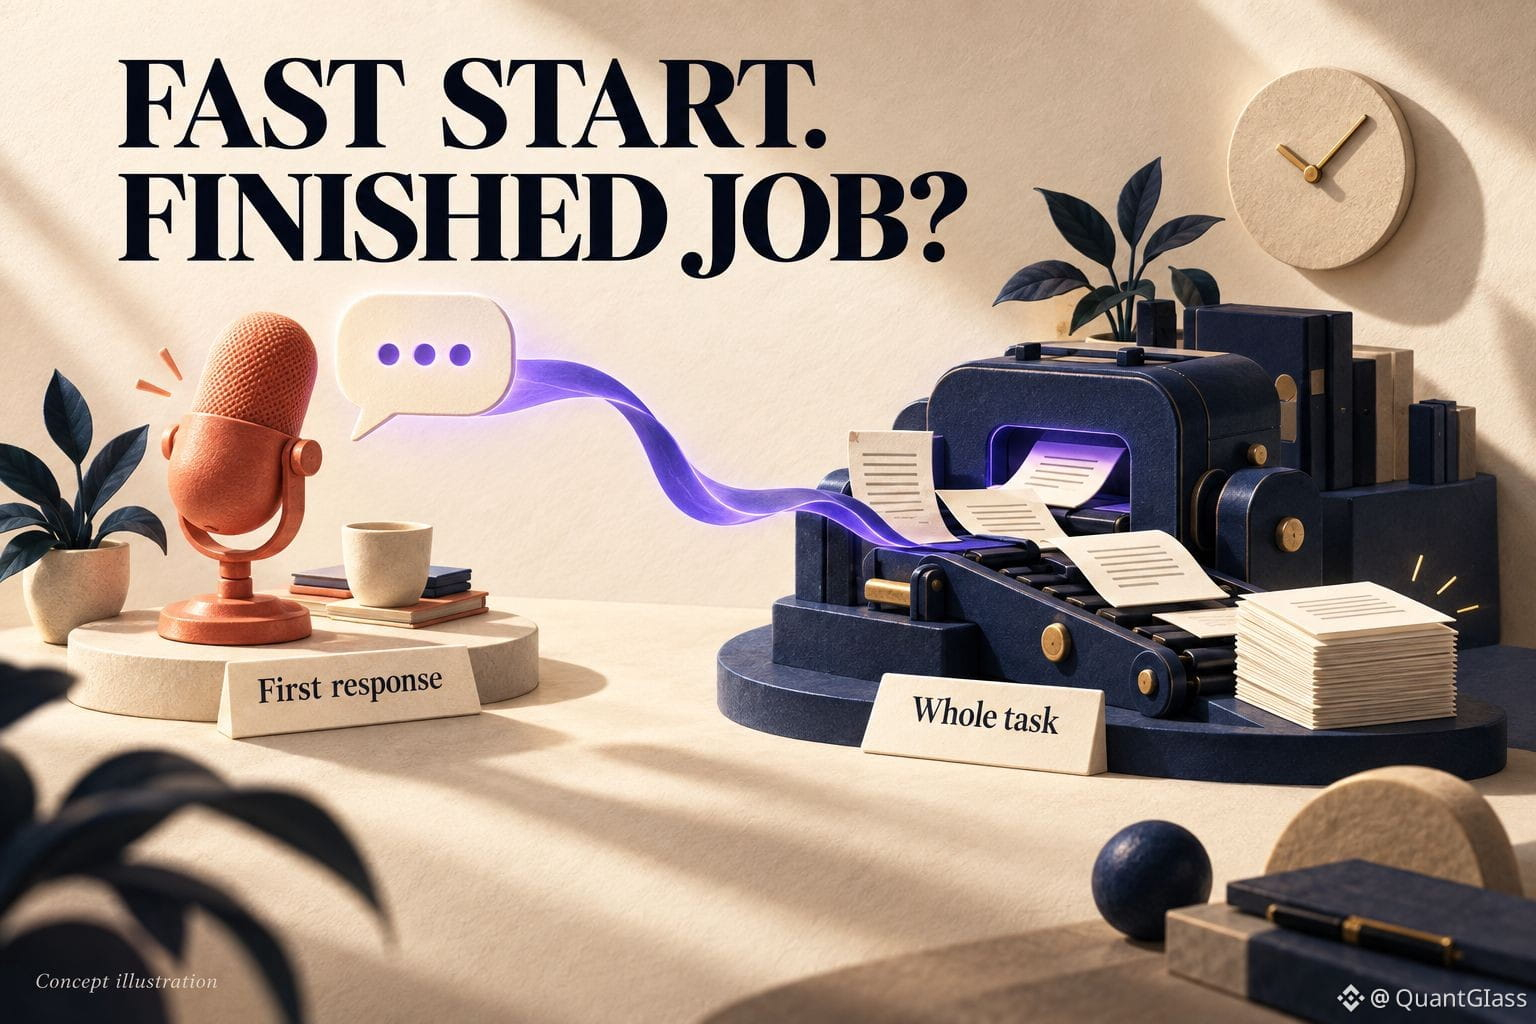
Eine KI, die schnell mit dem Antworten beginnt, kann trotzdem sehr lange brauchen, um die Aufgabe zu Ende zu bringen.
In seinem Artikel vom 18. September unterscheidet io.net zwischen Time-to-First-Token – der Wartezeit, bevor die Ausgabe beginnt – und Batch-Throughput. Es ordnet seine verteilten GPUs nach Kosten und Flexibilität ein, nicht danach, wer zuerst die erste Token ausgibt.
Mein Test für die $IO compute-Story: die gesamte Aufgabe messen. Ein Live-Voice-Assistant braucht eine schnelle Rückmeldung; ein Dokumentenjob über Nacht benötigt bis zum Abgabetermin genaue Ergebnisse zu insgesamt sinnvollen Kosten. Die Kostengrößen im Artikel dienen nur als anschauliche Beispiele, nicht als unabhängige Benchmarks. Reale Workloads müssen weiterhin getestet werden.
Was frustriert dich mehr: das Warten auf das erste Wort oder das Warten auf die fertige Antwort? #AIInference
In seinem Artikel vom 18. September unterscheidet io.net zwischen Time-to-First-Token – der Wartezeit, bevor die Ausgabe beginnt – und Batch-Throughput. Es ordnet seine verteilten GPUs nach Kosten und Flexibilität ein, nicht danach, wer zuerst die erste Token ausgibt.
Mein Test für die $IO compute-Story: die gesamte Aufgabe messen. Ein Live-Voice-Assistant braucht eine schnelle Rückmeldung; ein Dokumentenjob über Nacht benötigt bis zum Abgabetermin genaue Ergebnisse zu insgesamt sinnvollen Kosten. Die Kostengrößen im Artikel dienen nur als anschauliche Beispiele, nicht als unabhängige Benchmarks. Reale Workloads müssen weiterhin getestet werden.
Was frustriert dich mehr: das Warten auf das erste Wort oder das Warten auf die fertige Antwort? #AIInference