

#inference
inference
1,600 مشاهدات
32 يقومون بالنقاش
رائج
جديد

⚡ تُعزّز رؤوس الأموال المؤسسية البنية التحتية للذكاء الاصطناعي مع تحوّل سرعة الاستدلال نحو $TAO 🔍
يشير استحواذ Prime Intellect على Moondream إلى تحوّل مؤسسي نحو الاستدلال عالي الكفاءة والتنفيذ متعدد الوسائط. 🦈 ومن خلال تأمين محرك Photon — الذي ينجز أكثر من 60 عملية استدلال في الثانية على وحدة أجهزة واحدة — تعمل رؤوس الأموال الذكية بنشاط على تقليل زمن الاستجابة عبر مسارات عمل الوكلاء المعقدة. 📊
تمثّل هذه الخطوة انتقالًا هيكليًا من الاعتماد على ضخامة النماذج إلى زيادة الإنتاجية التشغيلية بكفاءة. 💡 ومع تحوّل تسريع الاستدلال إلى طبقة السيولة الأساسية التي تدعم نشر الذكاء الاصطناعي في العالم الحقيقي، بدأت رؤوس الأموال بالفعل في اتخاذ مواقعها قبل تحوّل الاتجاه. 🌊
🤔 هل ستُشعل سرعة الاستدلال المحسّنة موجة الاختراق المستدامة التالية لبروتوكولات الذكاء الاصطناعي، أم لا تزال قيود الأجهزة المادية تُقيَّم بأقل من قيمتها؟ 👇
⚠️ هذه ليست نصيحة مالية. احرص دائمًا على إدارة مخاطرَك. 🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
1

·
--
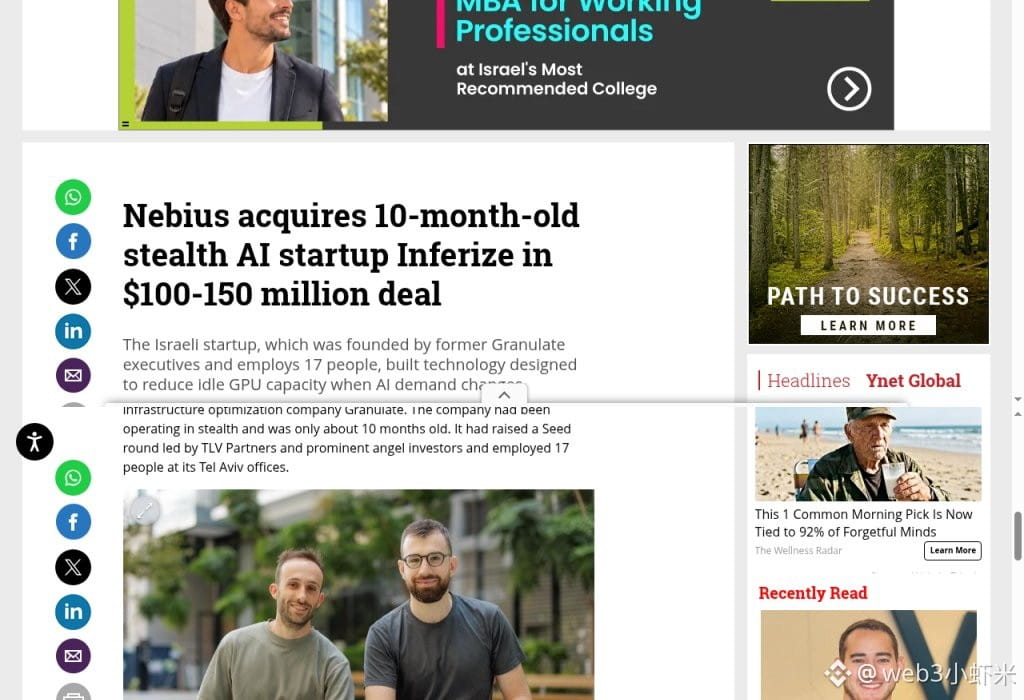
استحوذت Nebius، الشركة السحابية للذكاء الاصطناعي المُدرجة في ناسداك (الرمز $NBIS)، والتي تُعرف بأنها تأسست عبر CTech/Nebius، على شركة ناشئة إسرائيلية لتحسين الاستدلال (Inferize) تأسست قبل نحو 10 أشهر فقط. لم تُكشف تفاصيل شروط الصفقة رسميًا، ويقدّر CTech قيمتها بنحو 100–150 مليون دولار.
ما فعلوه محدد جدًا—إلغاء ما يُسمّى «ضريبة وحدات GPU الخاملة» عند بدء تشغيل النموذج ببرود. عند تحميل الأوزان، أو التوسّع، أو عند تبديل الأوزان أثناء التعلم المعزز، غالبًا ما تعاني البطاقات من خمول ووقت ضائع. تريد Inferize أن يكون سِعَة الحوسبة أقرب لتلبية الاحتياج الفعلي، بحيث ترفع معدل استغلال سعة Token Factory وتخفض تكلفة كل رمز (token).
الفريق يضم حوالي 17 شخصًا، والمؤسس سبق أن قاد فريقًا له صلة بشركة Granulate التي استحوذت عليها Intel. تقول Nebius إن الأشخاص والتقنيات ستُدمج ضمن منصة الاستدلال، كما كانت قد ضمّت في السابق قدرات مرتبطة بـ Eigen AI وClarifai.
من التدريب إلى النشر، تبدأ شركات السحابة بتكميل طبقات البرامج واحدة تلو الأخرى. إن استحواذات البنية التحتية الصغيرة والصلبة هذه أكثر إثارة للاهتمام من مجرد سرد القصص.
$NBIS #AI #Inference #Nebius
استحوذت Nebius، الشركة السحابية للذكاء الاصطناعي المُدرجة في ناسداك (الرمز $NBIS )، والتي تُعرف بأنها تأسست عبر CTech/Nebius، على شركة ناشئة إسرائيلية لتحسين الاستدلال (Inferize) تأسست قبل نحو 10 أشهر فقط. لم تُكشف تفاصيل شروط الصفقة رسميًا، ويقدّر CTech قيمتها بنحو 100–150 مليون دولار.
ما فعلوه محدد جدًا—إلغاء ما يُسمّى «ضريبة وحدات GPU الخاملة» عند بدء تشغيل النموذج ببرود. عند تحميل الأوزان، أو التوسّع، أو عند تبديل الأوزان أثناء التعلم المعزز، غالبًا ما تعاني البطاقات من خمول ووقت ضائع. تريد Inferize أن يكون سِعَة الحوسبة أقرب لتلبية الاحتياج الفعلي، بحيث ترفع معدل استغلال سعة Token Factory وتخفض تكلفة كل رمز (token).
الفريق يضم حوالي 17 شخصًا، والمؤسس سبق أن قاد فريقًا له صلة بشركة Granulate التي استحوذت عليها Intel. تقول Nebius إن الأشخاص والتقنيات ستُدمج ضمن منصة الاستدلال، كما كانت قد ضمّت في السابق قدرات مرتبطة بـ Eigen AI وClarifai.
من التدريب إلى النشر، تبدأ شركات السحابة بتكميل طبقات البرامج واحدة تلو الأخرى. إن استحواذات البنية التحتية الصغيرة والصلبة هذه أكثر إثارة للاهتمام من مجرد سرد القصص.
$NBIS #AI #Inference #Nebius
407

·
--
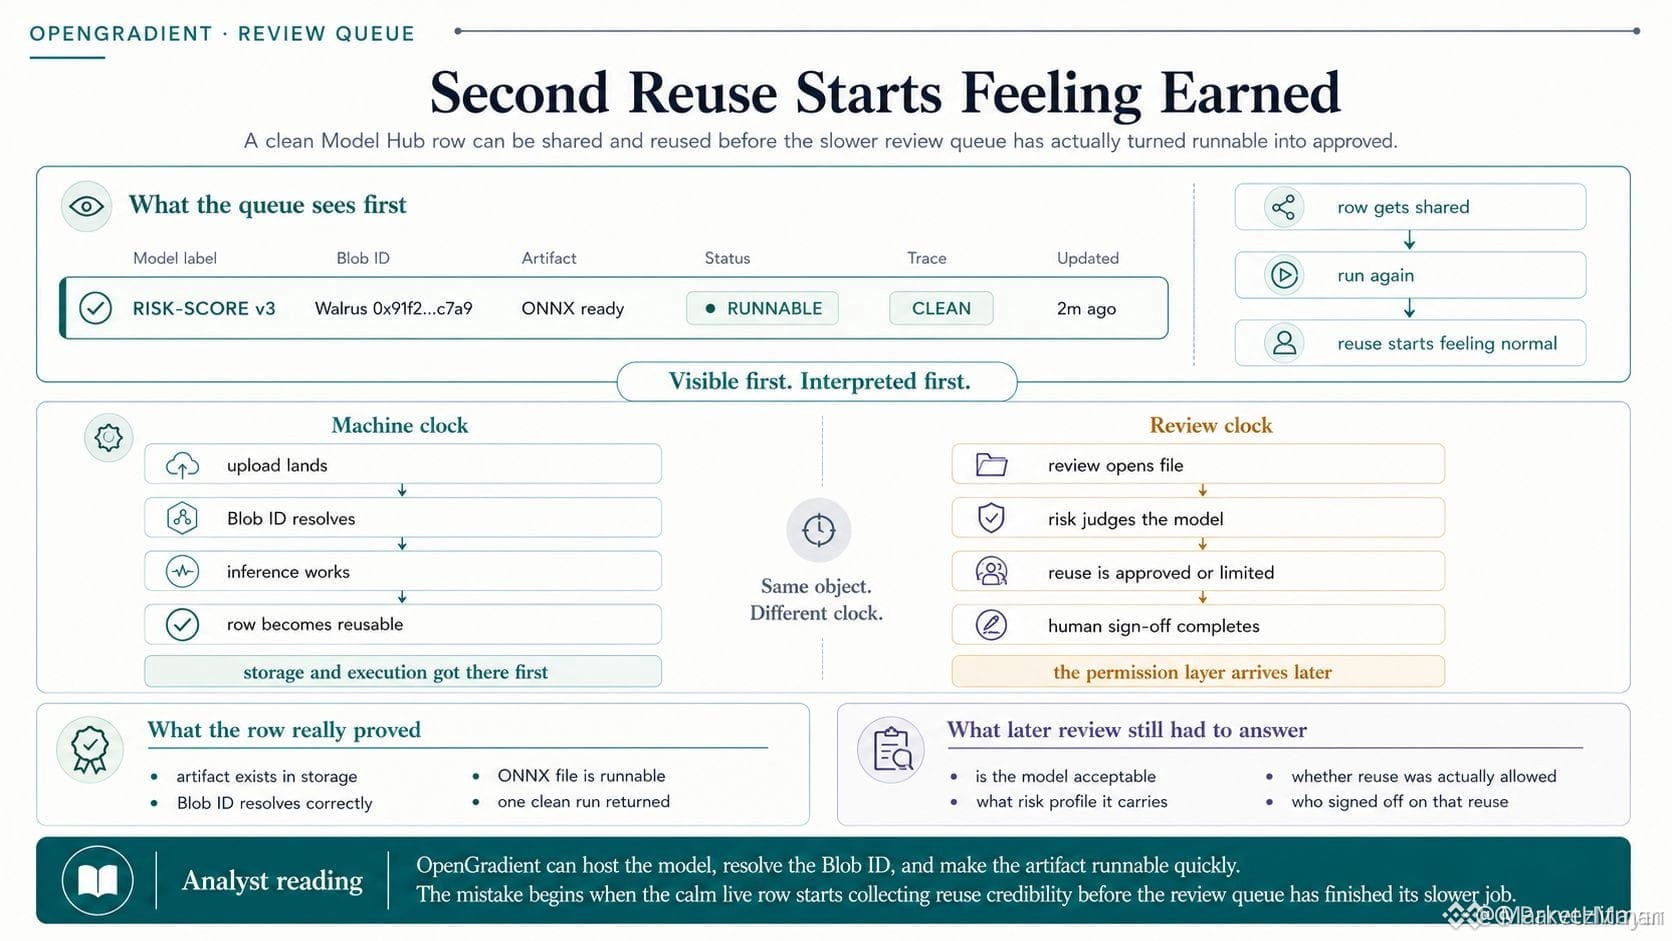
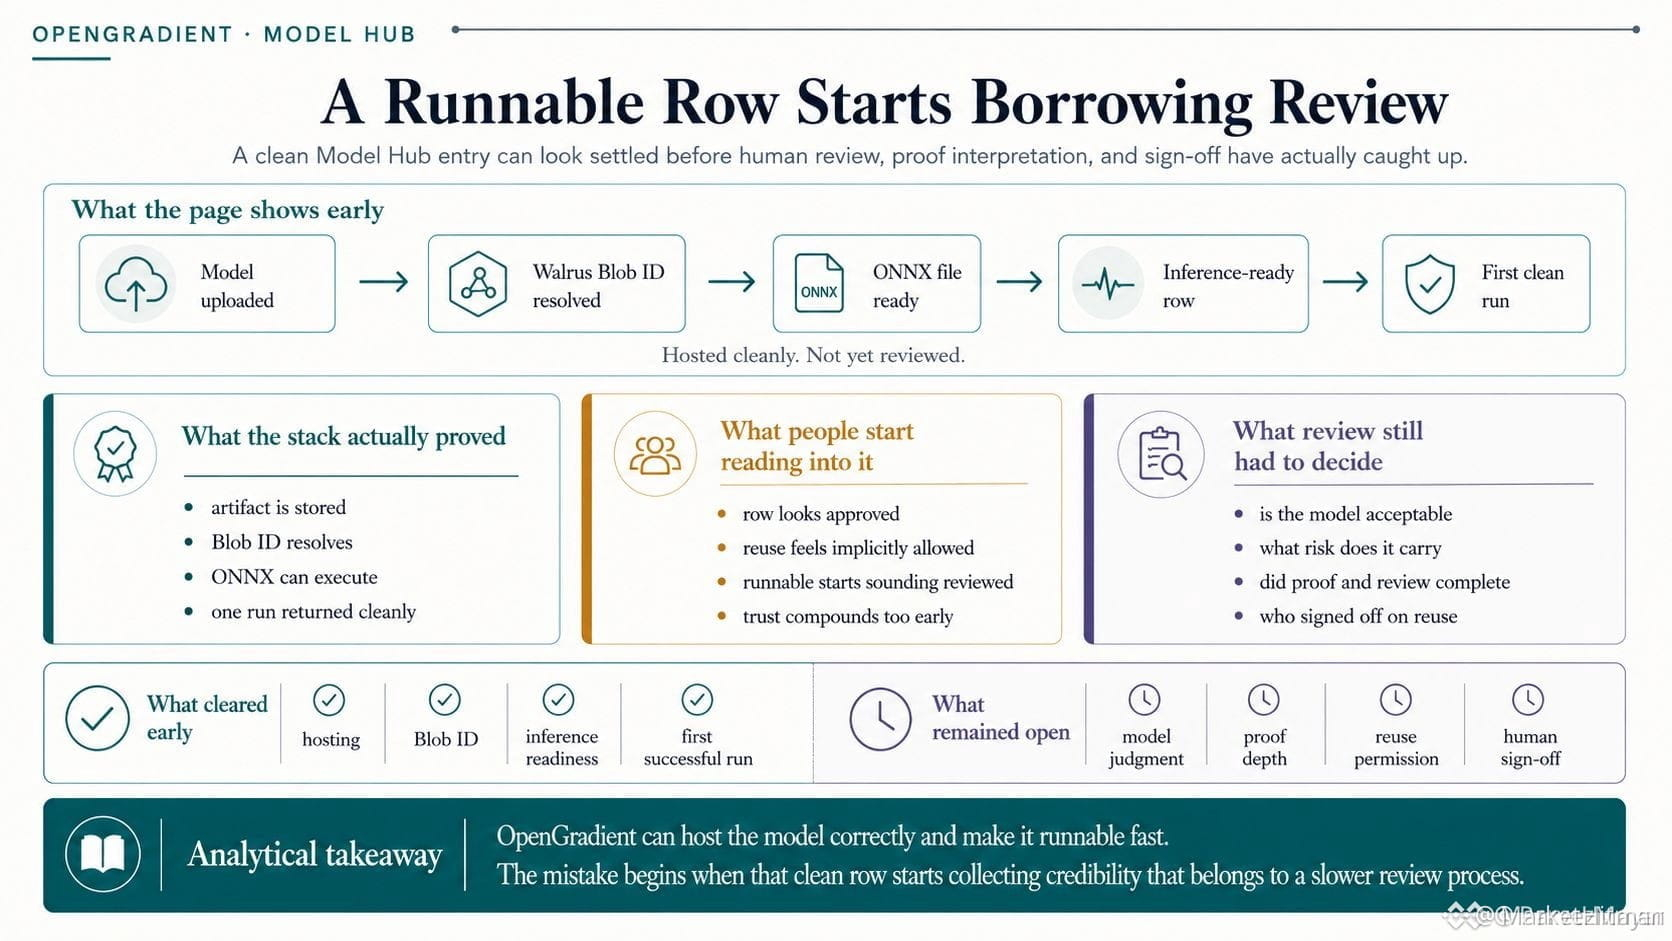
$OPG INFERENCE RUNS AHEAD OF THE REVIEW QUEUE 🔥
يتم التحقق من صف نموذج في OpenGradient Model Hub خلال ثوانٍ — تتبع نظيف، ومعرّف Walrus blob جاهز، وملف ONNX يعمل. لكن المراجعة البشرية تتأخر. بحلول الاستخدام الثالث، يبدأ ذلك الصف بالتصرف على أنه «تمت مراجعته» قبل أن يحصل أصلًا على الموافقة. النظام يعمل بشكل مثالي. العملية لا تعمل.
تخلق هذه الفجوة بين كفاءة الآلة والإشراف البشري نقطة عمياء. كان النموذج سليمًا، لكن هل تم تدقيقه فعلًا؟ إن تفضيل السرعة على الترتيب هو ميزة خفية — أو تسريب خفي.
هل تقوم بتشغيل نماذج اجتازت الآلة لكن تخطّت بوابة الإنسان؟
ليس نصيحة مالية. دائمًا أدرِ مخاطرَك.
#OPG #ModelHub #Inference #CryptoAI
🔥
19

$AI INFERENCE MEMORY COULD BE THE NEXT MAJOR BOTTLENECK IN CRYPTO AI 💎
يدحض محلل أبحاث Critini Jukan الرأي المتشائم بشأن مستقبل Micron، مشيرًا إلى أنه في مرحلة استدلال الذكاء الاصطناعي (AI inference)، فإن إضافة الذاكرة أكثر قيمة من إضافة وحدات GPUs. المشكلة ببساطة هي أن تكديس وحدات NVIDIA GPUs لا يحسن أداء الاستدلال، لأن وحدات GPUs غالبًا ما تكون خاملة بسبب اختناقات الذاكرة. العائد على الاستثمار النهائي للاستدلال يعتمد أكثر على الذاكرة من اعتماده على GPUs.
هذا التحول ينقل السرد من “الحوسبة” إلى “الذاكرة”—وهنا قد تشهد مشاريع التشفير التي تركز على التخزين اللامركزي وعرض نطاق الذاكرة (memory bandwidth) تحولًا نموذجيًا في القيمة. هل أنت مهيأ لهذا التحول في المرحلة؟
تنبيه: ليست نصيحة مالية. دائمًا أدرِك مخاطرك.
#AI #Memory #Inference #CryptoNarratives
💎
29
·
--
يعتقد الجميع أن نظام $BNB ecosystem لا يتحرك إلا عبر تحديثات السلسلة.
تقوم الدبلوماسية العالمية في الشرق الأوسط بإعادة توجيه قدرة الحوسبة بهدوء بعيدًا عن مجموعات العقد. عندما تواجه شركات ناشئة في مجال الذكاء الاصطناعي احتكاكًا في سلسلة التوريد، تتنافس الشبكات اللامركزية على نفس فتات السيليكون. راقب تكلفة عقد RPC بوصفها مؤشرًا رئيسيًا على الضغط الذي تتعرض له العتاد المحلي.
$BNB $ETH #CryptoInfra #TechTrends #Inference
57
·
--
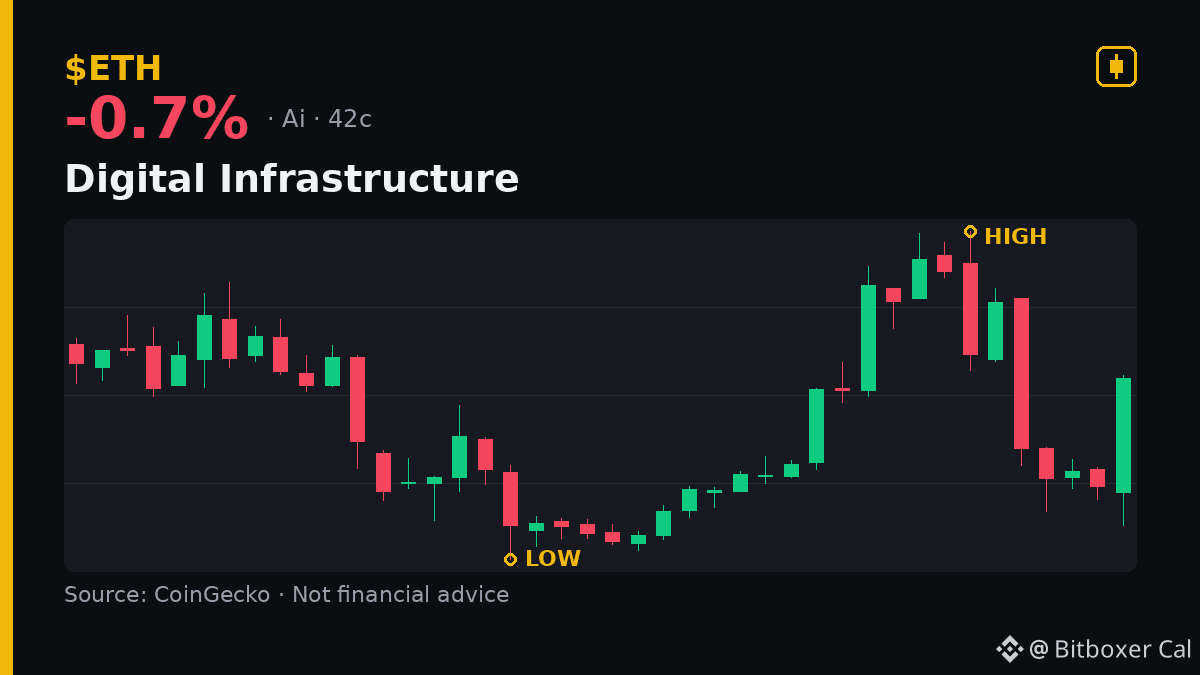
يقال لنا إن الذكاء الاصطناعي ليس سوى سباقٍ على أسلحةٍ تعتمد على العتاد.
هذا تشتيت. تُثبت شركات مثل Mandela Digital أن مرونة البرمجيات أهم من مجرد قوة الحوسبة الخام. تمامًا كما يحتاج المحرك الثقيل إلى هيكلٍ متين، فإن التطبيقات المالية على ETH أو BTC تتطلب بياناتَ يمكن التنبؤ بها—سواء كانت تعمل على رقائقٍ متطورة أو على عتادٍ قديم.
$ETH $BTC #AI #CryptoAI #Inference
هذا تشتيت. تُثبت شركات مثل Mandela Digital أن مرونة البرمجيات أهم من مجرد قوة الحوسبة الخام. تمامًا كما يحتاج المحرك الثقيل إلى هيكلٍ متين، فإن التطبيقات المالية على ETH أو BTC تتطلب بياناتَ يمكن التنبؤ بها—سواء كانت تعمل على رقائقٍ متطورة أو على عتادٍ قديم.
$ETH $BTC #AI #CryptoAI #Inference
69
·
--
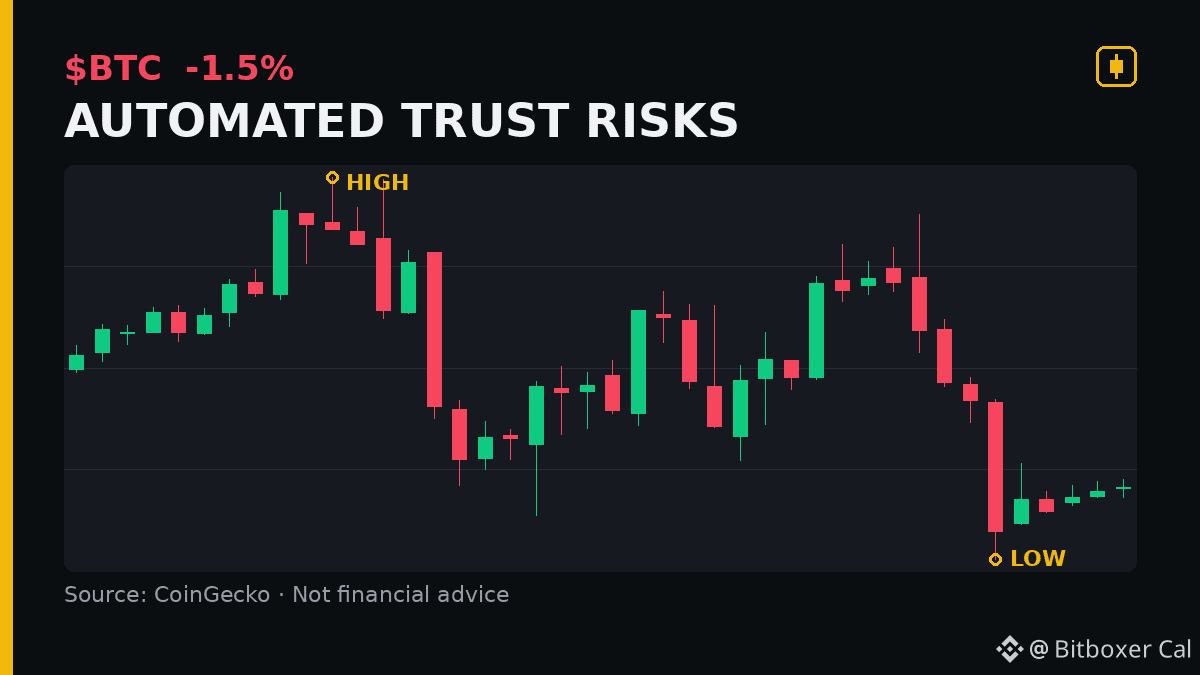
يريد المتفائلون أن تتولى الخوارزميات إدارة احتياطيات البيتكوين الوطنية لأنهم يعتقدون أن الرياضيات محصّنة من الأنا.
لكنهم ينسون أن الكود لا يملك ميزانية لتسوية الديون عندما تتعطل الأمور. إن الوثوق بتدفق منطقٍ غامض لا يمكن ترقيعه هو مجرد استبدال خطأ بشري بآلة لا يمكن مساءلتها. إذا هلوس النموذج، تُترك الجهة المعتمدة على النظام البيئي بلا شيء سوى فشلٍ في النظام.
$BTC $BNB #cryptoeducation #AI #Inference
لكنهم ينسون أن الكود لا يملك ميزانية لتسوية الديون عندما تتعطل الأمور. إن الوثوق بتدفق منطقٍ غامض لا يمكن ترقيعه هو مجرد استبدال خطأ بشري بآلة لا يمكن مساءلتها. إذا هلوس النموذج، تُترك الجهة المعتمدة على النظام البيئي بلا شيء سوى فشلٍ في النظام.
$BTC $BNB #cryptoeducation #AI #Inference
78

·
--
🚀 $AI RIPL يخفض زمن استدلال النماذج بمقدار 14 ضعفًا – ويعيد تعريف الحوسبة الطرفية الآنية! 📈
📊 يقلّص محرّك RIPL من Liquid AI زمن استجابة نموذج LFM2.5 ذي 1.2 مليار مُعامل إلى 34.6 مللي ثانية على وحدة NVIDIA B200 واحدة، مستجيبًا لـ95٪ من الطلبات البالغ عددها 1,000 طلب في الثانية ضمن تلك المدة. ⚡ وبالمقارنة مع 498 مللي ثانية لدى vLLM، تتسع الفجوة إلى 14.4 ضعفًا، ما يشير إلى ميزة طرفية حاسمة للسرعة في ترتيب نتائج البحث وضبط مخاطر المدفوعات.
🦈 يحوّل هذا التسارع نماذج اللغة إلى أدوات مرنة في الخطوط الأمامية، ويتيح للمؤسسات اقتناص السيولة قبل استقرار تدفق الأوامر. 💡 توقّعوا موجة تبنٍّ سريعة مع سعي الشركات إلى التفوق بفضل ميزة زمن الاستجابة، وسبق منافسيها في حلقات اتخاذ القرار الآني. 💬 كيف ستعيد ميزة السرعة هذه تشكيل استراتيجيتكم للذكاء الاصطناعي الآني؟ 👇
⚠️ هذه ليست نصيحة مالية. احرصوا دائمًا على إدارة المخاطر. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
4
·
--
تكشف PRIME INFERENCE عن اختراق في زمن استجابة التأخر للرموز بمقدار 1 تريليون token للـ $AI INFRASTRUCTURE ⚡ 📊
أطلقت Prime Intellect Prime Inference، حيث تعالج ما يقرب من 1 تريليون رمز يوميًا مع خفض زمن تأخر p90 بين الرموز بنسبة 40% لأحمال عمل الوكلاء المعقدة. 📊 من خلال فصل معالجة المطالبات وتوليد الاستجابة عبر وحدات GPUs، يعمل النظام على تحسين كفاءة الحوسبة على نطاق مؤسسي.
مع توسع بنسبة 50% في سعة ذاكرة KV cache حتى 1.63 مليون token لكل مفكك/decoder، يربط هذا النظام مفتوح المصدر بسلاسة بين تدريب النماذج والتنفيذ في الوقت الحقيقي. 💡 تعود البيانات التشغيلية باستمرار إلى مسارات التعلم المعزز، لتصبح كفاءة الاستدلال الخام هي المعيار التنافسي الحاسم. 🔍
💬 هل ترى أن تحسين الاستدلال مفتوح المصدر سيُسرّع نشر الوكلاء اللامركزيين، أم أن مراكز الحوسبة الخاصة ستحافظ على تفوقها؟ 👇
⚠️ ليس نصيحة مالية. دائمًا أدرِ مخاطرك. 🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
93
·
--
$CRBR تم ضبطه للإطلاق GPT-5.6 بمعدل 750 رمزًا/ثانية في يوليو 🚀
الدخول: $170 🔥
تأكيد Serenity بأن OpenAI ستقوم بنشر نموذج Sol الخاص بالجيل GPT-5.6 على أجهزة Cerebras هو محفّز مباشر لسهم الشركة. إن سرعة الاستدلال البالغة 750 رمزًا/ثانية تمنح ميزة تنافسية ملموسة مقارنةً بالمعماريات المعتمدة على وحدات GPU. يشير شراء Serenity عند $170 إلى قناعة قوية، لكنهم أيضًا يشيرون إلى أن التقييم الحالي مرتفع قليلًا مقارنةً بأقران مثل JBL.
السؤال الرئيسي هو ما إذا كان السوق قد تسعّر بالكامل علاوة الشراكة، أم إذا تمكن استمرار حجم التداول من دفع السهم إلى نطاق جديد. ما هو هدفك هنا — $200 أم تراجع أولًا؟
ليس نصيحة مالية. دائمًا تحكم في مخاطرك.
#CRBR #AI #Hardware #Inference #Breakout
🎯
17
$NVDA طلب استدلال الذكاء الاصطناعي لا يزال قوي ⚡
تقول سيتي غروب إن الندرة لم تعد تتعلق فقط بأحدث الشرائح. بل بدأت أيضًا تتسرب إلى وحدات معالجة الرسومات القديمة، ومراكز البيانات، وطرق الوصول إلى الطاقة، وطبقة التوجيه التي تقرر أي نموذج وأي عتاد يجب استخدامه.
هذا الأمر مهم لأن المرحلة التالية من قيمة الذكاء الاصطناعي قد لا تقتصر فقط على الحوسبة. السوق بدأ في تسعير مجموعة البنية التحتية الأوسع، من الشبكات الضوئية إلى السحابة وطبقات التطبيقات.
ليس نصيحة مالية. إدارة المخاطر الخاصة بك مهمة.
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
16
$CEREBRAS AT $170 WAS THE INSIDER ENTRY – NOW OPENAI CONFIRMS 🔥
Entry: 170 🔥
تقوم OpenAI بإطلاق GPT‑5.6 على أجهزة Cerebras الشهر المقبل، بمعدل يصل إلى 750 توكن في الثانية. هذا ليس مجرد إشاعة—بل تأكيد مباشر لسلسلة الاستدلال لديهم. سيرينتي، التي اشترت بسعر 170$، ما زالت ترى إمكانات طويلة المدى رغم علاوة السعر الحالية.
تزداد سخونة رواية البنية التحتية، وCerebras في قلب ذلك. السؤال الآن: هل يعكس السوق هذا المُحفّز بالكامل أم ما زالت هناك مساحة للصعود؟ هل تنتظر تراجعًا أم تقوم بالتجميع هنا؟
ليس نصيحة مالية. دائمًا أدرِ مخاطرِك.
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
28

أمازون ترفع الإنفاق الرأسمالي إلى 220 مليار دولار — لحظة طلب الاستدلال (Inference) عند $FET 🦈 💥
دورة الذكاء الاصطناعي تغيّرت للتو من مرحلة إلى أخرى. كان التدريب مجرد تمهيد — الاستدلال هو المكان الذي يُستهلك فيه الحوسبة فعليًا. يقول المسؤول عن الحوسبة السحابية لدى أمازون إن العملاء أنهوا مرحلة التجربة؛ فهم الآن يربطون النماذج مباشرة في سير العمل الإنتاجي. منحنى الطلب يتجه إلى أعلى. 📊
والآن ترفع AWS سقف الإنفاق الرأسمالي إلى 220 مليار دولار بحلول 2026. هذه ليست مجرد أرقام معدّلة — بل هي شركة كبرى تضع أكبر رهانات البنية التحتية في هذا العقد لإطعام محركات الاستدلال. عندما تتنافس عمالقة الويب2 على ندرة الحوسبة، تحصل رواية الذكاء الاصطناعي اللامركزي على مقعد في الطاولة. 💡
السوق ما زال يعيد تسعير أي الرموز (Tokens) ستَرث هذا الطلب. غالبًا ما يتأخر الزخم عن السردية حتى تؤكد أول اختراقات كبرى ذلك. 🔍 ما مشروع الذكاء الاصطناعي في محفظتك الذي يملك أقوى قصة استدلال واقعية؟ 💬
⚠️ ليست نصيحة مالية. دائمًا أدرِك مخاطرَك. 🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
135
·
--
زيبو يهدم حواجز السرعة باستخدام GLM-5.3-FLASHX مُشعِلًا التجمع البنيوي التالي $AI ! ⚡ 🚀
وصلت توسّعات الحوسبة بالذكاء الاصطناعي إلى وضع الدفع الفائق، حيث تكشف زيبو عن GLM-5.3-FlashX، مطلِقةً معدل تدفّق هائلًا يصل إلى 200 رمز في الثانية. ⚡ مدعومة بعوامل بنيوية داخلية تُحسّن الأداء على أكثر من 100,000 شريحة متخصصة، وتمت مضاعفة سرعات المعالجة من البداية إلى النهاية ثلاث مرات خلال أقل من أسبوعين.
تعني هذه القفزة الهائلة في السرعة الخام تحولًا ضخمًا نحو تنفيذ النماذج عالي الكفاءة عبر مشهد الذكاء اللامركزي. 📊 ومع تَحوّل سرعة الاستدلال الخام إلى الخندق الأقصى، تتقدم رؤوس الأموال الذكية بهدوء لتسبق أطروحة عنق الزجاجة في البنية التحتية. 💡
💬 هل ستُشعل محركات الاستدلال عالية السرعة خطوة التقييم الضخمة التالية لرموز الذكاء الاصطناعي هذا الربع؟ 👇
⚠️ ليست نصيحة مالية. دائمًا أدر مخاطرّك. 🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡ 🎯
55
خفض التكلفة بنسبة 70% الذي يقلب برمجة الذكاء الاصطناعي من الإيجار إلى أصل مُلك — $AMD 🦈 💥
أطلقت AMD حزمة مباشرة باتجاه المؤسسات: شرائح EPYC، وGPU من فئة Instinct، وخوادم Supermicro، وPaletteAI من Spectro Cloud، وGLM-5.2 — مع حليف واحد مُتكامل مسبقًا محليًا (على-الموقع) كمساعد مساعد (copilot) جاهز داخل صندوق. 🎯 الرقم الأهم في العنوان: انخفاض يصل إلى 70% في إجمالي التكلفة مقارنةً بنماذج سحابة رائدة، مع فترة استرداد رأس المال قد تكون سريعة حتى ستة أشهر.
الخطوة الحاسمة هي التوجيه المعتمد على السياسات — حيث تُبدّل PaletteAI تلقائيًا بين الاستدلال على-الموقع ونماذج سحابية من Anthropic أو OpenAI أو Google أو xAI عند الطلب، مع حصص للتوكنات وسجلات تدقيق ولوحات Grafana تكشف فجوة التكلفة الفعلية مباشرةً. 🔍
إنها برمجة بالذكاء الاصطناعي تنتقل من الإيجار بالعداد إلى بنية تحتية قابلة للتنبؤ — خطوة سيادية تعكس عقلية الحيازة الذاتية. 💬 هل ستواصل المؤسسات استئجار النماذج الرائدة أم ستبدأ في امتلاك القدرة الحاسوبية؟ 👇
⚠️ ليست نصيحة مالية. دائمًا أدِر مخاطرَك. 🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
90
·
--
🚨 $NVDA SHIFTS INSTITUTIONAL FOCUS TO AGENTIC AI INFERENCE EFFICIENCY! 🧠
قامت إنفيديا رسميًا بإطلاق الإنتاج الضخم لمعجّل Groq 3 LPX، مُعلِّمةً تحوّلًا بنيويًا رئيسيًا من التدريب على النماذج بشكلٍ بحت نحو التنفيذ المستمر. 🦈 يعمل كبار مشغّلي البنية التحتية مباشرةً عند حدود الطاقة، ما يجبر رأس المال الذكي على التحوّل إلى معماريات عالية الكفاءة لتطبيقات ذكاء اصطناعي وكيلـي متعددة الخطوات. 📊
يعيد هذا التحوّل معيار الأداء التشغيلي من القدرة الخام على المعالجة إلى كفاءة الحوسبة لكل واط محسّنة. 🔍 ومع استبدال الاستدلال الحي المستمر بالتدريب الثابت للنماذج، تصبح تصميمات العتاد المراعية للطاقة هي الميزة الفارقة على مستوى المؤسسات. 💡
🤔 هل ستجبر قيود الطاقة على إعادة تسعير كبيرة للقيمة عبر قطاعات الحوسبة عالية الأداء هذا العام؟ 👇
⚠️ ليست نصيحة مالية. دائمًا تعامل مع مخاطرك. 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
18
·
--
🚨 $AI INFERENCE SHIFT: رهانات بقيمة 200 مليون يورو ضد احتكار وحدات معالجة الرسوميات GPU ⚡
تُعد جولة "السلسلة A" البالغة 200 مليون يورو لشركة Euclyd، والتي تقودها بالاشتراك Samsung وEQT وSomerset، تصويتًا بنيويًا لصالح اعتبار استدلال (AI inference) هو عنق الزجاجة القادم. 📊 تمتلك الشركة 16,384 معالجًا داخل الذاكرة وخريطة طريق حتى عام 2028 بسرعة 2028 إكسافلوب لمهاجمة طبقة كفاءة الطاقة التي قد تكون وحدات GPU عرضة لها.
⚡ الفكرة المراوغة: الادعاء بأن الكفاءة تبلغ 100x لدى Nvidia يظل مجرد توقع، وليس دليلًا تجاريًا. إن الفجوة بين الطموح والتحقق هي بالضبط ما يراقبه المال الذكي بحثًا عن محفزات. 💬 هل هذه بداية دورة جديدة في عتاد الذكاء الاصطناعي، أم أنها لا تزال رواية غير مُثبتة؟ 👇
⚠️ ليست نصيحة مالية. دائمًا أدِر مخاطرك. 🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
39
·
--
تقرير سبيس إكس القادم ليس مجرد أخبارٍ شركاتية؛ بل يُبرز الصدام بين «الصناديق السوداء» الخاصة وبين $ETH و $BTC منهجيّة.
الشركات المركزية تطلب إيمانًا أعمى بــ«معادلات مجلس الإدارة». أما البروتوكولات اللامركزية فتجبر الكود على إثبات كل ادعاء. التدقيقات المستقلة في ميزانيتك أنت هي الطريقة الوحيدة لضمان أمانٍ حقيقي في هذا السوق.
$ETH $BTC #Web3 #Inference #DeFi
الشركات المركزية تطلب إيمانًا أعمى بــ«معادلات مجلس الإدارة». أما البروتوكولات اللامركزية فتجبر الكود على إثبات كل ادعاء. التدقيقات المستقلة في ميزانيتك أنت هي الطريقة الوحيدة لضمان أمانٍ حقيقي في هذا السوق.
$ETH $BTC #Web3 #Inference #DeFi
65

·
--
⚡ $FET AI INFERENCE BOTTLENECK PIVOTS TO MEMORY BANDWIDTH AS INSTITUTIONS RESTRUCTURE INFRASTRUCTURE! 📊
تتحول متطلبات الحوسبة المؤسسية بشكلٍ كبير من السعة الخام للذاكرة إلى تنسيق عرض نطاق شديد الكفاءة. 📊 ومع سيادة بنية MoE، أصبحّت سرعة التوجيه عبر مسارات Prefill وDecode هي عنق الزجاجة الأساسي لتجهيزات البنية التحتية للأجهزة من الجيل التالي.
يحدد الآن جدولة ذاكرة التخزين المؤقت KV على طبقات وتدفق عرض النطاق كفاءة العنقود بدلًا من الاعتماد على الكثافة الخام للأجهزة. 🔍 يستثمر رأس المال الذكي حول بروتوكولات البنية التحتية التي تُحسّن عبء نقل البيانات قبل التوسّع التوسعي التالي.
💡 تُجبر بنى العقد المفككة على إجراء إعادة شاملة في استراتيجيات تخصيص العتاد داخل المؤسسات. 💬 هل ستلتقط بروتوكولات تحسين عرض النطاق الدور البنيوي التالي في الحوسبة اللامركزية؟ 👇
⚠️ ليست نصيحة مالية. تحمّل دائمًا مسؤولية مخاطرك. 🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
239

·
--
$AI تكاليف البنية التحتية ترتفع مع زيادة الطلب على الاستدلال ⚡
تقول سيتي جروب إن الطلب على استدلال الذكاء الاصطناعي لا يزال ساخنًا، والضغط لم يعد مقتصرًا على أحدث الشرائح. الندرة تنتشر عبر وحدات معالجة الرسوميات، ومراكز البيانات، والوصول إلى الطاقة، وطبقات التوجيه، مما يعني أن السوق الآن يسعر كل الطبقات، وليس فقط أشباه الموصلات.
النقطة الأساسية هي هيكلية: بائعو النماذج يحققون الأرباح بشكل أسرع، بينما أصبحت اختناقات البنية التحتية هي القيد الحقيقي. إذا استمر هذا الاتجاه، قد تستمر القيمة في التدوير نحو الطبقات التي تساعد على تقليل تكلفة الاستدلال وتخصيص الحوسبة بشكل أكثر كفاءة.
ليس نصيحة مالية. ادارة المخاطر الخاصة بك.
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
64
سجّل الدخول لاستكشاف المزيد من المُحتوى
انضم إلى مُستخدمي العملات الرقمية حول العالم على Binance Square
⚡️ احصل على أحدث المعلومات المفيدة عن العملات الرقمية.
💬 موثوقة من قبل أكبر منصّة لتداول العملات الرقمية في العالم.
👍 اكتشف الرؤى الحقيقية من صنّاع المُحتوى الموثوقين.
البريد الإلكتروني / رقم الهاتف
المواضيع الرائجة
1
#BinanceProcesses$4.65BWithdrawals
18,736 مشاهدات
101 يقومون بالنقاش
2
#WithdrawalsBack: 15 networks live
6,952 مشاهدات
121 يقومون بالنقاش
3
#BinanceUpdatesProofofReservesAddresses
113,477 مشاهدات
1,490 يقومون بالنقاش
4
#BinanceToResumePhaseOneOfWithdrawals
151,896 مشاهدات
1,574 يقومون بالنقاش
5
#BinanceHadAlreadyCovered$6BofHackLoss
10,247 مشاهدات
136 يقومون بالنقاش
6
#FBIConfirmsNorthKoreaIsResponsibleForBinanceCryptoHack
49,647 مشاهدات
149 يقومون بالنقاش
7
#CZDismissesClaimsBinanceHackWasPredicted
77,484 مشاهدات
745 يقومون بالنقاش
8
#B14gReportsUnauthorizedTransferOfAbout97MCORE
28,092 مشاهدات
378 يقومون بالنقاش
9
#USSpotETHETFsPost23StraightDaysOfNetOutflows
30,623 مشاهدات
369 يقومون بالنقاش
10
#IntelHasItsWorstDaySince1974
124,110 مشاهدات
977 يقومون بالنقاش