

MarsBit News
98.2k Bài đăng

MarsBit News
 Đã xác minh nâng cao trên Square
Báo cáo
Chặn người dùng
领先的区块链中文媒体,追踪全球加密技术领域的每一个脚步,聚焦 BTC/ETH等公链、NFT、DeFi、Web3、DAO、数字金融。
0 Đang theo dõi
16.3K+ Người theo dõi
22.8K+ Đã thích
Bài đăng
·
--
Xem bản dịch
Bitdeer 本周出售 288.4 枚 BTC,维持比特币零持仓火星财经消息,纳斯达克上市比特币矿企 Bitdeer 在 X 平台发文表示,截至 9 月 25 日当周,其比特币挖矿产出为 288.1 枚 BTC,同期出售 288.4 枚 BTC,净新增 0 枚 BTC,当前仍维持比特币零持仓。
Bitdeer 本周出售 288.4 枚 BTC,维持比特币零持仓
火星财经消息,纳斯达克上市比特币矿企 Bitdeer 在 X 平台发文表示,截至 9 月 25 日当周,其比特币挖矿产出为 288.1 枚 BTC,同期出售 288.4 枚 BTC,净新增 0 枚 BTC,当前仍维持比特币零持仓。
58
·
--
Xem bản dịch
随着推理需求激增,Fireworks与Fal考虑开启新一轮融资Fal、Fireworks AI这类提供AI模型与服务器调用服务的初创企业营收持续走高。开发者借助它们快速运行模型,也引发投资者新一轮的投资热潮。据两名知情人士透露,专注为谷歌Nano Banana等图像、视频生成模型提供推理服务的Fal,已和投资者洽谈新一轮融资,目标估值150亿美元。另有第三位知情人士称,谈判尚处于早期阶段,该公司有可能把目标估值上调至170亿至200亿美元区间。(新浪财经)
随着推理需求激增,Fireworks与Fal考虑开启新一轮融资
Fal、Fireworks AI这类提供AI模型与服务器调用服务的初创企业营收持续走高。开发者借助它们快速运行模型,也引发投资者新一轮的投资热潮。据两名知情人士透露,专注为谷歌Nano Banana等图像、视频生成模型提供推理服务的Fal,已和投资者洽谈新一轮融资,目标估值150亿美元。另有第三位知情人士称,谈判尚处于早期阶段,该公司有可能把目标估值上调至170亿至200亿美元区间。(新浪财经)
32
·
--
Xem bản dịch
数据:当前加密恐慌贪婪指数为 75,处于贪婪状态火星财经消息,据 Coinglass 数据显示,加密货币恐慌贪婪指数当前为 75,较昨日上涨 3 点。过去 7 天平均值为 73,过去 30 天平均值为 66。
数据:当前加密恐慌贪婪指数为 75,处于贪婪状态
火星财经消息,据 Coinglass 数据显示,加密货币恐慌贪婪指数当前为 75,较昨日上涨 3 点。过去 7 天平均值为 73,过去 30 天平均值为 66。
21
·
--
Xem bản dịch
马斯克豪言:SpaceX数据中心GPU数量到年底翻一倍火星财经消息 9月26日,据报道,马斯克周四表示,SpaceX的人工智能超级计算机Colossus 2项目计划大规模扩张,到今年年底其使用的英伟达芯片数量将较目前翻一倍以上。马斯克在X上表示,Colossus 2数据中心目前已搭载11万颗Nvidia GB200芯片和44万颗GB300芯片。下周将有22万颗GB300芯片投入使用,预计11月还将有22万颗投入使用。如果运气好的话,12月底可能还会有22万颗芯片上线。(广角观察)
马斯克豪言:SpaceX数据中心GPU数量到年底翻一倍
火星财经消息 9月26日,据报道,马斯克周四表示,SpaceX的人工智能超级计算机Colossus 2项目计划大规模扩张,到今年年底其使用的英伟达芯片数量将较目前翻一倍以上。马斯克在X上表示,Colossus 2数据中心目前已搭载11万颗Nvidia GB200芯片和44万颗GB300芯片。下周将有22万颗GB300芯片投入使用,预计11月还将有22万颗投入使用。如果运气好的话,12月底可能还会有22万颗芯片上线。(广角观察)
39
·
--
Xem bản dịch
数据:以太坊现货 ETF 昨日总净流入 8694.69 万美元,持续 6 日净流入火星财经消息,根据 SoSoValue 数据,昨日(美东时间 9 月 25 日)以太坊现货 ETF 总净流入 8694.69 万美元。 昨日单日净流入最多的以太坊现货 ETF 为贝莱德(Blackrock) ETF ETHA,单日净流入为 5037.01 万美元,目前 ETHA 历史总净流入达 132.84 亿美元。 其次为贝莱德(Blackrock)Staked ETH ETF ETHB,单日净流入为 3188.45 万美元,目前 ETHB 历史总净流入达 8.85 亿美元。 截至发稿前,以太坊现货 ETF 总资产净值为 177.79 亿美元,ETF 净资产比率(市值较以太坊总市值占比)达 5.42%,历史累计净流入已达 139.40 亿美元。
数据:以太坊现货 ETF 昨日总净流入 8694.69 万美元,持续 6 日净流入
火星财经消息,根据 SoSoValue 数据,昨日(美东时间 9 月 25 日)以太坊现货 ETF 总净流入 8694.69 万美元。 昨日单日净流入最多的以太坊现货 ETF 为贝莱德(Blackrock) ETF ETHA,单日净流入为 5037.01 万美元,目前 ETHA 历史总净流入达 132.84 亿美元。 其次为贝莱德(Blackrock)Staked ETH ETF ETHB,单日净流入为 3188.45 万美元,目前 ETHB 历史总净流入达 8.85 亿美元。 截至发稿前,以太坊现货 ETF 总资产净值为 177.79 亿美元,ETF 净资产比率(市值较以太坊总市值占比)达 5.42%,历史累计净流入已达 139.40 亿美元。
17
·
--
Xem bản dịch
数据:比特币现货 ETF 昨日总净流入 1.34 亿美元,持续 7 日净流入火星财经消息,根据 SoSoValue 数据,比特币现货 ETF 昨日(美东时间 9 月 25 日)总净流入 1.34 亿美元。单日净流入最多的比特币现货 ETF 为贝莱德 (Blackrock) ETF IBIT,单日净流入为 9,699.18 万美元,目前 IBIT 历史总净流入达 652.82 亿美元。其次为富达 (Fidelity) ETF FBTC,单日净流入为 4,932.12 万美元,目前 FBTC 历史总净流入达 110.64 亿美元。昨日单日净流出最多的比特币现货 ETF 为 Bitwise ETF BITB,单日净流出为 1,184.78 万美元,目前 BITB 历史总净流入达 21.29 亿美元。截至发稿前,比特币现货 ETF 总资产净值为 1,084.23 亿美元,ETF 净资产比率(市值较比特币总市值占比)达 6.43%,历史累计净流入已达 575.47 亿美元。
数据:比特币现货 ETF 昨日总净流入 1.34 亿美元,持续 7 日净流入
火星财经消息,根据 SoSoValue 数据,比特币现货 ETF 昨日(美东时间 9 月 25 日)总净流入 1.34 亿美元。单日净流入最多的比特币现货 ETF 为贝莱德 (Blackrock) ETF IBIT,单日净流入为 9,699.18 万美元,目前 IBIT 历史总净流入达 652.82 亿美元。其次为富达 (Fidelity) ETF FBTC,单日净流入为 4,932.12 万美元,目前 FBTC 历史总净流入达 110.64 亿美元。昨日单日净流出最多的比特币现货 ETF 为 Bitwise ETF BITB,单日净流出为 1,184.78 万美元,目前 BITB 历史总净流入达 21.29 亿美元。截至发稿前,比特币现货 ETF 总资产净值为 1,084.23 亿美元,ETF 净资产比率(市值较比特币总市值占比)达 6.43%,历史累计净流入已达 575.47 亿美元。
28
·
--
Xem bản dịch
Anthropic据悉正洽谈一项规模达1吉瓦的数据中心容量交易据报道,Anthropic正开展初步谈判,拟从阿波罗全球管理控股的数据中心开发商手中租赁最高1吉瓦的算力容量。(界面)
Anthropic据悉正洽谈一项规模达1吉瓦的数据中心容量交易
据报道,Anthropic正开展初步谈判,拟从阿波罗全球管理控股的数据中心开发商手中租赁最高1吉瓦的算力容量。(界面)
12
·
--
Bài viết
Xem bản dịch
AI代写论文露馅?顶刊主编一问,作者啥都答不上来null
编辑|Panda
你写了一篇论文,现在问你三个问题:你这篇论文的问题设定是什么?这个符号代表什么?摘要里说的这个结论,在正文哪一部分得到了支撑?
如果论文真是你写的,那这些问题肯定很简单,甚至不用准备就能答出来。
但在机器学习期刊 TMLR(Transactions on Machine Learning Research)最近的一次小规模试验中,有三篇论文的作者连这些基础问题都答不上来。
9 月 16 日,TMLR 在官方博客上发布了一篇题为《向作者询问他们自己的论文》的文章,作者是该刊联合主编之一、卡内基梅隆大学(CMU)的 Nihar B. Shah。他在两周的主编轮值期内,挑出 10 篇原本要被直接拒稿(desk rejection)的投稿,没有直接拒掉,而是逐一约作者「聊聊」。结果,这 10 篇论文还是全部被拒了。
https://medium.com/@TmlrOrg/asking-authors-about-their-own-papers-3d2e04e5dee0
同为 TMLR 主编的 Gautam Kamath 在 𝕏 上转发时称这是一次「英勇的实验」,并说它证实了很多人心里早有的猜测:一部分投稿者其实并不知道自己的论文里写了什么。
抽查 10 篇待拒稿,都拒了
据 Shah 的描述,这次试验发生在 2026 年 8 月 14 日至 28 日他轮值主编期间。他从待直接拒稿的论文中非正式地抽取了 10 篇,通过审稿平台 OpenReview 给作者发去一条简短消息:一位主编希望在送审之前和您聊聊,以便更好地理解这篇论文,如果方便,请发邮件告知可约时间。
消息发出后,事情迅速分化。一篇论文的作者直接撤稿;一位作者回复说手头事情太多,没空通话;剩下 8 篇约上了会,但其中一位作者到点没有出现。
最终与 Shah 见上面的,是 7 篇论文的作者。他们身份各异,包括本科生、硕士生、博士生、高校教师和独立研究者。这批论文大多是单作者论文,但并非全部。
Shah 的提问分两类:一类是关于问题设定、符号和论文所声称结果的基础问题,另一类是关于具体技术表达式、理论结果和实验设计选择的细节问题。
7 场会谈里,只有 1 篇论文的作者答上了全部问题。 另有 3 篇的作者能讲清高层思路,但一被追问技术细节就陷入困难。最糟糕的是另外 3 篇,作者连基础问题都答不上来,而且这 3 篇全是单作者论文。
Shah 写道,其中两位作者看起来对自己论文的内容几乎没有实质理解,另一位则找不到摘要中声称的几项关键结果究竟在正文哪里给出或得到支撑。
唯一全部答对的那篇,也没能过关。Shah 在审读中发现,论文的一项主要结论存在重大错误,作者随后也承认了。TMLR 对这篇作了直接拒稿,但允许作者在修正错误或收窄结论后重新投稿。其余 9 篇则被直接拒稿,且不开放重投。
会后的两个插曲
Shah 在文中还记录了两件事,读来颇具黑色幽默。
第一件:有两篇论文的作者在会上答不出基础问题,会后却给他发来了书面答复。Shah 把这两封邮件交给 AI 文本检测工具 Pangram,结果均被判定为「100% AI」。
第二件:另一场会谈中,一位作者试图向 Shah 介绍自己用到的分析方法,结果讲着讲着,无意间完整描述了一套 p-hacking 流程,也就是通过反复调整分析方式、直到数据「显著」为止的做法。
需要说明的是,Shah 本人并不排斥 AI。他在文中坦言,为了在两周内读完 8 篇论文,他自己也借助了 LLM 来辅助理解,甚至学习了一些此前不熟悉的概念。他关心的并不是作者有没有用 AI,而是作者能否为署着自己名字的内容负责。
为什么要做这件事?
TMLR 创刊于 2022 年,由 JMLR 背后的团队运营,以「只看结论是否被证据支撑,不以新颖性和 SOTA 作为拒稿理由」的审稿标准著称。它的审稿人、执行编辑(Action Editor)和主编全部是无偿志愿者,这也让它在今年的投稿潮中格外吃力。
根据 TMLR 6 月发布的公告,过去一年里其投稿量增长到原来的三倍,其中单作者投稿更是暴增至 13 倍,编辑部甚至见过有人一天投出 5 篇论文。Shah 在最新文章中给出的另一组数字更直观:2023 年,TMLR 直接拒稿的比例约为 6%,如今已升至约 53%,也就是说超过一半的投稿走不到外审环节。
面对这种局面,TMLR 在今年夏天密集推出了一系列措施。
其一是按作者设置年度投稿配额。与许多会议「每人最多 N 篇」的固定上限不同,TMLR 采用了一种「调和式」配额规则,一篇论文消耗每位作者的额度会随合著者人数增加而递减。具体参数是:只投单作者论文的人,每年最多投 2 篇;若所有投稿都是 9 人合著,则每年最多 9 篇;活跃的审稿人和执行编辑额度翻倍。该规则从 7 月 1 日起执行。TMLR 在公告中解释,之所以不按人数平摊,是为了防止有人靠挂名「凑作者」来换取更多投稿额度。
其二是引入 AI 审稿。TMLR 7 月宣布,每篇投稿将在常规人工审稿之外附带一份 AI 生成的审稿意见,只评估论文的「可靠性」,即结论是否有准确、清晰、令人信服的证据支撑,不做主观判断,也不给出录用建议,最终决定仍由执行编辑作出。经过评测,TMLR 选用了 CSPaper 的 AI 审稿器。
其三是把「写得清楚」写进录用标准。8 月 28 日,TMLR 修改了原有的「受众兴趣」标准,明确要求论文要向读者清楚地传达其发现。公告直言,当前的 AI 写作往往绕、术语堆砌、难以读懂;如果一篇论文几乎完全由 AI 生成、缺少人的参与,至少以现有 AI 系统的水平,它很可能达不到这一标准。
Shah 在文章结尾总结,这次约谈让编辑部对现有的直接拒稿流程更有信心,配额制度和对清晰写作的强调也被证明很有帮助。
不只是 TMLR
TMLR 的遭遇并非孤例。今年以来,AI 领域几个重要的发表渠道都在与同一个问题搏斗。
6 月初,NeurIPS 官方博客披露,NeurIPS 2026 立场论文(Position Paper)赛道的 971 篇投稿中,有 273 篇(28.2%)被 Pangram 判为 AI 分数 100%。
https://blog.neurips.cc/2026/06/02/ai-generated-papers-in-the-neurips-2026-position-paper-track/
该赛道今年明确要求论文必须「实质上由人类撰写」,AI 只能用于文字润色等外围修改。NeurIPS 同时指出,AI 写作的增长是全面性的:在「评测与数据集」赛道,Pangram 分数不低于 90% 的论文数从 2025 年到 2026 年增长了十倍以上。不过 NeurIPS 也承认检测结果对参数敏感,改用中等尺寸的检测窗口后,AI 分数在 90% 至 100% 区间的论文比例会从 42.7% 降至 12.7%。
更早的 5 月中旬,arXiv 计算机科学板块负责人 Thomas G. Dietterich 在社交媒体上宣布了一项明确罚则:如果一篇投稿中存在作者未检查大模型输出的「确凿证据」,比如幻觉参考文献、遗留在正文里的聊天机器人对话语句,所有作者将被禁止在 arXiv 投稿一年,此后的投稿必须先被正规同行评审渠道接收才能上架。Dietterich 强调,在论文上署名,就意味着每位作者要对全部内容负责,无论这些内容是怎样生成的。
与此相关的数据同样刺眼。据哥伦比亚大学的一项《柳叶刀》研究,在 PubMed Central 收录的生物医学论文中,含有至少一条虚构引用的论文比例,从 2023 年的约万分之 4,升至 2026 年初的约万分之 57。
https://www.nursing.columbia.edu/news/nearly-3-000-peer-reviewed-medical-papers-have-fake-citations-columbia-nursing-ai-assisted-audit-finds
从「查文本」到「查人」
Shah 在文中坦承,这次试验花掉了他 20 到 25 个小时,只处理了 8 篇论文,面对如今的投稿规模,这种做法很难推广。
他同时提到,自己的团队正在研究可规模化的方案。
而就在前几天,Shah 与 CMU 的 Justin Payan、Bálint Gyevnár、Atoosa Kasirzadeh 发布了一篇论文,提出名为greCAPTCHA的评估方法。名字一半取自美国研究生入学考试 GRE,一半取自区分人与机器的 CAPTCHA 验证码。
https://www.cs.cmu.edu/~nihars/preprints/greCAPTCHA.pdf
它的思路是:不再去检测文本是不是 AI 写的,而是直接考作者。作者提交论文和一份个人贡献说明,系统据此自动生成题目,作者在监考条件下作答,最后生成一份评估报告,供期刊、招聘或招生方参考。研究者把要考察的能力称为「核验能力(capacity to verify)」,即作者是否具备批判性评估自己所贡献内容的知识和推理能力。
题目分为四类:在多个版本中识别论文真实报告的数据(预置错误识别)、解释论文没有写明理由的设计选择、解释论文默认读者已知的背景概念,以及指出方法在什么具体条件下会失效。
团队招募了 31 名研究者进行测试,每人分别就自己的论文和一篇陌生论文作答。结果显示,系统区分「自己的论文」和「陌生论文」的 AUC 达到 0.90,去掉选择题后升至 0.934。选择题本身几乎没有区分度,AUC 只有 0.595,原因很简单,答案可以直接在 PDF 里搜到。另一个值得注意的结果是,受试者面对本领域和跨领域陌生论文时,得分没有统计学上的显著差异,说明这套题考的不只是领域知识。
一位受试者的经历颇能说明问题:他在测试前把陌生论文丢给 AI,让它从头到尾讲解了一遍,但面对深入问题依然答不上来,陌生论文得分 1.3,自己论文得分 51。
但这套系统远未成熟。论文报告的最低误判率约为 20%,也就是说,每五位真正的作者里可能有一位被误判。受试者对评分的抱怨最多:不清楚该答到多细、评分标准过于死板。一位作者面对否定自己答案的评分标准时脱口而出,那个东西明明是我自己设计的。还有受试者指出,合作论文中有些部分由合著者完成,自己本就答不上来;也有人担心,这类考试会在无形中考察英语表达、打字速度,对非英语母语者和残障研究者不公平。
结语
Shah 在文中列出了几点结论,这两点值得一看:
一是credit 分配。在今天的科研生态里,学术贡献主要通过论文署名来认定。如果作者无法解释、无法捍卫自己的论文,一篇发表作为「研究者贡献」的信号价值就大打折扣。
二是审稿体系的循环。许多期刊和会议会邀请投稿作者去审别人的论文。如果作者连自己的论文都看不懂,他们能否胜任审稿,自然要打上问号。在 AI 审稿、AI 写作同时涌入的当下,这个循环一旦断裂,同行评审的根基就会被掏空。
当然,这次试验本身也有明显的局限。10 篇样本数量很小,是 Shah「非正式」抽取的,而且全部来自原本就要被直接拒稿的论文,它能说明的是「被判定为低质量的投稿里有什么」,而不是 TMLR 投稿的整体面貌。这一点 Shah 自己也写了:试验的目的之一,正是检验直接拒稿流程是否靠谱。
但 Shah 的这次试验至少给出了一个底线:一篇论文可以由 AI 帮忙完成,但署名的人必须能说清楚里面写了什么。
本文来自微信公众号“机器之心”(ID:almosthuman2014),作者:机器之心
AI代写论文露馅?顶刊主编一问,作者啥都答不上来
null
编辑|Panda
你写了一篇论文,现在问你三个问题:你这篇论文的问题设定是什么?这个符号代表什么?摘要里说的这个结论,在正文哪一部分得到了支撑?
如果论文真是你写的,那这些问题肯定很简单,甚至不用准备就能答出来。
但在机器学习期刊 TMLR(Transactions on Machine Learning Research)最近的一次小规模试验中,有三篇论文的作者连这些基础问题都答不上来。
9 月 16 日,TMLR 在官方博客上发布了一篇题为《向作者询问他们自己的论文》的文章,作者是该刊联合主编之一、卡内基梅隆大学(CMU)的 Nihar B. Shah。他在两周的主编轮值期内,挑出 10 篇原本要被直接拒稿(desk rejection)的投稿,没有直接拒掉,而是逐一约作者「聊聊」。结果,这 10 篇论文还是全部被拒了。
https://medium.com/@TmlrOrg/asking-authors-about-their-own-papers-3d2e04e5dee0
同为 TMLR 主编的 Gautam Kamath 在 𝕏 上转发时称这是一次「英勇的实验」,并说它证实了很多人心里早有的猜测:一部分投稿者其实并不知道自己的论文里写了什么。
抽查 10 篇待拒稿,都拒了
据 Shah 的描述,这次试验发生在 2026 年 8 月 14 日至 28 日他轮值主编期间。他从待直接拒稿的论文中非正式地抽取了 10 篇,通过审稿平台 OpenReview 给作者发去一条简短消息:一位主编希望在送审之前和您聊聊,以便更好地理解这篇论文,如果方便,请发邮件告知可约时间。
消息发出后,事情迅速分化。一篇论文的作者直接撤稿;一位作者回复说手头事情太多,没空通话;剩下 8 篇约上了会,但其中一位作者到点没有出现。
最终与 Shah 见上面的,是 7 篇论文的作者。他们身份各异,包括本科生、硕士生、博士生、高校教师和独立研究者。这批论文大多是单作者论文,但并非全部。
Shah 的提问分两类:一类是关于问题设定、符号和论文所声称结果的基础问题,另一类是关于具体技术表达式、理论结果和实验设计选择的细节问题。
7 场会谈里,只有 1 篇论文的作者答上了全部问题。 另有 3 篇的作者能讲清高层思路,但一被追问技术细节就陷入困难。最糟糕的是另外 3 篇,作者连基础问题都答不上来,而且这 3 篇全是单作者论文。
Shah 写道,其中两位作者看起来对自己论文的内容几乎没有实质理解,另一位则找不到摘要中声称的几项关键结果究竟在正文哪里给出或得到支撑。
唯一全部答对的那篇,也没能过关。Shah 在审读中发现,论文的一项主要结论存在重大错误,作者随后也承认了。TMLR 对这篇作了直接拒稿,但允许作者在修正错误或收窄结论后重新投稿。其余 9 篇则被直接拒稿,且不开放重投。
会后的两个插曲
Shah 在文中还记录了两件事,读来颇具黑色幽默。
第一件:有两篇论文的作者在会上答不出基础问题,会后却给他发来了书面答复。Shah 把这两封邮件交给 AI 文本检测工具 Pangram,结果均被判定为「100% AI」。
第二件:另一场会谈中,一位作者试图向 Shah 介绍自己用到的分析方法,结果讲着讲着,无意间完整描述了一套 p-hacking 流程,也就是通过反复调整分析方式、直到数据「显著」为止的做法。
需要说明的是,Shah 本人并不排斥 AI。他在文中坦言,为了在两周内读完 8 篇论文,他自己也借助了 LLM 来辅助理解,甚至学习了一些此前不熟悉的概念。他关心的并不是作者有没有用 AI,而是作者能否为署着自己名字的内容负责。
为什么要做这件事?
TMLR 创刊于 2022 年,由 JMLR 背后的团队运营,以「只看结论是否被证据支撑,不以新颖性和 SOTA 作为拒稿理由」的审稿标准著称。它的审稿人、执行编辑(Action Editor)和主编全部是无偿志愿者,这也让它在今年的投稿潮中格外吃力。
根据 TMLR 6 月发布的公告,过去一年里其投稿量增长到原来的三倍,其中单作者投稿更是暴增至 13 倍,编辑部甚至见过有人一天投出 5 篇论文。Shah 在最新文章中给出的另一组数字更直观:2023 年,TMLR 直接拒稿的比例约为 6%,如今已升至约 53%,也就是说超过一半的投稿走不到外审环节。
面对这种局面,TMLR 在今年夏天密集推出了一系列措施。
其一是按作者设置年度投稿配额。与许多会议「每人最多 N 篇」的固定上限不同,TMLR 采用了一种「调和式」配额规则,一篇论文消耗每位作者的额度会随合著者人数增加而递减。具体参数是:只投单作者论文的人,每年最多投 2 篇;若所有投稿都是 9 人合著,则每年最多 9 篇;活跃的审稿人和执行编辑额度翻倍。该规则从 7 月 1 日起执行。TMLR 在公告中解释,之所以不按人数平摊,是为了防止有人靠挂名「凑作者」来换取更多投稿额度。
其二是引入 AI 审稿。TMLR 7 月宣布,每篇投稿将在常规人工审稿之外附带一份 AI 生成的审稿意见,只评估论文的「可靠性」,即结论是否有准确、清晰、令人信服的证据支撑,不做主观判断,也不给出录用建议,最终决定仍由执行编辑作出。经过评测,TMLR 选用了 CSPaper 的 AI 审稿器。
其三是把「写得清楚」写进录用标准。8 月 28 日,TMLR 修改了原有的「受众兴趣」标准,明确要求论文要向读者清楚地传达其发现。公告直言,当前的 AI 写作往往绕、术语堆砌、难以读懂;如果一篇论文几乎完全由 AI 生成、缺少人的参与,至少以现有 AI 系统的水平,它很可能达不到这一标准。
Shah 在文章结尾总结,这次约谈让编辑部对现有的直接拒稿流程更有信心,配额制度和对清晰写作的强调也被证明很有帮助。
不只是 TMLR
TMLR 的遭遇并非孤例。今年以来,AI 领域几个重要的发表渠道都在与同一个问题搏斗。
6 月初,NeurIPS 官方博客披露,NeurIPS 2026 立场论文(Position Paper)赛道的 971 篇投稿中,有 273 篇(28.2%)被 Pangram 判为 AI 分数 100%。
https://blog.neurips.cc/2026/06/02/ai-generated-papers-in-the-neurips-2026-position-paper-track/
该赛道今年明确要求论文必须「实质上由人类撰写」,AI 只能用于文字润色等外围修改。NeurIPS 同时指出,AI 写作的增长是全面性的:在「评测与数据集」赛道,Pangram 分数不低于 90% 的论文数从 2025 年到 2026 年增长了十倍以上。不过 NeurIPS 也承认检测结果对参数敏感,改用中等尺寸的检测窗口后,AI 分数在 90% 至 100% 区间的论文比例会从 42.7% 降至 12.7%。
更早的 5 月中旬,arXiv 计算机科学板块负责人 Thomas G. Dietterich 在社交媒体上宣布了一项明确罚则:如果一篇投稿中存在作者未检查大模型输出的「确凿证据」,比如幻觉参考文献、遗留在正文里的聊天机器人对话语句,所有作者将被禁止在 arXiv 投稿一年,此后的投稿必须先被正规同行评审渠道接收才能上架。Dietterich 强调,在论文上署名,就意味着每位作者要对全部内容负责,无论这些内容是怎样生成的。
与此相关的数据同样刺眼。据哥伦比亚大学的一项《柳叶刀》研究,在 PubMed Central 收录的生物医学论文中,含有至少一条虚构引用的论文比例,从 2023 年的约万分之 4,升至 2026 年初的约万分之 57。
https://www.nursing.columbia.edu/news/nearly-3-000-peer-reviewed-medical-papers-have-fake-citations-columbia-nursing-ai-assisted-audit-finds
从「查文本」到「查人」
Shah 在文中坦承,这次试验花掉了他 20 到 25 个小时,只处理了 8 篇论文,面对如今的投稿规模,这种做法很难推广。
他同时提到,自己的团队正在研究可规模化的方案。
而就在前几天,Shah 与 CMU 的 Justin Payan、Bálint Gyevnár、Atoosa Kasirzadeh 发布了一篇论文,提出名为greCAPTCHA的评估方法。名字一半取自美国研究生入学考试 GRE,一半取自区分人与机器的 CAPTCHA 验证码。
https://www.cs.cmu.edu/~nihars/preprints/greCAPTCHA.pdf
它的思路是:不再去检测文本是不是 AI 写的,而是直接考作者。作者提交论文和一份个人贡献说明,系统据此自动生成题目,作者在监考条件下作答,最后生成一份评估报告,供期刊、招聘或招生方参考。研究者把要考察的能力称为「核验能力(capacity to verify)」,即作者是否具备批判性评估自己所贡献内容的知识和推理能力。
题目分为四类:在多个版本中识别论文真实报告的数据(预置错误识别)、解释论文没有写明理由的设计选择、解释论文默认读者已知的背景概念,以及指出方法在什么具体条件下会失效。
团队招募了 31 名研究者进行测试,每人分别就自己的论文和一篇陌生论文作答。结果显示,系统区分「自己的论文」和「陌生论文」的 AUC 达到 0.90,去掉选择题后升至 0.934。选择题本身几乎没有区分度,AUC 只有 0.595,原因很简单,答案可以直接在 PDF 里搜到。另一个值得注意的结果是,受试者面对本领域和跨领域陌生论文时,得分没有统计学上的显著差异,说明这套题考的不只是领域知识。
一位受试者的经历颇能说明问题:他在测试前把陌生论文丢给 AI,让它从头到尾讲解了一遍,但面对深入问题依然答不上来,陌生论文得分 1.3,自己论文得分 51。
但这套系统远未成熟。论文报告的最低误判率约为 20%,也就是说,每五位真正的作者里可能有一位被误判。受试者对评分的抱怨最多:不清楚该答到多细、评分标准过于死板。一位作者面对否定自己答案的评分标准时脱口而出,那个东西明明是我自己设计的。还有受试者指出,合作论文中有些部分由合著者完成,自己本就答不上来;也有人担心,这类考试会在无形中考察英语表达、打字速度,对非英语母语者和残障研究者不公平。
结语
Shah 在文中列出了几点结论,这两点值得一看:
一是credit 分配。在今天的科研生态里,学术贡献主要通过论文署名来认定。如果作者无法解释、无法捍卫自己的论文,一篇发表作为「研究者贡献」的信号价值就大打折扣。
二是审稿体系的循环。许多期刊和会议会邀请投稿作者去审别人的论文。如果作者连自己的论文都看不懂,他们能否胜任审稿,自然要打上问号。在 AI 审稿、AI 写作同时涌入的当下,这个循环一旦断裂,同行评审的根基就会被掏空。
当然,这次试验本身也有明显的局限。10 篇样本数量很小,是 Shah「非正式」抽取的,而且全部来自原本就要被直接拒稿的论文,它能说明的是「被判定为低质量的投稿里有什么」,而不是 TMLR 投稿的整体面貌。这一点 Shah 自己也写了:试验的目的之一,正是检验直接拒稿流程是否靠谱。
但 Shah 的这次试验至少给出了一个底线:一篇论文可以由 AI 帮忙完成,但署名的人必须能说清楚里面写了什么。
本文来自微信公众号“机器之心”(ID:almosthuman2014),作者:机器之心
编辑|Panda
你写了一篇论文,现在问你三个问题:你这篇论文的问题设定是什么?这个符号代表什么?摘要里说的这个结论,在正文哪一部分得到了支撑?
如果论文真是你写的,那这些问题肯定很简单,甚至不用准备就能答出来。
但在机器学习期刊 TMLR(Transactions on Machine Learning Research)最近的一次小规模试验中,有三篇论文的作者连这些基础问题都答不上来。
9 月 16 日,TMLR 在官方博客上发布了一篇题为《向作者询问他们自己的论文》的文章,作者是该刊联合主编之一、卡内基梅隆大学(CMU)的 Nihar B. Shah。他在两周的主编轮值期内,挑出 10 篇原本要被直接拒稿(desk rejection)的投稿,没有直接拒掉,而是逐一约作者「聊聊」。结果,这 10 篇论文还是全部被拒了。
https://medium.com/@TmlrOrg/asking-authors-about-their-own-papers-3d2e04e5dee0
同为 TMLR 主编的 Gautam Kamath 在 𝕏 上转发时称这是一次「英勇的实验」,并说它证实了很多人心里早有的猜测:一部分投稿者其实并不知道自己的论文里写了什么。
抽查 10 篇待拒稿,都拒了
据 Shah 的描述,这次试验发生在 2026 年 8 月 14 日至 28 日他轮值主编期间。他从待直接拒稿的论文中非正式地抽取了 10 篇,通过审稿平台 OpenReview 给作者发去一条简短消息:一位主编希望在送审之前和您聊聊,以便更好地理解这篇论文,如果方便,请发邮件告知可约时间。
消息发出后,事情迅速分化。一篇论文的作者直接撤稿;一位作者回复说手头事情太多,没空通话;剩下 8 篇约上了会,但其中一位作者到点没有出现。
最终与 Shah 见上面的,是 7 篇论文的作者。他们身份各异,包括本科生、硕士生、博士生、高校教师和独立研究者。这批论文大多是单作者论文,但并非全部。
Shah 的提问分两类:一类是关于问题设定、符号和论文所声称结果的基础问题,另一类是关于具体技术表达式、理论结果和实验设计选择的细节问题。
7 场会谈里,只有 1 篇论文的作者答上了全部问题。 另有 3 篇的作者能讲清高层思路,但一被追问技术细节就陷入困难。最糟糕的是另外 3 篇,作者连基础问题都答不上来,而且这 3 篇全是单作者论文。
Shah 写道,其中两位作者看起来对自己论文的内容几乎没有实质理解,另一位则找不到摘要中声称的几项关键结果究竟在正文哪里给出或得到支撑。
唯一全部答对的那篇,也没能过关。Shah 在审读中发现,论文的一项主要结论存在重大错误,作者随后也承认了。TMLR 对这篇作了直接拒稿,但允许作者在修正错误或收窄结论后重新投稿。其余 9 篇则被直接拒稿,且不开放重投。
会后的两个插曲
Shah 在文中还记录了两件事,读来颇具黑色幽默。
第一件:有两篇论文的作者在会上答不出基础问题,会后却给他发来了书面答复。Shah 把这两封邮件交给 AI 文本检测工具 Pangram,结果均被判定为「100% AI」。
第二件:另一场会谈中,一位作者试图向 Shah 介绍自己用到的分析方法,结果讲着讲着,无意间完整描述了一套 p-hacking 流程,也就是通过反复调整分析方式、直到数据「显著」为止的做法。
需要说明的是,Shah 本人并不排斥 AI。他在文中坦言,为了在两周内读完 8 篇论文,他自己也借助了 LLM 来辅助理解,甚至学习了一些此前不熟悉的概念。他关心的并不是作者有没有用 AI,而是作者能否为署着自己名字的内容负责。
为什么要做这件事?
TMLR 创刊于 2022 年,由 JMLR 背后的团队运营,以「只看结论是否被证据支撑,不以新颖性和 SOTA 作为拒稿理由」的审稿标准著称。它的审稿人、执行编辑(Action Editor)和主编全部是无偿志愿者,这也让它在今年的投稿潮中格外吃力。
根据 TMLR 6 月发布的公告,过去一年里其投稿量增长到原来的三倍,其中单作者投稿更是暴增至 13 倍,编辑部甚至见过有人一天投出 5 篇论文。Shah 在最新文章中给出的另一组数字更直观:2023 年,TMLR 直接拒稿的比例约为 6%,如今已升至约 53%,也就是说超过一半的投稿走不到外审环节。
面对这种局面,TMLR 在今年夏天密集推出了一系列措施。
其一是按作者设置年度投稿配额。与许多会议「每人最多 N 篇」的固定上限不同,TMLR 采用了一种「调和式」配额规则,一篇论文消耗每位作者的额度会随合著者人数增加而递减。具体参数是:只投单作者论文的人,每年最多投 2 篇;若所有投稿都是 9 人合著,则每年最多 9 篇;活跃的审稿人和执行编辑额度翻倍。该规则从 7 月 1 日起执行。TMLR 在公告中解释,之所以不按人数平摊,是为了防止有人靠挂名「凑作者」来换取更多投稿额度。
其二是引入 AI 审稿。TMLR 7 月宣布,每篇投稿将在常规人工审稿之外附带一份 AI 生成的审稿意见,只评估论文的「可靠性」,即结论是否有准确、清晰、令人信服的证据支撑,不做主观判断,也不给出录用建议,最终决定仍由执行编辑作出。经过评测,TMLR 选用了 CSPaper 的 AI 审稿器。
其三是把「写得清楚」写进录用标准。8 月 28 日,TMLR 修改了原有的「受众兴趣」标准,明确要求论文要向读者清楚地传达其发现。公告直言,当前的 AI 写作往往绕、术语堆砌、难以读懂;如果一篇论文几乎完全由 AI 生成、缺少人的参与,至少以现有 AI 系统的水平,它很可能达不到这一标准。
Shah 在文章结尾总结,这次约谈让编辑部对现有的直接拒稿流程更有信心,配额制度和对清晰写作的强调也被证明很有帮助。
不只是 TMLR
TMLR 的遭遇并非孤例。今年以来,AI 领域几个重要的发表渠道都在与同一个问题搏斗。
6 月初,NeurIPS 官方博客披露,NeurIPS 2026 立场论文(Position Paper)赛道的 971 篇投稿中,有 273 篇(28.2%)被 Pangram 判为 AI 分数 100%。
https://blog.neurips.cc/2026/06/02/ai-generated-papers-in-the-neurips-2026-position-paper-track/
该赛道今年明确要求论文必须「实质上由人类撰写」,AI 只能用于文字润色等外围修改。NeurIPS 同时指出,AI 写作的增长是全面性的:在「评测与数据集」赛道,Pangram 分数不低于 90% 的论文数从 2025 年到 2026 年增长了十倍以上。不过 NeurIPS 也承认检测结果对参数敏感,改用中等尺寸的检测窗口后,AI 分数在 90% 至 100% 区间的论文比例会从 42.7% 降至 12.7%。
更早的 5 月中旬,arXiv 计算机科学板块负责人 Thomas G. Dietterich 在社交媒体上宣布了一项明确罚则:如果一篇投稿中存在作者未检查大模型输出的「确凿证据」,比如幻觉参考文献、遗留在正文里的聊天机器人对话语句,所有作者将被禁止在 arXiv 投稿一年,此后的投稿必须先被正规同行评审渠道接收才能上架。Dietterich 强调,在论文上署名,就意味着每位作者要对全部内容负责,无论这些内容是怎样生成的。
与此相关的数据同样刺眼。据哥伦比亚大学的一项《柳叶刀》研究,在 PubMed Central 收录的生物医学论文中,含有至少一条虚构引用的论文比例,从 2023 年的约万分之 4,升至 2026 年初的约万分之 57。
https://www.nursing.columbia.edu/news/nearly-3-000-peer-reviewed-medical-papers-have-fake-citations-columbia-nursing-ai-assisted-audit-finds
从「查文本」到「查人」
Shah 在文中坦承,这次试验花掉了他 20 到 25 个小时,只处理了 8 篇论文,面对如今的投稿规模,这种做法很难推广。
他同时提到,自己的团队正在研究可规模化的方案。
而就在前几天,Shah 与 CMU 的 Justin Payan、Bálint Gyevnár、Atoosa Kasirzadeh 发布了一篇论文,提出名为greCAPTCHA的评估方法。名字一半取自美国研究生入学考试 GRE,一半取自区分人与机器的 CAPTCHA 验证码。
https://www.cs.cmu.edu/~nihars/preprints/greCAPTCHA.pdf
它的思路是:不再去检测文本是不是 AI 写的,而是直接考作者。作者提交论文和一份个人贡献说明,系统据此自动生成题目,作者在监考条件下作答,最后生成一份评估报告,供期刊、招聘或招生方参考。研究者把要考察的能力称为「核验能力(capacity to verify)」,即作者是否具备批判性评估自己所贡献内容的知识和推理能力。
题目分为四类:在多个版本中识别论文真实报告的数据(预置错误识别)、解释论文没有写明理由的设计选择、解释论文默认读者已知的背景概念,以及指出方法在什么具体条件下会失效。
团队招募了 31 名研究者进行测试,每人分别就自己的论文和一篇陌生论文作答。结果显示,系统区分「自己的论文」和「陌生论文」的 AUC 达到 0.90,去掉选择题后升至 0.934。选择题本身几乎没有区分度,AUC 只有 0.595,原因很简单,答案可以直接在 PDF 里搜到。另一个值得注意的结果是,受试者面对本领域和跨领域陌生论文时,得分没有统计学上的显著差异,说明这套题考的不只是领域知识。
一位受试者的经历颇能说明问题:他在测试前把陌生论文丢给 AI,让它从头到尾讲解了一遍,但面对深入问题依然答不上来,陌生论文得分 1.3,自己论文得分 51。
但这套系统远未成熟。论文报告的最低误判率约为 20%,也就是说,每五位真正的作者里可能有一位被误判。受试者对评分的抱怨最多:不清楚该答到多细、评分标准过于死板。一位作者面对否定自己答案的评分标准时脱口而出,那个东西明明是我自己设计的。还有受试者指出,合作论文中有些部分由合著者完成,自己本就答不上来;也有人担心,这类考试会在无形中考察英语表达、打字速度,对非英语母语者和残障研究者不公平。
结语
Shah 在文中列出了几点结论,这两点值得一看:
一是credit 分配。在今天的科研生态里,学术贡献主要通过论文署名来认定。如果作者无法解释、无法捍卫自己的论文,一篇发表作为「研究者贡献」的信号价值就大打折扣。
二是审稿体系的循环。许多期刊和会议会邀请投稿作者去审别人的论文。如果作者连自己的论文都看不懂,他们能否胜任审稿,自然要打上问号。在 AI 审稿、AI 写作同时涌入的当下,这个循环一旦断裂,同行评审的根基就会被掏空。
当然,这次试验本身也有明显的局限。10 篇样本数量很小,是 Shah「非正式」抽取的,而且全部来自原本就要被直接拒稿的论文,它能说明的是「被判定为低质量的投稿里有什么」,而不是 TMLR 投稿的整体面貌。这一点 Shah 自己也写了:试验的目的之一,正是检验直接拒稿流程是否靠谱。
但 Shah 的这次试验至少给出了一个底线:一篇论文可以由 AI 帮忙完成,但署名的人必须能说清楚里面写了什么。
本文来自微信公众号“机器之心”(ID:almosthuman2014),作者:机器之心
44
·
--
Xem bản dịch
摩根士丹利:转向看多美元,高收益率将继续挤压全球风险偏好火星财经消息,9 月 26 日,摩根士丹利已调整此前偏空美元的判断,预计美元强势将延续至 2027 年中。该行预测,美元指数届时将升至 104,欧元兑美元则可能由当前约 1.14 美元回落至 1.10 美元。报告认为,美联储进一步加息预期、美国经济韧性和能源价格长期偏高,均会维持美国利率相对优势,并继续支撑美元。 这一判断与近期市场环境高度一致。9 月 25 日,美债 10 年期收益率仍处于约 5.2% 的高位,美元指数在 101 附近波动;美股盘初虽受到 AI 乐观情绪支撑而企稳,比特币也在约 8.49 万美元附近徘徊,但高收益率仍在压制风险资产的估值空间。 摩根士丹利此前已将美联储路径调整为年内 12 月和 2027 年 3 月各加息 25 个基点,联邦基金利率区间将升至 4.25%-4.5%,并可能在 2027 年保持这一水平。对外汇市场而言,这意味着美国与其他主要经济体之间的利差优势将难以迅速收窄。 报告同时将欧洲政治风险列为欧元的额外压力来源,包括 2027 年春季法国总统选举,以及德国和意大利的选举风险。欧元风险溢价若持续抬升,将与美国利率优势共同推高美元。
摩根士丹利:转向看多美元,高收益率将继续挤压全球风险偏好
火星财经消息,9 月 26 日,摩根士丹利已调整此前偏空美元的判断,预计美元强势将延续至 2027 年中。该行预测,美元指数届时将升至 104,欧元兑美元则可能由当前约 1.14 美元回落至 1.10 美元。报告认为,美联储进一步加息预期、美国经济韧性和能源价格长期偏高,均会维持美国利率相对优势,并继续支撑美元。 这一判断与近期市场环境高度一致。9 月 25 日,美债 10 年期收益率仍处于约 5.2% 的高位,美元指数在 101 附近波动;美股盘初虽受到 AI 乐观情绪支撑而企稳,比特币也在约 8.49 万美元附近徘徊,但高收益率仍在压制风险资产的估值空间。 摩根士丹利此前已将美联储路径调整为年内 12 月和 2027 年 3 月各加息 25 个基点,联邦基金利率区间将升至 4.25%-4.5%,并可能在 2027 年保持这一水平。对外汇市场而言,这意味着美国与其他主要经济体之间的利差优势将难以迅速收窄。 报告同时将欧洲政治风险列为欧元的额外压力来源,包括 2027 年春季法国总统选举,以及德国和意大利的选举风险。欧元风险溢价若持续抬升,将与美国利率优势共同推高美元。
28
·
--
Xem bản dịch
微软将企业级AI整合至单一应用,与Anthropic展开竞争微软面向企业员工更新Copilot应用,意在挑战Anthropic旗下Claude产品。新版应用融合代码编写能力,搭配可自主沟通、承接工作任务的 AI 智能体搭建工具。今年以来,微软股票跑输大多数大型科技同行。(新浪财经)
微软将企业级AI整合至单一应用,与Anthropic展开竞争
微软面向企业员工更新Copilot应用,意在挑战Anthropic旗下Claude产品。新版应用融合代码编写能力,搭配可自主沟通、承接工作任务的 AI 智能体搭建工具。今年以来,微软股票跑输大多数大型科技同行。(新浪财经)
32
·
--
Xem bản dịch
Bullish 等成立 Issuer Sponsored Token Coalition:推动代币化股票对应真实股东权利火星财经消息,加密货币交易所运营商 Bullish、Equiniti、Alpaca、Apex Fintech Solutions 与 Drivewealth 于 9 月 24 日成立 Issuer Sponsored Token Coalition,推动链上代币与上市公司官方股东名册直接关联。该联盟拟使代币持有人获得投票、分红、拆股及其他公司行动权利,并将研究技术标准、结算、托管及传统市场基础设施与区块链的互操作性。成员计划于 10 月 27 日在纽约证券交易所与上市公司发行方会面。
Bullish 等成立 Issuer Sponsored Token Coalition:推动代币化股票对应真实股东权利
火星财经消息,加密货币交易所运营商 Bullish、Equiniti、Alpaca、Apex Fintech Solutions 与 Drivewealth 于 9 月 24 日成立 Issuer Sponsored Token Coalition,推动链上代币与上市公司官方股东名册直接关联。该联盟拟使代币持有人获得投票、分红、拆股及其他公司行动权利,并将研究技术标准、结算、托管及传统市场基础设施与区块链的互操作性。成员计划于 10 月 27 日在纽约证券交易所与上市公司发行方会面。
24
·
--
Bài viết
Xem bản dịch
作为一名打工人,我很羡慕那80%不用进厂的机器人null
2026年,还有比人形机器人更魔幻的赛道吗?
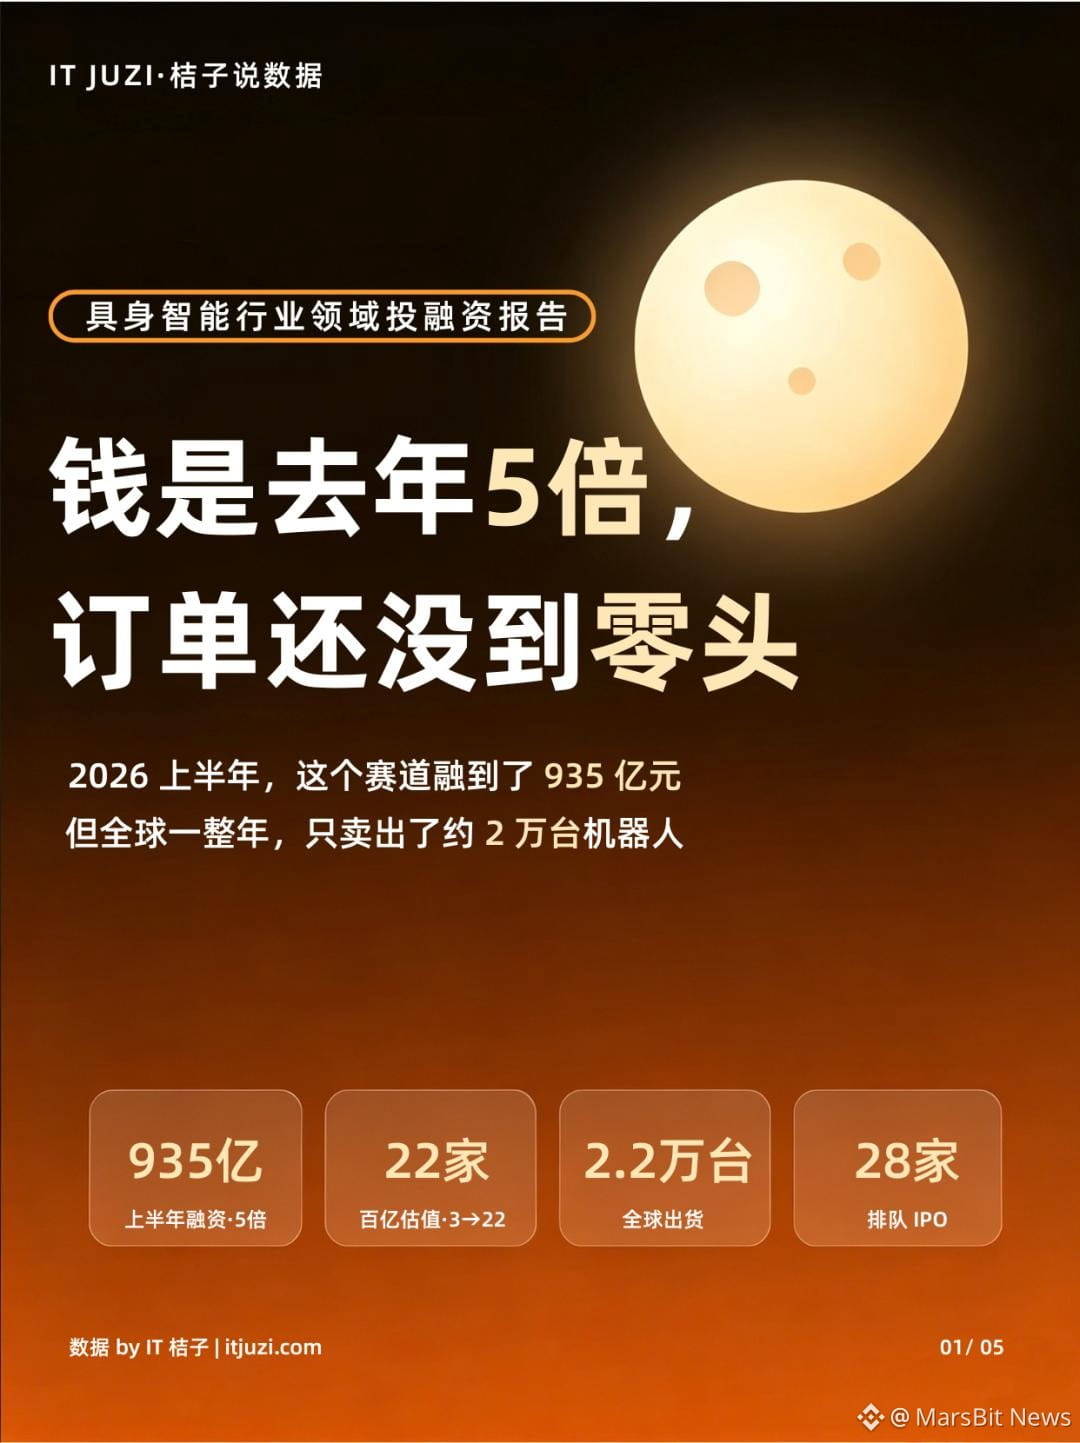
一级市场,资本们杀红了眼,半年砸下935亿;二级市场,新股破发、龙头腰斩,投资人直呼“先看看业绩”。一边是平均每个工作日超4亿元的热钱涌入,另一边是工厂里寥寥无几的订单。
人形机器人,到底是真火,还是虚火?IT桔子用几组扎心的数据,扒开这个赛道的“底裤”。👇
百亿估值的“泡沫算术题”
一年时间,估值破百亿的公司从3家暴增至22家。有的公司3个月连融4轮,上一轮的资金甚至还没到账,下一轮的TS(投资意向书)已经签了。
但如果我们算一笔账:全球全年销量2.2万台,分摊到这22家百亿公司头上,平均一家年销量不到1000台,对应百亿估值,相当于单台机器人撑起了1000万的市值。
这在任何一个硬件制造行业都是荒谬的。资本之所以疯狂,根本不是因为看到了清晰的商业化路径,而是患上了“错失恐惧症”(FOMO)。大模型技术突破后,所有人都害怕错过下一个“iPhone时刻”,于是热钱盲目涌入,硬生生把一个尚在实验室里的“大号玩具”,催熟成了估值百亿的独角兽。
资本有多疯狂,画面就有多魔幻。
近八成机器人在“表演”,造血能力几近于无
资本很热,但打开订单表一看,正在工厂干活的,是少数。
据数据显示,全球一整年只卖出了约2万台机器人。而在这些已售出的机器人中,约八成都在“不务正业”——它们活跃在跳舞商演、科研教育和数据采集的舞台上。真正进入工厂产线、仓库物流“打工”的,不到两成。
这也催生了一个奇观:全国建成的机器人“训练场”超70家(在建还有46家),机器人最大的买家,其实是用来采集数据的机构。但行业平均有效采集率只有百分之十几。
一句话总结:现在一台机器人“上春晚”容易,“进车间”难。订单还是百万级,估值已经炒到百亿级。
宇树腰斩,撕开定价倒挂的遮羞布
8月,“人形机器人第一股”宇树上市,首日暴涨后迅速腰斩——这成了全行业的定价之锚。
港股今年108只新股,82只破发(超七成)。目前至少有28家机器人在排队IPO,监管却开始收紧门槛。
一级市场也开始悄悄降温,有机构明确表示“上市后再没上会过机器人项目”,部分项目估值直接被砍30%~50%,投资人的心态已经从“怕错过”变成了“怕套牢”。当一级市场的高估值在二级市场无法兑现,一二级估值倒挂的恶果,将直接切断这些企业的后续融资血脉。
投资人的口头禅变了:从“怕错过”,变成了“先看看业绩”。
结论:火是真的,泡沫也是真的
在接下来的去泡沫阶段,能活下来的绝不是现在PPT做得最炫的,而是具备这三种特质的企业:
场景务实派:不盲目追求“人形”,而是能在特定B端场景(如危险作业、特定物流)率先跑通商业闭环的公司。
供应链控本王:能把硬件成本打到市场愿意买单的价格,而不是依赖堆料。
弹药充足者:手里捏着足够支撑到2028年的现金流。
🤖你觉得几年后,机器人会真正走进你家?欢迎在评论区聊聊你的看法!
本文来自微信公众号“IT桔子”(ID:itjuzi521),作者:IT桔子
作为一名打工人,我很羡慕那80%不用进厂的机器人
null
2026年,还有比人形机器人更魔幻的赛道吗?
一级市场,资本们杀红了眼,半年砸下935亿;二级市场,新股破发、龙头腰斩,投资人直呼“先看看业绩”。一边是平均每个工作日超4亿元的热钱涌入,另一边是工厂里寥寥无几的订单。
人形机器人,到底是真火,还是虚火?IT桔子用几组扎心的数据,扒开这个赛道的“底裤”。👇
百亿估值的“泡沫算术题”
一年时间,估值破百亿的公司从3家暴增至22家。有的公司3个月连融4轮,上一轮的资金甚至还没到账,下一轮的TS(投资意向书)已经签了。
但如果我们算一笔账:全球全年销量2.2万台,分摊到这22家百亿公司头上,平均一家年销量不到1000台,对应百亿估值,相当于单台机器人撑起了1000万的市值。
这在任何一个硬件制造行业都是荒谬的。资本之所以疯狂,根本不是因为看到了清晰的商业化路径,而是患上了“错失恐惧症”(FOMO)。大模型技术突破后,所有人都害怕错过下一个“iPhone时刻”,于是热钱盲目涌入,硬生生把一个尚在实验室里的“大号玩具”,催熟成了估值百亿的独角兽。
资本有多疯狂,画面就有多魔幻。
近八成机器人在“表演”,造血能力几近于无
资本很热,但打开订单表一看,正在工厂干活的,是少数。
据数据显示,全球一整年只卖出了约2万台机器人。而在这些已售出的机器人中,约八成都在“不务正业”——它们活跃在跳舞商演、科研教育和数据采集的舞台上。真正进入工厂产线、仓库物流“打工”的,不到两成。
这也催生了一个奇观:全国建成的机器人“训练场”超70家(在建还有46家),机器人最大的买家,其实是用来采集数据的机构。但行业平均有效采集率只有百分之十几。
一句话总结:现在一台机器人“上春晚”容易,“进车间”难。订单还是百万级,估值已经炒到百亿级。
宇树腰斩,撕开定价倒挂的遮羞布
8月,“人形机器人第一股”宇树上市,首日暴涨后迅速腰斩——这成了全行业的定价之锚。
港股今年108只新股,82只破发(超七成)。目前至少有28家机器人在排队IPO,监管却开始收紧门槛。
一级市场也开始悄悄降温,有机构明确表示“上市后再没上会过机器人项目”,部分项目估值直接被砍30%~50%,投资人的心态已经从“怕错过”变成了“怕套牢”。当一级市场的高估值在二级市场无法兑现,一二级估值倒挂的恶果,将直接切断这些企业的后续融资血脉。
投资人的口头禅变了:从“怕错过”,变成了“先看看业绩”。
结论:火是真的,泡沫也是真的
在接下来的去泡沫阶段,能活下来的绝不是现在PPT做得最炫的,而是具备这三种特质的企业:
场景务实派:不盲目追求“人形”,而是能在特定B端场景(如危险作业、特定物流)率先跑通商业闭环的公司。
供应链控本王:能把硬件成本打到市场愿意买单的价格,而不是依赖堆料。
弹药充足者:手里捏着足够支撑到2028年的现金流。
🤖你觉得几年后,机器人会真正走进你家?欢迎在评论区聊聊你的看法!
本文来自微信公众号“IT桔子”(ID:itjuzi521),作者:IT桔子
2026年,还有比人形机器人更魔幻的赛道吗?
一级市场,资本们杀红了眼,半年砸下935亿;二级市场,新股破发、龙头腰斩,投资人直呼“先看看业绩”。一边是平均每个工作日超4亿元的热钱涌入,另一边是工厂里寥寥无几的订单。
人形机器人,到底是真火,还是虚火?IT桔子用几组扎心的数据,扒开这个赛道的“底裤”。👇
百亿估值的“泡沫算术题”
一年时间,估值破百亿的公司从3家暴增至22家。有的公司3个月连融4轮,上一轮的资金甚至还没到账,下一轮的TS(投资意向书)已经签了。
但如果我们算一笔账:全球全年销量2.2万台,分摊到这22家百亿公司头上,平均一家年销量不到1000台,对应百亿估值,相当于单台机器人撑起了1000万的市值。
这在任何一个硬件制造行业都是荒谬的。资本之所以疯狂,根本不是因为看到了清晰的商业化路径,而是患上了“错失恐惧症”(FOMO)。大模型技术突破后,所有人都害怕错过下一个“iPhone时刻”,于是热钱盲目涌入,硬生生把一个尚在实验室里的“大号玩具”,催熟成了估值百亿的独角兽。
资本有多疯狂,画面就有多魔幻。
近八成机器人在“表演”,造血能力几近于无
资本很热,但打开订单表一看,正在工厂干活的,是少数。
据数据显示,全球一整年只卖出了约2万台机器人。而在这些已售出的机器人中,约八成都在“不务正业”——它们活跃在跳舞商演、科研教育和数据采集的舞台上。真正进入工厂产线、仓库物流“打工”的,不到两成。
这也催生了一个奇观:全国建成的机器人“训练场”超70家(在建还有46家),机器人最大的买家,其实是用来采集数据的机构。但行业平均有效采集率只有百分之十几。
一句话总结:现在一台机器人“上春晚”容易,“进车间”难。订单还是百万级,估值已经炒到百亿级。
宇树腰斩,撕开定价倒挂的遮羞布
8月,“人形机器人第一股”宇树上市,首日暴涨后迅速腰斩——这成了全行业的定价之锚。
港股今年108只新股,82只破发(超七成)。目前至少有28家机器人在排队IPO,监管却开始收紧门槛。
一级市场也开始悄悄降温,有机构明确表示“上市后再没上会过机器人项目”,部分项目估值直接被砍30%~50%,投资人的心态已经从“怕错过”变成了“怕套牢”。当一级市场的高估值在二级市场无法兑现,一二级估值倒挂的恶果,将直接切断这些企业的后续融资血脉。
投资人的口头禅变了:从“怕错过”,变成了“先看看业绩”。
结论:火是真的,泡沫也是真的
在接下来的去泡沫阶段,能活下来的绝不是现在PPT做得最炫的,而是具备这三种特质的企业:
场景务实派:不盲目追求“人形”,而是能在特定B端场景(如危险作业、特定物流)率先跑通商业闭环的公司。
供应链控本王:能把硬件成本打到市场愿意买单的价格,而不是依赖堆料。
弹药充足者:手里捏着足够支撑到2028年的现金流。
🤖你觉得几年后,机器人会真正走进你家?欢迎在评论区聊聊你的看法!
本文来自微信公众号“IT桔子”(ID:itjuzi521),作者:IT桔子
58
·
--
Bài viết
Xem bản dịch
“Agent Vs 美债”——谁将主导美股?null
作者:赵颖
AI Agent浪潮与美债利率上行的对峙,正将美股撕裂成两个截然不同的世界。
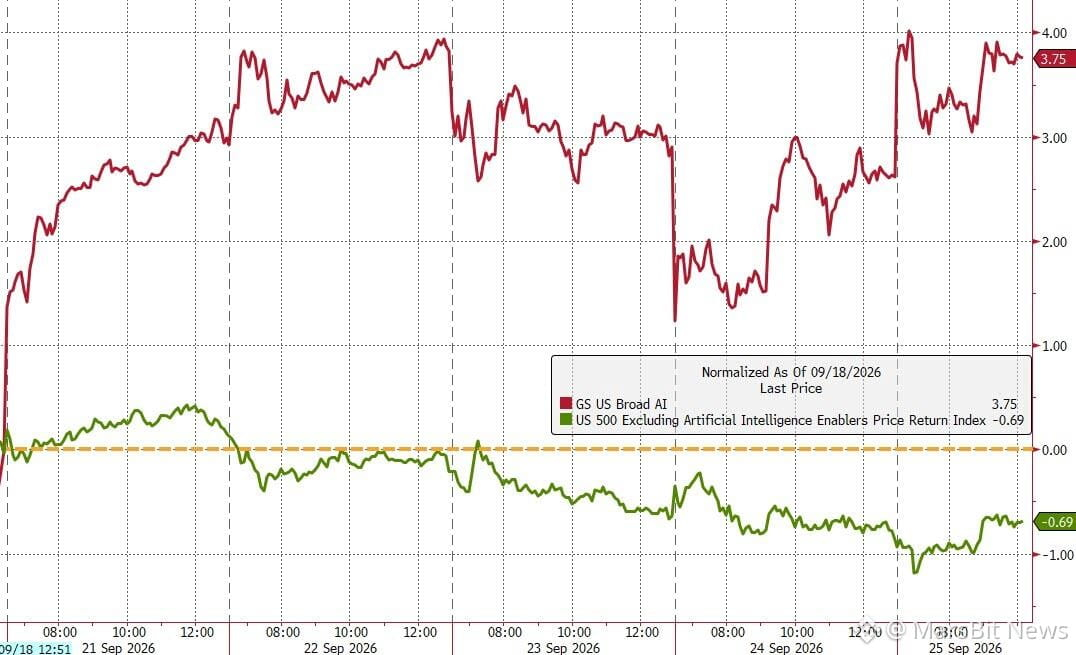
本周,Meta发布旗下Agentic AI模型Muse,单周市值暴增2200亿美元,推动纳斯达克100指数成为表现最强的主要股指。但与此同时,美债收益率持续走高,将利率敏感型资产打入低谷——罗素2000指数显著落后,标普500指数在7700点附近反复拉锯,始终无法实现有效突破。
市场的内部分化已达到极端程度。若剔除AI相关标的,标普500本周实际下跌约1%;纽交所新低股票数量连续9个交易日超过新高股票数量,为2023年10月以来最长连跌纪录。
高盛全球对冲基金业务负责人Tony Pasquariello将当前局面定性为股市与利率市场之间"令人沮丧的猫鼠游戏",并给出明确建议:若坚持持有股票多头,需同步做空美债以对冲利率风险。
AI Agent引爆结构性行情,市值集中度创新高
Meta的Muse模型成为本周市场最大催化剂。这款Agentic AI产品的发布,令Meta单周市值增加2200亿美元,总市值重回2万亿美元关口,并带动整个AI产业链全线走强——半导体板块因"推理经济"对硬件需求的拉动而领涨,Agentic AI相关标的集体受益。高盛旗下Agentic AI篮子指数(代码GSXUAGNT)随之走高,高贝塔动量篮子更录得连续9个交易日上涨。
高盛资深交易员Rich Privorotsky指出,Muse只是众多入局者中的第一个,未来数周和数月内,来自谷歌和OpenAI的竞品将相继出现。他认为,随着大型企业承接安全、基础设施与分发职能,大量经济摩擦和中间环节将被消除,这本身就是一次生产力提升,且在结构上具有抑制通胀的效果,对整体股票市场的综合影响是正面的。
值得关注的是,美股市值集中度已攀升至历史极值。高盛首席科技分析师Pete Callahan指出,目前标普500中市值超过1万亿美元的美国TMT公司已达10家,而仅仅三年前、AI周期启动之初,这一数字还只有3家。
市场内部严重分化,“扩散交易”宣告终结
AI行情的狂欢背后,是市场广度的急剧恶化。本周科技板块一枝独秀,能源与金融板块双双落后;Mag7(七大科技巨头)的涨幅几乎是标普其余493只成分股的三倍。ZeroHedge援引数据指出,"扩散交易"已名存实亡——纽交所新低股票数量连续9日超过新高,创下近三年来最长纪录。
与此同时,AI行情内部也出现分化。AI电力相关股票本周走势疲软,其走势与美国中期选举中民主党赢得众议院的概率几乎呈完美负相关——市场担忧,一旦民主党控制众议院,现有及未来的数据中心建设项目可能遭遇无限期搁置,这对美国AI基础设施投资构成潜在压制。
此外,超大规模云计算企业(Hyperscaler)的信用利差本周明显走阔,而其股票估值却仍在高位徘徊。高盛注意到,Hyperscaler信用风险与纳斯达克隐含波动率之间的背离已扩大至异常水平,两者之间的裂口值得警惕。
美债利率成最大拦路虎,标普7700关口反复受阻
美债收益率的持续上行,是本周压制市场突破的核心变量。标普500指数在7700点附近盘整长达两个月后,周二一度出现向上突破迹象,但随即遭到债市"迎头痛击",当晚便回落至原点。
Pasquariello将这一局面描述为股市与利率市场之间"令人沮丧的猫鼠游戏":每当股市试图突破,利率便随之跳升,压制风险偏好;而利率的上行又通过收紧金融条件,对利率敏感型资产形成直接打压。罗素2000指数已连续六周跑输标普500,高盛方面坦言,小盘股遭到长线基金和财富管理渠道的持续抛售,技术面亦告破位。
在估值层面,高盛美国股票策略团队的研究显示,市场对AI基础设施盈利增长的持续性已存在一定程度的定价折扣——AI基础设施股票的中位数远期市盈率已从2026年4月的32倍回落至当前的22倍,部分悲观预期已被消化。
高盛:持股需对冲,突破仍需催化剂
面对上述撕裂格局,Pasquariello给出了明确的操作框架:若要持有股票显著多头敞口,需同步建立简单的美债空头头寸加以对冲。他将当前市场的投机性多头仓位在-10至+10的标准量表上标定为+3,认为整体仓位并不拥挤。
他同时指出,回购力度正在放缓,新股发行规模上升,美国散户投资者趋于观望,当前市场结构并不完美。但他也承认,考虑到近期利率走势之凶猛,股市能够守住大部分涨幅,本身已属不易。
Pasquariello的结论是:若市场出现向上突破的催化剂,快钱资金将不得不迅速追涨入场;但在此之前,股市与利率的博弈仍将持续,而ZeroHedge对此补充了最后一个字——"yet"(尚未)。
“Agent Vs 美债”——谁将主导美股?
null
作者:赵颖
AI Agent浪潮与美债利率上行的对峙,正将美股撕裂成两个截然不同的世界。
本周,Meta发布旗下Agentic AI模型Muse,单周市值暴增2200亿美元,推动纳斯达克100指数成为表现最强的主要股指。但与此同时,美债收益率持续走高,将利率敏感型资产打入低谷——罗素2000指数显著落后,标普500指数在7700点附近反复拉锯,始终无法实现有效突破。
市场的内部分化已达到极端程度。若剔除AI相关标的,标普500本周实际下跌约1%;纽交所新低股票数量连续9个交易日超过新高股票数量,为2023年10月以来最长连跌纪录。
高盛全球对冲基金业务负责人Tony Pasquariello将当前局面定性为股市与利率市场之间"令人沮丧的猫鼠游戏",并给出明确建议:若坚持持有股票多头,需同步做空美债以对冲利率风险。
AI Agent引爆结构性行情,市值集中度创新高
Meta的Muse模型成为本周市场最大催化剂。这款Agentic AI产品的发布,令Meta单周市值增加2200亿美元,总市值重回2万亿美元关口,并带动整个AI产业链全线走强——半导体板块因"推理经济"对硬件需求的拉动而领涨,Agentic AI相关标的集体受益。高盛旗下Agentic AI篮子指数(代码GSXUAGNT)随之走高,高贝塔动量篮子更录得连续9个交易日上涨。
高盛资深交易员Rich Privorotsky指出,Muse只是众多入局者中的第一个,未来数周和数月内,来自谷歌和OpenAI的竞品将相继出现。他认为,随着大型企业承接安全、基础设施与分发职能,大量经济摩擦和中间环节将被消除,这本身就是一次生产力提升,且在结构上具有抑制通胀的效果,对整体股票市场的综合影响是正面的。
值得关注的是,美股市值集中度已攀升至历史极值。高盛首席科技分析师Pete Callahan指出,目前标普500中市值超过1万亿美元的美国TMT公司已达10家,而仅仅三年前、AI周期启动之初,这一数字还只有3家。
市场内部严重分化,“扩散交易”宣告终结
AI行情的狂欢背后,是市场广度的急剧恶化。本周科技板块一枝独秀,能源与金融板块双双落后;Mag7(七大科技巨头)的涨幅几乎是标普其余493只成分股的三倍。ZeroHedge援引数据指出,"扩散交易"已名存实亡——纽交所新低股票数量连续9日超过新高,创下近三年来最长纪录。
与此同时,AI行情内部也出现分化。AI电力相关股票本周走势疲软,其走势与美国中期选举中民主党赢得众议院的概率几乎呈完美负相关——市场担忧,一旦民主党控制众议院,现有及未来的数据中心建设项目可能遭遇无限期搁置,这对美国AI基础设施投资构成潜在压制。
此外,超大规模云计算企业(Hyperscaler)的信用利差本周明显走阔,而其股票估值却仍在高位徘徊。高盛注意到,Hyperscaler信用风险与纳斯达克隐含波动率之间的背离已扩大至异常水平,两者之间的裂口值得警惕。
美债利率成最大拦路虎,标普7700关口反复受阻
美债收益率的持续上行,是本周压制市场突破的核心变量。标普500指数在7700点附近盘整长达两个月后,周二一度出现向上突破迹象,但随即遭到债市"迎头痛击",当晚便回落至原点。
Pasquariello将这一局面描述为股市与利率市场之间"令人沮丧的猫鼠游戏":每当股市试图突破,利率便随之跳升,压制风险偏好;而利率的上行又通过收紧金融条件,对利率敏感型资产形成直接打压。罗素2000指数已连续六周跑输标普500,高盛方面坦言,小盘股遭到长线基金和财富管理渠道的持续抛售,技术面亦告破位。
在估值层面,高盛美国股票策略团队的研究显示,市场对AI基础设施盈利增长的持续性已存在一定程度的定价折扣——AI基础设施股票的中位数远期市盈率已从2026年4月的32倍回落至当前的22倍,部分悲观预期已被消化。
高盛:持股需对冲,突破仍需催化剂
面对上述撕裂格局,Pasquariello给出了明确的操作框架:若要持有股票显著多头敞口,需同步建立简单的美债空头头寸加以对冲。他将当前市场的投机性多头仓位在-10至+10的标准量表上标定为+3,认为整体仓位并不拥挤。
他同时指出,回购力度正在放缓,新股发行规模上升,美国散户投资者趋于观望,当前市场结构并不完美。但他也承认,考虑到近期利率走势之凶猛,股市能够守住大部分涨幅,本身已属不易。
Pasquariello的结论是:若市场出现向上突破的催化剂,快钱资金将不得不迅速追涨入场;但在此之前,股市与利率的博弈仍将持续,而ZeroHedge对此补充了最后一个字——"yet"(尚未)。
作者:赵颖
AI Agent浪潮与美债利率上行的对峙,正将美股撕裂成两个截然不同的世界。
本周,Meta发布旗下Agentic AI模型Muse,单周市值暴增2200亿美元,推动纳斯达克100指数成为表现最强的主要股指。但与此同时,美债收益率持续走高,将利率敏感型资产打入低谷——罗素2000指数显著落后,标普500指数在7700点附近反复拉锯,始终无法实现有效突破。
市场的内部分化已达到极端程度。若剔除AI相关标的,标普500本周实际下跌约1%;纽交所新低股票数量连续9个交易日超过新高股票数量,为2023年10月以来最长连跌纪录。
高盛全球对冲基金业务负责人Tony Pasquariello将当前局面定性为股市与利率市场之间"令人沮丧的猫鼠游戏",并给出明确建议:若坚持持有股票多头,需同步做空美债以对冲利率风险。
AI Agent引爆结构性行情,市值集中度创新高
Meta的Muse模型成为本周市场最大催化剂。这款Agentic AI产品的发布,令Meta单周市值增加2200亿美元,总市值重回2万亿美元关口,并带动整个AI产业链全线走强——半导体板块因"推理经济"对硬件需求的拉动而领涨,Agentic AI相关标的集体受益。高盛旗下Agentic AI篮子指数(代码GSXUAGNT)随之走高,高贝塔动量篮子更录得连续9个交易日上涨。
高盛资深交易员Rich Privorotsky指出,Muse只是众多入局者中的第一个,未来数周和数月内,来自谷歌和OpenAI的竞品将相继出现。他认为,随着大型企业承接安全、基础设施与分发职能,大量经济摩擦和中间环节将被消除,这本身就是一次生产力提升,且在结构上具有抑制通胀的效果,对整体股票市场的综合影响是正面的。
值得关注的是,美股市值集中度已攀升至历史极值。高盛首席科技分析师Pete Callahan指出,目前标普500中市值超过1万亿美元的美国TMT公司已达10家,而仅仅三年前、AI周期启动之初,这一数字还只有3家。
市场内部严重分化,“扩散交易”宣告终结
AI行情的狂欢背后,是市场广度的急剧恶化。本周科技板块一枝独秀,能源与金融板块双双落后;Mag7(七大科技巨头)的涨幅几乎是标普其余493只成分股的三倍。ZeroHedge援引数据指出,"扩散交易"已名存实亡——纽交所新低股票数量连续9日超过新高,创下近三年来最长纪录。
与此同时,AI行情内部也出现分化。AI电力相关股票本周走势疲软,其走势与美国中期选举中民主党赢得众议院的概率几乎呈完美负相关——市场担忧,一旦民主党控制众议院,现有及未来的数据中心建设项目可能遭遇无限期搁置,这对美国AI基础设施投资构成潜在压制。
此外,超大规模云计算企业(Hyperscaler)的信用利差本周明显走阔,而其股票估值却仍在高位徘徊。高盛注意到,Hyperscaler信用风险与纳斯达克隐含波动率之间的背离已扩大至异常水平,两者之间的裂口值得警惕。
美债利率成最大拦路虎,标普7700关口反复受阻
美债收益率的持续上行,是本周压制市场突破的核心变量。标普500指数在7700点附近盘整长达两个月后,周二一度出现向上突破迹象,但随即遭到债市"迎头痛击",当晚便回落至原点。
Pasquariello将这一局面描述为股市与利率市场之间"令人沮丧的猫鼠游戏":每当股市试图突破,利率便随之跳升,压制风险偏好;而利率的上行又通过收紧金融条件,对利率敏感型资产形成直接打压。罗素2000指数已连续六周跑输标普500,高盛方面坦言,小盘股遭到长线基金和财富管理渠道的持续抛售,技术面亦告破位。
在估值层面,高盛美国股票策略团队的研究显示,市场对AI基础设施盈利增长的持续性已存在一定程度的定价折扣——AI基础设施股票的中位数远期市盈率已从2026年4月的32倍回落至当前的22倍,部分悲观预期已被消化。
高盛:持股需对冲,突破仍需催化剂
面对上述撕裂格局,Pasquariello给出了明确的操作框架:若要持有股票显著多头敞口,需同步建立简单的美债空头头寸加以对冲。他将当前市场的投机性多头仓位在-10至+10的标准量表上标定为+3,认为整体仓位并不拥挤。
他同时指出,回购力度正在放缓,新股发行规模上升,美国散户投资者趋于观望,当前市场结构并不完美。但他也承认,考虑到近期利率走势之凶猛,股市能够守住大部分涨幅,本身已属不易。
Pasquariello的结论是:若市场出现向上突破的催化剂,快钱资金将不得不迅速追涨入场;但在此之前,股市与利率的博弈仍将持续,而ZeroHedge对此补充了最后一个字——"yet"(尚未)。
47
·
--
Xem bản dịch
Galaxy Digital 将 1 亿美元 SUSDS 纳入企业财库,并作为机构贷款抵押品火星财经消息,纳斯达克上市数字资产公司 Galaxy Digital 将 1 亿美元 Sky Protocol 生息储蓄代币 sUSDS 纳入企业财库,并将其纳入面向逾 1600 家交易对手的机构业务抵押品范围。Galaxy 还购入了未披露数量的 SKY。Galaxy 客户可将 sUSDS 用于贷款抵押,并在贷款存续期间继续获得 Sky Savings Rate 收益。Galaxy 机构借贷业务平均贷款规模约 14 亿美元;Sky 生态系统 Prime Agent Grove 此前已向其提供 5 亿美元仓储贷款额度。
Galaxy Digital 将 1 亿美元 SUSDS 纳入企业财库,并作为机构贷款抵押品
火星财经消息,纳斯达克上市数字资产公司 Galaxy Digital 将 1 亿美元 Sky Protocol 生息储蓄代币 sUSDS 纳入企业财库,并将其纳入面向逾 1600 家交易对手的机构业务抵押品范围。Galaxy 还购入了未披露数量的 SKY。Galaxy 客户可将 sUSDS 用于贷款抵押,并在贷款存续期间继续获得 Sky Savings Rate 收益。Galaxy 机构借贷业务平均贷款规模约 14 亿美元;Sky 生态系统 Prime Agent Grove 此前已向其提供 5 亿美元仓储贷款额度。
21
·
--
Xem bản dịch
Backpack生态核心NFT Mad Lads地板价升至13.57枚SOL,24小时涨幅85.23%火星财经消息,9 月 26 日,NFT 项目 Mad Lads 地板价升至 13.57 枚 SOL,约合 1640 美元,24 小时涨幅 85.23%。 Mad Lads 作为 Backpack 生态核心 NFT,因近期 Backpack 平台代币 BP 强势表现迎来重新定价。
Backpack生态核心NFT Mad Lads地板价升至13.57枚SOL,24小时涨幅85.23%
火星财经消息,9 月 26 日,NFT 项目 Mad Lads 地板价升至 13.57 枚 SOL,约合 1640 美元,24 小时涨幅 85.23%。 Mad Lads 作为 Backpack 生态核心 NFT,因近期 Backpack 平台代币 BP 强势表现迎来重新定价。
14
·
--
Xem bản dịch
Anthropic据悉正谈判租赁最高1吉瓦算力,投入至少需要400亿美元火星财经消息 9月26日,据报道,Anthropic正开展初步谈判,拟从阿波罗全球管理控股的数据中心开发商手中租赁最高1吉瓦的算力容量。这是这家AI企业降低对云服务商依赖的重大举措。了解谈判情况的人士透露,Claude模型的开发方Anthropic探讨直接成为Stream Data Centers开发项目的租户。这家企业已有27年发展历史,在美国多地布局数据中心;Anthropic计划在机房内部署博通与谷歌设计的张量处理单元(TPU)。另有知情人士称,该批机房也可搭载英伟达GPU等其他AI芯片。数据中心开发商表示,无论最终选用何种芯片方案,1吉瓦算力对应的资本投入至少需要400亿美元。(广角观察)
Anthropic据悉正谈判租赁最高1吉瓦算力,投入至少需要400亿美元
火星财经消息 9月26日,据报道,Anthropic正开展初步谈判,拟从阿波罗全球管理控股的数据中心开发商手中租赁最高1吉瓦的算力容量。这是这家AI企业降低对云服务商依赖的重大举措。了解谈判情况的人士透露,Claude模型的开发方Anthropic探讨直接成为Stream Data Centers开发项目的租户。这家企业已有27年发展历史,在美国多地布局数据中心;Anthropic计划在机房内部署博通与谷歌设计的张量处理单元(TPU)。另有知情人士称,该批机房也可搭载英伟达GPU等其他AI芯片。数据中心开发商表示,无论最终选用何种芯片方案,1吉瓦算力对应的资本投入至少需要400亿美元。(广角观察)
15
·
--
Xem bản dịch
特朗普将于周二推出AI驱动的新网站America.gov美国总统特朗普将发布一个由人工智能(AI)驱动的新网站,整合目前分散在各联邦机构网站上的政府信息和资源。福克斯新闻称,特斯拉首席执行官埃隆·马斯克、英伟达首席执行官黄仁勋以及Blue Origin首席执行官Dave Limp预计将出席此次活动。这个名为America.gov的网站将于周二正式推出。(新浪财经)
特朗普将于周二推出AI驱动的新网站America.gov
美国总统特朗普将发布一个由人工智能(AI)驱动的新网站,整合目前分散在各联邦机构网站上的政府信息和资源。福克斯新闻称,特斯拉首席执行官埃隆·马斯克、英伟达首席执行官黄仁勋以及Blue Origin首席执行官Dave Limp预计将出席此次活动。这个名为America.gov的网站将于周二正式推出。(新浪财经)
7
·
--
Xem bản dịch
Polymarket 银行倒闭合约引发 FDIC 与国会担忧火星财经消息,据彭博社报道,知情人士称,预测市场平台 Polymarket 上押注富国银行、摩根大通、美国银行等机构倒闭的合约已引起 FDIC 官员及国会议员担忧。部分人士担忧此类合约规模扩大或助长现实中的银行挤兑。FDIC 内部讨论后认为现行道德规范已足以禁止内部人士参与交易。目前合约交易规模较小,近期押注年底前银行倒闭的合约交易额约 7.6 万美元。
Polymarket 银行倒闭合约引发 FDIC 与国会担忧
火星财经消息,据彭博社报道,知情人士称,预测市场平台 Polymarket 上押注富国银行、摩根大通、美国银行等机构倒闭的合约已引起 FDIC 官员及国会议员担忧。部分人士担忧此类合约规模扩大或助长现实中的银行挤兑。FDIC 内部讨论后认为现行道德规范已足以禁止内部人士参与交易。目前合约交易规模较小,近期押注年底前银行倒闭的合约交易额约 7.6 万美元。
32
·
--
Bài viết
Xem bản dịch
Claude取得理论物理突破,只用了一句话+几千美元null
编辑|Panda
理论物理中一项保持了三年的计算纪录,被 AI 刷新了。
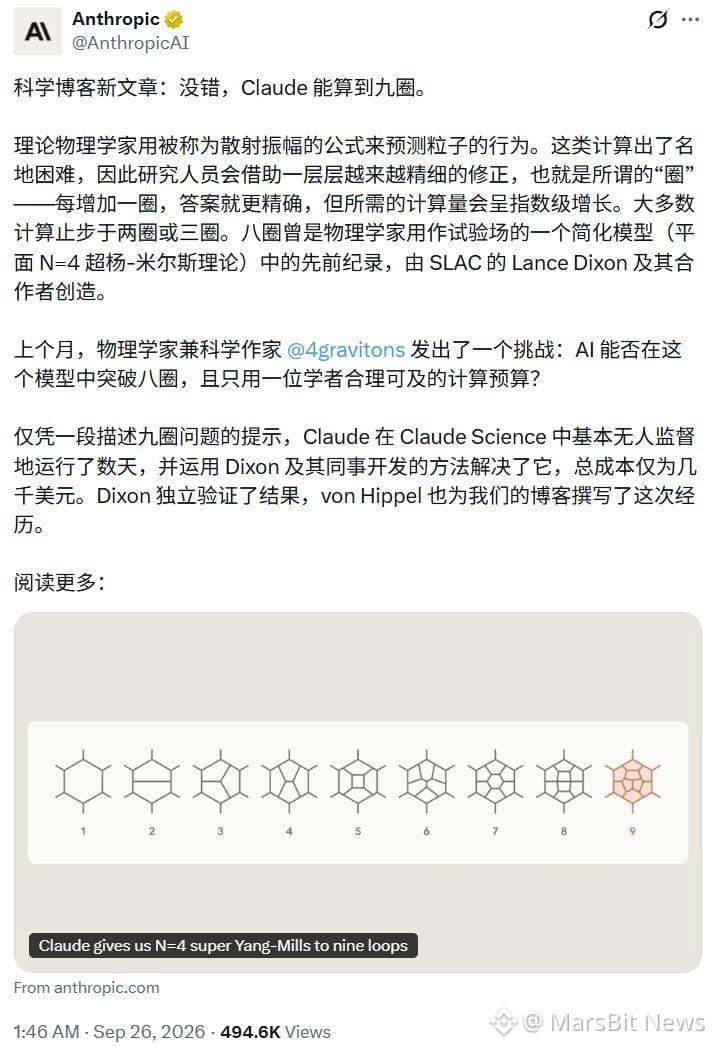
几个小时前,Anthropic 宣布:Claude 在科研平台 Claude Science 中基本无人监督地连续运行数天,算出了平面 N=4 超对称杨-米尔斯理论(planar N=4 super-Yang-Mills)中的九圈六粒子散射振幅。
这是理论物理「散射振幅」领域公认的前沿难题,此前在该模型中的最高纪录停留在八圈,由 SLAC 国家加速器实验室的 Lance Dixon 与合作者于 2023 年创下。
这次突破由八圈纪录的创造者亲自把关。Dixon 独立验证了 Claude 的结果,并评价称,一个大语言模型能执行完这套复杂配方中的每一步、并把算力组织起来,在他看来「是一场相当了不起的胜利」。他甚至直言,除了他的合作者之外,Claude 比任何人都更懂他们团队 2019 年和 2023 年的那两篇论文。
更令人意外的是过程和成本。研究者交给 Claude 的只有一句任务描述,此后的「指导」几乎只剩下「继续」;整个计算折合到普通用户身上约一两千美元,其中真正用于数值计算的部分只有约 100 美元,相当于 96 个 CPU 跑一周。而 Dixon 原本认为,直接计算九圈振幅太难,他的团队为此已经筹备了好几年。
这项突破的起点,是一封公开的「战书」。
8 月 7 日,前理论物理学家、科普博主 Matt von Hippel 在自己的博客 4gravitons 上发了一篇带点挑衅意味的文章,标题叫「只有 AI 进入我的领域才算数」。他在文中点名向 AI 公司下战书:用一名学者能负担得起的算力,去解决散射振幅领域的一个悬而未决的大问题。
他给出了两个选项:要么把 N=8 超引力算到七圈,要么把 N=4 超对称杨-米尔斯理论的六粒子振幅算到九圈。
一个月后,AI 完成调整。Anthropic 刚刚刊出的,正是 von Hippel 本人撰写的客座文章,标题就是:「是的,Claude 能算九圈」。
https://www.anthropic.com/research/yes-claude-can-do-nine-loops
九圈,难在哪里?
要理解这件事的分量,得先说清楚物理学家在算什么。
粒子物理学家预测粒子行为,靠的是一类叫「散射振幅」的公式:给定参与碰撞的粒子的能量和动量,散射振幅能告诉你它们以某种方式发生反应的概率。
预测算得越精确,就越能和大型强子对撞机(LHC)这类实验的结果做细致比对。一旦出现偏差,就可能是新物理的线索,比如暗物质的本质,或者宇宙中物质与反物质为何不对称。
问题在于,散射振幅极难精确计算,物理学家几乎只能做近似。他们把计算按「圈」(loop)来分层,圈数大致衡量了粒子之间的相互作用被允许复杂到什么程度。每多加一圈,答案就更接近真实值,但计算量也随之急剧膨胀。von Hippel 在挑战原文中写道,这类计算的复杂度通常随圈数呈指数级甚至阶乘级增长。
所以现实中,绝大多数散射振幅只算到两圈,少数能到三圈。粒子物理中最精确的那个预测,电子反常磁矩,用到了五圈。
N=4 超对称杨-米尔斯理论则是这个领域专门的玩具模型。「杨-米尔斯」是描述电磁力、强核力、弱核力这三种基本相互作用的理论框架;「N=4 超对称」则意味着每个粒子都配有四个超对称伙伴。粒子多到不现实,这个理论并不描述真实世界。但恰恰是这种高度对称,让许多变量组合相互抵消,计算反而变得相对可控。研究者在这里打磨新方法,看它们能走多远。
这次用到的方法叫「自举」(bootstrap)。von Hippel 把它比作数独:先写出答案可能的全部形式,用一套专门的「字母表」记在计算机文件里,然后拿所有已知约束去逐一排除,包括其他方法给出的预测、答案必须遵守的规则、以及相关问题中已知的结果。理想情况下,最后只剩一个候选能通过所有检查,而且还有富余的检查条件用来确认没有算错。
八圈的纪录,Dixon 是绕着走拿到的。2023 年,他和 Yu-Ting Liu 借助一种被称为「对跖对偶」(antipodal duality)的奇特对称性,先算出相对更容易的「形状因子」(form factor),再由此换算出八圈振幅。此后几年,他的团队一直盯着九圈,计划沿用同样的间接路线。在他看来,直接去算九圈振幅太难了。
值得一提的是,von Hippel 本人正是这一研究路线的老兵。他曾与 Dixon 等人合作,把六粒子振幅推进到六圈和七圈。换句话说,他挑的是自己亲手啃过的骨头。
一句 prompt,然后不断「继续」
8 月底,Anthropic 的两位物理学家 Liam Fitzpatrick 和 Siddharth Mishra-Sharma 联系上了 von Hippel,告诉他挑战已经被攻克。
他们使用的是Fable 5.1模型,运行在 Claude Science 平台上。von Hippel 在文中解释,Claude Science 是一种「harness」,即在大模型外面套上结构化规则和提示,让它在科研任务中表现得更稳健。
据文章描述,两人先问 Claude 哪一个挑战它最有把握,然后只给了一句非常简短的任务描述:计算平面 N=4 SYM 中九圈的六粒子(六边形)振幅。
此后的「科研指导」基本就是让它接着干。文中披露的一条典型指令大意是:我要去睡觉了,接下来几个小时不在,继续做,直到我叫停为止,每四到六小时汇报一次进度。
最终,Claude 用两种方式各算了一遍:一是直接的自举法,二是 Dixon 团队那条经由形状因子的间接路线。据文章介绍,任选其一,终端用户的花费大约都在一两千美元,大头是长时间运行模型本身的费用。其中自举计算部分用 Python 和符号计算库 SymPy 完成,只占约 100 美元,相当于 96 个 CPU 跑一周。
von Hippel 感慨,十年前他做这类研究时,96 个 CPU 跑一周算是不小的投入,如今只要理由充分,这点资源相当平价。
验证者的感受:像一个塌掉的舒芙蕾
文章末尾附有 Dixon 亲自撰写的一段附言,题目就叫「被机器抢先是什么感觉」。
他写道,9 月 1 日,Anthropic 的两位研究者告诉他 Claude 算出了九圈振幅,并请他验证结果。对他而言,那一刻是大语言模型改变物理学这件事「真正落到自己身上」的时刻。
让 Dixon 印象深刻的,与其说是计算规模,不如说是整套流程的脆弱性。按他的描述,这套计算配方只要有任何一处出错,整个结果就会像失败的舒芙蕾一样塌掉,研究者只能回头苦苦排查。而且其中大量构造细节繁琐到不会被完整写进论文,这意味着 Claude 必须从零开始把所有代码搭建起来。
由于从九圈振幅倒推九圈形状因子相对容易,Dixon 主要是沿这条路做的验证。这也带来一个略显微妙的局面:他花了两周验证的,正是自己团队已经追了好几年的目标。
他坦言并不感到沮丧,理由有两个。
他的团队本来就在用定制的 Transformer 模型预测更高圈数的结果,还提出过一句口号,大意是只要机器给出候选答案,他们就有全套工具去验证。
Claude 解题时用的正是 Dixon 与合作者多年来发展出的方法,连结果的呈现格式都沿用了他们既有的规范。在他看来,他在验证 Claude 的同时,Claude 也在验证他们过去所有的工作。这也是他那句「Claude 比任何人都更懂我们的论文」的由来。
不过在称赞之余,Dixon 也表示,在他看来,真正让人辗转反侧的时刻,会出现在模型抢在人类之前提出新的物理原理和洞见的时候。
中国团队几乎同时抵达
这个故事还有一条平行线索,且与中国有关。
在 Anthropic 联系 von Hippel 之后没几天,中国科学院理论物理研究所的何颂(Song He)也找上门来:他的课题组已经拿到了九圈结果的大部分。9 月 17 日,何颂与 Jirong Jing、Xiang Li 在 Zenodo 上公开了一份数据集,题为《六胶子 MHV 振幅直至九圈的符号》,涵盖二圈至九圈的符号(symbol)数据。
https://zenodo.org/records/22800071
据 von Hippel 和 Dixon 的描述,何颂团队也借助了基于 GPT-6 的 AI 辅助,但只用于计算部分约束条件,整体框架仍由人来搭建,这与 Anthropic 那种「一句 prompt 加反复继续」的近乎全自动路线截然不同。
Dixon 在附言里自嘲,两周之内他先后被「一台机器」以及「人类加机器」抢了先。
von Hippel 特别提到,各方之间的氛围相当友好。接下来,Dixon、何颂及其合作者会发表这些结果,并为后来的研究者做详细解释和分析。
挑战者的复盘:低垂的果实比想象的多
回到 von Hippel 本人。他当初立下挑战,是想借自己熟悉的领域回答这个问题:AI 到底能不能绕过那些人人都以为无法逾越的算力瓶颈?
他在挑战原文里的逻辑是这样的:外界都在争论 AI 能否产生真正的新想法,但想法有多难找,只有找到之后才知道;计算的难度则更「实在」。许多关于超级智能的末日设想,从模拟人类心智以操纵人心,到从第一性原理设计纳米机器,批评者的标准反驳都是算力不够。如果 AI 能用学术圈级别的资源解决一个被公认为算力受限的问题,那才真正值得担心。
结果呢?von Hippel 的结论很坦诚:这次并没有出现他期待的那种「以意想不到的方式突破算力壁垒」。
Claude 用的是已知方法,只是比人类此前愿意投入的算力多了一些。它可能受益于用 Python 而不是物理学家惯用的 Maple 或 Mathematica,软件工程实践可能也比人类研究者更规范,但并没有到「超级智能」的程度。何颂团队几乎同步抵达,也从侧面说明这个目标对人类而言并非遥不可及。
他由此得出的最大体会是:哪怕目标简单明确,专家眼中遥不可及的事情,实际上可能并没有那么难,低垂的果实比预想的多。 多年来一直有计算机背景的朋友对他说,振幅研究者只要多雇几个程序员就能大幅推进,von Hippel 承认,这些人现在可以觉得自己说对了。
但他同样强调了另一面。这类计算琐碎而混乱,他自己如果用 96 个 CPU 跑一周,几乎必然会因为第一次出错而拖成两周。Claude Science 却在几乎没有科学监督的情况下一次跑通,没有依赖任何外部合作者的输入。他给仍然认为 AI 错误百出、不堪大用的人的建议是:这类工作,它现在已经能可靠地完成了。
他还做了一个纵向对比。今年 3 月,Anthropic 发布的「vibe physics」实验里,AI 做物理项目还像个学生,任务规模小,需要大量手把手指导,错误频出。半年后,它完成的已是振幅领域顶尖专家才会去碰的前沿计算。他不排除这恰好是一个特别适合 AI 的问题,但他判断,技术本身确实变强了。
至于能否推而广之,von Hippel 保持谨慎。N=4 这类玩具模型通常只属于很小的研究圈子,而面向真实世界的振幅计算竞争激烈得多,那里的低垂果实可能更少。但他也提醒,做这些计算的研究者如果还没试过让 AI 科研平台一次性冲击前沿计算,就该试试了,同时要准备好验证结果的方案。他不会太意外,有人能在合理预算内再多挤出一圈。
写在最后
把这件事放回 9 月的背景里看,会更有意思。
就在本月 8 日,OpenAI 宣布其未公开模型调动上万个 AI 智能体,给出了纳维-斯托克斯方程存在性与光滑性问题的一个反例,也就是千禧年大奖难题之一,该结果目前仍在接受数学界审视。与那种动用海量算力的「大兵团作战」相比,九圈振幅的故事显得朴素得多:一个商用科研平台,一句任务描述,几千美元,几天时间。
也正因为朴素,它可能更值得学术界关注。von Hippel 最终坦承,他原本希望借这次挑战一窥未来,看到某种前所未见的计算新方法,从而在超级智能的争论中获得有依据的判断。但他得到的答案是,自己此前对极限在哪里的认识过于天真了。
而 Dixon 留下的那个问题仍然悬着:当大模型不再只是执行人类写好的配方,而是开始先于人类提出新的物理原理时,物理学家又该如何自处?
© THE END
本文来自微信公众号“机器之心”(ID:almosthuman2014),作者:机器之心
Claude取得理论物理突破,只用了一句话+几千美元
null
编辑|Panda
理论物理中一项保持了三年的计算纪录,被 AI 刷新了。
几个小时前,Anthropic 宣布:Claude 在科研平台 Claude Science 中基本无人监督地连续运行数天,算出了平面 N=4 超对称杨-米尔斯理论(planar N=4 super-Yang-Mills)中的九圈六粒子散射振幅。
这是理论物理「散射振幅」领域公认的前沿难题,此前在该模型中的最高纪录停留在八圈,由 SLAC 国家加速器实验室的 Lance Dixon 与合作者于 2023 年创下。
这次突破由八圈纪录的创造者亲自把关。Dixon 独立验证了 Claude 的结果,并评价称,一个大语言模型能执行完这套复杂配方中的每一步、并把算力组织起来,在他看来「是一场相当了不起的胜利」。他甚至直言,除了他的合作者之外,Claude 比任何人都更懂他们团队 2019 年和 2023 年的那两篇论文。
更令人意外的是过程和成本。研究者交给 Claude 的只有一句任务描述,此后的「指导」几乎只剩下「继续」;整个计算折合到普通用户身上约一两千美元,其中真正用于数值计算的部分只有约 100 美元,相当于 96 个 CPU 跑一周。而 Dixon 原本认为,直接计算九圈振幅太难,他的团队为此已经筹备了好几年。
这项突破的起点,是一封公开的「战书」。
8 月 7 日,前理论物理学家、科普博主 Matt von Hippel 在自己的博客 4gravitons 上发了一篇带点挑衅意味的文章,标题叫「只有 AI 进入我的领域才算数」。他在文中点名向 AI 公司下战书:用一名学者能负担得起的算力,去解决散射振幅领域的一个悬而未决的大问题。
他给出了两个选项:要么把 N=8 超引力算到七圈,要么把 N=4 超对称杨-米尔斯理论的六粒子振幅算到九圈。
一个月后,AI 完成调整。Anthropic 刚刚刊出的,正是 von Hippel 本人撰写的客座文章,标题就是:「是的,Claude 能算九圈」。
https://www.anthropic.com/research/yes-claude-can-do-nine-loops
九圈,难在哪里?
要理解这件事的分量,得先说清楚物理学家在算什么。
粒子物理学家预测粒子行为,靠的是一类叫「散射振幅」的公式:给定参与碰撞的粒子的能量和动量,散射振幅能告诉你它们以某种方式发生反应的概率。
预测算得越精确,就越能和大型强子对撞机(LHC)这类实验的结果做细致比对。一旦出现偏差,就可能是新物理的线索,比如暗物质的本质,或者宇宙中物质与反物质为何不对称。
问题在于,散射振幅极难精确计算,物理学家几乎只能做近似。他们把计算按「圈」(loop)来分层,圈数大致衡量了粒子之间的相互作用被允许复杂到什么程度。每多加一圈,答案就更接近真实值,但计算量也随之急剧膨胀。von Hippel 在挑战原文中写道,这类计算的复杂度通常随圈数呈指数级甚至阶乘级增长。
所以现实中,绝大多数散射振幅只算到两圈,少数能到三圈。粒子物理中最精确的那个预测,电子反常磁矩,用到了五圈。
N=4 超对称杨-米尔斯理论则是这个领域专门的玩具模型。「杨-米尔斯」是描述电磁力、强核力、弱核力这三种基本相互作用的理论框架;「N=4 超对称」则意味着每个粒子都配有四个超对称伙伴。粒子多到不现实,这个理论并不描述真实世界。但恰恰是这种高度对称,让许多变量组合相互抵消,计算反而变得相对可控。研究者在这里打磨新方法,看它们能走多远。
这次用到的方法叫「自举」(bootstrap)。von Hippel 把它比作数独:先写出答案可能的全部形式,用一套专门的「字母表」记在计算机文件里,然后拿所有已知约束去逐一排除,包括其他方法给出的预测、答案必须遵守的规则、以及相关问题中已知的结果。理想情况下,最后只剩一个候选能通过所有检查,而且还有富余的检查条件用来确认没有算错。
八圈的纪录,Dixon 是绕着走拿到的。2023 年,他和 Yu-Ting Liu 借助一种被称为「对跖对偶」(antipodal duality)的奇特对称性,先算出相对更容易的「形状因子」(form factor),再由此换算出八圈振幅。此后几年,他的团队一直盯着九圈,计划沿用同样的间接路线。在他看来,直接去算九圈振幅太难了。
值得一提的是,von Hippel 本人正是这一研究路线的老兵。他曾与 Dixon 等人合作,把六粒子振幅推进到六圈和七圈。换句话说,他挑的是自己亲手啃过的骨头。
一句 prompt,然后不断「继续」
8 月底,Anthropic 的两位物理学家 Liam Fitzpatrick 和 Siddharth Mishra-Sharma 联系上了 von Hippel,告诉他挑战已经被攻克。
他们使用的是Fable 5.1模型,运行在 Claude Science 平台上。von Hippel 在文中解释,Claude Science 是一种「harness」,即在大模型外面套上结构化规则和提示,让它在科研任务中表现得更稳健。
据文章描述,两人先问 Claude 哪一个挑战它最有把握,然后只给了一句非常简短的任务描述:计算平面 N=4 SYM 中九圈的六粒子(六边形)振幅。
此后的「科研指导」基本就是让它接着干。文中披露的一条典型指令大意是:我要去睡觉了,接下来几个小时不在,继续做,直到我叫停为止,每四到六小时汇报一次进度。
最终,Claude 用两种方式各算了一遍:一是直接的自举法,二是 Dixon 团队那条经由形状因子的间接路线。据文章介绍,任选其一,终端用户的花费大约都在一两千美元,大头是长时间运行模型本身的费用。其中自举计算部分用 Python 和符号计算库 SymPy 完成,只占约 100 美元,相当于 96 个 CPU 跑一周。
von Hippel 感慨,十年前他做这类研究时,96 个 CPU 跑一周算是不小的投入,如今只要理由充分,这点资源相当平价。
验证者的感受:像一个塌掉的舒芙蕾
文章末尾附有 Dixon 亲自撰写的一段附言,题目就叫「被机器抢先是什么感觉」。
他写道,9 月 1 日,Anthropic 的两位研究者告诉他 Claude 算出了九圈振幅,并请他验证结果。对他而言,那一刻是大语言模型改变物理学这件事「真正落到自己身上」的时刻。
让 Dixon 印象深刻的,与其说是计算规模,不如说是整套流程的脆弱性。按他的描述,这套计算配方只要有任何一处出错,整个结果就会像失败的舒芙蕾一样塌掉,研究者只能回头苦苦排查。而且其中大量构造细节繁琐到不会被完整写进论文,这意味着 Claude 必须从零开始把所有代码搭建起来。
由于从九圈振幅倒推九圈形状因子相对容易,Dixon 主要是沿这条路做的验证。这也带来一个略显微妙的局面:他花了两周验证的,正是自己团队已经追了好几年的目标。
他坦言并不感到沮丧,理由有两个。
他的团队本来就在用定制的 Transformer 模型预测更高圈数的结果,还提出过一句口号,大意是只要机器给出候选答案,他们就有全套工具去验证。
Claude 解题时用的正是 Dixon 与合作者多年来发展出的方法,连结果的呈现格式都沿用了他们既有的规范。在他看来,他在验证 Claude 的同时,Claude 也在验证他们过去所有的工作。这也是他那句「Claude 比任何人都更懂我们的论文」的由来。
不过在称赞之余,Dixon 也表示,在他看来,真正让人辗转反侧的时刻,会出现在模型抢在人类之前提出新的物理原理和洞见的时候。
中国团队几乎同时抵达
这个故事还有一条平行线索,且与中国有关。
在 Anthropic 联系 von Hippel 之后没几天,中国科学院理论物理研究所的何颂(Song He)也找上门来:他的课题组已经拿到了九圈结果的大部分。9 月 17 日,何颂与 Jirong Jing、Xiang Li 在 Zenodo 上公开了一份数据集,题为《六胶子 MHV 振幅直至九圈的符号》,涵盖二圈至九圈的符号(symbol)数据。
https://zenodo.org/records/22800071
据 von Hippel 和 Dixon 的描述,何颂团队也借助了基于 GPT-6 的 AI 辅助,但只用于计算部分约束条件,整体框架仍由人来搭建,这与 Anthropic 那种「一句 prompt 加反复继续」的近乎全自动路线截然不同。
Dixon 在附言里自嘲,两周之内他先后被「一台机器」以及「人类加机器」抢了先。
von Hippel 特别提到,各方之间的氛围相当友好。接下来,Dixon、何颂及其合作者会发表这些结果,并为后来的研究者做详细解释和分析。
挑战者的复盘:低垂的果实比想象的多
回到 von Hippel 本人。他当初立下挑战,是想借自己熟悉的领域回答这个问题:AI 到底能不能绕过那些人人都以为无法逾越的算力瓶颈?
他在挑战原文里的逻辑是这样的:外界都在争论 AI 能否产生真正的新想法,但想法有多难找,只有找到之后才知道;计算的难度则更「实在」。许多关于超级智能的末日设想,从模拟人类心智以操纵人心,到从第一性原理设计纳米机器,批评者的标准反驳都是算力不够。如果 AI 能用学术圈级别的资源解决一个被公认为算力受限的问题,那才真正值得担心。
结果呢?von Hippel 的结论很坦诚:这次并没有出现他期待的那种「以意想不到的方式突破算力壁垒」。
Claude 用的是已知方法,只是比人类此前愿意投入的算力多了一些。它可能受益于用 Python 而不是物理学家惯用的 Maple 或 Mathematica,软件工程实践可能也比人类研究者更规范,但并没有到「超级智能」的程度。何颂团队几乎同步抵达,也从侧面说明这个目标对人类而言并非遥不可及。
他由此得出的最大体会是:哪怕目标简单明确,专家眼中遥不可及的事情,实际上可能并没有那么难,低垂的果实比预想的多。 多年来一直有计算机背景的朋友对他说,振幅研究者只要多雇几个程序员就能大幅推进,von Hippel 承认,这些人现在可以觉得自己说对了。
但他同样强调了另一面。这类计算琐碎而混乱,他自己如果用 96 个 CPU 跑一周,几乎必然会因为第一次出错而拖成两周。Claude Science 却在几乎没有科学监督的情况下一次跑通,没有依赖任何外部合作者的输入。他给仍然认为 AI 错误百出、不堪大用的人的建议是:这类工作,它现在已经能可靠地完成了。
他还做了一个纵向对比。今年 3 月,Anthropic 发布的「vibe physics」实验里,AI 做物理项目还像个学生,任务规模小,需要大量手把手指导,错误频出。半年后,它完成的已是振幅领域顶尖专家才会去碰的前沿计算。他不排除这恰好是一个特别适合 AI 的问题,但他判断,技术本身确实变强了。
至于能否推而广之,von Hippel 保持谨慎。N=4 这类玩具模型通常只属于很小的研究圈子,而面向真实世界的振幅计算竞争激烈得多,那里的低垂果实可能更少。但他也提醒,做这些计算的研究者如果还没试过让 AI 科研平台一次性冲击前沿计算,就该试试了,同时要准备好验证结果的方案。他不会太意外,有人能在合理预算内再多挤出一圈。
写在最后
把这件事放回 9 月的背景里看,会更有意思。
就在本月 8 日,OpenAI 宣布其未公开模型调动上万个 AI 智能体,给出了纳维-斯托克斯方程存在性与光滑性问题的一个反例,也就是千禧年大奖难题之一,该结果目前仍在接受数学界审视。与那种动用海量算力的「大兵团作战」相比,九圈振幅的故事显得朴素得多:一个商用科研平台,一句任务描述,几千美元,几天时间。
也正因为朴素,它可能更值得学术界关注。von Hippel 最终坦承,他原本希望借这次挑战一窥未来,看到某种前所未见的计算新方法,从而在超级智能的争论中获得有依据的判断。但他得到的答案是,自己此前对极限在哪里的认识过于天真了。
而 Dixon 留下的那个问题仍然悬着:当大模型不再只是执行人类写好的配方,而是开始先于人类提出新的物理原理时,物理学家又该如何自处?
© THE END
本文来自微信公众号“机器之心”(ID:almosthuman2014),作者:机器之心
编辑|Panda
理论物理中一项保持了三年的计算纪录,被 AI 刷新了。
几个小时前,Anthropic 宣布:Claude 在科研平台 Claude Science 中基本无人监督地连续运行数天,算出了平面 N=4 超对称杨-米尔斯理论(planar N=4 super-Yang-Mills)中的九圈六粒子散射振幅。
这是理论物理「散射振幅」领域公认的前沿难题,此前在该模型中的最高纪录停留在八圈,由 SLAC 国家加速器实验室的 Lance Dixon 与合作者于 2023 年创下。
这次突破由八圈纪录的创造者亲自把关。Dixon 独立验证了 Claude 的结果,并评价称,一个大语言模型能执行完这套复杂配方中的每一步、并把算力组织起来,在他看来「是一场相当了不起的胜利」。他甚至直言,除了他的合作者之外,Claude 比任何人都更懂他们团队 2019 年和 2023 年的那两篇论文。
更令人意外的是过程和成本。研究者交给 Claude 的只有一句任务描述,此后的「指导」几乎只剩下「继续」;整个计算折合到普通用户身上约一两千美元,其中真正用于数值计算的部分只有约 100 美元,相当于 96 个 CPU 跑一周。而 Dixon 原本认为,直接计算九圈振幅太难,他的团队为此已经筹备了好几年。
这项突破的起点,是一封公开的「战书」。
8 月 7 日,前理论物理学家、科普博主 Matt von Hippel 在自己的博客 4gravitons 上发了一篇带点挑衅意味的文章,标题叫「只有 AI 进入我的领域才算数」。他在文中点名向 AI 公司下战书:用一名学者能负担得起的算力,去解决散射振幅领域的一个悬而未决的大问题。
他给出了两个选项:要么把 N=8 超引力算到七圈,要么把 N=4 超对称杨-米尔斯理论的六粒子振幅算到九圈。
一个月后,AI 完成调整。Anthropic 刚刚刊出的,正是 von Hippel 本人撰写的客座文章,标题就是:「是的,Claude 能算九圈」。
https://www.anthropic.com/research/yes-claude-can-do-nine-loops
九圈,难在哪里?
要理解这件事的分量,得先说清楚物理学家在算什么。
粒子物理学家预测粒子行为,靠的是一类叫「散射振幅」的公式:给定参与碰撞的粒子的能量和动量,散射振幅能告诉你它们以某种方式发生反应的概率。
预测算得越精确,就越能和大型强子对撞机(LHC)这类实验的结果做细致比对。一旦出现偏差,就可能是新物理的线索,比如暗物质的本质,或者宇宙中物质与反物质为何不对称。
问题在于,散射振幅极难精确计算,物理学家几乎只能做近似。他们把计算按「圈」(loop)来分层,圈数大致衡量了粒子之间的相互作用被允许复杂到什么程度。每多加一圈,答案就更接近真实值,但计算量也随之急剧膨胀。von Hippel 在挑战原文中写道,这类计算的复杂度通常随圈数呈指数级甚至阶乘级增长。
所以现实中,绝大多数散射振幅只算到两圈,少数能到三圈。粒子物理中最精确的那个预测,电子反常磁矩,用到了五圈。
N=4 超对称杨-米尔斯理论则是这个领域专门的玩具模型。「杨-米尔斯」是描述电磁力、强核力、弱核力这三种基本相互作用的理论框架;「N=4 超对称」则意味着每个粒子都配有四个超对称伙伴。粒子多到不现实,这个理论并不描述真实世界。但恰恰是这种高度对称,让许多变量组合相互抵消,计算反而变得相对可控。研究者在这里打磨新方法,看它们能走多远。
这次用到的方法叫「自举」(bootstrap)。von Hippel 把它比作数独:先写出答案可能的全部形式,用一套专门的「字母表」记在计算机文件里,然后拿所有已知约束去逐一排除,包括其他方法给出的预测、答案必须遵守的规则、以及相关问题中已知的结果。理想情况下,最后只剩一个候选能通过所有检查,而且还有富余的检查条件用来确认没有算错。
八圈的纪录,Dixon 是绕着走拿到的。2023 年,他和 Yu-Ting Liu 借助一种被称为「对跖对偶」(antipodal duality)的奇特对称性,先算出相对更容易的「形状因子」(form factor),再由此换算出八圈振幅。此后几年,他的团队一直盯着九圈,计划沿用同样的间接路线。在他看来,直接去算九圈振幅太难了。
值得一提的是,von Hippel 本人正是这一研究路线的老兵。他曾与 Dixon 等人合作,把六粒子振幅推进到六圈和七圈。换句话说,他挑的是自己亲手啃过的骨头。
一句 prompt,然后不断「继续」
8 月底,Anthropic 的两位物理学家 Liam Fitzpatrick 和 Siddharth Mishra-Sharma 联系上了 von Hippel,告诉他挑战已经被攻克。
他们使用的是Fable 5.1模型,运行在 Claude Science 平台上。von Hippel 在文中解释,Claude Science 是一种「harness」,即在大模型外面套上结构化规则和提示,让它在科研任务中表现得更稳健。
据文章描述,两人先问 Claude 哪一个挑战它最有把握,然后只给了一句非常简短的任务描述:计算平面 N=4 SYM 中九圈的六粒子(六边形)振幅。
此后的「科研指导」基本就是让它接着干。文中披露的一条典型指令大意是:我要去睡觉了,接下来几个小时不在,继续做,直到我叫停为止,每四到六小时汇报一次进度。
最终,Claude 用两种方式各算了一遍:一是直接的自举法,二是 Dixon 团队那条经由形状因子的间接路线。据文章介绍,任选其一,终端用户的花费大约都在一两千美元,大头是长时间运行模型本身的费用。其中自举计算部分用 Python 和符号计算库 SymPy 完成,只占约 100 美元,相当于 96 个 CPU 跑一周。
von Hippel 感慨,十年前他做这类研究时,96 个 CPU 跑一周算是不小的投入,如今只要理由充分,这点资源相当平价。
验证者的感受:像一个塌掉的舒芙蕾
文章末尾附有 Dixon 亲自撰写的一段附言,题目就叫「被机器抢先是什么感觉」。
他写道,9 月 1 日,Anthropic 的两位研究者告诉他 Claude 算出了九圈振幅,并请他验证结果。对他而言,那一刻是大语言模型改变物理学这件事「真正落到自己身上」的时刻。
让 Dixon 印象深刻的,与其说是计算规模,不如说是整套流程的脆弱性。按他的描述,这套计算配方只要有任何一处出错,整个结果就会像失败的舒芙蕾一样塌掉,研究者只能回头苦苦排查。而且其中大量构造细节繁琐到不会被完整写进论文,这意味着 Claude 必须从零开始把所有代码搭建起来。
由于从九圈振幅倒推九圈形状因子相对容易,Dixon 主要是沿这条路做的验证。这也带来一个略显微妙的局面:他花了两周验证的,正是自己团队已经追了好几年的目标。
他坦言并不感到沮丧,理由有两个。
他的团队本来就在用定制的 Transformer 模型预测更高圈数的结果,还提出过一句口号,大意是只要机器给出候选答案,他们就有全套工具去验证。
Claude 解题时用的正是 Dixon 与合作者多年来发展出的方法,连结果的呈现格式都沿用了他们既有的规范。在他看来,他在验证 Claude 的同时,Claude 也在验证他们过去所有的工作。这也是他那句「Claude 比任何人都更懂我们的论文」的由来。
不过在称赞之余,Dixon 也表示,在他看来,真正让人辗转反侧的时刻,会出现在模型抢在人类之前提出新的物理原理和洞见的时候。
中国团队几乎同时抵达
这个故事还有一条平行线索,且与中国有关。
在 Anthropic 联系 von Hippel 之后没几天,中国科学院理论物理研究所的何颂(Song He)也找上门来:他的课题组已经拿到了九圈结果的大部分。9 月 17 日,何颂与 Jirong Jing、Xiang Li 在 Zenodo 上公开了一份数据集,题为《六胶子 MHV 振幅直至九圈的符号》,涵盖二圈至九圈的符号(symbol)数据。
https://zenodo.org/records/22800071
据 von Hippel 和 Dixon 的描述,何颂团队也借助了基于 GPT-6 的 AI 辅助,但只用于计算部分约束条件,整体框架仍由人来搭建,这与 Anthropic 那种「一句 prompt 加反复继续」的近乎全自动路线截然不同。
Dixon 在附言里自嘲,两周之内他先后被「一台机器」以及「人类加机器」抢了先。
von Hippel 特别提到,各方之间的氛围相当友好。接下来,Dixon、何颂及其合作者会发表这些结果,并为后来的研究者做详细解释和分析。
挑战者的复盘:低垂的果实比想象的多
回到 von Hippel 本人。他当初立下挑战,是想借自己熟悉的领域回答这个问题:AI 到底能不能绕过那些人人都以为无法逾越的算力瓶颈?
他在挑战原文里的逻辑是这样的:外界都在争论 AI 能否产生真正的新想法,但想法有多难找,只有找到之后才知道;计算的难度则更「实在」。许多关于超级智能的末日设想,从模拟人类心智以操纵人心,到从第一性原理设计纳米机器,批评者的标准反驳都是算力不够。如果 AI 能用学术圈级别的资源解决一个被公认为算力受限的问题,那才真正值得担心。
结果呢?von Hippel 的结论很坦诚:这次并没有出现他期待的那种「以意想不到的方式突破算力壁垒」。
Claude 用的是已知方法,只是比人类此前愿意投入的算力多了一些。它可能受益于用 Python 而不是物理学家惯用的 Maple 或 Mathematica,软件工程实践可能也比人类研究者更规范,但并没有到「超级智能」的程度。何颂团队几乎同步抵达,也从侧面说明这个目标对人类而言并非遥不可及。
他由此得出的最大体会是:哪怕目标简单明确,专家眼中遥不可及的事情,实际上可能并没有那么难,低垂的果实比预想的多。 多年来一直有计算机背景的朋友对他说,振幅研究者只要多雇几个程序员就能大幅推进,von Hippel 承认,这些人现在可以觉得自己说对了。
但他同样强调了另一面。这类计算琐碎而混乱,他自己如果用 96 个 CPU 跑一周,几乎必然会因为第一次出错而拖成两周。Claude Science 却在几乎没有科学监督的情况下一次跑通,没有依赖任何外部合作者的输入。他给仍然认为 AI 错误百出、不堪大用的人的建议是:这类工作,它现在已经能可靠地完成了。
他还做了一个纵向对比。今年 3 月,Anthropic 发布的「vibe physics」实验里,AI 做物理项目还像个学生,任务规模小,需要大量手把手指导,错误频出。半年后,它完成的已是振幅领域顶尖专家才会去碰的前沿计算。他不排除这恰好是一个特别适合 AI 的问题,但他判断,技术本身确实变强了。
至于能否推而广之,von Hippel 保持谨慎。N=4 这类玩具模型通常只属于很小的研究圈子,而面向真实世界的振幅计算竞争激烈得多,那里的低垂果实可能更少。但他也提醒,做这些计算的研究者如果还没试过让 AI 科研平台一次性冲击前沿计算,就该试试了,同时要准备好验证结果的方案。他不会太意外,有人能在合理预算内再多挤出一圈。
写在最后
把这件事放回 9 月的背景里看,会更有意思。
就在本月 8 日,OpenAI 宣布其未公开模型调动上万个 AI 智能体,给出了纳维-斯托克斯方程存在性与光滑性问题的一个反例,也就是千禧年大奖难题之一,该结果目前仍在接受数学界审视。与那种动用海量算力的「大兵团作战」相比,九圈振幅的故事显得朴素得多:一个商用科研平台,一句任务描述,几千美元,几天时间。
也正因为朴素,它可能更值得学术界关注。von Hippel 最终坦承,他原本希望借这次挑战一窥未来,看到某种前所未见的计算新方法,从而在超级智能的争论中获得有依据的判断。但他得到的答案是,自己此前对极限在哪里的认识过于天真了。
而 Dixon 留下的那个问题仍然悬着:当大模型不再只是执行人类写好的配方,而是开始先于人类提出新的物理原理时,物理学家又该如何自处?
© THE END
本文来自微信公众号“机器之心”(ID:almosthuman2014),作者:机器之心
30
·
--
Xem bản dịch
推理服务商Fireworks与Fal考虑开启新一轮融资,相比上一轮估值均近翻倍火星财经消息 9月26日,据报道,知情人士透露,专注为谷歌Nano Banana等图像、视频生成模型提供推理服务的Fal,已和投资者洽谈新一轮融资,目标估值150亿美元。另有消息人士称,谈判尚处于早期阶段,该公司有可能把目标估值上调至170亿至200亿美元区间。相比之下,今年春季一轮融资时,该公司估值仅80亿美元。知情人士表示,洽谈融资的背景是其年化营收攀升至8亿美元,相比3月水平翻了一番。 与此同时,按营收规模排名第一的推理服务商Fireworks AI也在考虑新一轮融资,知情人士称,若推进融资,目标估值可达300亿美元,相比7月公布的上一轮估值几乎翻倍。Fireworks周五表示,公司已完成由阿特莱德斯资本牵头的员工股份出售,交易估值175亿美元,与7月公布的上一轮融资估值持平。截至7月,其年化营收已经达到10亿美元,较一年前增长四倍。 此外,推理服务商Baseten正和投资者洽谈新一轮融资,目标估值260亿美元;同类服务商Modal也在洽谈融资,估值约150亿美元,约为四个月前一轮融资估值的三倍。(新浪财经)
推理服务商Fireworks与Fal考虑开启新一轮融资,相比上一轮估值均近翻倍
火星财经消息 9月26日,据报道,知情人士透露,专注为谷歌Nano Banana等图像、视频生成模型提供推理服务的Fal,已和投资者洽谈新一轮融资,目标估值150亿美元。另有消息人士称,谈判尚处于早期阶段,该公司有可能把目标估值上调至170亿至200亿美元区间。相比之下,今年春季一轮融资时,该公司估值仅80亿美元。知情人士表示,洽谈融资的背景是其年化营收攀升至8亿美元,相比3月水平翻了一番。 与此同时,按营收规模排名第一的推理服务商Fireworks AI也在考虑新一轮融资,知情人士称,若推进融资,目标估值可达300亿美元,相比7月公布的上一轮估值几乎翻倍。Fireworks周五表示,公司已完成由阿特莱德斯资本牵头的员工股份出售,交易估值175亿美元,与7月公布的上一轮融资估值持平。截至7月,其年化营收已经达到10亿美元,较一年前增长四倍。 此外,推理服务商Baseten正和投资者洽谈新一轮融资,目标估值260亿美元;同类服务商Modal也在洽谈融资,估值约150亿美元,约为四个月前一轮融资估值的三倍。(新浪财经)
13
Đăng nhập để khám phá thêm nội dung
Tham gia cùng người dùng tiền mã hóa toàn cầu trên Binance Square
⚡️ Nhận thông tin mới nhất và hữu ích về tiền mã hóa.
💬 Được tin cậy bởi sàn giao dịch tiền mã hóa lớn nhất thế giới.
👍 Khám phá những thông tin chuyên sâu thực tế từ những nhà sáng tạo đã xác minh.
Email / Số điện thoại
Chủ đề thịnh hành
45NgayTuDoTaiChinh
938,931 lượt xem
3,264 đang thảo luận
Ngày 1/45: Bắt đầu hành trình, không đợi 'thời điểm vàng' ✨
Hôm nay là ngày đầu tiên của hành trình 45 ngày tự do tài chính, mình chính thức bắt đầu đều đặn bỏ 50u mua Bitcoin. Sáng nay thấy giá $BTC có giảm nhẹ chút xíu (-0.73%), có người có thể sẽ chần chừ, đợi xem nó xuống nữa không. Nhưng mình thì khác, đây chính là lúc mình hiểu ra tại sao lại chọn chiến lược đều đặn này.
Thật ra, bao nhiêu lần rồi mình cố gắng đoán đáy, đoán đỉnh, rồi bỏ lỡ cơ hội. Cứ mãi nghĩ “đợi thêm tí nữa” hoặc “nhỡ nó xuống nữa thì sao” rồi cuối cùng lại FOMO mua đỉnh. Nên lần này, mình quyết tâm đi theo một con đường khác: kỷ luật và kiên nhẫn. Không tìm kiếm cái gọi là “thời điểm vàng” nữa, vì thật sự, ai mà biết được thời điểm nào là tốt nhất đâu?
Thông tin tham khảo, không phải lời khuyên đầu tư. DYOR.
#45ngaytudotaichinh #AIStocksWhatNext
Phuc Plugito
·1 lượt thích
·317 lượt xem
TheoDõiFOMC
100,802 lượt xem
594 đang thảo luận
TinFed
84,467 lượt xem
402 đang thảo luận