


Tổng hợp những hiểu biết từ Axis Robotics
Năm 2026, ngành công nghiệp trí tuệ nhân tạo đã học cách giải quyết bài toán về khả năng tính toán (compute). GPU đang ngày càng dễ tiếp cận hơn, các mô hình rẻ hơn để chạy suy luận (inference), và hạ tầng đám mây tiếp tục mở rộng. Nhưng làn sóng AI tiếp theo, robot và AI Vật lý (Physical AI), lại gặp một vấn đề hoàn toàn khác. Tất cả đều xuất phát từ dữ liệu mà đơn giản là không tồn tại với khối lượng cần thiết.
Không có Internet cho Robot
LLM (mô hình ngôn ngữ lớn) phát triển dựa trên một nền tảng mà trước đó đã tồn tại. Nhiều thập kỷ văn bản trên internet, hàng nghìn tỷ token bao phủ gần như mọi lĩnh vực của tri thức con người. Với kho dữ liệu đó đã sẵn có, tiến bộ chủ yếu là nhờ tăng quy mô khả năng tính toán và cải thiện kiến trúc (architecture).
Robotics không có nền tảng như vậy. Thế giới vật lý không có chỉ mục tìm kiếm, và cũng không có “internet của các tương tác robot” để huấn luyện một mô hình.
Toàn bộ khối lượng dữ liệu hiện có để huấn luyện robot chỉ là một phần cực nhỏ so với các tập văn bản (text corpora) mà các mô hình ngôn ngữ hiện đại được huấn luyện. Điều này tạo ra sự thiếu hụt dữ liệu nền tảng ở mọi cấp độ.
Khoảnh khắc GPT-1 bị thiếu trong lĩnh vực robot
Quỹ đạo của các mô hình ngôn ngữ rất đáng để suy ngẫm, vì mỗi bước đi qua lại khiến một ràng buộc mới được loại bỏ. GPT-2 được huấn luyện trên khoảng 10 tỷ token, tương đương khoảng 500.000 giờ đọc ở tốc độ của con người.
Đó là thời điểm lần đầu hành vi mô hình mang tính “nổi lên” xuất hiện. GPT-3 được huấn luyện trên khoảng 300 tỷ token, tương đương khoảng 15 triệu giờ, và nếu không có khối lượng đó thì sẽ không có ChatGPT, cũng như không có những gì diễn ra sau đó.
Robotics vẫn chưa có “khoảnh khắc” đó. Kiến trúc mô hình đang hội tụ, thuật toán đang trưởng thành, nhưng chính dữ liệu vẫn chưa ổn định. Phân phối dữ liệu tiền huấn luyện nào là đúng, tỷ lệ mô phỏng, thế giới thực và dữ liệu theo góc nhìn chủ thể (ego-centric) nên như thế nào. Nói cách khác, không có sự đồng thuận nào về cấu trúc dữ liệu.
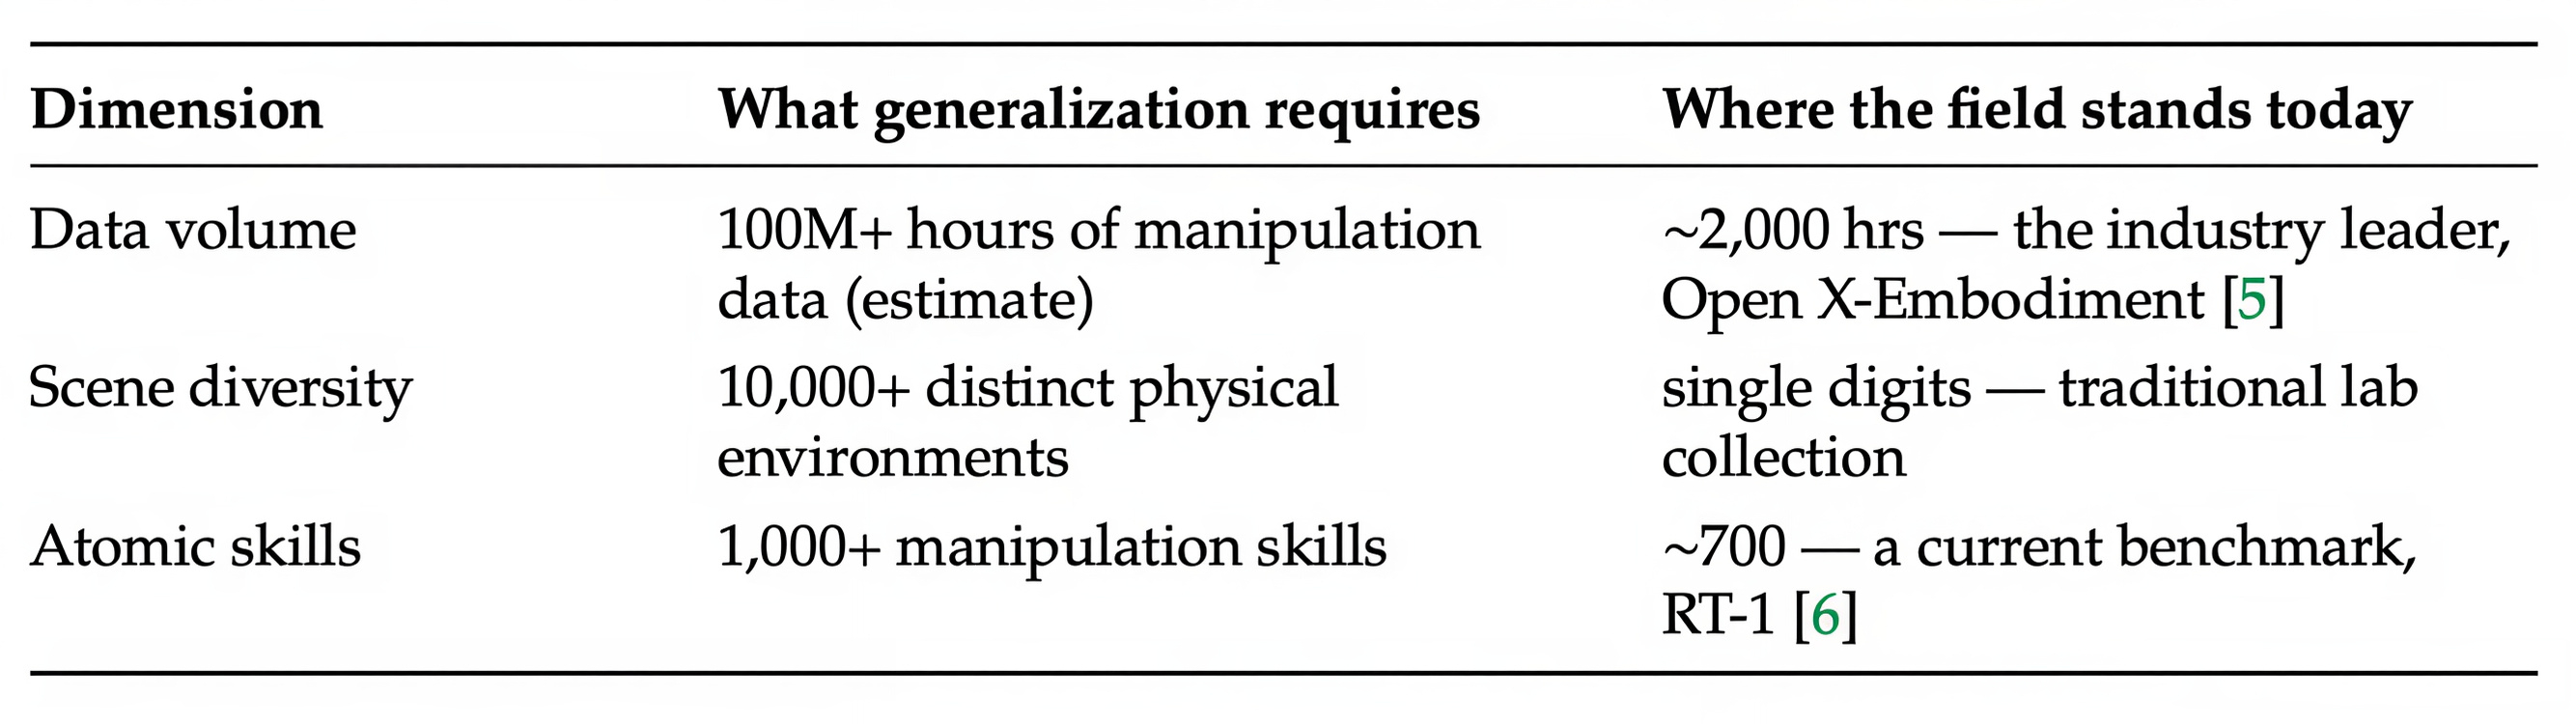
Nếu 15 triệu giờ văn bản tạo ra GPT-3, thì một mô hình thực sự đa dụng về trí tuệ vật lý có thể cần cỡ khoảng 100 triệu giờ dữ liệu về thao tác với vật thể của con người.
Ngày nay, ngành công nghiệp có khoảng 2.000 giờ, bộ dữ liệu công khai tốt nhất là Open X-Embodiment. Cũng tồn tại một khoảng trống tương tự về sự đa dạng kịch bản và số lượng kỹ năng nguyên tử đã được thuần thục.
Vì sao việc thu thập không mở rộng được
Tính toán (compute), phần cứng và các thuật toán cho trí tuệ vật lý đã sẵn sàng. Điều thực sự còn thiếu là dữ liệu, và có ba lý do mang tính cấu trúc cho điều đó.
Thu thập ngoài đời thực bị nghẽn bởi phần cứng. Các bộ gá (rig) chuyên dụng, hệ thống an toàn và mỗi robot cần một người vận hành đã được huấn luyện. Điều này giới hạn cả khối lượng lẫn độ phủ, và khiến việc đạt “quy mô mô hình nền tảng” về mặt cấu trúc trở nên không thể tiếp cận.
Thu thập thủ công không thể tạo ra sự đa dạng cần thiết. Khả năng khái quát (generalization) đòi hỏi sự đa dạng tích lũy qua các đối tượng, kịch bản, dạng hình robot và góc camera; những bộ dữ liệu thu thập thủ công đơn giản là không thể cung cấp được.
Các mô hình chỉ được huấn luyện trên các minh họa của chuyên gia sẽ bị “mù” trước chính sai lầm của họ. Chính sách chỉ nhìn thấy các trạng thái mà chuyên gia đã đi qua, nghĩa là chính tại nơi nó yếu nhất thì lại có ít dữ liệu huấn luyện nhất. Sai lỗi tích lũy qua toàn bộ tầm chân trời của tác vụ.
Mỗi ràng buộc trong số này đều hướng theo cùng một phía. Thứ cần thiết không phải là một mô hình tiên tiến hơn, mà là một cơ chế (regime) cơ bản khác để tạo dữ liệu.
Humanoids chạy bằng dữ liệu
Năm 2026 trở thành đỉnh điểm của sự quan tâm đầu tư vào robot humanoid. Hàng tỷ đô la đổ vào phần cứng, vào mô hình, và vào năng lực sản xuất của những “ông lớn” chính trong ngành. Nhưng toàn bộ lượng vốn đó lại mắc vào cùng một nút thắt cổ chai. Tiền giải quyết được câu hỏi về phần cứng và năng lực tính toán (compute), nhưng lấy đâu ra hàng triệu giờ dữ liệu về thao tác vật thể trong thế giới thực?
Điều này khiến bài toán dữ liệu trở thành chính thứ đang kìm hãm một ngành đang nhận đầu tư hàng tỷ đô la ngay lúc này. Tham vọng triển khai humanoid trong điều kiện thực tế càng tăng, thì sự thiếu hụt dữ liệu cũng tăng nhanh tương ứng. Mỗi dạng hình robot mới, môi trường mới và kỹ năng mới đều cần phần dữ liệu huấn luyện riêng của mình.
Axis Robotics: động cơ dữ liệu tích lũy qua từng vòng
Phần lớn các pipeline dữ liệu robotics chỉ chạy một chiều. Thu thập dữ liệu, huấn luyện mô hình, gửi đi, rồi bắt đầu lại. Axis được xây dựng như một vòng lặp khép kín: mọi đóng góp sẽ cải thiện chính sách kế tiếp, và mọi chính sách được cải thiện lại quyết định nên thu thập dữ liệu gì tiếp theo. Dữ liệu không còn là chi phí một lần nữa mà trở thành một tài sản có xu hướng tăng giá trị.
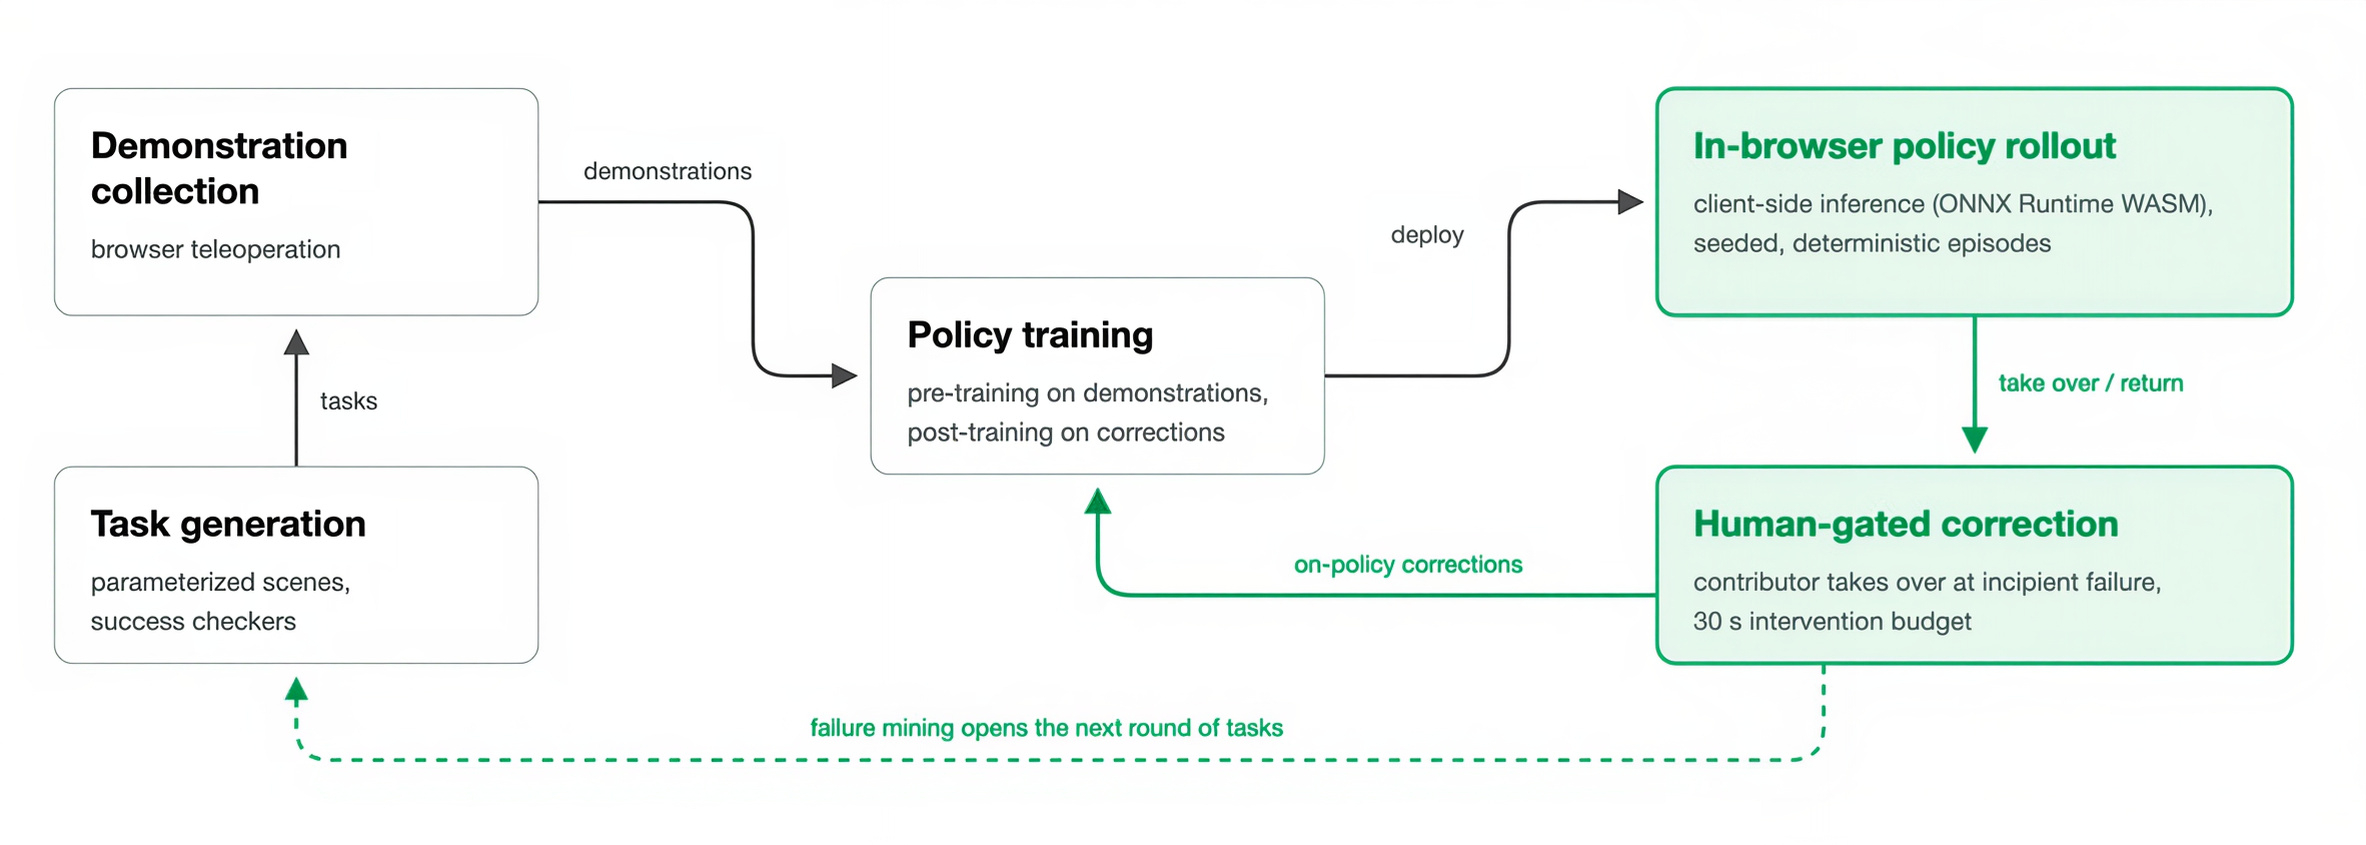
Chu trình gồm năm bước: tạo tác vụ và cảnh, thu thập hành vi thông qua điều khiển từ xa trong mô phỏng và ghi nhận các tương tác ngoài đời thực, xử lý và làm sạch các quỹ đạo, rồi huấn luyện và triển khai chính sách (policy) trên cả đội robot thật lẫn mô phỏng.
Cuối cùng, đó là việc thu thập các tín hiệu về chính nơi mà chính sách vẫn còn mắc sai lầm. Các tín hiệu này quyết định những tác vụ nào sẽ mở ra ở vòng tiếp theo, và chu trình lặp lại trên dữ liệu khó hơn và có giá trị hơn.
Ba sản phẩm nền tảng bao phủ toàn bộ chu trình:
Nền tảng mô phỏng dữ liệu trên web: mô phỏng chạy trong trình duyệt, không cần cài đặt và không yêu cầu phần cứng; người tham gia điều khiển robot qua điều khiển từ xa để tạo các minh họa, đồng thời sửa hành vi của một mô hình đã được huấn luyện. Năng suất hiện đã đạt 10.000 quỹ đạo hợp lệ mỗi giờ;
Ứng dụng di động theo góc nhìn chủ thể (Mobile Ego-Centric App): một ứng dụng di động để ghi lại dữ liệu góc nhìn thứ nhất thông qua theo dõi tư thế tay (hand-pose tracking), không cần thiết bị chuyên dụng. Ra mắt vào tháng 9 năm 2026 với mục tiêu 10.000+ giờ dữ liệu hợp lệ mỗi tháng;
Pipeline từ dữ liệu đến mô hình (Data-to-Model Pipeline): một đường ống xử lý thống nhất làm sạch, tăng cường thông qua domain randomization, và gán nhãn cho các quỹ đạo thô, biến chúng thành dữ liệu sẵn sàng cho huấn luyện mô hình.
Kết quả thực nghiệm cốt lõi là: việc tiếp tục tiền huấn luyện mô hình π0.5 của Physical Intelligence trên bộ dữ liệu Axis đã nâng tỷ lệ thành công trên benchmark LIBERO-Plus từ 83,9% lên 88,8%, và vượt kết quả của nhóm đối chứng được khớp về khối lượng (volume-matched control group) trên RoboCasa365 thêm 31,3 điểm phần trăm. Mức tăng tỷ lệ theo khối lượng dữ liệu Axis, cho thấy tính mạch lạc (coherence) của tín hiệu đến từ crowdsourcing, thay vì nhiễu ngẫu nhiên.
Tính đến cuối tháng 8 năm 2026, nền tảng đã vượt 150.000 người đóng góp toàn cầu và thu thập hơn 3,7 triệu quỹ đạo trên 4.000+ tác vụ đã được xuất bản.
Trong số các đối tác của Axis: các nhà sản xuất phần cứng robotics AgiBot, Booster Robotics, Unitree và Deep Robotics; các phòng thí nghiệm mô hình nền tảng như Manycore Tech; và các khách hàng công nghiệp Geely Auto và Lotus Cars, những đơn vị sử dụng nền tảng để huấn luyện tự động hóa cho các tác vụ phân loại và các tác vụ sản xuất khác.
Crypto như một hạ tầng (Infrastructure)
Mở hệ thống như thế này cho cộng đồng người đóng góp toàn cầu, không cần xin phép ngay mặc định, lại đặt ra một câu hỏi mà chính động cơ dữ liệu không thể tự trả lời: làm sao biến các đóng góp có thể nhiễu, ở một số nơi kém tối ưu, và thậm chí có thể mang ý đồ xấu, thành một bộ dữ liệu huấn luyện đáng tin cậy, đồng thời vẫn giữ được hồ sơ chính xác về ai thực sự đã tạo ra cái gì.
Axis giải quyết điều đó bằng hệ thống đánh giá hai tầng. Hệ thống Chấm điểm (Scoring System) đánh giá từng quỹ đạo riêng lẻ, trong khi Hệ thống Điểm (Point System) tổng hợp danh tiếng của người đóng góp theo thời gian dựa trên khối lượng, độ khó tác vụ, chất lượng và mức độ đa dạng của đóng góp.
Mọi quỹ đạo (trajectory) được chấp nhận đều được ký on-chain trên Mạng Base với một Data ID duy nhất, gắn ví của người đóng góp, một mốc thời gian (timestamp), điểm chất lượng (quality score) và tham chiếu tác vụ vào một hồ sơ vĩnh viễn, chống giả mạo. Crypto ở đây là hạ tầng cho provenance, tính minh bạch và phối hợp trong quá trình sản xuất Physical AI.
Ngoài Base, dự án còn có các tích hợp với BitRobot Network trong hệ sinh thái Solana và với Pi Network, trong khi kiến trúc provenance bản thân vẫn giữ nguyên bất kể dùng mạng nào.
Những hiểu biết từ Axis Robotics
Chúng tôi đã hỏi đội ngũ Axis Robotics về cơ chế đằng sau việc mở rộng một động cơ dữ liệu do cộng đồng tạo (crowdsourced): chất lượng được giữ vững ra sao khi nền tảng tăng trưởng, họ quyết định thu thập gì tiếp theo như thế nào, và “quy mô mô hình nền tảng” thực sự có ý nghĩa gì với họ.
Hỏi: Làm thế nào để duy trì chất lượng dữ liệu khi số lượng người đóng góp tiếp tục tăng nhanh như vậy?
Ngay từ ngày đầu, chúng tôi đã xây dựng một hệ thống kiểm tra chất lượng và kiểm soát hoàn chỉnh gồm ba lớp, kèm theo một đường ống xử lý dữ liệu tự động tương ứng. Nhờ vậy, hoạt động kiểm soát chất lượng của chúng tôi không bị suy giảm đáng kể khi cơ sở người đóng góp mở rộng.
Cụ thể, ba lớp kiểm tra chất lượng là:
Lớp 1:Xác thực theo thời gian thực khi nộp. Khi người dùng gửi dữ liệu, hệ thống sử dụng bộ kiểm tra thành công (success checker) để kiểm tra ngay liệu tác vụ có thực sự được hoàn thành hay không và trạng thái tạo ra có nhất quán hay không, đồng thời lọc các bản gửi rõ ràng bất thường như chuyển động không tự nhiên, lỗi vận hành hoặc tệp bị hỏng.
Lớp 2:Phát lại quỹ đạo ở phía backend. Backend sẽ phát lại toàn bộ quỹ đạo, sử dụng cơ chế phát lại có đối chiếu (cross-simulator replay) để kiểm tra liệu có kịch bản hóa (scripting), công cụ gian lận (cheating tools) hay can thiệp phi con người khác hay không, đồng thời tiếp tục kiểm tra chất lượng dữ liệu và độ ổn định của chính quỹ đạo đó.
Lớp 3:Xác thực chính sách theo lô (batch-level policy validation). Mọi lô dữ liệu đều được dùng để huấn luyện nhanh một chính sách nhẹ (lightweight policy), và hiệu suất của chính sách đó được dùng để xác thực tính hiệu quả và khả năng học được của lô dữ liệu này.
Khi hoàn tất cả ba lớp xác thực, hệ thống giữ lại dữ liệu hợp lệ và gán điểm chất lượng. Sau đó, người dùng có thể đăng ký quỹ đạo dữ liệu tương ứng lên blockchain, đảm bảo rằng mọi mảnh dữ liệu hợp lệ đều mang hồ sơ provenance dài hạn, có thể truy vết và có thể kiểm chứng.
Hỏi: Làm thế nào bạn quyết định nên ưu tiên bổ sung những dạng hình robot và kịch bản nào vào động cơ tạo tác vụ?
Chúng tôi xác định ưu tiên theo ba chiều chính: tính khái quát, sự đa dạng và nhu cầu cụ thể của các đối tác.
Thứ nhất, tính khái quát đủ cao. Chúng tôi ưu tiên các dạng hình robot và các kịch bản có phạm vi bao phủ rộng nhất và được sử dụng phổ biến nhất trong toàn ngành. Ở phía dạng hình, ví dụ, chúng tôi ưu tiên các cấu hình tay đơn điển hình như Franka Arm, cũng như các cấu hình hai tay như Open Arm. Nền tảng hiện hỗ trợ hơn mười tài sản robot phổ biến, trải rộng từ tay đơn, hai tay, hai tay dạng bánh xe, và các loại khác. Ở phía kịch bản, chúng tôi đã bao quát một cách hệ thống mọi thứ từ môi trường gia đình đến môi trường công nghiệp, đảm bảo rằng tất cả các kịch bản cấp cao phổ biến đều được hỗ trợ.
Thứ hai, sự đa dạng đủ phong phú. Chúng tôi liên tục theo dõi các nghiên cứu học thuật tiên phong và nhu cầu của ngành để xác định những kịch bản, loại đối tượng và kỹ năng nguyên tử còn thiếu gấp nhất trong quá trình huấn luyện của mô hình hiện tại, rồi nhanh chóng mở rộng và lấp đầy các khoảng trống đó. Mục tiêu của chúng tôi là để Axis trở thành nền tảng dữ liệu với lợi thế rõ ràng về cả sự đa dạng lẫn độ phủ, tạo ra giá trị khác biệt đặc biệt trong các tác vụ đuôi dài, các tình huống ngoại lệ và khả năng tương tác phức tạp.
Thứ ba, nhu cầu cụ thể của các đối tác. Chúng tôi cũng ưu tiên các dạng hình robot và kịch bản dựa trên nhu cầu thực tế của đối tác. Với các đối tác như Booster Robotics, Feagine Robotics và các cộng tác viên phần cứng và dạng hình khác, chúng tôi ưu tiên việc điều chỉnh theo các dạng hình robot của họ, đồng thời thiết kế riêng việc thu thập dữ liệu và các tác vụ xoay quanh dữ liệu đầu vào thị giác, không gian thao tác (action space) và mục tiêu huấn luyện mô hình của họ.
Cần nhấn mạnh rằng nhờ chính bản chất của mô phỏng, cùng với thư viện tài sản quy mô lớn mà chúng tôi tự xây dựng nội bộ, chúng tôi có thể mở rộng sang các dạng hình robot mới, tài sản đối tượng mới, môi trường cảnh mới và các kỹ năng nguyên tử mới một cách rất hiệu quả. Điều này mang lại cho Axis sự linh hoạt và khả năng mở rộng mạnh mẽ trong sản xuất dữ liệu, cho phép chúng tôi phản hồi nhanh cả với các nhu cầu chung của ngành lẫn yêu cầu riêng của từng khách hàng.
Hỏi: Điều gì thực sự sẽ thuyết phục bạn rằng động cơ dữ liệu đã đạt “quy mô mô hình nền tảng”?
Đánh giá liệu một động cơ dữ liệu có thực sự đạt “quy mô mô hình nền tảng” hay không không chỉ là chuyện tích lũy khối lượng dữ liệu thô, dù bản thân khối lượng vẫn còn rất quan trọng.
Ở phía dữ liệu theo góc nhìn chủ thể (ego data), ví dụ, trước hết bạn cần một “quỹ dự trữ” tối thiểu 1 triệu giờ dữ liệu OTS trải rộng trên hàng trăm nhóm con (sub-categories); ở phía dữ liệu mô phỏng, bạn cần hàng triệu quỹ đạo đã được xác thực và có hiệu quả. Đây chính là quy mô nền tảng cần thiết cho huấn luyện mô hình nền tảng.Nhưng bên trên nền tảng đó, câu hỏi quan trọng hơn là liệu toàn bộ nền tảng có thể tiếp tục tiến hóa: liệu nó có thể liên tục lặp lại, mở rộng và tự củng cố khi ranh giới năng lực của mô hình, các hướng nghiên cứu và nhu cầu của ngành thay đổi hay không.
Một động cơ dữ liệu đạt đúng “quy mô mô hình nền tảng” phải là hạ tầng nghiên cứu chủ động, chứ không phải hệ thống sản xuất dữ liệu thụ động chỉ phản hồi các đơn hàng đến. Nó phải có thể nhanh chóng và tự động chuyển đổi các mục tiêu nghiên cứu hoặc thương mại thành các tác vụ có cấu trúc, và sinh dữ liệu ở quy mô lớn trên nhiều dạng hình robot, nhiều kịch bản và nhiều nền tảng tác vụ. Đồng thời, nó phải sử dụng kết quả huấn luyện mô hình để xác thực ngược lại tính hiệu quả và giá trị của dữ liệu đó, tạo thành một vòng lặp khép kín liên tục giữa sản xuất dữ liệu, huấn luyện mô hình, đánh giá năng lực và lặp lại tác vụ.
Cuối cùng, một động cơ dữ liệu ở quy mô mô hình nền tảng phải có khả năng chứng minh rằng nó có thể liên tục cung cấp dữ liệu chất lượng cao, đa dạng cao và bao phủ rộng với chi phí cận biên thấp; thúc đẩy các mô hình và dạng hình robot ngày càng cải thiện mức độ “thông minh”, đồng thời thể hiện khả năng bền vững (robustness) và khả năng khái quát hóa tốt hơn trong các môi trường thực tế, không kịch bản (real, unscripted).
Điểm chung xuyên suốt cả ba câu trả lời là: Axis coi bản thân việc “mở rộng quy mô” là một bài toán kỹ thuật, chứ không chỉ là một con số mục tiêu. Chất lượng được đảm bảo bằng các kiểm tra tự động theo từng lớp thay vì duyệt thủ công, và ngưỡng cho “quy mô mô hình nền tảng” tạo thành một vòng lặp tự củng cố.
Ghi chú từ CEO của Cicada Market Maker
Chúng tôi quay lại gặp CEO và đồng sáng lập của Cicada, Maxim Moris, để xin ý kiến đánh giá cụ thể về Physical AI: liệu câu chuyện đó có đứng vững hay không, và theo ông thì token nên nằm ở đâu trong câu chuyện.
Hỏi: Điều gì đưa Dữ liệu Physical AI và robotics lên “radar” của Cicada?
Thành thật mà nói, trước hết là câu chuyện tiếp theo: danh sách và khối lượng sẽ theo sau, và chúng tôi làm việc với thanh khoản (liquidity), không phải robot. Có một vấn đề thực sự ở phía bên dưới: các mô hình ngôn ngữ có hàng nghìn tỷ token, robotics có hàng nghìn giờ tương tác vật lý, và dữ liệu đó không thể cạo (scrape) được—nó phải được tạo ra bằng tay.
Sau đó là câu hỏi khiến tôi quan tâm hơn cả bản thân câu chuyện: thu thập dữ liệu là một hoạt động kinh doanh bình thường, nhưng tại sao nó lại cần một token riêng? Hiện tại, câu trả lời trung thực từ phần lớn các dự án là "vậy nên có một token."
Hỏi: Đây có phải là một câu chuyện bền vững hay chỉ là một vòng hype giống nhau?
Nhu cầu dữ liệu là bền vững; các token xây dựng dựa trên nhu cầu đó thì không bền. Và đó là hai câu chuyện khác nhau. Bên mua ở đây là một phòng thí nghiệm cần quyền sử dụng sạch, provenance rõ ràng và chất lượng có thể tái tạo; họ trả tiền theo hình thức fiat theo hợp đồng và sẽ không giữ “ticker” của ai đó trên bảng cân đối kế toán.
Cơ chế DePIN cũng vỡ ở đây vì robot là một tài sản vốn có người vận hành, không phải bộ định tuyến Wi‑Fi nhàn rỗi; và việc chi trả dựa trên lượng phát thải (emissions) cho khối lượng tạo ra spam chứ không tạo ra dữ liệu, từ đó làm nhiễm bẩn bộ dữ liệu—hi Helium. Vì vậy, câu chuyện sẽ sống lâu hơn chu kỳ, và 90% số token chạy theo câu chuyện đó sẽ không tồn tại được.
Hỏi: Điều gì sẽ xảy ra với danh mục đó sau một năm nữa?
Trí tuệ vật lý (Physical AI) có thể vẫn là một thuật ngữ trong các deck chào mời và chỉ số ngành, trong khi thứ thực sự được giao dịch là các phân mảnh: mô hình VLA, thu thập dữ liệu, mô phỏng, phần cứng, và vận hành đội robot (fleet operations).
Về mặt khách quan, crypto chỉ có vị trí trong một lớp rất hẹp của danh sách đó: thanh toán máy và danh tính, miễn là sẽ có đủ robot để chúng bắt đầu thanh toán cho nhau; điều đó sẽ không xảy ra vào năm 2027, và nó cũng không cần một token riêng cho mỗi bộ dữ liệu.
Phần còn lại là các công ty bình thường, cần một token như kênh huy động vốn và marketing, chứ không phải là một phần của sản phẩm. Tôi không phản đối điều đó; tôi chỉ thích gọi đúng tên những gì nó là.
Câu trả lời của Maxim vạch ra một đường ranh giới rõ ràng: nhu cầu đứng sau dữ liệu của Physical AI là có thật, nhưng theo ông đó là lập luận để câu chuyện đó vẫn chỉ là một hoạt động kinh doanh bình thường.
Kết luận
Physical AI đang đi ngược lại con đường mà các mô hình ngôn ngữ trước đó đã từng đi. Điểm khác biệt là: với mô hình ngôn ngữ, quy mô đó đã tồn tại sẵn dưới dạng văn bản trên internet, còn với robotics thì nó vẫn phải được thu thập.
Các dự án như Axis Robotics đặt cược rằng quy trình này sẽ đi theo con đường tương tự như văn bản internet trước đây. Dữ liệu cho robot sẽ được thu thập theo cách phân tán, bởi nhiều người trên khắp thế giới, thay vì bởi một phòng thí nghiệm duy nhất với đội robot bị giới hạn.
Kết quả trên LIBERO-Plus và số lượng người đóng góp của nền tảng tăng lên con số hàng trăm nghìn, cùng với danh sách đối tác ngày càng tăng trong nhóm nhà sản xuất phần cứng, các phòng thí nghiệm và khách hàng công nghiệp, là bằng chứng ban đầu rằng mô hình sản xuất dữ liệu này thực sự hoạt động.
Tìm hiểu thêm: GPU Shortage and the Birth of AI DePIN