Mình đã nhận thấy một điều thú vị trong crypto.
Mỗi khi một dự án AI mới thu hút sự chú ý, cuộc trò chuyện nhanh chóng chuyển sang cuộc đua tìm ai có nhiều sức mạnh tính toán nhất, mô hình lớn nhất, hoặc cơ sở hạ tầng mạnh mẽ nhất. Giả định rất đơn giản: ai có thể lưu trữ nhiều trí tuệ hơn thì sẽ thắng.
Có lẽ đó là kết luận đầu tiên mà hầu hết mọi người đạt được khi nhìn vào @OpenGradient .
Nhưng càng suy nghĩ lâu, mình càng không chắc chắn rằng việc lưu trữ trí tuệ là vấn đề khó khăn nhất.
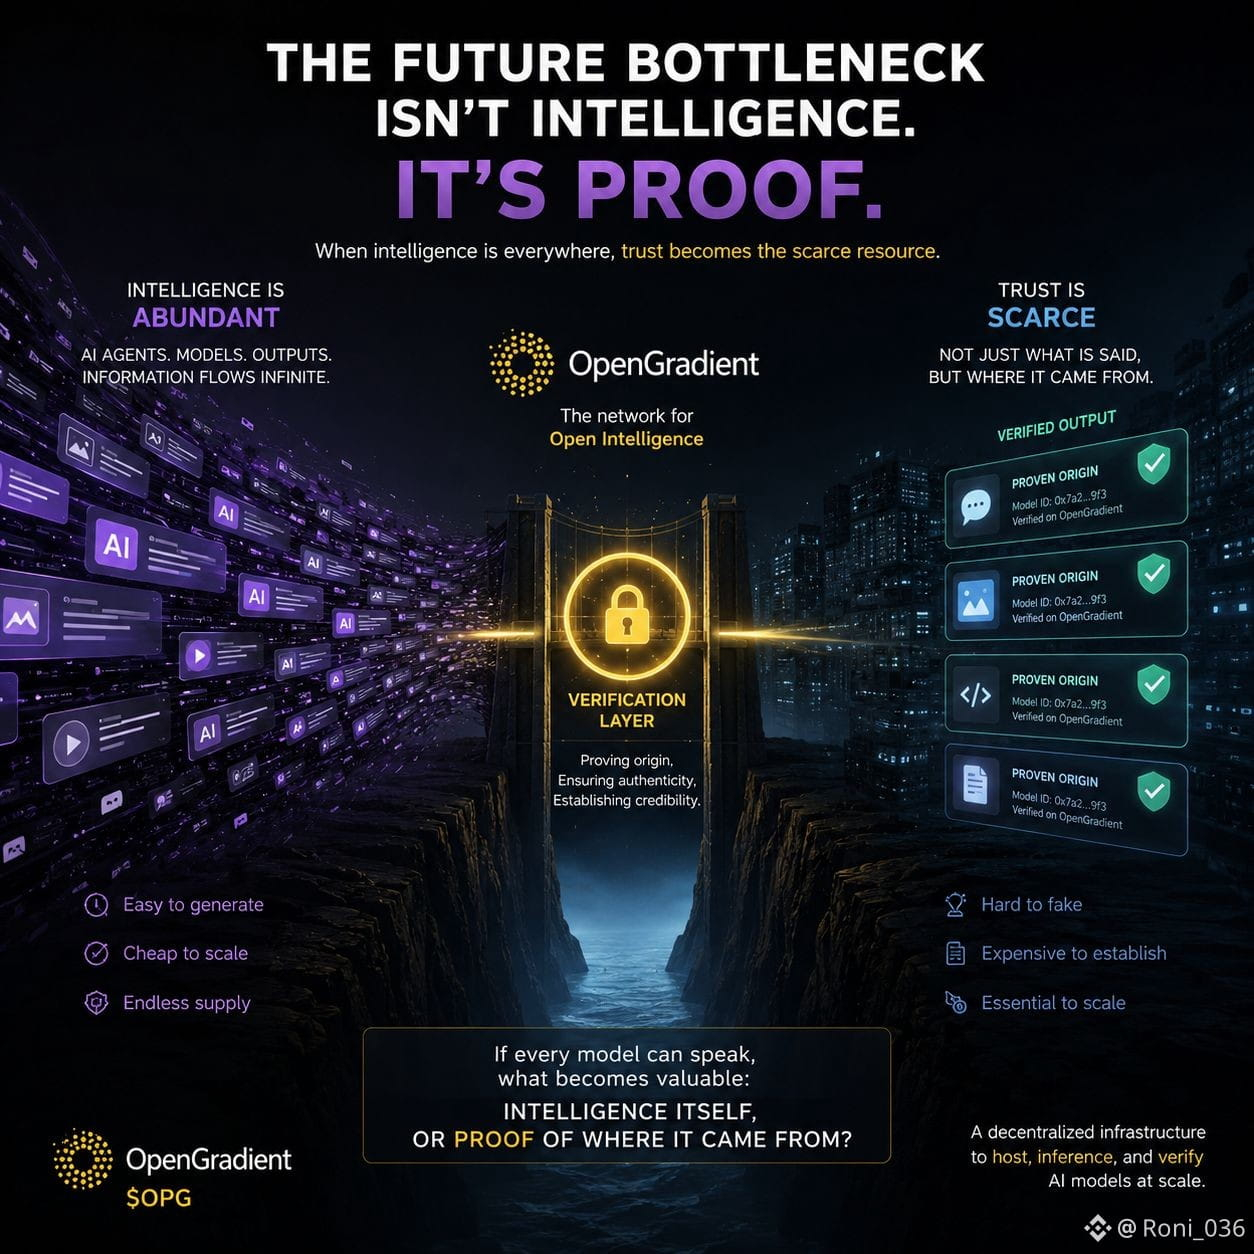
Hãy tưởng tượng một tương lai mà các tác nhân AI hiện diện khắp nơi. Các tác nhân nghiên cứu, tác nhân giao dịch, tác nhân hỗ trợ khách hàng, phần mềm tự động. Việc tạo ra thông tin trở nên rẻ và liên tục. Các đầu ra tràn ngập mọi ngóc ngách của internet.
Bây giờ hãy đặt một câu hỏi khác.
Làm sao bạn biết một đầu ra thực sự đến từ mô hình, tác nhân, hoặc hệ thống mà nó tuyên bố đã sản xuất ra?
Điều đó nghe có vẻ như một chi tiết nhỏ hôm nay, nhưng có thể trở thành một lớp kinh tế quan trọng vào ngày mai. Nếu trí tuệ trở nên phong phú, thì niềm tin không tự động trở nên phong phú theo.
Đó là lý do tại sao @OpenGradient khiến mình suy nghĩ ít hơn về khả năng AI và nhiều hơn về độ tin cậy của AI. Không phải vì mình biết đó là hướng mà thị trường đang đi, mà vì đó là một câu hỏi có vẻ như chưa được khám phá nhiều.
Có thể nút thắt tương lai không phải là tạo ra trí tuệ.
Có thể nó là việc chứng minh nguồn gốc của trí tuệ.
#opg $OPG
@OpenGradient
Mỗi khi một dự án AI mới thu hút sự chú ý, cuộc trò chuyện nhanh chóng chuyển sang cuộc đua tìm ai có nhiều sức mạnh tính toán nhất, mô hình lớn nhất, hoặc cơ sở hạ tầng mạnh mẽ nhất. Giả định rất đơn giản: ai có thể lưu trữ nhiều trí tuệ hơn thì sẽ thắng.
Có lẽ đó là kết luận đầu tiên mà hầu hết mọi người đạt được khi nhìn vào @OpenGradient .
Nhưng càng suy nghĩ lâu, mình càng không chắc chắn rằng việc lưu trữ trí tuệ là vấn đề khó khăn nhất.
Hãy tưởng tượng một tương lai mà các tác nhân AI hiện diện khắp nơi. Các tác nhân nghiên cứu, tác nhân giao dịch, tác nhân hỗ trợ khách hàng, phần mềm tự động. Việc tạo ra thông tin trở nên rẻ và liên tục. Các đầu ra tràn ngập mọi ngóc ngách của internet.
Bây giờ hãy đặt một câu hỏi khác.
Làm sao bạn biết một đầu ra thực sự đến từ mô hình, tác nhân, hoặc hệ thống mà nó tuyên bố đã sản xuất ra?
Điều đó nghe có vẻ như một chi tiết nhỏ hôm nay, nhưng có thể trở thành một lớp kinh tế quan trọng vào ngày mai. Nếu trí tuệ trở nên phong phú, thì niềm tin không tự động trở nên phong phú theo.
Đó là lý do tại sao @OpenGradient khiến mình suy nghĩ ít hơn về khả năng AI và nhiều hơn về độ tin cậy của AI. Không phải vì mình biết đó là hướng mà thị trường đang đi, mà vì đó là một câu hỏi có vẻ như chưa được khám phá nhiều.
Có thể nút thắt tương lai không phải là tạo ra trí tuệ.
Có thể nó là việc chứng minh nguồn gốc của trí tuệ.
#opg $OPG
@OpenGradient