
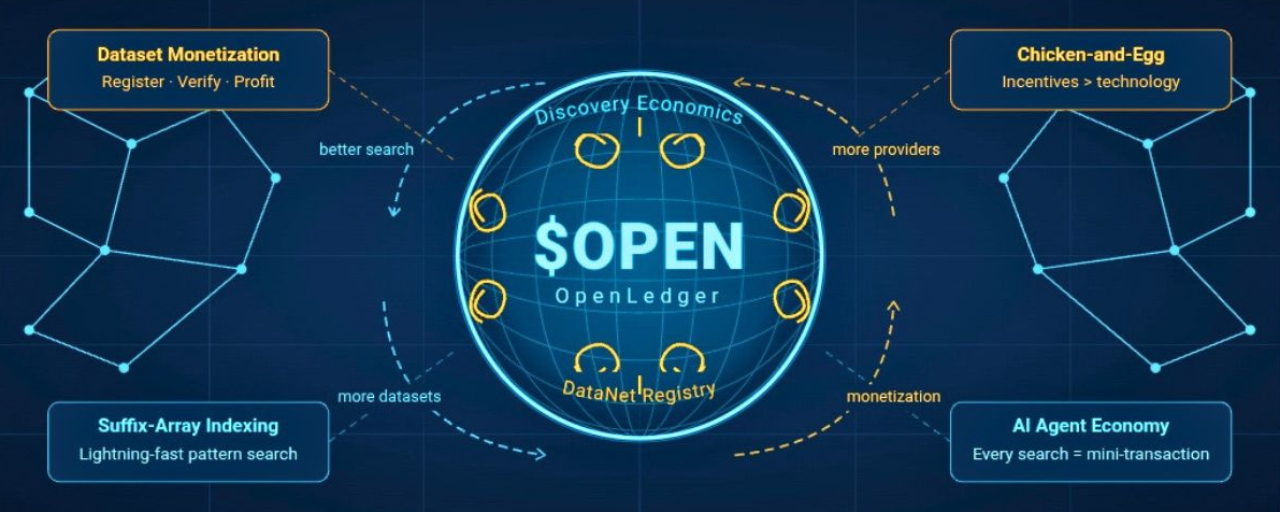


Lần đầu tiên tôi mở DataNet Registry của OpenLedger, tôi đã mong đợi một câu chuyện hạ tầng AI khác. Thay vào đó, nó khiến tôi suy nghĩ về cơ sở dữ liệu.
Thường thì khi mọi người nói về hạ tầng AI, bạn sẽ nghe về các mô hình. Mô hình lớn hơn. Phân tích nhanh hơn. Kết quả ấn tượng hơn. Nhưng điều thực sự quyết định một hệ thống AI thành công hay không không phải là các mô hình; mà là cách bạn tổ chức dữ liệu bên trong.
Sự khác biệt, ít nhất là từ những gì tôi thấy, là sự tập trung của OpenLedger vào việc khám phá - không chỉ là lưu trữ.
Không phải dữ liệu thực sự. Chỉ… cách bạn tìm ra nó.
Khoảng cách này chạm vào thực tế mạnh hơn nhiều người tưởng.
Càng nhìn kỹ thì tôi càng thấy nó giống “Discovery Economics”—ý tưởng rằng việc tìm dữ liệu có thể trở nên có giá trị hơn việc lưu trữ nó.
Thứ thật sự khiến tôi bị cuốn hút là việc lập chỉ mục kiểu mảng hậu tố (suffix-array) được nhúng thẳng vào kiến trúc của họ. Nếu trước đây bạn chưa từng “làm nerd” với suffix array, thì tôi đã gặp chúng từ nhiều năm trước khi bày trò với tối ưu hóa tìm kiếm. Cốt lõi rất đơn giản, nhưng cũng hơi điên—nó cho phép bạn tổ chức thông tin để việc tìm mẫu khớp “tự bật” vào đúng vị trí, cực nhanh như chớp.
Nghe có vẻ kỹ thuật, đúng không—nhưng tác động thực sự lại là kinh tế.
Bởi vì khi những tác nhân AI bắt đầu chạy nhảy tự thân, mọi lần tìm kiếm đều biến thành một giao dịch mini. Mỗi giây thêm dành cho việc tìm kiếm đều là ma sát. Mỗi lần tra cứu cụt hứng? Tính toán rỗng, năng lượng bị lãng phí. Khi các tác nhân bắt đầu đưa ra quyết định ở quy mô lớn, những thiếu hiệu quả nhỏ này bắt đầu chồng chất như điên.
Đó là lúc DataNet Registry trở nên đáng chú ý với tôi.
Thay vì chỉ vứt các bộ dữ liệu lên internet như những tệp tĩnh, nó đối xử với chúng như những tài sản mà bạn có thể tìm thấy và thậm chí kiếm tiền. Hệ thống không chỉ nhét chúng vào một ngăn kéo—nó cung cấp các “đường ray” có cấu trúc để đăng ký, xác minh, tìm kiếm và có thể cả thu lợi từ dữ liệu. Tất cả đều dưới một mái nhà.
Tối ưu hiệu quả tìm kiếm giúp tăng năng suất của tác nhân. Tác nhân càng năng suất thì càng tiêu thụ nhiều bộ dữ liệu hơn. Việc sử dụng dữ liệu nhiều tạo ra cơ hội kiếm tiền, và cơ hội đó thu hút thêm nhà cung cấp, đồng thời củng cố mạng lưới. Đó là logic cơ bản đằng sau thứ mà tôi bắt đầu nghĩ như một “Discovery Economics” (Kinh tế của Khả năng Khám phá).
Nói thật, nếu nhìn lại thì các lớp “khám phá” có xu hướng lấn át phần nội dung thực. Công cụ tìm kiếm to hơn trang web. Các cửa hàng ứng dụng vượt trội so với hầu hết ứng dụng cá nhân. Thị trường thắng vì nó giảm bớt rắc rối khi ghép đúng thứ người ta cần với thứ người ta cung cấp.
Tôi cứ nghĩ mãi—liệu chuyện đó có thể xảy ra với cả các bộ dữ liệu cho AI không? Đặc biệt là khi mọi thứ đang dịch chuyển theo cách như bây giờ.
Bạn cảm thấy thị trường đang trượt quay lại câu chuyện về hạ tầng. AI được đưa lên sân khấu, không phải nghi ngờ gì, nhưng nhà đầu tư có vẻ lại bị ám ảnh nhiều hơn bởi đường ống và hệ thống cấp thoát vận hành nó, chứ không chỉ là các mô hình bắt mắt. Crypto cũng đã có những lần xoay vòng như vậy: trước tiên là sự phấn khích điên cuồng về ứng dụng… rồi ai cũng đuổi theo những “đường ray” nằm bên dưới.
Đôi khi? Giai đoạn thứ hai lại “vơ” được nhiều giá trị hơn giai đoạn đầu.
Nhưng các mạng dữ liệu gặp phải một vấn đề “khởi động nguội” khó chịu. Một sổ đăng ký chỉ hoạt động khi có đủ những bộ dữ liệu “ngon” nằm bên trong. Và những bộ dữ liệu “ngon” chỉ xuất hiện khi việc khám phá và kiếm tiền từ chúng đã chạy trơn tru.
Hoàn toàn kiểu “gà và trứng”.
Crypto cứ mãi vấp vào chuyện này. Dù là pool thanh khoản, mạng oracle, hay lưu trữ phi tập trung—tất cả đều đụng vào những biến thể của cùng một cơn đau đầu.
Điều quan trọng hơn cả công nghệ chính là các động lực khuyến khích.
Sổ đăng ký tuyệt vời? Không có nghĩa là mọi người sẽ ào vào. Người ta cần lý do thực sự để chia sẻ dữ liệu, giữ cho dữ liệu sạch, và tin tưởng vào hệ thống. Nếu không, bạn sẽ mắc kẹt với một kệ trưng bày sang xịn cho… thông tin rác—a một thị trấn ma kỹ thuật số.
Thành thật mà nói, đây là phần tôi vẫn đang vật lộn.
Kiến trúc thì hay đấy—nó kết hợp khoa học máy tính kiểu cũ với các “công thức” động lực từ blockchain mới. Nhưng lịch sử cứ nhắc tôi nhớ mãi: sự xuất sắc về kỹ thuật và tính bền vững ngoài đời thật không phải lúc nào cũng đi cùng nhau.
Có lẽ tia lửa thật sự không nằm ở phép màu lập chỉ mục, mà là biến khả năng khám phá thành một động lực kinh tế “bẩm sinh” cho AI.
Hoặc có thể—thực ra chỉ là khói và gương.
Cảm giác là chúng ta còn ở giai đoạn đầu, thật lòng mà nói. Khó biết đâu là hạ tầng thật sự và đâu chỉ là một câu chuyện khoác áo hạ tầng.
Cơ chế kinh tế chỉ hoạt động nếu chất lượng bộ dữ liệu tăng theo cùng với số lượng. Chỉ tăng trưởng thôi thì chưa đủ.
Có lẽ đó chính là thứ “Discovery Economics” đang thực sự thử nghiệm—không phải liệu dữ liệu có giá trị hay không, mà liệu khả năng khám phá có thể trở thành một thị trường của riêng nó.
Nếu khả năng khám phá trở thành một lớp kinh tế riêng, thì DataNet Registry có thể sẽ quan trọng hơn chính những bộ dữ liệu. Còn nếu không, nó chỉ là một sổ đăng ký khác mà chẳng ai dùng.
#OpenLedger @OpenLedger $OPEN
