



Tổ chức & biên soạn: Sunny, Shenchao TechFlow
Giao thức điện toán Blockchain AI Gensyn đã thông báo vào ngày 12 tháng 6 rằng họ đã hoàn thành khoản tài trợ Series A trị giá 43 triệu đô la do a16z dẫn đầu.
Sứ mệnh của Gensyn là cung cấp cho người dùng quyền truy cập vào quy mô điện toán tương đương với việc sở hữu một cụm máy tính riêng và quan trọng nhất là đạt được quyền truy cập công bằng để tránh bị bất kỳ thực thể trung tâm nào kiểm soát hoặc tắt máy. Trong khi đó, Gensyn là một giao thức điện toán phi tập trung tập trung vào việc đào tạo các mô hình machine learning.
Nhìn lại podcast của người sáng lập Gensyn, Harry và Ben với Epicenter vào cuối năm ngoái, bạn có thể thấy rằng họ đã thảo luận sâu sắc về việc điều tra các tài nguyên máy tính, bao gồm AWS, cơ sở hạ tầng cục bộ và cơ sở hạ tầng đám mây, để hiểu cách tối ưu hóa và sử dụng các tài nguyên này để hỗ trợ phát triển các ứng dụng AI.
Đồng thời, họ cũng thảo luận chi tiết về triết lý thiết kế, mục tiêu và định vị thị trường của Gensyn, cũng như các ràng buộc, giả định và chiến lược thực hiện khác nhau phải đối mặt trong quá trình thiết kế.
Podcast giới thiệu bốn vai trò chính trong mạng ngoài chuỗi Gensyn, khám phá các đặc điểm của mạng trên chuỗi Gensyn cũng như tầm quan trọng của mã thông báo Gensyn và quản trị.
Ngoài ra, Ben và Harry còn chia sẻ một số kiến thức khoa học AI thú vị để mọi người hiểu sâu hơn về nguyên lý cơ bản và ứng dụng của trí tuệ nhân tạo.
Người dẫn chương trình: Tiến sĩ Friederike Ernst, Epicenter Podcast
Diễn giả: Ben Fielding & Harry Grieve, Đồng sáng lập Gensyn
Tựa gốc: "Ben Fielding & Harry Grieve: Gensyn – The Deep Learning Computing Protocol"
Ngày phát sóng: 24/11/2022
Blockchain như một lớp tin cậy cho cơ sở hạ tầng AI phi tập trung
Người dẫn chương trình hỏi Ben và Harry tại sao họ lại kết hợp kinh nghiệm phong phú của mình về AI và deep learning với blockchain?
Ben cho biết quyết định của họ không được đưa ra trong một sớm một chiều mà sau một khoảng thời gian tương đối dài. Mục tiêu của Gensyn là xây dựng cơ sở hạ tầng AI quy mô lớn và trong khi nghiên cứu cách đạt được khả năng mở rộng tối đa, họ nhận ra rằng cần có một lớp không tin cậy.
Họ cần có khả năng củng cố khả năng tính toán mà không cần dựa vào việc triển khai tập trung các nhà cung cấp mới hoặc gặp phải các hạn chế về mở rộng quản trị. Để giải quyết vấn đề này, họ bắt đầu khám phá nghiên cứu tính toán có thể kiểm chứng được, nhưng họ nhận thấy rằng việc này luôn yêu cầu một bên thứ ba hoặc thẩm phán đáng tin cậy kiểm tra tính toán.
Hạn chế này đã dẫn họ đến với blockchain. Blockchain cung cấp một cách để phá vỡ nhu cầu về một người ra quyết định hoặc trọng tài duy nhất vì nó cho phép sự đồng thuận giữa các nhóm lớn.
Harry cũng chia sẻ triết lý của mình rằng anh và Ben ủng hộ mạnh mẽ quyền tự do ngôn luận và lo ngại về việc kiểm duyệt.
Trước khi chuyển sang blockchain, họ đã xem xét học tập liên kết, một lĩnh vực học sâu nơi bạn đào tạo nhiều mô hình trên các nguồn dữ liệu phân tán và sau đó kết hợp chúng lại với nhau để tạo ra một siêu mô hình có thể học từ tất cả các nguồn dữ liệu. Họ làm việc với các ngân hàng về cách tiếp cận này. Tuy nhiên, họ sớm nhận ra rằng vấn đề lớn hơn là có được tài nguyên máy tính hoặc bộ xử lý có thể đào tạo các mô hình này.
Để tối đa hóa việc tích hợp các tài nguyên máy tính, họ cần một phương pháp phối hợp phi tập trung, đó là lúc blockchain xuất hiện.
Khảo sát tài nguyên điện toán thị trường: AWS, Cơ sở hạ tầng tại chỗ và Cơ sở hạ tầng đám mây
Harry giải thích các tùy chọn tài nguyên máy tính khác nhau để chạy các mô hình AI, tùy thuộc vào kích thước mô hình.
Sinh viên có thể sử dụng AWS hoặc máy tại chỗ, các công ty khởi nghiệp có thể chọn AWS theo yêu cầu hoặc các tùy chọn rẻ hơn theo lịch trình.
Nhưng đối với nhu cầu GPU quy mô lớn, AWS có thể bị giới hạn bởi chi phí và khả năng mở rộng và thường chọn xây dựng cơ sở hạ tầng nội bộ.
Nghiên cứu cho thấy nhiều tổ chức đang gặp khó khăn trong việc mở rộng quy mô, một số thậm chí còn chọn tự mua và quản lý GPU. Nhìn chung, việc mua GPU về lâu dài sẽ tiết kiệm chi phí hơn so với việc chạy GPU trên AWS.
Các tùy chọn cho tài nguyên máy tính học máy bao gồm điện toán đám mây, chạy mô hình AI cục bộ hoặc xây dựng cụm máy tính của riêng bạn. Mục tiêu của Gensyn là cung cấp quyền truy cập vào cùng quy mô điện toán như có cụm riêng và điều quan trọng là đạt được quyền truy cập công bằng, quyền truy cập này không thể bị kiểm soát hoặc tắt bởi bất kỳ thực thể trung tâm nào.
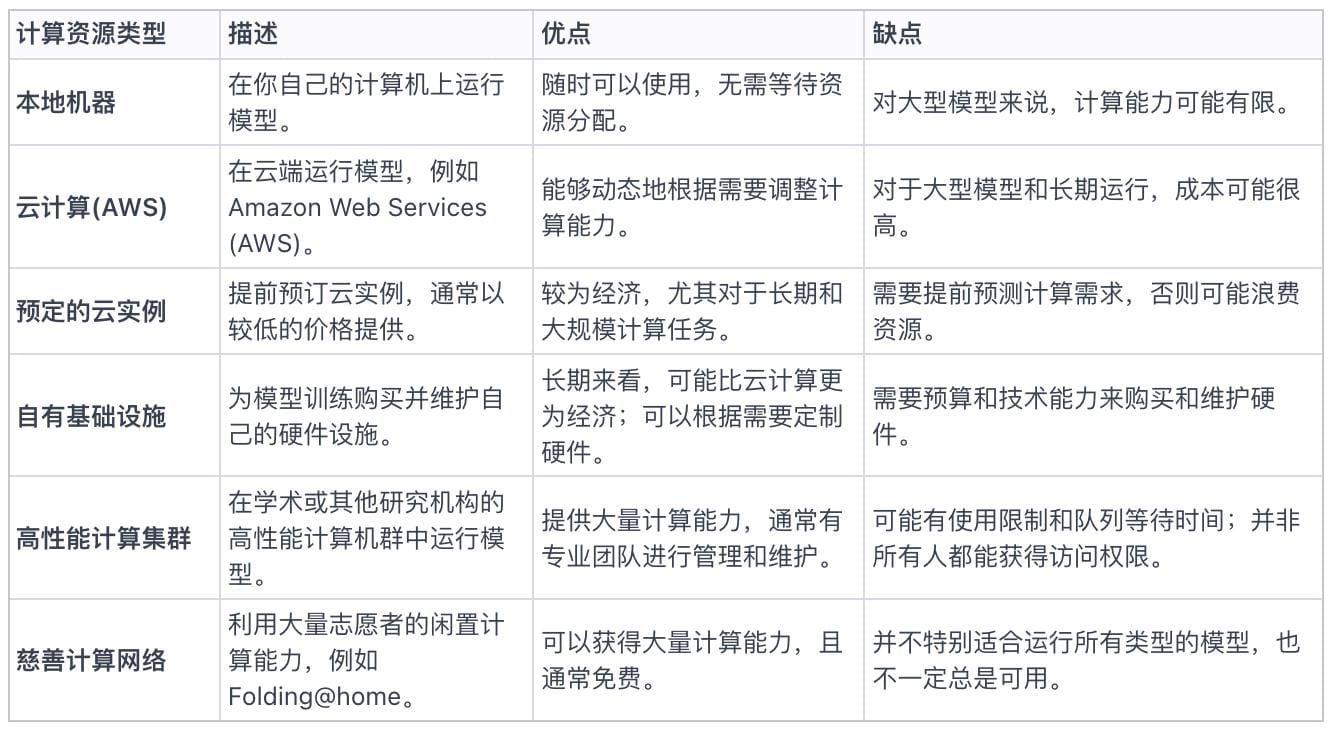
Bảng 1: Tất cả các tùy chọn tài nguyên máy tính hiện có trên thị trường
Thảo luận về triết lý thiết kế, mục tiêu và định vị thị trường của Gensyn
Người dẫn chương trình đã hỏi Gensyn khác với các dự án điện toán blockchain trước đây như thế nào, chẳng hạn như Golem Network.
Harry giải thích rằng triết lý thiết kế của Gensyn chủ yếu được xem xét theo hai trục:
Mức độ chi tiết của giao thức: Không giống như các giao thức điện toán có mục đích chung như Golem, Gensyn là một giao thức chi tiết tập trung vào việc đào tạo các mô hình học máy.
Khả năng mở rộng đã được xác minh: Các dự án ban đầu thường dựa vào danh tiếng hoặc các phương pháp sao chép ít chấp nhận lỗi Byzantine hơn, không đủ tin cậy vào kết quả học máy. Gensyn đặt mục tiêu tận dụng những kiến thức học được từ các giao thức tính toán trong thế giới tiền điện tử và áp dụng chúng cụ thể vào học máy để tối ưu hóa tốc độ và chi phí trong khi vẫn đảm bảo mức độ xác minh thỏa đáng.
Harry nói thêm rằng khi xem xét bản chất của những gì mạng phải làm, nó cần nhắm vào các kỹ sư và nhà nghiên cứu máy học. Nó cần phải có một thành phần xác minh, nhưng điều quan trọng là nó cần phải có khả năng chống kiểm duyệt và trung lập về phần cứng để cho phép mọi người tham gia.
Các ràng buộc, giả định và thực hiện trong quá trình thiết kế
Trong quá trình thiết kế nền tảng của Gensyn, Ben nhấn mạnh tầm quan trọng của các ràng buộc và giả định về hệ thống. Mục tiêu của họ là tạo ra một mạng lưới có thể biến toàn bộ thế giới thành siêu máy tính AI và để làm được điều đó, họ cần tìm ra sự cân bằng giữa các giả định về sản phẩm, giả định nghiên cứu và giả định về công nghệ.
Lý do họ xây dựng Gensyn làm blockchain lớp đầu tiên của riêng mình là để duy trì tính linh hoạt cao hơn và quyền tự do ra quyết định trong các lĩnh vực kỹ thuật quan trọng như cơ chế đồng thuận. Họ muốn có khả năng đảm bảo giao thức của mình trong tương lai và không muốn áp đặt những hạn chế không cần thiết trong giai đoạn đầu của dự án. Hơn nữa, họ tin rằng trong tương lai, các chuỗi sẽ có thể tương tác thông qua giao thức nhắn tin được chấp nhận rộng rãi, vì vậy quyết định của họ phù hợp với tầm nhìn này.
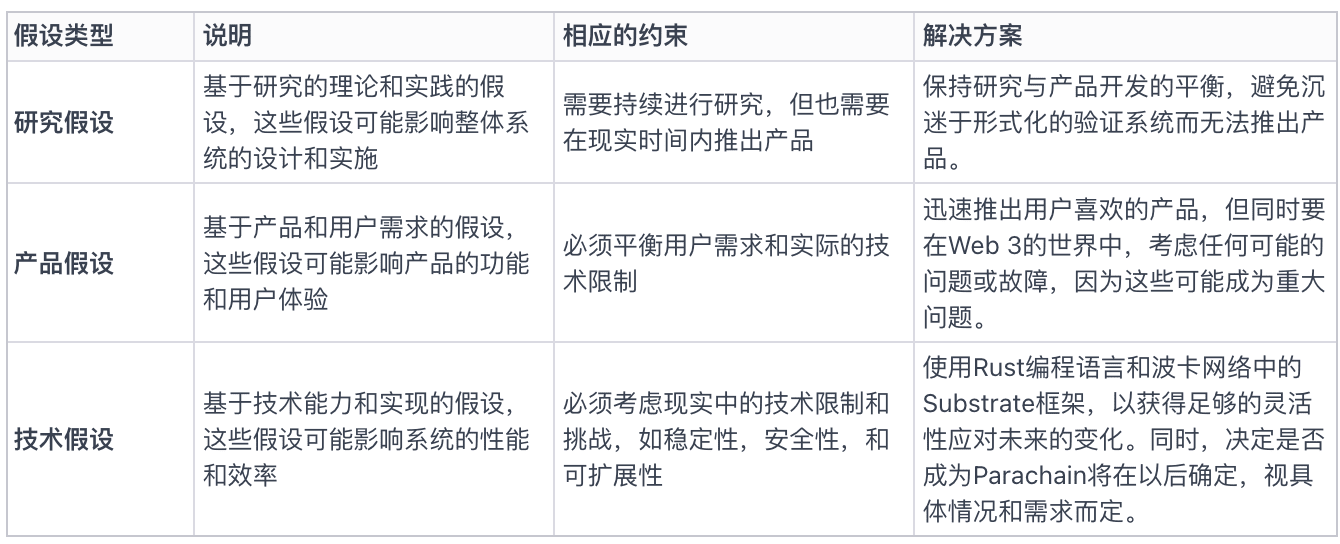
Hình 2: Giả định về sản phẩm, giả định nghiên cứu và giả định về công nghệ, hạn chế và cách thực hiện
Bốn tác nhân chính trong mạng lưới ngoài chuỗi Gensyn
Trong cuộc thảo luận về nền kinh tế Gensyn này, bốn vai trò chính được giới thiệu: người ủy quyền, người lao động, người xác nhận và người tố cáo. Người gửi có thể gửi nhiều vấn đề khác nhau tới mạng Gensyn, bao gồm tạo hình ảnh cụ thể hoặc phát triển mô hình AI có thể lái ô tô.
Người nộp nộp nhiệm vụ
Harry giải thích cách sử dụng Gensyn để đào tạo người mẫu. Trước tiên, người dùng xác định kết quả mong muốn, chẳng hạn như tạo hình ảnh dựa trên lời nhắc văn bản, sau đó xây dựng mô hình lấy lời nhắc văn bản làm đầu vào và tạo hình ảnh tương ứng. Dữ liệu đào tạo rất quan trọng cho việc học tập và cải tiến mô hình. Sau khi chuẩn bị kiến trúc mô hình và dữ liệu đào tạo, người dùng sẽ gửi chúng đến mạng Gensyn cùng với các siêu tham số như lịch trình tốc độ học tập và thời gian đào tạo. Kết quả của quá trình đào tạo này là một mô hình được đào tạo mà người dùng có thể lưu trữ và sử dụng.
Khi được hỏi cách chọn một người mẫu chưa qua đào tạo, Harry đề xuất hai phương pháp.
Đầu tiên dựa trên khái niệm mô hình cơ bản phổ biến hiện nay, trong đó các công ty lớn như OpenAI hay Midjourney sẽ xây dựng một mô hình cơ bản và sau đó người dùng có thể đào tạo mô hình cơ bản trên dữ liệu cụ thể.
Tùy chọn thứ hai là xây dựng mô hình từ đầu, trái ngược với cách tiếp cận mô hình cơ sở.
Trong Gensyn, các nhà phát triển có thể gửi nhiều kiến trúc khác nhau để đào tạo và thử nghiệm bằng các phương pháp tương tự như tối ưu hóa tiến hóa và liên tục tối ưu hóa để xây dựng mô hình mong muốn.
Ben cung cấp cái nhìn sâu sắc về mô hình cơ bản từ quan điểm của họ mà họ tin rằng đó là tương lai của lĩnh vực này.
Gensyn là một giao thức, chúng tôi hy vọng nó có thể được sử dụng bởi các DApp để triển khai các kỹ thuật tối ưu hóa tiến hóa hoặc các phương pháp tương tự. Các DApp này có thể gửi các kiến trúc riêng lẻ tới giao thức Gensyn để đào tạo và thử nghiệm, đồng thời xây dựng mô hình lý tưởng thông qua sàng lọc lặp đi lặp lại.
Mục tiêu của Gensyn là cung cấp nền tảng điện toán học máy thuần túy và khuyến khích sự phát triển của hệ sinh thái xung quanh nó.
Mặc dù các mô hình được đào tạo trước có thể gây ra sự thiên vị vì các tổ chức có thể sử dụng bộ dữ liệu độc quyền hoặc giữ lại thông tin về quy trình đào tạo, giải pháp của Gensyn là mở rộng quy trình đào tạo thay vì loại bỏ hộp đen hoặc dựa vào thuyết xác định hoàn toàn. Bằng cách cùng nhau thiết kế và đào tạo các mô hình cơ sở, chúng tôi có thể tạo ra các mô hình toàn cầu mà không bị sai lệch bởi bất kỳ tập dữ liệu của công ty cụ thể nào.
Bộ giải
Để phân phối nhiệm vụ, một nhiệm vụ tương ứng với một máy chủ. Nhưng một mô hình có thể được chia thành nhiều nhiệm vụ.
Các mô hình ngôn ngữ lớn được thiết kế để tận dụng tối đa dung lượng phần cứng sẵn có vào thời điểm đó. Khái niệm này có thể được mở rộng sang các mạng để xem xét tính không đồng nhất của thiết bị.
Đối với các nhiệm vụ cụ thể, chẳng hạn như người xác thực hoặc nhân viên, có một tùy chọn để tiếp quản từ Mempool. Một công nhân được chọn ngẫu nhiên trong số những người thể hiện sự sẵn sàng đảm nhận nhiệm vụ. Nếu mô hình và dữ liệu không thể được điều chỉnh cho phù hợp với một thiết bị cụ thể, nhưng chủ sở hữu thiết bị khẳng định điều đó có thể, thì có thể bị phạt do tắc nghẽn hệ thống.
Liệu một tác vụ có thể chạy trên máy hay không được xác định bởi một hàm ngẫu nhiên có thể kiểm chứng để chọn một công nhân từ một tập hợp con các công nhân có sẵn.
Về vấn đề xác minh năng lực của người lao động, nếu người lao động không có khả năng tính toán như đã công bố thì sẽ không thể hoàn thành nhiệm vụ tính toán và sẽ bị phát hiện khi gửi bằng chứng.
Tuy nhiên, quy mô của nhiệm vụ là một vấn đề. Nếu nhiệm vụ được đặt quá lớn, điều này có thể dẫn đến các sự cố hệ thống, chẳng hạn như tấn công từ chối dịch vụ (DoS), trong đó nhân viên yêu cầu hoàn thành nhiệm vụ nhưng không bao giờ hoàn thành, gây lãng phí thời gian và tài nguyên.
Do đó, việc quyết định quy mô nhiệm vụ là rất quan trọng và cần phải tính đến các yếu tố như sự song song hóa và cấu trúc nhiệm vụ được tối ưu hóa. Các nhà nghiên cứu đang tích cực nghiên cứu và khám phá những phương pháp tốt nhất dựa trên những hạn chế khác nhau.
Sau khi mạng thử nghiệm được khởi chạy, các điều kiện thực tế cũng sẽ được xem xét để quan sát cách hệ thống vận hành trong thế giới thực.
Việc xác định quy mô nhiệm vụ hoàn hảo có thể là một thách thức và Gensyn sẵn sàng điều chỉnh và cải thiện dựa trên trải nghiệm và phản hồi trong thế giới thực.
Cơ chế xác minh và điểm kiểm tra cho các tính toán quy mô lớn trên chuỗi
Harry và Ben đã chỉ ra rằng việc xác minh tính đúng đắn của một phép tính là một thách thức quan trọng vì nó không mang tính quyết định như hàm băm, do đó không thể chỉ xác minh bằng cách băm xem một phép tính có được thực hiện hay không. Để giải quyết vấn đề này, giải pháp lý tưởng là sử dụng ứng dụng chứng minh không có kiến thức cho toàn bộ quá trình tính toán. Hiện tại, Gensyn vẫn đang nỗ lực triển khai khả năng này.
Hiện tại, Gensyn giới thiệu một phương pháp kết hợp sử dụng điểm kiểm tra để xác minh các phép tính học máy thông qua cơ chế xác suất và điểm kiểm tra. Bằng cách kết hợp sơ đồ kiểm toán ngẫu nhiên với đường dẫn không gian gradient, có thể thiết lập một kiểm tra tương đối mạnh mẽ. Ngoài ra, bằng chứng không có kiến thức được giới thiệu để tăng cường quá trình xác minh và áp dụng cho việc mất mô hình trên toàn cầu.
Người xác minh và người tố cáo
Người điều hành và Harry đã thảo luận về hai vai trò bổ sung liên quan đến quá trình xác minh: người xác minh và người tố cáo. Họ trình bày chi tiết về trách nhiệm và vai trò cụ thể của hai vai trò này.
Nhiệm vụ của người xác thực là đảm bảo tính chính xác của các điểm kiểm tra, trong khi nhiệm vụ của người tố giác là đảm bảo tính chính xác mà người xác thực thực hiện nhiệm vụ của mình. Người tố cáo giải quyết vấn đề nan giải của người xác thực, đảm bảo rằng công việc của người xác thực là chính xác và đáng tin cậy. Người xác minh cố tình đưa sai sót vào công việc của họ và vai trò của người tố giác là xác định và vạch trần những sai sót này, từ đó đảm bảo tính toàn vẹn của quy trình xác minh.
Người xác minh cố tình đưa ra các sai sót để kiểm tra mức độ cảnh giác của người tố giác và đảm bảo tính hiệu quả của hệ thống. Nếu có lỗi trong công việc, người xác nhận sẽ phát hiện lỗi và thông báo cho người báo cáo. Lỗi sau đó được ghi lại trên blockchain và được xác minh trên chuỗi. Theo định kỳ và ở mức độ phù hợp với tính bảo mật của hệ thống, người xác thực cố tình đưa ra các lỗi để thu hút người tố cáo. Nếu người tố cáo phát hiện ra vấn đề, họ sẽ tham gia vào một trò chơi gọi là "giao thức xác định", qua đó họ có thể thu hẹp phép tính đến một điểm cụ thể trong cây Merkle của một vùng cụ thể của mạng lưới thần kinh. Thông tin này sau đó được gửi tới trọng tài trực tuyến. Đây là phiên bản đơn giản hóa của quy trình dành cho người xác nhận và người tố cáo, những người sẽ tiến hành nghiên cứu và phát triển thêm sau vòng hạt giống.
Mạng trên chuỗi Gensyn
Ben và Harry đã thảo luận chi tiết về cách thức hoạt động của giao thức phối hợp Gensyn trên chuỗi và các chi tiết triển khai. Đầu tiên, họ đề cập đến quá trình xây dựng các khối mạng, bao gồm việc đặt mã thông báo như một phần của mạng đặt cược đó. Sau đó, họ giải thích cách các thành phần này liên quan đến giao thức Gensyn.
Ben giải thích rằng giao thức Gensyn phần lớn là giao thức mạng Polkadot nền vanilla. Họ áp dụng cơ chế đồng thuận Grandpa Babe dựa trên bằng chứng cổ phần và những người xác nhận hoạt động theo cách thông thường. Tuy nhiên, tất cả các thành phần máy học được giới thiệu trước đây đều diễn ra ngoài chuỗi, liên quan đến nhiều tác nhân ngoài chuỗi khác nhau thực hiện các nhiệm vụ tương ứng của họ.
Những người tham gia này được khuyến khích bằng cách đặt cược, thông qua phần đặt cược trong Chất nền hoặc bằng cách gửi một số lượng mã thông báo cụ thể trong hợp đồng thông minh. Khi công việc của họ cuối cùng được xác minh, họ sẽ được khen thưởng.
Thử thách được Ben và Harry đề cập là đảm bảo sự cân bằng giữa số tiền đặt cược, số tiền có thể giảm và số tiền thưởng nhằm ngăn chặn việc tạo ra động cơ cho hành vi lười biếng hoặc độc hại.
Ngoài ra, họ còn thảo luận về sự phức tạp đi kèm với việc bổ sung thêm người tố cáo, nhưng sự hiện diện của họ rất quan trọng để đảm bảo tính trung thực của người xác minh do nhu cầu tính toán mở rộng quy mô. Trong khi họ tiếp tục khám phá những cách có khả năng loại bỏ những người tố cáo thông qua công nghệ chứng minh không có kiến thức. Họ tuyên bố rằng hệ thống hiện tại phù hợp với những gì được mô tả trong bản rút gọn, nhưng họ đang tích cực làm việc để đơn giản hóa mọi khía cạnh.
Người điều hành hỏi liệu họ có loại giải pháp nào đó về tính khả dụng của dữ liệu hay không và Henry giải thích rằng họ đã giới thiệu một lớp trên bề mặt được gọi là bằng chứng về tính khả dụng (POA). Lớp này sử dụng các công nghệ như mã hóa xóa để giải quyết những hạn chế mà chúng gặp phải trong thị trường cấp lưu trữ rộng. Họ cho biết họ sẽ rất quan tâm đến các nhà phát triển đã triển khai giải pháp như vậy.
Ben nói thêm rằng nhu cầu của họ không chỉ liên quan đến việc lưu trữ dữ liệu đào tạo mà còn cả dữ liệu chứng minh trung gian không yêu cầu lưu trữ lâu dài. Ví dụ: họ có thể chỉ cần giữ khoảng 20 giây khi xuất bản xong một số khối nhất định. Tuy nhiên, phí lưu trữ mà họ hiện phải trả trên Arweave kéo dài hàng trăm năm và không cần thiết cho những nhu cầu ngắn hạn này. Họ đang tìm kiếm một giải pháp có sự đảm bảo và tính năng của Arweave đồng thời đáp ứng nhu cầu lưu trữ ngắn hạn của họ với chi phí thấp hơn.
Gensyn Token và quản trị
Ben giải thích tầm quan trọng của mã thông báo gensyn trong hệ sinh thái, đóng vai trò chính trong việc đặt cược, trừng phạt, trao phần thưởng và duy trì sự đồng thuận. Mục đích chính của nó là đảm bảo tính lành mạnh tài chính và tính toàn vẹn của hệ thống. Ben cũng đề cập đến việc sử dụng cẩn thận tỷ lệ lạm phát để trả tiền cho người xác nhận và tận dụng các cơ chế lý thuyết trò chơi.
Ông nhấn mạnh việc sử dụng mã thông báo Gensyn thuần túy về mặt kỹ thuật và nói rằng về mặt kỹ thuật họ sẽ đảm bảo về thời gian và sự cần thiết của việc giới thiệu mã thông báo Gensyn.
Harry cho biết họ thuộc nhóm thiểu số trong cộng đồng deep learning, đặc biệt là trong bối cảnh các học giả AI ngày càng hoài nghi về tiền điện tử. Tuy nhiên, họ nhận ra giá trị của cả khía cạnh kỹ thuật và ý thức hệ của tiền điện tử.
Tuy nhiên, khi mạng ra mắt, họ dự đoán rằng hầu hết người dùng deep learning sẽ chủ yếu giao dịch bằng cách sử dụng tiền tệ fiat và việc chuyển đổi sang token sẽ diễn ra liền mạch sau hậu trường.
Về phía cung, người lao động và người cam kết sẽ tích cực tham gia vào việc giao dịch token và họ đã nhận được sự quan tâm từ những người khai thác Ethereum, những người có tài nguyên GPU đáng kể và đang tìm kiếm cơ hội mới.
Ở đây, điều quan trọng là phải đảm bảo rằng những người thực hành học máy và học sâu lo sợ về thuật ngữ tiền điện tử (chẳng hạn như mã thông báo), tách nó ra khỏi giao diện trải nghiệm người dùng. Gensyn cho biết đây là một trường hợp sử dụng thú vị giúp kết nối thế giới Web 2 và Web 3 vì nó có ý nghĩa kinh tế và công nghệ cần thiết để hỗ trợ sự tồn tại của nó.
Khoa học phổ biến Trí tuệ nhân tạo
AI, học sâu và học máy
Ben chia sẻ quan điểm của mình về sự phát triển của lĩnh vực AI trong những năm gần đây. Ông tin rằng mặc dù lĩnh vực AI và học máy đã trải qua một loạt vụ nổ nhỏ trong bảy năm qua, nhưng những tiến bộ hiện tại dường như đang tạo ra tác động thực sự và các ứng dụng có giá trị, thu hút được nhiều đối tượng hơn. Học sâu là động lực cơ bản của những thay đổi này. Mạng lưới thần kinh sâu đã chứng tỏ khả năng vượt qua các tiêu chuẩn được đặt ra bởi các phương pháp thị giác máy tính truyền thống. Ngoài ra, các mẫu như GPT-3 đã đẩy nhanh tiến độ này.
Harry giải thích thêm về sự khác biệt giữa AI, học máy và học sâu. Ông tin rằng ba thuật ngữ này thường được sử dụng thay thế cho nhau, nhưng chúng có những khác biệt đáng kể. Ông nói một cách ẩn dụ rằng AI, machine learning và deep learning giống như những con búp bê matryoshka của Nga, trong đó AI là lớp ngoài cùng.
Nói rộng ra, AI đề cập đến việc lập trình các máy móc để thực hiện các nhiệm vụ.
Học máy, trở nên phổ biến vào những năm 1990 và đầu những năm 2000, sử dụng dữ liệu để xác định xác suất đưa ra quyết định thay vì dựa vào hệ thống chuyên gia với quy tắc nếu-thì.
Học sâu được xây dựng dựa trên học máy nhưng cho phép tạo ra các mô hình phức tạp hơn.
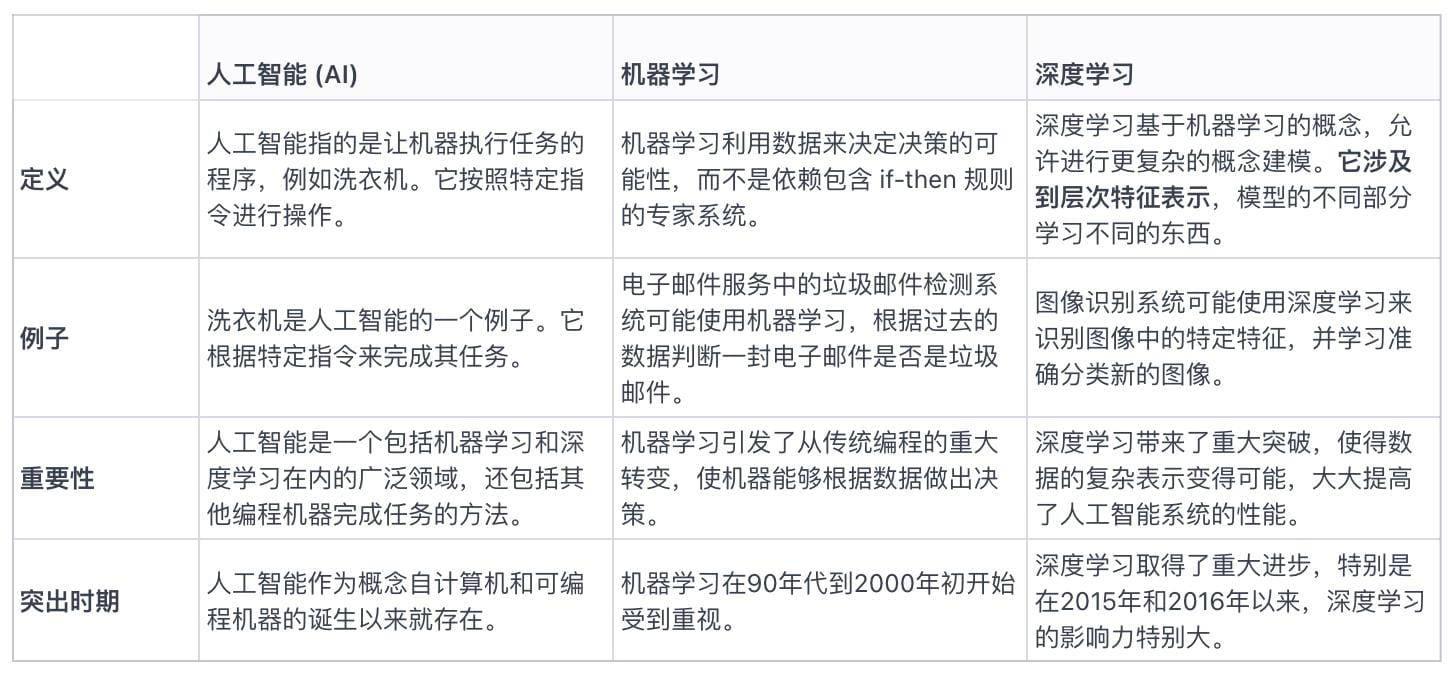
Hình 3: Sự khác biệt giữa trí tuệ nhân tạo, học máy và học sâu
Trí tuệ nhân tạo hẹp, trí tuệ nhân tạo tổng hợp, trí tuệ siêu nhân tạo
Trong phân khúc này, chủ nhà và khách cung cấp cái nhìn sâu sắc về ba lĩnh vực chính của trí tuệ nhân tạo: trí tuệ nhân tạo hẹp (ANI), trí tuệ nhân tạo tổng hợp (AGI) và siêu trí tuệ nhân tạo (ASI).
Trí tuệ nhân tạo hẹp (ANI): AI hiện tại chủ yếu ở giai đoạn này, nơi máy móc thực hiện rất tốt các nhiệm vụ cụ thể, chẳng hạn như phát hiện các loại ung thư cụ thể từ quét y tế thông qua nhận dạng mẫu.
Trí tuệ tổng hợp nhân tạo (AGI): AGI đề cập đến khả năng máy móc thực hiện các nhiệm vụ tương đối đơn giản đối với con người nhưng lại rất khó khăn khi được phản ánh trong hệ thống máy tính. Cho phép máy điều hướng trơn tru trong môi trường đông đúc trong khi đưa ra các giả định riêng biệt về tất cả các yếu tố đầu vào xung quanh là một ví dụ về AGI. AGI đề cập đến khả năng của một mô hình hoặc hệ thống thực hiện các công việc hàng ngày như con người.
Trí tuệ siêu nhân tạo (ASI): Sau khi đạt được trí tuệ nhân tạo tổng quát, máy móc có thể phát triển hơn nữa thành siêu trí tuệ nhân tạo. Điều này đề cập đến khả năng máy móc vượt qua khả năng của con người do sự phức tạp của mô hình, sức mạnh tính toán tăng lên, tuổi thọ không giới hạn và bộ nhớ hoàn hảo. Khái niệm này thường được khám phá trong các bộ phim khoa học viễn tưởng và kinh dị.
Ngoài ra, các vị khách cũng đề cập rằng việc tích hợp bộ não con người và máy móc, chẳng hạn như thông qua giao diện não-máy tính, có thể là một cách để đạt được AGI, nhưng điều này cũng đặt ra một loạt vấn đề đạo đức và đạo đức.
Mở khóa hộp đen của học sâu: xác định và xác suất
Ben giải thích rằng bản chất hộp đen của các mô hình deep learning là do kích thước khổng lồ của chúng. Bạn vẫn đang tìm đường đi qua một loạt các điểm quyết định trong mạng. Tuy nhiên, đường dẫn này rất lớn và rất khó để kết nối các trọng số hoặc tham số trong mô hình với các giá trị cụ thể của chúng, bởi vì các giá trị này được lấy sau khi hàng triệu mẫu được nhập vào. Bạn có thể làm điều này một cách chắc chắn và bạn có thể theo dõi mọi cập nhật, nhưng lượng dữ liệu bạn tạo ra sẽ rất lớn.
Anh thấy có hai điều xảy ra:
Khi chúng ta ngày càng hiểu rõ hơn về những mô hình mình đang xây dựng, bản chất hộp đen đang dần biến mất. Học sâu là một lĩnh vực nghiên cứu đã trải qua một thời kỳ thú vị và nhanh chóng với rất nhiều thử nghiệm không được thúc đẩy bởi các nguyên tắc cơ bản của nghiên cứu. Nó thiên về việc xem chúng ta có thể thu được gì từ nó. Vì vậy, chúng tôi đưa thêm dữ liệu vào nó, thử các kiến trúc mới và xem điều gì sẽ xảy ra, thay vì bắt đầu từ những nguyên tắc đầu tiên, thiết kế thứ này và biết chính xác nó hoạt động như thế nào. Vì vậy, có một khoảng thời gian thú vị khi mọi thứ đều là hộp đen. Nhưng anh ấy cho rằng sự tăng trưởng nhanh chóng này đang bắt đầu chậm lại, và chúng ta đang thấy mọi người xem lại những kiến trúc này, kiểm tra và nói, "Tại sao nó lại hoạt động tốt như vậy? Hãy đào sâu vào nó và chứng minh nó." đang được nâng lên.
Một điều khác đã xảy ra, có lẽ gây tranh cãi hơn, là sự thay đổi quan điểm về việc liệu các hệ thống tính toán có cần phải hoàn toàn mang tính quyết định hay không, hay liệu chúng ta có thể sống trong một thế giới xác suất hay không. Con người chúng ta sống trong một thế giới xác suất. Ví dụ về xe tự lái có thể rõ ràng nhất khi chúng ta lái xe, chúng ta chấp nhận rằng các sự kiện ngẫu nhiên sẽ xảy ra, có thể có những tai nạn nhỏ và có thể có vấn đề với hệ thống xe tự lái. Nhưng chúng tôi hoàn toàn không thể chấp nhận điều này và chúng tôi nói rằng đây phải là một quá trình hoàn toàn mang tính quyết định. Một trong những thách thức trong ngành công nghiệp ô tô tự lái là họ cho rằng con người sẽ chấp nhận các cơ chế xác suất áp dụng cho ô tô tự lái, nhưng thực tế thì không phải vậy. Ông cho rằng điều này sẽ thay đổi và có thể gây tranh cãi liệu chúng ta, với tư cách là một xã hội, có cho phép các hệ thống máy tính xác suất cùng tồn tại với chúng ta hay không? Anh ấy không chắc con đường có bằng phẳng hay không, nhưng anh ấy nghĩ điều đó sẽ xảy ra.
Phương pháp tối ưu hóa độ dốc: phương pháp tối ưu hóa cốt lõi của học sâu
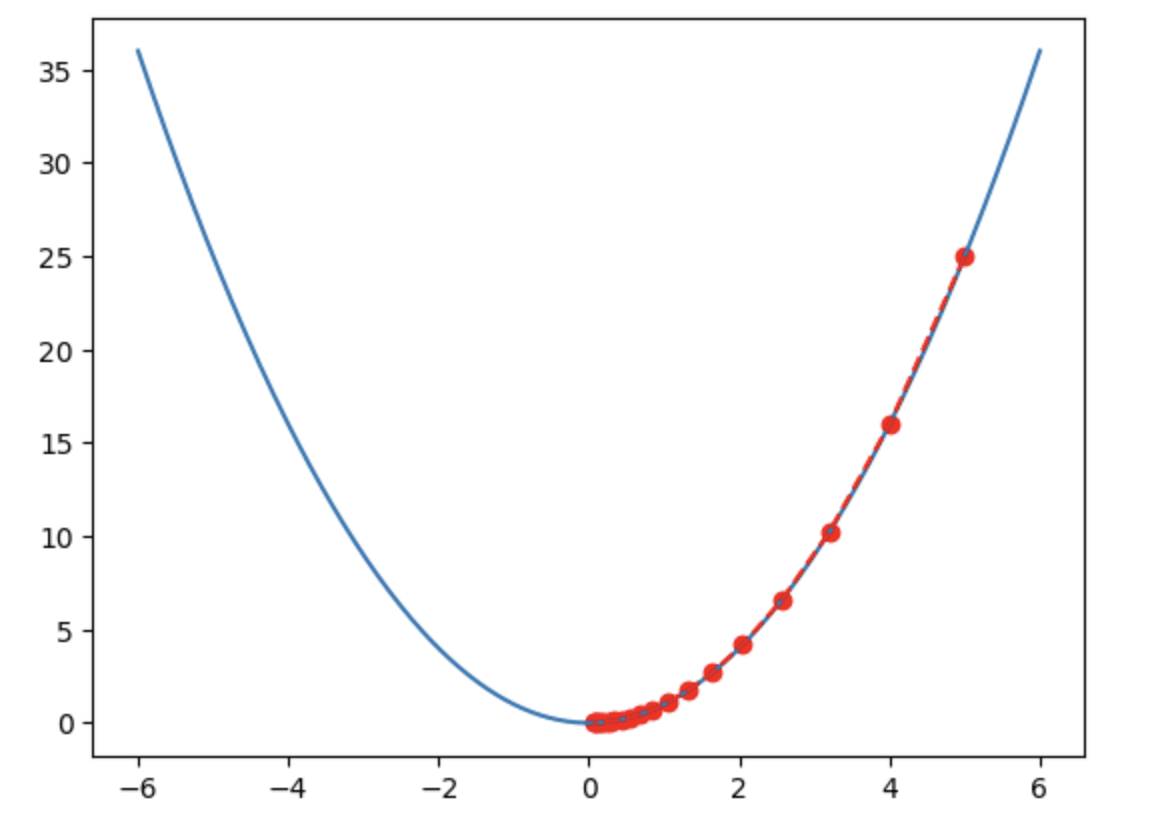
Tối ưu hóa độ dốc là một trong những phương pháp cốt lõi của học sâu, đóng vai trò quan trọng trong việc đào tạo mạng lưới thần kinh. Trong mạng lưới thần kinh, một loạt các tham số lớp về cơ bản là số thực. Huấn luyện mạng liên quan đến việc đặt các tham số này thành các giá trị thực tế cho phép dữ liệu được truyền chính xác và kích hoạt đầu ra mong muốn trong giai đoạn cuối của mạng.
Các phương pháp tối ưu hóa dựa trên gradient đã mang lại những thay đổi to lớn trong lĩnh vực mạng lưới thần kinh và học sâu. Phương pháp này sử dụng độ dốc, là sự phân biệt các tham số của từng lớp trong mạng liên quan đến lỗi. Bằng cách áp dụng quy tắc chuỗi, độ dốc có thể được truyền ngược trên toàn mạng phân cấp. Trong quá trình này, bạn có thể xác định mình đang ở đâu trên bề mặt lỗi. Lỗi có thể được mô hình hóa như một bề mặt trong không gian Euclide, xuất hiện dưới dạng một vùng đầy các mức cao và mức thấp. Mục tiêu của việc tối ưu hóa là tìm ra khu vực giảm thiểu lỗi.
Độ dốc hiển thị cho từng lớp nơi bạn ở trên bề mặt và hướng mà bạn nên cập nhật các tham số. Bạn có thể sử dụng độ dốc để điều hướng bề mặt nhấp nhô này và tìm hướng giảm lỗi. Kích thước của bước phụ thuộc vào độ dốc của bề mặt. Nếu dốc, bạn sẽ nhảy xa hơn; nếu không dốc, bạn sẽ nhảy nhỏ hơn. Về cơ bản, bạn chỉ đang điều hướng trên bề mặt, tìm kiếm một đường rãnh và độ dốc giúp bạn xác định vị trí và hướng.
Phương pháp này là một bước đột phá lớn vì độ dốc cung cấp tín hiệu rõ ràng và hướng hữu ích có thể hướng dẫn bạn đến vị trí của bạn trên bề mặt và vị trí của bạn một cách hiệu quả hơn so với việc thực hiện các bước nhảy ngẫu nhiên trong không gian tham số trên đỉnh núi. ở các khe núi hoặc vùng bằng phẳng.
Mặc dù có nhiều kỹ thuật trong học sâu để giải quyết vấn đề tìm giải pháp tối ưu nhưng tình hình trong thế giới thực thường phức tạp hơn. Có nhiều kỹ thuật chính quy hóa được sử dụng trong đào tạo deep learning khiến nó trở thành một nghệ thuật hơn là một môn khoa học. Và đây là lý do tại sao việc tối ưu hóa dựa trên độ dốc trong đời thực lại mang tính nghệ thuật hơn là một môn khoa học chính xác.
Tóm tắt
Mục tiêu của Gensyn là xây dựng hệ thống tài nguyên máy tính học máy lớn nhất thế giới, có thể tận dụng tối đa các tài nguyên máy tính nhàn rỗi hoặc chưa được sử dụng đầy đủ, chẳng hạn như điện thoại thông minh cá nhân, máy tính và các thiết bị khác.
Trong bối cảnh học máy và blockchain, các bản ghi do sổ cái lưu giữ thường là kết quả của các phép tính, tức là trạng thái của dữ liệu mà chúng ta đã xử lý thông qua học máy. Trạng thái này có thể là: "Tôi đã học được làn sóng dữ liệu này, nó hợp lệ và xảy ra vào năm X và tháng X." Mục tiêu chính của bản ghi này là thể hiện trạng thái kết quả thay vì trình bày chi tiết quá trình tính toán.
Trong khuôn khổ này, blockchain đóng vai trò quan trọng:
Blockchain cung cấp một cách để ghi lại kết quả trạng thái dữ liệu. Nó được thiết kế để đảm bảo tính xác thực của dữ liệu và ngăn chặn sự giả mạo và thoái thác.
Có một cơ chế khuyến khích kinh tế trong blockchain, qua đó hành vi của các vai trò khác nhau trong mạng máy tính có thể được điều phối, chẳng hạn như bốn vai trò được đề cập: người gửi, nhân viên, người xác minh và người tố cáo.
Qua khảo sát thị trường điện toán đám mây hiện tại, chúng tôi nhận thấy rằng điện toán đám mây không hoàn toàn là điều không mong muốn, nhưng các phương pháp tính toán khác nhau đều có những vấn đề cụ thể riêng. Phương thức tính toán phi tập trung của blockchain có thể đóng một vai trò nào đó trong một số trường hợp, nhưng nó không thể thay thế hoàn toàn điện toán đám mây truyền thống. Nói cách khác, blockchain không phải là giải pháp chữa bách bệnh.
Cuối cùng, AI có thể được coi là một loại năng suất. Tuy nhiên, làm thế nào để tổ chức và đào tạo AI một cách hiệu quả lại thuộc phạm trù quan hệ sản xuất. Điều này bao gồm các yếu tố như sự hợp tác, nguồn lực cộng đồng và các biện pháp khuyến khích. Về vấn đề này, Web 3.0 cung cấp một số lượng lớn các giải pháp và kịch bản khả thi.
Do đó, chúng ta có thể hiểu rằng sự kết hợp giữa blockchain và AI, đặc biệt là về chia sẻ dữ liệu và mô hình, điều phối tài nguyên máy tính và xác minh kết quả, sẽ cung cấp các giải pháp mới cho một số vấn đề trong khả năng đào tạo và sử dụng AI.
Trích dẫn
1. https://docs.gensyn.ai/litepaper/
2. https://a16zcrypto.com/posts/announcement/investing-in-gensyn/