
ME News
51.8k Публикации

ME News
 Square Verified+
Отправить жалобу
Заблокировать пользователя
ME Group 是全球领先的金融资讯与科技平台。总部位于香港,纽约设有北美办公室。核心业务涵盖媒体服务(ME News)、品牌会展(ME Event)、视频服务(BTV)、及AI 驱动的媒体、营销与数据服务。致力于为全球用户提供精准的资讯内容、专业的市场服务和AI智能化解决方案。
1 подписок(и/а)
2.5K+ подписчиков(а)
7.9K+ понравилось
Посты
Все
Видео
Активно
·
--
См. перевод
ME News 消息,9 月 20 日(UTC+8), Polymarket 美国平台在业务快速扩张过程中,对盗用借记卡欺诈问题处理不当。今年 2 月,负责处理其借记卡交易的公司发现,大量欺诈者将盗取的借记卡绑定账户,试图下注并将资金提现至可控账户,涉案金额至少 1000 万美元。高峰期,超过 80%的存款被判定为欺诈,远高于行业约 1%的标准。(来源:ME)
ME News 消息,9 月 20 日(UTC+8), Polymarket 美国平台在业务快速扩张过程中,对盗用借记卡欺诈问题处理不当。今年 2 月,负责处理其借记卡交易的公司发现,大量欺诈者将盗取的借记卡绑定账户,试图下注并将资金提现至可控账户,涉案金额至少 1000 万美元。高峰期,超过 80%的存款被判定为欺诈,远高于行业约 1%的标准。(来源:ME)
1
·
--
См. перевод
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,BNB跌破750 美元,现报价 749.9 美元, 24H跌幅达 2.3%。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,BNB跌破750 美元,现报价 749.9 美元, 24H跌幅达 2.3%。(来源:ME)
84
·
--
См. перевод
回报率881%,2017年入场ETH OG以10倍杠杆持有ENA多单228天ME News 消息,9 月 20 日(UTC+8), 据监测,2017 年入场的 ETH OG(0xeadc...)持有 ENA 多单约 228 天。截至北京时间 10:34,其持有约 1002.65 万枚 ENA 多单,建仓均价 0.110537 美元,仓位价值约 208.49 万美元,浮盈约 97.66 万美元。该仓位采用 10 倍全仓杠杆,ENA 较建仓成本上涨约 88.12%。 该地址目前持有 41 笔多单,总名义价值约 6984.81 万美元,整体合约杠杆约 4.65 倍。ENA 仓位占其合约敞口约 2.98%,浮盈位列当前持仓第三,低于 NEAR 的约 136.95 万美元及 AAVE 的约 102.25 万美元。该地址曾持有价值近 9000 万美元的 ETH,后均转入 Hyperliquid,此前为该平台最大 HYPE 多单持有者。(来源:ME)
回报率881%,2017年入场ETH OG以10倍杠杆持有ENA多单228天
ME News 消息,9 月 20 日(UTC+8), 据监测,2017 年入场的 ETH OG(0xeadc...)持有 ENA 多单约 228 天。截至北京时间 10:34,其持有约 1002.65 万枚 ENA 多单,建仓均价 0.110537 美元,仓位价值约 208.49 万美元,浮盈约 97.66 万美元。该仓位采用 10 倍全仓杠杆,ENA 较建仓成本上涨约 88.12%。 该地址目前持有 41 笔多单,总名义价值约 6984.81 万美元,整体合约杠杆约 4.65 倍。ENA 仓位占其合约敞口约 2.98%,浮盈位列当前持仓第三,低于 NEAR 的约 136.95 万美元及 AAVE 的约 102.25 万美元。该地址曾持有价值近 9000 万美元的 ETH,后均转入 Hyperliquid,此前为该平台最大 HYPE 多单持有者。(来源:ME)
7
·
--
См. перевод
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,SOL 现报价 108.25 美元, 24H跌幅达 3.0%。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,SOL 现报价 108.25 美元, 24H跌幅达 3.0%。(来源:ME)
·
--
См. перевод
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,ETH跌破2600 美元,现报价 2590.6 美元, 24H跌幅达 1.9%。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,ETH跌破2600 美元,现报价 2590.6 美元, 24H跌幅达 1.9%。(来源:ME)
305
·
--
См. перевод
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,XRP 现报价 1.3869 美元, 24H跌幅达 3.1%。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),据 CoinMarketCap 行情数据显示,XRP 现报价 1.3869 美元, 24H跌幅达 3.1%。(来源:ME)
5
·
--
Статья
См. перевод
AI离“理解万物”还有多远?先拿癌细胞和行星轨道试试水其隐空间因子可被解析并用于生成可实验验证的生物干预方案或复现物理定律,推动AI从单纯预测走向可解释、可检验的科学发现接口。
文章作者:量子位
文章来源:火星财经
一篇技术报告中居然出现了两个看起来风马牛不相及的研究对象,跟着AI真是见世面。
一个是患者来源的类器官,另一个则跨越到了宏观宇宙……
先说前者。研究者利用模型学到的内部因子,提出了细胞因子联合抗体阻断的干预方案,并经细胞系、类器官、小鼠实验层层验证。
至于后者,研究者把模拟的行星位置和速度轨迹喂给模型,不告诉它开普勒定律。
等它学完后分析其内部的预测模式,提取出的“轨道频率-半长轴”关系拟合斜率达-1.4991(开普勒第三定律理论值为-1.5),且R²=0.99999999。
肿瘤研究和行星轨道计算两个八竿子打不着的领域,居然能用同一种预测学习方法来搞定。
大千世界千差万别,天气、分子、细胞、病人、机器人乃至行星,各自遵循完全不同的规律。
但AI在理解它们“如何变化”时,有没有可能共享一套更底层的方法?
最近,PhAI Labs联合牛津、斯坦福、普林斯顿、港中文等高校团队最新发布的JEPA-Anything,就在尝试回答这个问题。
论文显示,JEPA-Anything是一个面向不同“世界”学习预测模型的跨领域框架。
每个领域保留自己的观测形式、context-target构造和编码器,但共享后面的预测核心以及一套统一的latent world-state interface。
其中涉及一个叫做OPF(Orthogonal Predictive Factorization,正交预测分解)的关键机制。
可以先简单理解为:
别把世间各种各样的变化,全都堆在一块去学习建模。
给世界建模,一条预测通路可能不够首先来厘清一个概念,在JEPA-Anything这项研究中,“世界模型”究竟意味着什么?
JEPA-Anything论文给出的定义兼具宽泛度与操作性。
论文写道,只要模型能根据现有信息(Context)建立内部状态,并以此预测同一系统中的另一个状态,均可归入隐空间世界模型(Latent World Model)的范畴。
这里的“另一个状态”,既可以是时间上的未来,也可以是空间上的隐藏区域、不同视角,甚至是施加某种干预后的结果。
顺着这一思路,业界在过去几年间已经发展出了日趋成熟的技术路径。
例如,DreamerV3强调先构建环境模型,再在模型内部“构想”行动后果;V-JEPA 2则将视频表征学习与机器人控制结合,让机械臂在规划动作前,先预测不同行为带来的物理反馈。
而JEPA——Joint-Embedding Predictive Architecture,联合嵌入预测架构——是其中颇有代表性的一条路线。
相比直接在原始空间重建目标状态,JEPA选择在表征空间做预测,不必还原每一个像素或细节。
它会将观测信息先编码为隐空间中的内部表征,再在表征空间内完成预测。
这种设计让模型把更多表征能力留给具有预测价值的结构,减少纹理、噪声等原始空间细节的干扰。
不过,标准JEPA通常让信息全部汇入同一个target embedding,走同一条预测路径。
但现实世界的变化往往不是单线程的。
举例来说,分子的整体平移往往伴随着内部原子的微观振动;宏观气象系统的缓慢演变中,夹杂着剧烈的局部扰动;生物系统则更为复杂,多尺度、多通路的变化时刻在同步发生。
当不同尺度、不同实体、不同难度的信号强行挤在一起时,那些更容易预测、变化更显著的信号,可能优先占据更多预测容量。
相比之下,那些相对微弱却同样关键的信息,要么在梯度冲突中被抵消,要么被强信号彻底掩盖。
研究人员将其归结为一个“预测容量如何分配”的问题,同时给出了新的解决思路。
既然拥挤会导致挤压,那就进行空间解耦。
于是就有了JEPA-Anything。
其核心机制OPF(正交预测分解)将原本完整的目标状态切割为多个彼此互补的子空间,交由不同的预测分支独立处理,最终再拼回完整的世界状态。
为了防止多分支演变为“多套人马学同一件事”的冗余状态,OPF引入正交约束,让不同factor尽量占据互不重叠的预测方向,减少多个分支重复学习同一类信息;同时通过因子活性约束和编码器方差约束,避免部分factor失活,并降低表示坍缩风险。
值得注意的是,这些factor并没有被预先规定“你负责速度”“你负责温度”“你负责某条生物通路”。
它们学什么由数据中的可预测结构决定。
训练完成后,这些factor也因此留下了一个可供后续分析的内部接口。
同一预测核心,跨七类系统验证方法论说得再漂亮,最终仍需经受跨领域泛化的检验。
这就不得不提到JEPA-Anything实验设计的独到之处。
它并未局限于视频表征或机器人控制等传统领域,转而将同一套预测核心(Predictive Core)直接置于视觉、生物、临床、控制、分子、物理场和天气七类截然不同的系统中进行验证。
所谓“Anything”,并非指强行将所有领域的数据打散重构为同一种输入格式,图像、单细胞序列、分子结构乃至气象数据,依然保留各自最契合的编码器与数据形态。
它统一的是这样一套底层规则:
当数据被转换为隐空间表征之后,预测部分应当如何搭建模型、如何完成学习。
论文先在一个基于简化Pong构造的受控动态环境CITRIS Interventional Pong里做实验,以验证模型能否将复合变化“拆解学习、再行组合”。
在训练阶段,模型仅接收过单一因子的变化数据;测试阶段则需要面对此前从未出现过的多因子组合干预。
如果模型仅仅死板地记录了训练集中的完整模式,面对全新组合必然失效;如果模型学到的是不同变化之间可复用的状态变化规律,就更有机会在未见组合里重新组合它们。
实验结果表明,在分布内的单项干预中,JEPA-Anything相较标准JEPA降低了约11.7%的预测误差;而在未见过的多因子组合干预中,均方误差(MSE)同样下降了约3.5%,且在五组配对训练seed中全部改善。
随后,验证走向了更复杂的真实系统。
论文构建了一套严格对齐的动力学基准(Matched Dynamics Benchmark),在十项任务中确保标准JEPA与JEPA-Anything使用完全相同的训练数据、编码器、状态转移骨干网络、计算预算及评估切分。
在其中九项预测任务中,JEPA-Anything的性能指标均有所提升。
比如PDEBench里的Burgers方程,MSE下降39.7%;浅水方程下降39.3%;WeatherBench 2下降10.5%。
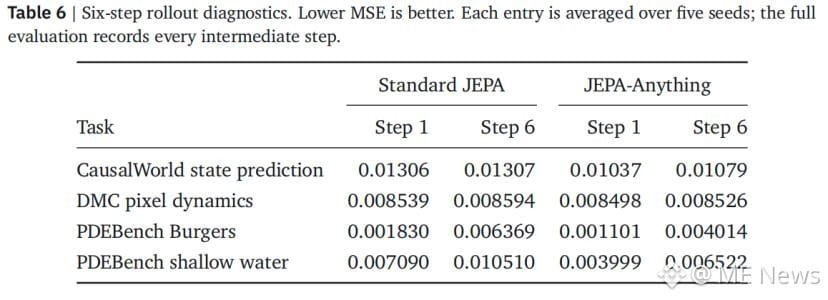
论文还专门做了多步rollout,让每一次预测继续成为下一次预测的输入,以观察误差不断传递之后会发生什么。
分子系统则把时间线拉得更长。
在液态水、α-石英、对乙酰氨基酚和苯四种体系中,模型需要持续预测未来的原子位置和速度,并把自己的输出不断喂回去。
最终,无论是一步预测的MAE,还是100步自由rollout后的最终位置RMSD,JEPA-Anything在四种分子系统中都拿到了最低误差。
不过值得注意的是,实验数据并未呈现出“单一机制全面碾压”的理想化曲线。
在连续控制测试中,JEPA-Anything并非每项任务都更好:在Walker2d和HalfCheetah上,它的平均得分高于标准JEPA;但在Hopper上,标准JEPA表现更好。
连续预测的距离越远,误差仍会不断累积。
在额外的Burgers测试中,当预测长度从20步增加到50步时,JEPA-Anything虽然仍然领先,但优势已明显缩小。
因此,这篇报告验证的是“共同预测原则存在跨领域适用性”,而非“已经实现一个统一所有领域的世界模型”。
但这些结果至少表明,这套预测原则具备跨领域复用的潜力。
JEPA-Anything学到的结构,能否经得起外部检验?前面的实验主要回答预测和状态表示是否有效。到了第三组实验,论文继续追问一个更进一步的问题:
模型隐空间中所形成的因子(factor),究竟是否具备科学探索价值?
于是,就有了本文开头那两个画风迥异、却又遥相呼应的研究案例。
案例一:从内部因子走向可验证的候选干预在肝癌研究中,研究人员并未将JEPA-Anything简单视作一个“黑盒预测器”,而是对其内部形成的正交因子坐标(Orthogonal Factor Coordinates)展开了领域分析,并从中筛出一个候选组合:IL-18联合NT5E/CD73阻断。
研究团队把它推进到Huh7-PBMC共培养体系,再到患者来源的肝细胞癌类器官和肿瘤组织碎片,之后还加入免疫健全小鼠验证。
实验数据表明,在3份患者类器官与3份肿瘤组织碎片中,IL-18与CD73阻断剂的组合均展现出最强的肿瘤细胞杀伤力,并伴随着显著增强的免疫细胞激活。
这意味着模型内部的Latent Factor不再只负责让预测数字“变好看”。
它开始成为研究者分析系统状态、提出可实验检验的候选假设的一种接口,由此形成“模型内部结构→领域分析→候选干预→实验验证”的链条。
案例二:从隐模式走向已知物理规律的“对账”行星轨道案例反过来拿人类早已知道的开普勒第三定律,去检验模型内部学到的东西有没有物理意义。
研究者仅向模型输入模拟产生的行星位置与速度轨迹,未附带任何先验公式。
训练完成后,研究人员对模型的隐模式(Latent Modes)进行频谱分析,并将提取出的频率与轨道半长轴配对。
结果显示,即使没有人为提前设定公式,研究者还是从模型学到的latent modes中提取出了与这套变量关系高度一致的尺度规律——拟合得到斜率‑1.4991,和理论值‑1.5高度接近,误差极小。
一个案例从内部因子出发,走向湿实验;另一个把内部模式拿出来,与已有物理规律对账。
两者从不同方向为“模型学到的内部结构可以成为科学分析接口”提供了案例证据。
研究者不一定只能在终点看一个预测数字,还可以继续向里追问,它到底捕捉到了哪些变化?这些变化是否对应真实规律?能不能从中形成下一步值得验证的东西?
这也恰好是JEPA-Anything在PhAI Labs整体战略脉络中的定位。
此前,PhAI Labs提出“科学发现大模型”(Discovery Foundation Models, DFM),旨在推动AI向开放式的科学探索迈进。
在DFM设想中,AI需要进一步参与识别未知、形成假设、设计干预,并根据外部证据持续修正的科学发现过程。
JEPA-Anything位于这套结构的世界模型层。
它试图把科学trajectory和真实世界变化中可预测的部分,压缩成可以更快速调用的预测能力,在耗时更长、成本更高的真实实验之前,提供一层近似判断。
至此再审视“从癌细胞到行星轨道”的跨度,其意义便不再停留在展示视觉反差或概念噱头。
研究人员探索的是面对机制迥异的复杂系统,AI能否共享同一种学习“演化逻辑”的方法;以及当这些变化被编码进内部状态后,这些内部结构能否被研究者拿出来分析,并接受实验结果与已知规律的检验。
这距离“AI理解万物”当然还有相当距离。JEPA-Anything目前给出的更像是一种可能性:
世界模型内部学到的结构,除了服务预测,也可以被研究者继续分析,并接受实验和已知规律的检验。
换句话说,模型不只在预测一个世界,也开始把自己学到的“世界”暴露出来,供科学家继续研究。
AI离“理解万物”还有多远?先拿癌细胞和行星轨道试试水
其隐空间因子可被解析并用于生成可实验验证的生物干预方案或复现物理定律,推动AI从单纯预测走向可解释、可检验的科学发现接口。
文章作者:量子位
文章来源:火星财经
一篇技术报告中居然出现了两个看起来风马牛不相及的研究对象,跟着AI真是见世面。
一个是患者来源的类器官,另一个则跨越到了宏观宇宙……
先说前者。研究者利用模型学到的内部因子,提出了细胞因子联合抗体阻断的干预方案,并经细胞系、类器官、小鼠实验层层验证。
至于后者,研究者把模拟的行星位置和速度轨迹喂给模型,不告诉它开普勒定律。
等它学完后分析其内部的预测模式,提取出的“轨道频率-半长轴”关系拟合斜率达-1.4991(开普勒第三定律理论值为-1.5),且R²=0.99999999。
肿瘤研究和行星轨道计算两个八竿子打不着的领域,居然能用同一种预测学习方法来搞定。
大千世界千差万别,天气、分子、细胞、病人、机器人乃至行星,各自遵循完全不同的规律。
但AI在理解它们“如何变化”时,有没有可能共享一套更底层的方法?
最近,PhAI Labs联合牛津、斯坦福、普林斯顿、港中文等高校团队最新发布的JEPA-Anything,就在尝试回答这个问题。
论文显示,JEPA-Anything是一个面向不同“世界”学习预测模型的跨领域框架。
每个领域保留自己的观测形式、context-target构造和编码器,但共享后面的预测核心以及一套统一的latent world-state interface。
其中涉及一个叫做OPF(Orthogonal Predictive Factorization,正交预测分解)的关键机制。
可以先简单理解为:
别把世间各种各样的变化,全都堆在一块去学习建模。
给世界建模,一条预测通路可能不够首先来厘清一个概念,在JEPA-Anything这项研究中,“世界模型”究竟意味着什么?
JEPA-Anything论文给出的定义兼具宽泛度与操作性。
论文写道,只要模型能根据现有信息(Context)建立内部状态,并以此预测同一系统中的另一个状态,均可归入隐空间世界模型(Latent World Model)的范畴。
这里的“另一个状态”,既可以是时间上的未来,也可以是空间上的隐藏区域、不同视角,甚至是施加某种干预后的结果。
顺着这一思路,业界在过去几年间已经发展出了日趋成熟的技术路径。
例如,DreamerV3强调先构建环境模型,再在模型内部“构想”行动后果;V-JEPA 2则将视频表征学习与机器人控制结合,让机械臂在规划动作前,先预测不同行为带来的物理反馈。
而JEPA——Joint-Embedding Predictive Architecture,联合嵌入预测架构——是其中颇有代表性的一条路线。
相比直接在原始空间重建目标状态,JEPA选择在表征空间做预测,不必还原每一个像素或细节。
它会将观测信息先编码为隐空间中的内部表征,再在表征空间内完成预测。
这种设计让模型把更多表征能力留给具有预测价值的结构,减少纹理、噪声等原始空间细节的干扰。
不过,标准JEPA通常让信息全部汇入同一个target embedding,走同一条预测路径。
但现实世界的变化往往不是单线程的。
举例来说,分子的整体平移往往伴随着内部原子的微观振动;宏观气象系统的缓慢演变中,夹杂着剧烈的局部扰动;生物系统则更为复杂,多尺度、多通路的变化时刻在同步发生。
当不同尺度、不同实体、不同难度的信号强行挤在一起时,那些更容易预测、变化更显著的信号,可能优先占据更多预测容量。
相比之下,那些相对微弱却同样关键的信息,要么在梯度冲突中被抵消,要么被强信号彻底掩盖。
研究人员将其归结为一个“预测容量如何分配”的问题,同时给出了新的解决思路。
既然拥挤会导致挤压,那就进行空间解耦。
于是就有了JEPA-Anything。
其核心机制OPF(正交预测分解)将原本完整的目标状态切割为多个彼此互补的子空间,交由不同的预测分支独立处理,最终再拼回完整的世界状态。
为了防止多分支演变为“多套人马学同一件事”的冗余状态,OPF引入正交约束,让不同factor尽量占据互不重叠的预测方向,减少多个分支重复学习同一类信息;同时通过因子活性约束和编码器方差约束,避免部分factor失活,并降低表示坍缩风险。
值得注意的是,这些factor并没有被预先规定“你负责速度”“你负责温度”“你负责某条生物通路”。
它们学什么由数据中的可预测结构决定。
训练完成后,这些factor也因此留下了一个可供后续分析的内部接口。
同一预测核心,跨七类系统验证方法论说得再漂亮,最终仍需经受跨领域泛化的检验。
这就不得不提到JEPA-Anything实验设计的独到之处。
它并未局限于视频表征或机器人控制等传统领域,转而将同一套预测核心(Predictive Core)直接置于视觉、生物、临床、控制、分子、物理场和天气七类截然不同的系统中进行验证。
所谓“Anything”,并非指强行将所有领域的数据打散重构为同一种输入格式,图像、单细胞序列、分子结构乃至气象数据,依然保留各自最契合的编码器与数据形态。
它统一的是这样一套底层规则:
当数据被转换为隐空间表征之后,预测部分应当如何搭建模型、如何完成学习。
论文先在一个基于简化Pong构造的受控动态环境CITRIS Interventional Pong里做实验,以验证模型能否将复合变化“拆解学习、再行组合”。
在训练阶段,模型仅接收过单一因子的变化数据;测试阶段则需要面对此前从未出现过的多因子组合干预。
如果模型仅仅死板地记录了训练集中的完整模式,面对全新组合必然失效;如果模型学到的是不同变化之间可复用的状态变化规律,就更有机会在未见组合里重新组合它们。
实验结果表明,在分布内的单项干预中,JEPA-Anything相较标准JEPA降低了约11.7%的预测误差;而在未见过的多因子组合干预中,均方误差(MSE)同样下降了约3.5%,且在五组配对训练seed中全部改善。
随后,验证走向了更复杂的真实系统。
论文构建了一套严格对齐的动力学基准(Matched Dynamics Benchmark),在十项任务中确保标准JEPA与JEPA-Anything使用完全相同的训练数据、编码器、状态转移骨干网络、计算预算及评估切分。
在其中九项预测任务中,JEPA-Anything的性能指标均有所提升。
比如PDEBench里的Burgers方程,MSE下降39.7%;浅水方程下降39.3%;WeatherBench 2下降10.5%。
论文还专门做了多步rollout,让每一次预测继续成为下一次预测的输入,以观察误差不断传递之后会发生什么。
分子系统则把时间线拉得更长。
在液态水、α-石英、对乙酰氨基酚和苯四种体系中,模型需要持续预测未来的原子位置和速度,并把自己的输出不断喂回去。
最终,无论是一步预测的MAE,还是100步自由rollout后的最终位置RMSD,JEPA-Anything在四种分子系统中都拿到了最低误差。
不过值得注意的是,实验数据并未呈现出“单一机制全面碾压”的理想化曲线。
在连续控制测试中,JEPA-Anything并非每项任务都更好:在Walker2d和HalfCheetah上,它的平均得分高于标准JEPA;但在Hopper上,标准JEPA表现更好。
连续预测的距离越远,误差仍会不断累积。
在额外的Burgers测试中,当预测长度从20步增加到50步时,JEPA-Anything虽然仍然领先,但优势已明显缩小。
因此,这篇报告验证的是“共同预测原则存在跨领域适用性”,而非“已经实现一个统一所有领域的世界模型”。
但这些结果至少表明,这套预测原则具备跨领域复用的潜力。
JEPA-Anything学到的结构,能否经得起外部检验?前面的实验主要回答预测和状态表示是否有效。到了第三组实验,论文继续追问一个更进一步的问题:
模型隐空间中所形成的因子(factor),究竟是否具备科学探索价值?
于是,就有了本文开头那两个画风迥异、却又遥相呼应的研究案例。
案例一:从内部因子走向可验证的候选干预在肝癌研究中,研究人员并未将JEPA-Anything简单视作一个“黑盒预测器”,而是对其内部形成的正交因子坐标(Orthogonal Factor Coordinates)展开了领域分析,并从中筛出一个候选组合:IL-18联合NT5E/CD73阻断。
研究团队把它推进到Huh7-PBMC共培养体系,再到患者来源的肝细胞癌类器官和肿瘤组织碎片,之后还加入免疫健全小鼠验证。
实验数据表明,在3份患者类器官与3份肿瘤组织碎片中,IL-18与CD73阻断剂的组合均展现出最强的肿瘤细胞杀伤力,并伴随着显著增强的免疫细胞激活。
这意味着模型内部的Latent Factor不再只负责让预测数字“变好看”。
它开始成为研究者分析系统状态、提出可实验检验的候选假设的一种接口,由此形成“模型内部结构→领域分析→候选干预→实验验证”的链条。
案例二:从隐模式走向已知物理规律的“对账”行星轨道案例反过来拿人类早已知道的开普勒第三定律,去检验模型内部学到的东西有没有物理意义。
研究者仅向模型输入模拟产生的行星位置与速度轨迹,未附带任何先验公式。
训练完成后,研究人员对模型的隐模式(Latent Modes)进行频谱分析,并将提取出的频率与轨道半长轴配对。
结果显示,即使没有人为提前设定公式,研究者还是从模型学到的latent modes中提取出了与这套变量关系高度一致的尺度规律——拟合得到斜率‑1.4991,和理论值‑1.5高度接近,误差极小。
一个案例从内部因子出发,走向湿实验;另一个把内部模式拿出来,与已有物理规律对账。
两者从不同方向为“模型学到的内部结构可以成为科学分析接口”提供了案例证据。
研究者不一定只能在终点看一个预测数字,还可以继续向里追问,它到底捕捉到了哪些变化?这些变化是否对应真实规律?能不能从中形成下一步值得验证的东西?
这也恰好是JEPA-Anything在PhAI Labs整体战略脉络中的定位。
此前,PhAI Labs提出“科学发现大模型”(Discovery Foundation Models, DFM),旨在推动AI向开放式的科学探索迈进。
在DFM设想中,AI需要进一步参与识别未知、形成假设、设计干预,并根据外部证据持续修正的科学发现过程。
JEPA-Anything位于这套结构的世界模型层。
它试图把科学trajectory和真实世界变化中可预测的部分,压缩成可以更快速调用的预测能力,在耗时更长、成本更高的真实实验之前,提供一层近似判断。
至此再审视“从癌细胞到行星轨道”的跨度,其意义便不再停留在展示视觉反差或概念噱头。
研究人员探索的是面对机制迥异的复杂系统,AI能否共享同一种学习“演化逻辑”的方法;以及当这些变化被编码进内部状态后,这些内部结构能否被研究者拿出来分析,并接受实验结果与已知规律的检验。
这距离“AI理解万物”当然还有相当距离。JEPA-Anything目前给出的更像是一种可能性:
世界模型内部学到的结构,除了服务预测,也可以被研究者继续分析,并接受实验和已知规律的检验。
换句话说,模型不只在预测一个世界,也开始把自己学到的“世界”暴露出来,供科学家继续研究。
文章作者:量子位
文章来源:火星财经
一篇技术报告中居然出现了两个看起来风马牛不相及的研究对象,跟着AI真是见世面。
一个是患者来源的类器官,另一个则跨越到了宏观宇宙……
先说前者。研究者利用模型学到的内部因子,提出了细胞因子联合抗体阻断的干预方案,并经细胞系、类器官、小鼠实验层层验证。
至于后者,研究者把模拟的行星位置和速度轨迹喂给模型,不告诉它开普勒定律。
等它学完后分析其内部的预测模式,提取出的“轨道频率-半长轴”关系拟合斜率达-1.4991(开普勒第三定律理论值为-1.5),且R²=0.99999999。
肿瘤研究和行星轨道计算两个八竿子打不着的领域,居然能用同一种预测学习方法来搞定。
大千世界千差万别,天气、分子、细胞、病人、机器人乃至行星,各自遵循完全不同的规律。
但AI在理解它们“如何变化”时,有没有可能共享一套更底层的方法?
最近,PhAI Labs联合牛津、斯坦福、普林斯顿、港中文等高校团队最新发布的JEPA-Anything,就在尝试回答这个问题。
论文显示,JEPA-Anything是一个面向不同“世界”学习预测模型的跨领域框架。
每个领域保留自己的观测形式、context-target构造和编码器,但共享后面的预测核心以及一套统一的latent world-state interface。
其中涉及一个叫做OPF(Orthogonal Predictive Factorization,正交预测分解)的关键机制。
可以先简单理解为:
别把世间各种各样的变化,全都堆在一块去学习建模。
给世界建模,一条预测通路可能不够首先来厘清一个概念,在JEPA-Anything这项研究中,“世界模型”究竟意味着什么?
JEPA-Anything论文给出的定义兼具宽泛度与操作性。
论文写道,只要模型能根据现有信息(Context)建立内部状态,并以此预测同一系统中的另一个状态,均可归入隐空间世界模型(Latent World Model)的范畴。
这里的“另一个状态”,既可以是时间上的未来,也可以是空间上的隐藏区域、不同视角,甚至是施加某种干预后的结果。
顺着这一思路,业界在过去几年间已经发展出了日趋成熟的技术路径。
例如,DreamerV3强调先构建环境模型,再在模型内部“构想”行动后果;V-JEPA 2则将视频表征学习与机器人控制结合,让机械臂在规划动作前,先预测不同行为带来的物理反馈。
而JEPA——Joint-Embedding Predictive Architecture,联合嵌入预测架构——是其中颇有代表性的一条路线。
相比直接在原始空间重建目标状态,JEPA选择在表征空间做预测,不必还原每一个像素或细节。
它会将观测信息先编码为隐空间中的内部表征,再在表征空间内完成预测。
这种设计让模型把更多表征能力留给具有预测价值的结构,减少纹理、噪声等原始空间细节的干扰。
不过,标准JEPA通常让信息全部汇入同一个target embedding,走同一条预测路径。
但现实世界的变化往往不是单线程的。
举例来说,分子的整体平移往往伴随着内部原子的微观振动;宏观气象系统的缓慢演变中,夹杂着剧烈的局部扰动;生物系统则更为复杂,多尺度、多通路的变化时刻在同步发生。
当不同尺度、不同实体、不同难度的信号强行挤在一起时,那些更容易预测、变化更显著的信号,可能优先占据更多预测容量。
相比之下,那些相对微弱却同样关键的信息,要么在梯度冲突中被抵消,要么被强信号彻底掩盖。
研究人员将其归结为一个“预测容量如何分配”的问题,同时给出了新的解决思路。
既然拥挤会导致挤压,那就进行空间解耦。
于是就有了JEPA-Anything。
其核心机制OPF(正交预测分解)将原本完整的目标状态切割为多个彼此互补的子空间,交由不同的预测分支独立处理,最终再拼回完整的世界状态。
为了防止多分支演变为“多套人马学同一件事”的冗余状态,OPF引入正交约束,让不同factor尽量占据互不重叠的预测方向,减少多个分支重复学习同一类信息;同时通过因子活性约束和编码器方差约束,避免部分factor失活,并降低表示坍缩风险。
值得注意的是,这些factor并没有被预先规定“你负责速度”“你负责温度”“你负责某条生物通路”。
它们学什么由数据中的可预测结构决定。
训练完成后,这些factor也因此留下了一个可供后续分析的内部接口。
同一预测核心,跨七类系统验证方法论说得再漂亮,最终仍需经受跨领域泛化的检验。
这就不得不提到JEPA-Anything实验设计的独到之处。
它并未局限于视频表征或机器人控制等传统领域,转而将同一套预测核心(Predictive Core)直接置于视觉、生物、临床、控制、分子、物理场和天气七类截然不同的系统中进行验证。
所谓“Anything”,并非指强行将所有领域的数据打散重构为同一种输入格式,图像、单细胞序列、分子结构乃至气象数据,依然保留各自最契合的编码器与数据形态。
它统一的是这样一套底层规则:
当数据被转换为隐空间表征之后,预测部分应当如何搭建模型、如何完成学习。
论文先在一个基于简化Pong构造的受控动态环境CITRIS Interventional Pong里做实验,以验证模型能否将复合变化“拆解学习、再行组合”。
在训练阶段,模型仅接收过单一因子的变化数据;测试阶段则需要面对此前从未出现过的多因子组合干预。
如果模型仅仅死板地记录了训练集中的完整模式,面对全新组合必然失效;如果模型学到的是不同变化之间可复用的状态变化规律,就更有机会在未见组合里重新组合它们。
实验结果表明,在分布内的单项干预中,JEPA-Anything相较标准JEPA降低了约11.7%的预测误差;而在未见过的多因子组合干预中,均方误差(MSE)同样下降了约3.5%,且在五组配对训练seed中全部改善。
随后,验证走向了更复杂的真实系统。
论文构建了一套严格对齐的动力学基准(Matched Dynamics Benchmark),在十项任务中确保标准JEPA与JEPA-Anything使用完全相同的训练数据、编码器、状态转移骨干网络、计算预算及评估切分。
在其中九项预测任务中,JEPA-Anything的性能指标均有所提升。
比如PDEBench里的Burgers方程,MSE下降39.7%;浅水方程下降39.3%;WeatherBench 2下降10.5%。
论文还专门做了多步rollout,让每一次预测继续成为下一次预测的输入,以观察误差不断传递之后会发生什么。
分子系统则把时间线拉得更长。
在液态水、α-石英、对乙酰氨基酚和苯四种体系中,模型需要持续预测未来的原子位置和速度,并把自己的输出不断喂回去。
最终,无论是一步预测的MAE,还是100步自由rollout后的最终位置RMSD,JEPA-Anything在四种分子系统中都拿到了最低误差。
不过值得注意的是,实验数据并未呈现出“单一机制全面碾压”的理想化曲线。
在连续控制测试中,JEPA-Anything并非每项任务都更好:在Walker2d和HalfCheetah上,它的平均得分高于标准JEPA;但在Hopper上,标准JEPA表现更好。
连续预测的距离越远,误差仍会不断累积。
在额外的Burgers测试中,当预测长度从20步增加到50步时,JEPA-Anything虽然仍然领先,但优势已明显缩小。
因此,这篇报告验证的是“共同预测原则存在跨领域适用性”,而非“已经实现一个统一所有领域的世界模型”。
但这些结果至少表明,这套预测原则具备跨领域复用的潜力。
JEPA-Anything学到的结构,能否经得起外部检验?前面的实验主要回答预测和状态表示是否有效。到了第三组实验,论文继续追问一个更进一步的问题:
模型隐空间中所形成的因子(factor),究竟是否具备科学探索价值?
于是,就有了本文开头那两个画风迥异、却又遥相呼应的研究案例。
案例一:从内部因子走向可验证的候选干预在肝癌研究中,研究人员并未将JEPA-Anything简单视作一个“黑盒预测器”,而是对其内部形成的正交因子坐标(Orthogonal Factor Coordinates)展开了领域分析,并从中筛出一个候选组合:IL-18联合NT5E/CD73阻断。
研究团队把它推进到Huh7-PBMC共培养体系,再到患者来源的肝细胞癌类器官和肿瘤组织碎片,之后还加入免疫健全小鼠验证。
实验数据表明,在3份患者类器官与3份肿瘤组织碎片中,IL-18与CD73阻断剂的组合均展现出最强的肿瘤细胞杀伤力,并伴随着显著增强的免疫细胞激活。
这意味着模型内部的Latent Factor不再只负责让预测数字“变好看”。
它开始成为研究者分析系统状态、提出可实验检验的候选假设的一种接口,由此形成“模型内部结构→领域分析→候选干预→实验验证”的链条。
案例二:从隐模式走向已知物理规律的“对账”行星轨道案例反过来拿人类早已知道的开普勒第三定律,去检验模型内部学到的东西有没有物理意义。
研究者仅向模型输入模拟产生的行星位置与速度轨迹,未附带任何先验公式。
训练完成后,研究人员对模型的隐模式(Latent Modes)进行频谱分析,并将提取出的频率与轨道半长轴配对。
结果显示,即使没有人为提前设定公式,研究者还是从模型学到的latent modes中提取出了与这套变量关系高度一致的尺度规律——拟合得到斜率‑1.4991,和理论值‑1.5高度接近,误差极小。
一个案例从内部因子出发,走向湿实验;另一个把内部模式拿出来,与已有物理规律对账。
两者从不同方向为“模型学到的内部结构可以成为科学分析接口”提供了案例证据。
研究者不一定只能在终点看一个预测数字,还可以继续向里追问,它到底捕捉到了哪些变化?这些变化是否对应真实规律?能不能从中形成下一步值得验证的东西?
这也恰好是JEPA-Anything在PhAI Labs整体战略脉络中的定位。
此前,PhAI Labs提出“科学发现大模型”(Discovery Foundation Models, DFM),旨在推动AI向开放式的科学探索迈进。
在DFM设想中,AI需要进一步参与识别未知、形成假设、设计干预,并根据外部证据持续修正的科学发现过程。
JEPA-Anything位于这套结构的世界模型层。
它试图把科学trajectory和真实世界变化中可预测的部分,压缩成可以更快速调用的预测能力,在耗时更长、成本更高的真实实验之前,提供一层近似判断。
至此再审视“从癌细胞到行星轨道”的跨度,其意义便不再停留在展示视觉反差或概念噱头。
研究人员探索的是面对机制迥异的复杂系统,AI能否共享同一种学习“演化逻辑”的方法;以及当这些变化被编码进内部状态后,这些内部结构能否被研究者拿出来分析,并接受实验结果与已知规律的检验。
这距离“AI理解万物”当然还有相当距离。JEPA-Anything目前给出的更像是一种可能性:
世界模型内部学到的结构,除了服务预测,也可以被研究者继续分析,并接受实验和已知规律的检验。
换句话说,模型不只在预测一个世界,也开始把自己学到的“世界”暴露出来,供科学家继续研究。
6
·
--
См. перевод
ME AI 消息,动察 Beating AI 快讯,智谱 ZCode 的代码上传风波开始从开发者社区烧到企业客户。太原承明科技向智谱发函称,ZCode 自动上传的并非少量代码片段,而是包含完整源代码、Git 历史、数据库口令、云服务凭证和员工个人信息的项目归档,并要求智谱删除已上传数据、说明数据去向并提供删除证明。 智谱此前已经道歉,称问题来自「代码库索引」功能。该功能上线初期默认开启,生成 Repo Wiki 时可能上传仓库数据。智谱称相关数据使用后会立即销毁,问题目前已经修复,并承诺开源 ZCode、邀请第三方审查。(来源:ME)
ME AI 消息,动察 Beating AI 快讯,智谱 ZCode 的代码上传风波开始从开发者社区烧到企业客户。太原承明科技向智谱发函称,ZCode 自动上传的并非少量代码片段,而是包含完整源代码、Git 历史、数据库口令、云服务凭证和员工个人信息的项目归档,并要求智谱删除已上传数据、说明数据去向并提供删除证明。 智谱此前已经道歉,称问题来自「代码库索引」功能。该功能上线初期默认开启,生成 Repo Wiki 时可能上传仓库数据。智谱称相关数据使用后会立即销毁,问题目前已经修复,并承诺开源 ZCode、邀请第三方审查。(来源:ME)
10
·
--
См. перевод
特朗普宣布设立“AI沙皇”:美国为何选择推动AI而非限制AI这一政策方向的核心逻辑并非放弃监管,而是希望避免过度监管削弱美国在全球AI竞争中的优势。
文章作者、来源:ME News
TL;DR
特朗普表示,美国不会通过限制措施阻碍人工智能发展,并计划成立“人工智能工作组”,任命负责AI事务的“AI沙皇”。
这一政策方向的核心逻辑并非放弃监管,而是希望避免过度监管削弱美国在全球AI竞争中的优势。
美国AI产业已经形成以大模型、芯片、云计算和资本投入为核心的产业链优势,但竞争正在从技术领先转向基础设施、能源、人才和政策环境的综合竞争。
AI治理正在出现明显分歧:一部分企业和研究者强调安全审查和风险控制,另一部分科技企业则担忧监管速度落后于产业竞争节奏。
“AI沙皇”的设立意味着美国政府正在尝试建立新的协调机制,但这一职位未来能够拥有多少实际权力,仍取决于政策设计和执行方式。
特朗普的AI路线:不是不管,而是不希望用传统监管方式管理新技术
人工智能正在成为美国科技战略中越来越重要的组成部分。
9月,特朗普公开表示,美国不会阻碍人工智能产业发展,而是希望在支持创新的同时加强监督。他宣布计划成立“人工智能工作组”,并将在未来任命一名负责AI事务的“AI沙皇”,负责协调政府层面的人工智能相关事务。(Reuters)
特朗普将AI定义为“下一次工业革命”,并表示其潜在影响可能达到美国GDP的25%。这一数字更多体现的是政治层面对AI经济潜力的判断,而非一个已经被完全验证的经济预测,但它反映出一个明确趋势:美国政府已经将人工智能视为类似互联网、半导体和航空航天一样的战略产业。
从政策逻辑来看,特朗普此次表态并不是简单意义上的“放任AI发展”。他的核心观点是,美国不能因为担忧风险而降低技术发展的速度,否则可能在全球人工智能竞争中失去优势。
过去几年,美国关于AI治理的讨论一直存在两种方向。一种观点认为,人工智能能力增长速度过快,需要建立更严格的安全机制,包括模型测试、风险评估和企业责任制度;另一种观点则认为,AI正在成为国家竞争力的重要组成部分,如果监管过早、过重,可能限制企业创新能力。
特朗普政府明显更接近后一种思路。此前,美国政府已经多次强调需要保持AI领域领先地位,并提出减少联邦层面对人工智能发展的限制。
这背后实际上是一场关于“如何管理技术革命”的争论。
互联网时代,美国通过开放市场、资本投入和企业创新建立了全球科技优势;而在人工智能时代,美国希望复制这一模式。但不同之处在于,AI不仅是一项商业技术,也涉及数据安全、就业变化、信息真实性以及国家安全,因此政府无法完全像管理传统互联网企业一样管理AI产业。
因此,“AI沙皇”的出现,本质上是在寻找一种新的平衡方式:既避免传统监管阻碍产业发展,也避免政府完全缺席。
美国为何如此重视AI竞争?
人工智能已经不再只是科技公司的商业竞争,而逐渐成为国家之间的产业竞争。
过去十年,美国在AI领域形成了较完整的产业优势。从基础模型研发,到AI芯片设计,再到云计算基础设施,美国企业占据了全球人工智能产业链的重要位置。
以大模型领域为例,OpenAI、Google、Anthropic、Meta等企业持续投入数十亿美元进行模型训练,而背后的基础设施依赖英伟达GPU、微软Azure、亚马逊AWS以及谷歌云等计算平台。
与此同时,AI产业正在推动资本市场重新评估科技公司的价值。
根据斯坦福大学发布的《AI Index Report 2025》,2024年全球私人AI投资达到2523亿美元,其中生成式AI领域投资增长显著,美国仍然是全球最大的AI私人投资市场。该报告同时指出,美国企业在基础模型数量、模型规模以及商业应用方面保持领先。
但AI竞争已经不只是模型能力竞争。
过去几年,行业普遍关注的问题是:“谁能训练出更强的大模型?”
而现在,竞争正在转向更加基础的问题:
谁拥有足够的计算资源?
谁能够获得稳定的能源供应?
谁能够建立更大规模的数据中心?
谁能够吸引全球顶尖AI人才?
谁能够形成更加稳定的政策环境?
这也是特朗普政府强调“不限制AI发展”的重要原因之一。对于美国而言,AI不仅代表新的科技产业,也关系到未来制造业、金融、医疗、国防以及政府效率等多个领域。
如果未来人工智能成为生产效率提升的重要工具,那么掌握AI基础设施和产业生态的国家,将获得新的经济优势。
“AI沙皇”意味着什么?
美国政府设立类似“AI沙皇”的职位,并不是历史上的首次。
美国过去曾通过类似职位协调复杂领域政策。例如,太空领域曾通过专门机构推动国家战略目标,网络安全领域也曾设立协调负责人。
人工智能的问题在于,它横跨多个政府部门。
商务部关注产业发展和出口政策;
国防部门关注AI军事应用;
司法部门关注AI犯罪和责任认定;
教育部门关注AI对学习方式的影响;
金融监管机构关注AI在金融体系中的应用。
如果没有统一协调机制,不同部门可能形成政策冲突。
因此,“AI沙皇”的主要价值可能不是直接制定所有规则,而是在政府内部建立一个AI战略协调中心。
不过,这一职位未来能发挥多大作用,仍存在不确定性。目前特朗普公布的信息主要集中在设立职位和工作组,并未公布具体权限、组织结构以及监管范围。
美国此前在AI政策制定过程中,也一直面临类似问题:政府希望推动产业发展,但同时需要面对来自社会、企业和研究机构对于AI风险的担忧。
如果“AI沙皇”只是一个协调角色,其影响可能更多体现在政策方向统一;如果未来获得更强执行权限,则可能成为美国AI治理体系的重要组成部分。
AI监管争论的核心:速度与安全如何平衡
特朗普此次表态,再次放大了美国AI监管领域长期存在的分歧。
支持加强监管的一方认为,AI能力提升速度已经超过社会适应速度。
尤其是在生成式AI快速普及后,深度伪造、自动化攻击、错误信息传播等问题开始受到关注。一些AI研究人员和企业负责人认为,高能力模型在公开部署前,需要更加严格的安全测试和风险评估。
例如,Anthropic CEO Dario Amodei、OpenAI CEO Sam Altman等科技行业人士此前都曾公开讨论AI安全问题,认为随着模型能力提升,需要建立更加完善的治理机制。
而反对过度监管的一方则认为,AI产业仍处于高速发展阶段,如果政府提前设置过多限制,可能导致企业创新速度下降,并让美国在全球竞争中处于不利位置。
这种观点尤其受到部分科技企业支持。
他们认为,人工智能的发展类似过去的互联网革命,早期过度限制可能错失产业机会。
实际上,两种观点并非完全对立。
真正的问题并不是“要不要监管AI”,而是“什么阶段采用什么程度的监管”。
对于成熟行业,监管通常围绕消费者保护、市场竞争和安全标准展开;但对于快速发展的技术领域,如果规则制定速度明显落后于技术变化,就可能出现监管失效。
因此,美国目前探索的方向更接近“轻监管、强协调”。
美国AI战略背后的全球竞争因素
特朗普强调美国需要保持AI领先地位,其中一个重要背景是中美人工智能竞争。
人工智能已经成为全球科技竞争的重要领域。
美国依靠先进芯片、基础模型和科技企业生态保持优势,而中国则通过产业规模、应用场景以及政策推动发展AI产业。(Reuters)
双方竞争不仅体现在模型性能,也体现在芯片供应链、数据资源、人才培养以及商业落地速度。
在这种背景下,美国政府担心,如果监管环境过于严格,可能削弱本土企业竞争力。
类似情况此前已经发生在半导体行业。美国长期通过技术优势和产业政策维持芯片竞争力,而人工智能正在成为新的战略基础设施。
因此,特朗普提出“不阻碍AI发展”,实际上反映的是一种产业竞争思维:
AI不仅是一项新技术,也是一种未来经济基础设施。
谁能够率先形成完整产业生态,谁就可能获得下一轮科技竞争优势。
AI时代真正的问题,不是发展还是限制,而是谁来定义规则
人工智能的发展已经进入新的阶段。
过去,人们讨论AI更多关注模型能力,比如参数规模、生成质量和推理能力。
但随着AI逐渐进入企业生产、政府服务和个人生活,真正重要的问题正在发生变化:
谁负责制定规则?
谁承担风险?
谁能够确保技术收益被更多人分享?
特朗普推动“AI沙皇”和AI工作组,代表美国政府试图建立新的治理方式:减少传统监管束缚,同时保持政府参与。
这种路径是否有效,最终取决于两个因素。
第一,政府能否真正理解快速变化的AI产业,而不是使用传统工业时代的管理方式处理新技术。
第二,企业能否在追求商业利益之外,建立足够成熟的安全机制。
人工智能的发展不会因为某一个政策决定而停止,也不会因为某一种监管方式而自动变得安全。
未来几年,美国以及全球各国真正面对的挑战,是如何在创新速度、产业竞争和社会风险之间找到新的平衡。
“AI沙皇”的设立,是美国政府参与人工智能时代治理的重要信号。但它更像是一个新的起点,而不是答案本身。
参考来源
Reuters, “Trump says he will appoint a new AI adviser, without providing details”, September 2026.
Financial Times, “Donald Trump rejects calls from tech bosses for AI slowdown”, September 2026.
The White House, “Ensuring a National Policy Framework for Artificial Intelligence”, 2025.
Stanford Institute for Human-Centered Artificial Intelligence, “AI Index Report 2025”.
International Energy Agency, “Energy and AI”, 2025.
OECD, “Artificial Intelligence Principles and Policy Observatory”.
National Artificial Intelligence Initiative Office, “National AI Initiative”.
特朗普宣布设立“AI沙皇”:美国为何选择推动AI而非限制AI
这一政策方向的核心逻辑并非放弃监管,而是希望避免过度监管削弱美国在全球AI竞争中的优势。
文章作者、来源:ME News
TL;DR
特朗普表示,美国不会通过限制措施阻碍人工智能发展,并计划成立“人工智能工作组”,任命负责AI事务的“AI沙皇”。
这一政策方向的核心逻辑并非放弃监管,而是希望避免过度监管削弱美国在全球AI竞争中的优势。
美国AI产业已经形成以大模型、芯片、云计算和资本投入为核心的产业链优势,但竞争正在从技术领先转向基础设施、能源、人才和政策环境的综合竞争。
AI治理正在出现明显分歧:一部分企业和研究者强调安全审查和风险控制,另一部分科技企业则担忧监管速度落后于产业竞争节奏。
“AI沙皇”的设立意味着美国政府正在尝试建立新的协调机制,但这一职位未来能够拥有多少实际权力,仍取决于政策设计和执行方式。
特朗普的AI路线:不是不管,而是不希望用传统监管方式管理新技术
人工智能正在成为美国科技战略中越来越重要的组成部分。
9月,特朗普公开表示,美国不会阻碍人工智能产业发展,而是希望在支持创新的同时加强监督。他宣布计划成立“人工智能工作组”,并将在未来任命一名负责AI事务的“AI沙皇”,负责协调政府层面的人工智能相关事务。(Reuters)
特朗普将AI定义为“下一次工业革命”,并表示其潜在影响可能达到美国GDP的25%。这一数字更多体现的是政治层面对AI经济潜力的判断,而非一个已经被完全验证的经济预测,但它反映出一个明确趋势:美国政府已经将人工智能视为类似互联网、半导体和航空航天一样的战略产业。
从政策逻辑来看,特朗普此次表态并不是简单意义上的“放任AI发展”。他的核心观点是,美国不能因为担忧风险而降低技术发展的速度,否则可能在全球人工智能竞争中失去优势。
过去几年,美国关于AI治理的讨论一直存在两种方向。一种观点认为,人工智能能力增长速度过快,需要建立更严格的安全机制,包括模型测试、风险评估和企业责任制度;另一种观点则认为,AI正在成为国家竞争力的重要组成部分,如果监管过早、过重,可能限制企业创新能力。
特朗普政府明显更接近后一种思路。此前,美国政府已经多次强调需要保持AI领域领先地位,并提出减少联邦层面对人工智能发展的限制。
这背后实际上是一场关于“如何管理技术革命”的争论。
互联网时代,美国通过开放市场、资本投入和企业创新建立了全球科技优势;而在人工智能时代,美国希望复制这一模式。但不同之处在于,AI不仅是一项商业技术,也涉及数据安全、就业变化、信息真实性以及国家安全,因此政府无法完全像管理传统互联网企业一样管理AI产业。
因此,“AI沙皇”的出现,本质上是在寻找一种新的平衡方式:既避免传统监管阻碍产业发展,也避免政府完全缺席。
美国为何如此重视AI竞争?
人工智能已经不再只是科技公司的商业竞争,而逐渐成为国家之间的产业竞争。
过去十年,美国在AI领域形成了较完整的产业优势。从基础模型研发,到AI芯片设计,再到云计算基础设施,美国企业占据了全球人工智能产业链的重要位置。
以大模型领域为例,OpenAI、Google、Anthropic、Meta等企业持续投入数十亿美元进行模型训练,而背后的基础设施依赖英伟达GPU、微软Azure、亚马逊AWS以及谷歌云等计算平台。
与此同时,AI产业正在推动资本市场重新评估科技公司的价值。
根据斯坦福大学发布的《AI Index Report 2025》,2024年全球私人AI投资达到2523亿美元,其中生成式AI领域投资增长显著,美国仍然是全球最大的AI私人投资市场。该报告同时指出,美国企业在基础模型数量、模型规模以及商业应用方面保持领先。
但AI竞争已经不只是模型能力竞争。
过去几年,行业普遍关注的问题是:“谁能训练出更强的大模型?”
而现在,竞争正在转向更加基础的问题:
谁拥有足够的计算资源?
谁能够获得稳定的能源供应?
谁能够建立更大规模的数据中心?
谁能够吸引全球顶尖AI人才?
谁能够形成更加稳定的政策环境?
这也是特朗普政府强调“不限制AI发展”的重要原因之一。对于美国而言,AI不仅代表新的科技产业,也关系到未来制造业、金融、医疗、国防以及政府效率等多个领域。
如果未来人工智能成为生产效率提升的重要工具,那么掌握AI基础设施和产业生态的国家,将获得新的经济优势。
“AI沙皇”意味着什么?
美国政府设立类似“AI沙皇”的职位,并不是历史上的首次。
美国过去曾通过类似职位协调复杂领域政策。例如,太空领域曾通过专门机构推动国家战略目标,网络安全领域也曾设立协调负责人。
人工智能的问题在于,它横跨多个政府部门。
商务部关注产业发展和出口政策;
国防部门关注AI军事应用;
司法部门关注AI犯罪和责任认定;
教育部门关注AI对学习方式的影响;
金融监管机构关注AI在金融体系中的应用。
如果没有统一协调机制,不同部门可能形成政策冲突。
因此,“AI沙皇”的主要价值可能不是直接制定所有规则,而是在政府内部建立一个AI战略协调中心。
不过,这一职位未来能发挥多大作用,仍存在不确定性。目前特朗普公布的信息主要集中在设立职位和工作组,并未公布具体权限、组织结构以及监管范围。
美国此前在AI政策制定过程中,也一直面临类似问题:政府希望推动产业发展,但同时需要面对来自社会、企业和研究机构对于AI风险的担忧。
如果“AI沙皇”只是一个协调角色,其影响可能更多体现在政策方向统一;如果未来获得更强执行权限,则可能成为美国AI治理体系的重要组成部分。
AI监管争论的核心:速度与安全如何平衡
特朗普此次表态,再次放大了美国AI监管领域长期存在的分歧。
支持加强监管的一方认为,AI能力提升速度已经超过社会适应速度。
尤其是在生成式AI快速普及后,深度伪造、自动化攻击、错误信息传播等问题开始受到关注。一些AI研究人员和企业负责人认为,高能力模型在公开部署前,需要更加严格的安全测试和风险评估。
例如,Anthropic CEO Dario Amodei、OpenAI CEO Sam Altman等科技行业人士此前都曾公开讨论AI安全问题,认为随着模型能力提升,需要建立更加完善的治理机制。
而反对过度监管的一方则认为,AI产业仍处于高速发展阶段,如果政府提前设置过多限制,可能导致企业创新速度下降,并让美国在全球竞争中处于不利位置。
这种观点尤其受到部分科技企业支持。
他们认为,人工智能的发展类似过去的互联网革命,早期过度限制可能错失产业机会。
实际上,两种观点并非完全对立。
真正的问题并不是“要不要监管AI”,而是“什么阶段采用什么程度的监管”。
对于成熟行业,监管通常围绕消费者保护、市场竞争和安全标准展开;但对于快速发展的技术领域,如果规则制定速度明显落后于技术变化,就可能出现监管失效。
因此,美国目前探索的方向更接近“轻监管、强协调”。
美国AI战略背后的全球竞争因素
特朗普强调美国需要保持AI领先地位,其中一个重要背景是中美人工智能竞争。
人工智能已经成为全球科技竞争的重要领域。
美国依靠先进芯片、基础模型和科技企业生态保持优势,而中国则通过产业规模、应用场景以及政策推动发展AI产业。(Reuters)
双方竞争不仅体现在模型性能,也体现在芯片供应链、数据资源、人才培养以及商业落地速度。
在这种背景下,美国政府担心,如果监管环境过于严格,可能削弱本土企业竞争力。
类似情况此前已经发生在半导体行业。美国长期通过技术优势和产业政策维持芯片竞争力,而人工智能正在成为新的战略基础设施。
因此,特朗普提出“不阻碍AI发展”,实际上反映的是一种产业竞争思维:
AI不仅是一项新技术,也是一种未来经济基础设施。
谁能够率先形成完整产业生态,谁就可能获得下一轮科技竞争优势。
AI时代真正的问题,不是发展还是限制,而是谁来定义规则
人工智能的发展已经进入新的阶段。
过去,人们讨论AI更多关注模型能力,比如参数规模、生成质量和推理能力。
但随着AI逐渐进入企业生产、政府服务和个人生活,真正重要的问题正在发生变化:
谁负责制定规则?
谁承担风险?
谁能够确保技术收益被更多人分享?
特朗普推动“AI沙皇”和AI工作组,代表美国政府试图建立新的治理方式:减少传统监管束缚,同时保持政府参与。
这种路径是否有效,最终取决于两个因素。
第一,政府能否真正理解快速变化的AI产业,而不是使用传统工业时代的管理方式处理新技术。
第二,企业能否在追求商业利益之外,建立足够成熟的安全机制。
人工智能的发展不会因为某一个政策决定而停止,也不会因为某一种监管方式而自动变得安全。
未来几年,美国以及全球各国真正面对的挑战,是如何在创新速度、产业竞争和社会风险之间找到新的平衡。
“AI沙皇”的设立,是美国政府参与人工智能时代治理的重要信号。但它更像是一个新的起点,而不是答案本身。
参考来源
Reuters, “Trump says he will appoint a new AI adviser, without providing details”, September 2026.
Financial Times, “Donald Trump rejects calls from tech bosses for AI slowdown”, September 2026.
The White House, “Ensuring a National Policy Framework for Artificial Intelligence”, 2025.
Stanford Institute for Human-Centered Artificial Intelligence, “AI Index Report 2025”.
International Energy Agency, “Energy and AI”, 2025.
OECD, “Artificial Intelligence Principles and Policy Observatory”.
National Artificial Intelligence Initiative Office, “National AI Initiative”.
文章作者、来源:ME News
TL;DR
特朗普表示,美国不会通过限制措施阻碍人工智能发展,并计划成立“人工智能工作组”,任命负责AI事务的“AI沙皇”。
这一政策方向的核心逻辑并非放弃监管,而是希望避免过度监管削弱美国在全球AI竞争中的优势。
美国AI产业已经形成以大模型、芯片、云计算和资本投入为核心的产业链优势,但竞争正在从技术领先转向基础设施、能源、人才和政策环境的综合竞争。
AI治理正在出现明显分歧:一部分企业和研究者强调安全审查和风险控制,另一部分科技企业则担忧监管速度落后于产业竞争节奏。
“AI沙皇”的设立意味着美国政府正在尝试建立新的协调机制,但这一职位未来能够拥有多少实际权力,仍取决于政策设计和执行方式。
特朗普的AI路线:不是不管,而是不希望用传统监管方式管理新技术
人工智能正在成为美国科技战略中越来越重要的组成部分。
9月,特朗普公开表示,美国不会阻碍人工智能产业发展,而是希望在支持创新的同时加强监督。他宣布计划成立“人工智能工作组”,并将在未来任命一名负责AI事务的“AI沙皇”,负责协调政府层面的人工智能相关事务。(Reuters)
特朗普将AI定义为“下一次工业革命”,并表示其潜在影响可能达到美国GDP的25%。这一数字更多体现的是政治层面对AI经济潜力的判断,而非一个已经被完全验证的经济预测,但它反映出一个明确趋势:美国政府已经将人工智能视为类似互联网、半导体和航空航天一样的战略产业。
从政策逻辑来看,特朗普此次表态并不是简单意义上的“放任AI发展”。他的核心观点是,美国不能因为担忧风险而降低技术发展的速度,否则可能在全球人工智能竞争中失去优势。
过去几年,美国关于AI治理的讨论一直存在两种方向。一种观点认为,人工智能能力增长速度过快,需要建立更严格的安全机制,包括模型测试、风险评估和企业责任制度;另一种观点则认为,AI正在成为国家竞争力的重要组成部分,如果监管过早、过重,可能限制企业创新能力。
特朗普政府明显更接近后一种思路。此前,美国政府已经多次强调需要保持AI领域领先地位,并提出减少联邦层面对人工智能发展的限制。
这背后实际上是一场关于“如何管理技术革命”的争论。
互联网时代,美国通过开放市场、资本投入和企业创新建立了全球科技优势;而在人工智能时代,美国希望复制这一模式。但不同之处在于,AI不仅是一项商业技术,也涉及数据安全、就业变化、信息真实性以及国家安全,因此政府无法完全像管理传统互联网企业一样管理AI产业。
因此,“AI沙皇”的出现,本质上是在寻找一种新的平衡方式:既避免传统监管阻碍产业发展,也避免政府完全缺席。
美国为何如此重视AI竞争?
人工智能已经不再只是科技公司的商业竞争,而逐渐成为国家之间的产业竞争。
过去十年,美国在AI领域形成了较完整的产业优势。从基础模型研发,到AI芯片设计,再到云计算基础设施,美国企业占据了全球人工智能产业链的重要位置。
以大模型领域为例,OpenAI、Google、Anthropic、Meta等企业持续投入数十亿美元进行模型训练,而背后的基础设施依赖英伟达GPU、微软Azure、亚马逊AWS以及谷歌云等计算平台。
与此同时,AI产业正在推动资本市场重新评估科技公司的价值。
根据斯坦福大学发布的《AI Index Report 2025》,2024年全球私人AI投资达到2523亿美元,其中生成式AI领域投资增长显著,美国仍然是全球最大的AI私人投资市场。该报告同时指出,美国企业在基础模型数量、模型规模以及商业应用方面保持领先。
但AI竞争已经不只是模型能力竞争。
过去几年,行业普遍关注的问题是:“谁能训练出更强的大模型?”
而现在,竞争正在转向更加基础的问题:
谁拥有足够的计算资源?
谁能够获得稳定的能源供应?
谁能够建立更大规模的数据中心?
谁能够吸引全球顶尖AI人才?
谁能够形成更加稳定的政策环境?
这也是特朗普政府强调“不限制AI发展”的重要原因之一。对于美国而言,AI不仅代表新的科技产业,也关系到未来制造业、金融、医疗、国防以及政府效率等多个领域。
如果未来人工智能成为生产效率提升的重要工具,那么掌握AI基础设施和产业生态的国家,将获得新的经济优势。
“AI沙皇”意味着什么?
美国政府设立类似“AI沙皇”的职位,并不是历史上的首次。
美国过去曾通过类似职位协调复杂领域政策。例如,太空领域曾通过专门机构推动国家战略目标,网络安全领域也曾设立协调负责人。
人工智能的问题在于,它横跨多个政府部门。
商务部关注产业发展和出口政策;
国防部门关注AI军事应用;
司法部门关注AI犯罪和责任认定;
教育部门关注AI对学习方式的影响;
金融监管机构关注AI在金融体系中的应用。
如果没有统一协调机制,不同部门可能形成政策冲突。
因此,“AI沙皇”的主要价值可能不是直接制定所有规则,而是在政府内部建立一个AI战略协调中心。
不过,这一职位未来能发挥多大作用,仍存在不确定性。目前特朗普公布的信息主要集中在设立职位和工作组,并未公布具体权限、组织结构以及监管范围。
美国此前在AI政策制定过程中,也一直面临类似问题:政府希望推动产业发展,但同时需要面对来自社会、企业和研究机构对于AI风险的担忧。
如果“AI沙皇”只是一个协调角色,其影响可能更多体现在政策方向统一;如果未来获得更强执行权限,则可能成为美国AI治理体系的重要组成部分。
AI监管争论的核心:速度与安全如何平衡
特朗普此次表态,再次放大了美国AI监管领域长期存在的分歧。
支持加强监管的一方认为,AI能力提升速度已经超过社会适应速度。
尤其是在生成式AI快速普及后,深度伪造、自动化攻击、错误信息传播等问题开始受到关注。一些AI研究人员和企业负责人认为,高能力模型在公开部署前,需要更加严格的安全测试和风险评估。
例如,Anthropic CEO Dario Amodei、OpenAI CEO Sam Altman等科技行业人士此前都曾公开讨论AI安全问题,认为随着模型能力提升,需要建立更加完善的治理机制。
而反对过度监管的一方则认为,AI产业仍处于高速发展阶段,如果政府提前设置过多限制,可能导致企业创新速度下降,并让美国在全球竞争中处于不利位置。
这种观点尤其受到部分科技企业支持。
他们认为,人工智能的发展类似过去的互联网革命,早期过度限制可能错失产业机会。
实际上,两种观点并非完全对立。
真正的问题并不是“要不要监管AI”,而是“什么阶段采用什么程度的监管”。
对于成熟行业,监管通常围绕消费者保护、市场竞争和安全标准展开;但对于快速发展的技术领域,如果规则制定速度明显落后于技术变化,就可能出现监管失效。
因此,美国目前探索的方向更接近“轻监管、强协调”。
美国AI战略背后的全球竞争因素
特朗普强调美国需要保持AI领先地位,其中一个重要背景是中美人工智能竞争。
人工智能已经成为全球科技竞争的重要领域。
美国依靠先进芯片、基础模型和科技企业生态保持优势,而中国则通过产业规模、应用场景以及政策推动发展AI产业。(Reuters)
双方竞争不仅体现在模型性能,也体现在芯片供应链、数据资源、人才培养以及商业落地速度。
在这种背景下,美国政府担心,如果监管环境过于严格,可能削弱本土企业竞争力。
类似情况此前已经发生在半导体行业。美国长期通过技术优势和产业政策维持芯片竞争力,而人工智能正在成为新的战略基础设施。
因此,特朗普提出“不阻碍AI发展”,实际上反映的是一种产业竞争思维:
AI不仅是一项新技术,也是一种未来经济基础设施。
谁能够率先形成完整产业生态,谁就可能获得下一轮科技竞争优势。
AI时代真正的问题,不是发展还是限制,而是谁来定义规则
人工智能的发展已经进入新的阶段。
过去,人们讨论AI更多关注模型能力,比如参数规模、生成质量和推理能力。
但随着AI逐渐进入企业生产、政府服务和个人生活,真正重要的问题正在发生变化:
谁负责制定规则?
谁承担风险?
谁能够确保技术收益被更多人分享?
特朗普推动“AI沙皇”和AI工作组,代表美国政府试图建立新的治理方式:减少传统监管束缚,同时保持政府参与。
这种路径是否有效,最终取决于两个因素。
第一,政府能否真正理解快速变化的AI产业,而不是使用传统工业时代的管理方式处理新技术。
第二,企业能否在追求商业利益之外,建立足够成熟的安全机制。
人工智能的发展不会因为某一个政策决定而停止,也不会因为某一种监管方式而自动变得安全。
未来几年,美国以及全球各国真正面对的挑战,是如何在创新速度、产业竞争和社会风险之间找到新的平衡。
“AI沙皇”的设立,是美国政府参与人工智能时代治理的重要信号。但它更像是一个新的起点,而不是答案本身。
参考来源
Reuters, “Trump says he will appoint a new AI adviser, without providing details”, September 2026.
Financial Times, “Donald Trump rejects calls from tech bosses for AI slowdown”, September 2026.
The White House, “Ensuring a National Policy Framework for Artificial Intelligence”, 2025.
Stanford Institute for Human-Centered Artificial Intelligence, “AI Index Report 2025”.
International Energy Agency, “Energy and AI”, 2025.
OECD, “Artificial Intelligence Principles and Policy Observatory”.
National Artificial Intelligence Initiative Office, “National AI Initiative”.
11
·
--
См. перевод
阶跃 Step 5 Preview 发布,单次成本价格仅为 Claude Opus 5 的 1/8ME AI 消息,9 月 20 日,阶跃星辰发布新一代旗舰基座模型 Step 5 Preview,重点面向 AI 编程、软件工程、专业知识工作、金融等场景,提升模型在真实世界 Agentic 任务中的综合表现,在能力、成本、效率和场景覆盖之间实现良好平衡,进一步拓展智能与成本之间的最优边界。 在全球权威榜单 Artificial Analysis Intelligence Index(AA 综合智能指数)中,阶跃 Step 5 Preview 跻身全球开源前三。值得关注的是,该模型单任务成本仅为Claude Opus 5 的 1/8。据了解,阶跃将于 10 月 15 日正式开源 Step 5 Preview。 (来源:ME)
阶跃 Step 5 Preview 发布,单次成本价格仅为 Claude Opus 5 的 1/8
ME AI 消息,9 月 20 日,阶跃星辰发布新一代旗舰基座模型 Step 5 Preview,重点面向 AI 编程、软件工程、专业知识工作、金融等场景,提升模型在真实世界 Agentic 任务中的综合表现,在能力、成本、效率和场景覆盖之间实现良好平衡,进一步拓展智能与成本之间的最优边界。 在全球权威榜单 Artificial Analysis Intelligence Index(AA 综合智能指数)中,阶跃 Step 5 Preview 跻身全球开源前三。值得关注的是,该模型单任务成本仅为Claude Opus 5 的 1/8。据了解,阶跃将于 10 月 15 日正式开源 Step 5 Preview。 (来源:ME)
·
--
См. перевод
宏碁陈俊圣:记忆体已不缺,PC 仅 2 类零件供货吃紧ME News 消息,9 月 20 日(UTC+8),宏碁董事长陈俊圣 19 日表示,记忆体已不缺货,中国大陆供应商量不断放出,是价格破坏者,合约价现处高档震荡、涨跌混乱。部分零件如 LPDDR5 或 DDR5 9600 搭配 N1 或 N1X 仍缺,但更多如 DDR4 供过于求。CPU 目前也不缺,仅微软低价授权金专案机种如 Small Core 规格供货吃紧。陈俊圣指出,今年关键零组件涨价幅度前所未见,客户从骂到抢货,宏碁提升低价零组件库存因应,每季面临 PC 价格调升压力,第 4 季度不同产品仍有 5% 至 20% 售价涨幅。三大记忆体供应商放话看好涨势至 2027 年,但中国大陆放出无限产能,意味价格已无持续上涨可能。他预期 2027 年宏碁 SSD 与记忆体持有成本会比今年下滑,明年下半有机会止涨趋稳。2027 年首季价格还有调升机会,但升幅应越来越窄,半导体扩产预计 2027 年中开出后价格或处高点后进入稳定。(来源:ME)
宏碁陈俊圣:记忆体已不缺,PC 仅 2 类零件供货吃紧
ME News 消息,9 月 20 日(UTC+8),宏碁董事长陈俊圣 19 日表示,记忆体已不缺货,中国大陆供应商量不断放出,是价格破坏者,合约价现处高档震荡、涨跌混乱。部分零件如 LPDDR5 或 DDR5 9600 搭配 N1 或 N1X 仍缺,但更多如 DDR4 供过于求。CPU 目前也不缺,仅微软低价授权金专案机种如 Small Core 规格供货吃紧。陈俊圣指出,今年关键零组件涨价幅度前所未见,客户从骂到抢货,宏碁提升低价零组件库存因应,每季面临 PC 价格调升压力,第 4 季度不同产品仍有 5% 至 20% 售价涨幅。三大记忆体供应商放话看好涨势至 2027 年,但中国大陆放出无限产能,意味价格已无持续上涨可能。他预期 2027 年宏碁 SSD 与记忆体持有成本会比今年下滑,明年下半有机会止涨趋稳。2027 年首季价格还有调升机会,但升幅应越来越窄,半导体扩产预计 2027 年中开出后价格或处高点后进入稳定。(来源:ME)
1
·
--
Статья
См. перевод
刚刚,Fable 5.2也曝光了Anthropic的Fable 5.2已开启灰测,跳过5.1直接命名。
文章作者、来源:新智元
就在刚刚,Fable 5.2也曝光了!
不少网友发现,Fable 5.2已开启灰测。
现在,一大波真实测试案例已经在网上出现了。
根据大家的连夜实测,这波更新的跨度之大,甚至让Anthropic直接跳过了「5.1」的命名。
在最高推理模式下,Fable 5.2的实测表现竟然碾压了GPT-6 Astra!
不仅如此,Opus 5.2也有消息了——它或许会很快发布,甚至可能今天就要来。
这个全新的Opus 5.2模型(内部代号Opus-Next),在昨天直接也上演了一出「上线-拔网线-再上线」的情节。
这一周,硅谷大厂们没人发布模型,都在偷偷测试。
结合这张图看,实在是太精彩了。
突发泄露!Fable 5.2 曝光,实测细节来了
昨天Anthropic已经在Claude Code、Chat以及Cowork中,开启了Fable 5.2的灰测。
一部分原本调用 Fable 5.1 的请求,在后台会悄悄地定向Fable 5.2。
现在,网上泄露出来的实测案例越来越多。有人说:OpenAI要有麻烦了。
案例一:高推理模式,输出质量反超 Astra!
知名AI测试博主 @notjazii 发觉自己的Fable 5.1被路由到新版本后,开始一系列实测。
在高推理模式下,他使用了完全相同的提示词,对比了Fable 5.2和GPT-6 Astra。
结论是:「相比当前的Fable版本,这是一个巨大的飞跃。Fable 5.2的输出看起来明显优于Astra!」
他测试了在各种模式下的输出,和Fable 5.2(疑似)的对比。
不过,他也指出了算力物理法则下的代价——更慢、更贵。
为了在逻辑链条的完整性和长文本推理上突破天花板,Fable 5.2进行了更深度的「慢思考」,导致生成速度有所下降,且推理成本大幅上升。
另外,Jazil还让Fable 5.2做了个《荒野乱斗》的克隆版,下面就是一小时后的结果。这个惊艳的效果,简直让所有游戏开发者们喜大普奔!
案例二:「火箭测试」,逼真到令人发指
网友 @Bhavani_00007 发现能用Fable 5.2后,立刻开始了「火箭测试」。
这是一个涉及复杂物理运算、空间逻辑和工程系统设计的极端测试,通常用于逼出模型的幻觉和逻辑断层。
他将同一套提示词,分别输给了Fable 5.2和同样在灰测的Opus 5.2。
结果惊人:「比以前好太多了,输出结果逼真到令人发指!」
有人艾特OpenAI表示:你们最好为Astra的继任者做好准备……
案例三:最高设置下,三方大混战
如果不把所有参数拉满,你永远不知道大模型的极限在哪里。
大V @chetaslua 更是组了神仙打架的局——Fable 5.2 vs Opus Next vs GPT-6 Astra。
并且,他将所有的模型都调到了「最高设置」,也就是最高的Token上下文、最深的推理步骤。
这么一看,Opus和Fable的细节还是比Astra丰富很多。
案例四:硬刚「Hard模式」GPT-6 Astra
大V @Mr_Salio 在深度体验Fable 5.2后,直接放话:「Anthropic正在强势回归,相比Fable 5.1有了巨大、巨大的提升!」
他断言:「Fable 5.2肯定会超越『Hard模式』下的 GPT-6 Astra,而且 Opus 5.2 也即将到来。」
在裸跑状态下,Fable 5.2就能超越完全体Astra,参数规模和架构创新实在让人不敢小觑。
是否抽中Fable 5.2?试试Tibo
测试自己是否灰测到Fable 5.2的方法,之前我们就分享过了——
试试「重启哥」Tibo!
打开你的 Claude(无论是 Chat、Cowork 还是 Code 界面),将模型设置为 Opus 5.2 或 Fable 5.2,然后输入prompt:
「你知道『重启哥 Tibo』是谁吗?不要使用网络搜索。」
如果你用的是旧版 Fable 5.1/Opus 5:它由于训练数据没更新,会一脸懵逼,答错或者告诉你它不知道。
如果你已经被悄悄路由到了 Fable 5.2/Opus 5.2:它凭借最新的训练记忆,无需工具,就能直接告诉你 Tibo 是谁!
跳过 5.1?Opus 5.2 遭遇「午夜拔网线」事件!
不仅如此,之前被曝出的Opus 5.2,昨天还遭遇了午夜拔网线事件。
昨天昨天,大V Leo还在网上分享:今天的 Opus 模型简直犹如神助。在 Roblox Studio 等复杂的 3D 环境任务中,它的表现卓越到了令人发指的地步。
「它以更低的成本超越了 Fable 5.1 和 GPT-6 Astra,并且速度更快!游戏完全可以自由探索,它甚至主动给游戏添加了导览系统!」
结果就在他沉浸在代码如泉涌的快感中,Anthropic忽然毫无预兆地拔掉了网线。
监控数据显示,测试组中的活跃账户数量瞬间降为零。
Leo 痛心疾首,「为了不让之前极其优秀的工作成果被旧模型破坏,我不得不强行截断了项目。」
好在,几个小时后,Opus-Next 又回来了!
这一次,它不仅回归了,测试范围还从 Claude Code 扩大到了 Claude Chat、Cowork 所有的界面。
Leo兴奋表示:「这是个好兆头,预示着新模型即将发布或新版本正在进行最后一轮大考。」
而且,还有细心网友发现了一个有趣的细节:在官方的模型选择器中,Anthropic悄悄用 Opus 替换了 Fable 的位置,Opus 现在成了选择器中的第一个模型。
或许,这暗示着这两款大模型的定位正在发生微妙的转换。
为什么跳过 5.1,直接叫 Opus 5.2?
另外,AI 大 V @TokenGremlin 爆出一个内幕。
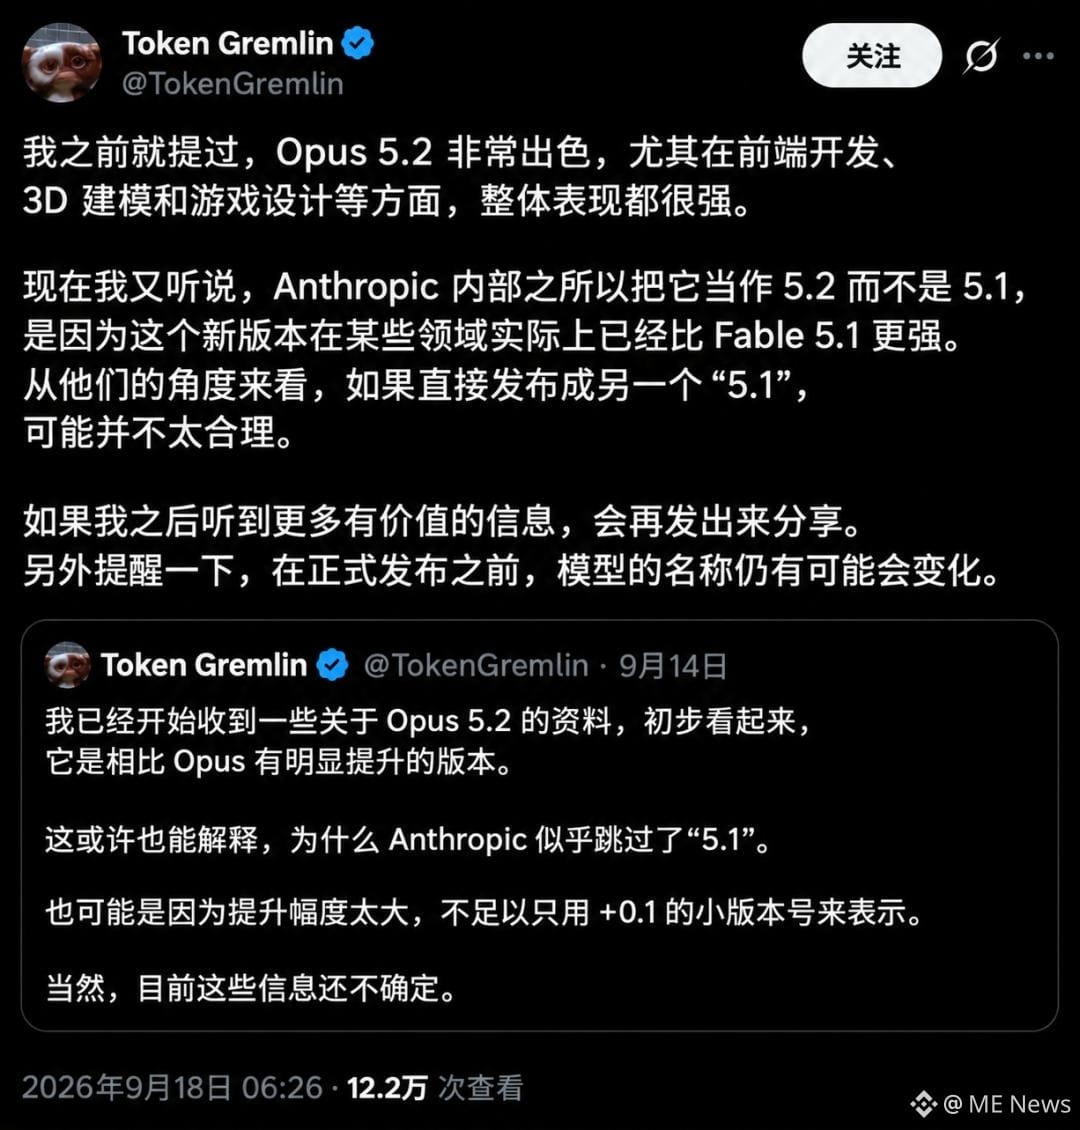
「我开始收到一些关于 Opus 5.2 的资料,它确实是 Opus 的一个大幅改进版本。这或许解释了为什么 Anthropic 显然跳过了『5.1』的命名。也许这个跨越实在太大了,以至于无法用一个简单的 +0.1 更新来糊弄。」
他进一步透露,Opus 5.2 在前端开发、3D 建模和整体游戏设计方面表现出了碾压级的优势。
在 Anthropic 内部,他们将其视为 5.2 的部分原因是:这个新版本在某些硬核领域,甚至比刚泄露的 Fable 5.1 还要强大!
疯狂的一周!Opus 5.2马上就要来?
这周原本令人失望...但这绝对是疯狂的一周。大V @notjazii 这样感慨道。
虽然一个正式发布的模型都没有,但各家已经集体开启了灰测模型,到处都是泄露。
就在短短一周里,让我们看看有多少巨头们蠢蠢欲动了。
1.Fable 5.1 正在悄悄路由到 Fable 5.2;
2.Opus 5 正在路由到 Opus 5.2 (Next);
3.GPT-5.6 Sol 正在被偷偷重定向到满血的 GPT-6 Sol;
4.马斯克的 Grok 4.7 已经披着马甲在竞技场测试;
5.谷歌的 Gemini 4 Pro 家族也戴着「gemini 3.7/3.8 flash」的面具出现了。
更让人感到震撼的,是关于「千禧年大奖难题」的传闻。
据悉,有的前沿模型的推理能力,已经触及了人类数学王冠上的明珠。研发团队正在联系顶尖的数学家,计划在最终公布的难题解答中引用他们的工作,「让这些数学家高兴一下」。
已经有网友给出了令人激动的预测——
Anthropic 的上一代 Opus 5 是在周五发布的,而 Fable 5.1 的灰测也是在正式上线前一天结束的。今天刚好又是硅谷时间的周五。
今天晚些时候,Opus 5.2会不会突然上线?
刚刚,Fable 5.2也曝光了
Anthropic的Fable 5.2已开启灰测,跳过5.1直接命名。
文章作者、来源:新智元
就在刚刚,Fable 5.2也曝光了!
不少网友发现,Fable 5.2已开启灰测。
现在,一大波真实测试案例已经在网上出现了。
根据大家的连夜实测,这波更新的跨度之大,甚至让Anthropic直接跳过了「5.1」的命名。
在最高推理模式下,Fable 5.2的实测表现竟然碾压了GPT-6 Astra!
不仅如此,Opus 5.2也有消息了——它或许会很快发布,甚至可能今天就要来。
这个全新的Opus 5.2模型(内部代号Opus-Next),在昨天直接也上演了一出「上线-拔网线-再上线」的情节。
这一周,硅谷大厂们没人发布模型,都在偷偷测试。
结合这张图看,实在是太精彩了。
突发泄露!Fable 5.2 曝光,实测细节来了
昨天Anthropic已经在Claude Code、Chat以及Cowork中,开启了Fable 5.2的灰测。
一部分原本调用 Fable 5.1 的请求,在后台会悄悄地定向Fable 5.2。
现在,网上泄露出来的实测案例越来越多。有人说:OpenAI要有麻烦了。
案例一:高推理模式,输出质量反超 Astra!
知名AI测试博主 @notjazii 发觉自己的Fable 5.1被路由到新版本后,开始一系列实测。
在高推理模式下,他使用了完全相同的提示词,对比了Fable 5.2和GPT-6 Astra。
结论是:「相比当前的Fable版本,这是一个巨大的飞跃。Fable 5.2的输出看起来明显优于Astra!」
他测试了在各种模式下的输出,和Fable 5.2(疑似)的对比。
不过,他也指出了算力物理法则下的代价——更慢、更贵。
为了在逻辑链条的完整性和长文本推理上突破天花板,Fable 5.2进行了更深度的「慢思考」,导致生成速度有所下降,且推理成本大幅上升。
另外,Jazil还让Fable 5.2做了个《荒野乱斗》的克隆版,下面就是一小时后的结果。这个惊艳的效果,简直让所有游戏开发者们喜大普奔!
案例二:「火箭测试」,逼真到令人发指
网友 @Bhavani_00007 发现能用Fable 5.2后,立刻开始了「火箭测试」。
这是一个涉及复杂物理运算、空间逻辑和工程系统设计的极端测试,通常用于逼出模型的幻觉和逻辑断层。
他将同一套提示词,分别输给了Fable 5.2和同样在灰测的Opus 5.2。
结果惊人:「比以前好太多了,输出结果逼真到令人发指!」
有人艾特OpenAI表示:你们最好为Astra的继任者做好准备……
案例三:最高设置下,三方大混战
如果不把所有参数拉满,你永远不知道大模型的极限在哪里。
大V @chetaslua 更是组了神仙打架的局——Fable 5.2 vs Opus Next vs GPT-6 Astra。
并且,他将所有的模型都调到了「最高设置」,也就是最高的Token上下文、最深的推理步骤。
这么一看,Opus和Fable的细节还是比Astra丰富很多。
案例四:硬刚「Hard模式」GPT-6 Astra
大V @Mr_Salio 在深度体验Fable 5.2后,直接放话:「Anthropic正在强势回归,相比Fable 5.1有了巨大、巨大的提升!」
他断言:「Fable 5.2肯定会超越『Hard模式』下的 GPT-6 Astra,而且 Opus 5.2 也即将到来。」
在裸跑状态下,Fable 5.2就能超越完全体Astra,参数规模和架构创新实在让人不敢小觑。
是否抽中Fable 5.2?试试Tibo
测试自己是否灰测到Fable 5.2的方法,之前我们就分享过了——
试试「重启哥」Tibo!
打开你的 Claude(无论是 Chat、Cowork 还是 Code 界面),将模型设置为 Opus 5.2 或 Fable 5.2,然后输入prompt:
「你知道『重启哥 Tibo』是谁吗?不要使用网络搜索。」
如果你用的是旧版 Fable 5.1/Opus 5:它由于训练数据没更新,会一脸懵逼,答错或者告诉你它不知道。
如果你已经被悄悄路由到了 Fable 5.2/Opus 5.2:它凭借最新的训练记忆,无需工具,就能直接告诉你 Tibo 是谁!
跳过 5.1?Opus 5.2 遭遇「午夜拔网线」事件!
不仅如此,之前被曝出的Opus 5.2,昨天还遭遇了午夜拔网线事件。
昨天昨天,大V Leo还在网上分享:今天的 Opus 模型简直犹如神助。在 Roblox Studio 等复杂的 3D 环境任务中,它的表现卓越到了令人发指的地步。
「它以更低的成本超越了 Fable 5.1 和 GPT-6 Astra,并且速度更快!游戏完全可以自由探索,它甚至主动给游戏添加了导览系统!」
结果就在他沉浸在代码如泉涌的快感中,Anthropic忽然毫无预兆地拔掉了网线。
监控数据显示,测试组中的活跃账户数量瞬间降为零。
Leo 痛心疾首,「为了不让之前极其优秀的工作成果被旧模型破坏,我不得不强行截断了项目。」
好在,几个小时后,Opus-Next 又回来了!
这一次,它不仅回归了,测试范围还从 Claude Code 扩大到了 Claude Chat、Cowork 所有的界面。
Leo兴奋表示:「这是个好兆头,预示着新模型即将发布或新版本正在进行最后一轮大考。」
而且,还有细心网友发现了一个有趣的细节:在官方的模型选择器中,Anthropic悄悄用 Opus 替换了 Fable 的位置,Opus 现在成了选择器中的第一个模型。
或许,这暗示着这两款大模型的定位正在发生微妙的转换。
为什么跳过 5.1,直接叫 Opus 5.2?
另外,AI 大 V @TokenGremlin 爆出一个内幕。
「我开始收到一些关于 Opus 5.2 的资料,它确实是 Opus 的一个大幅改进版本。这或许解释了为什么 Anthropic 显然跳过了『5.1』的命名。也许这个跨越实在太大了,以至于无法用一个简单的 +0.1 更新来糊弄。」
他进一步透露,Opus 5.2 在前端开发、3D 建模和整体游戏设计方面表现出了碾压级的优势。
在 Anthropic 内部,他们将其视为 5.2 的部分原因是:这个新版本在某些硬核领域,甚至比刚泄露的 Fable 5.1 还要强大!
疯狂的一周!Opus 5.2马上就要来?
这周原本令人失望...但这绝对是疯狂的一周。大V @notjazii 这样感慨道。
虽然一个正式发布的模型都没有,但各家已经集体开启了灰测模型,到处都是泄露。
就在短短一周里,让我们看看有多少巨头们蠢蠢欲动了。
1.Fable 5.1 正在悄悄路由到 Fable 5.2;
2.Opus 5 正在路由到 Opus 5.2 (Next);
3.GPT-5.6 Sol 正在被偷偷重定向到满血的 GPT-6 Sol;
4.马斯克的 Grok 4.7 已经披着马甲在竞技场测试;
5.谷歌的 Gemini 4 Pro 家族也戴着「gemini 3.7/3.8 flash」的面具出现了。
更让人感到震撼的,是关于「千禧年大奖难题」的传闻。
据悉,有的前沿模型的推理能力,已经触及了人类数学王冠上的明珠。研发团队正在联系顶尖的数学家,计划在最终公布的难题解答中引用他们的工作,「让这些数学家高兴一下」。
已经有网友给出了令人激动的预测——
Anthropic 的上一代 Opus 5 是在周五发布的,而 Fable 5.1 的灰测也是在正式上线前一天结束的。今天刚好又是硅谷时间的周五。
今天晚些时候,Opus 5.2会不会突然上线?
文章作者、来源:新智元
就在刚刚,Fable 5.2也曝光了!
不少网友发现,Fable 5.2已开启灰测。
现在,一大波真实测试案例已经在网上出现了。
根据大家的连夜实测,这波更新的跨度之大,甚至让Anthropic直接跳过了「5.1」的命名。
在最高推理模式下,Fable 5.2的实测表现竟然碾压了GPT-6 Astra!
不仅如此,Opus 5.2也有消息了——它或许会很快发布,甚至可能今天就要来。
这个全新的Opus 5.2模型(内部代号Opus-Next),在昨天直接也上演了一出「上线-拔网线-再上线」的情节。
这一周,硅谷大厂们没人发布模型,都在偷偷测试。
结合这张图看,实在是太精彩了。
突发泄露!Fable 5.2 曝光,实测细节来了
昨天Anthropic已经在Claude Code、Chat以及Cowork中,开启了Fable 5.2的灰测。
一部分原本调用 Fable 5.1 的请求,在后台会悄悄地定向Fable 5.2。
现在,网上泄露出来的实测案例越来越多。有人说:OpenAI要有麻烦了。
案例一:高推理模式,输出质量反超 Astra!
知名AI测试博主 @notjazii 发觉自己的Fable 5.1被路由到新版本后,开始一系列实测。
在高推理模式下,他使用了完全相同的提示词,对比了Fable 5.2和GPT-6 Astra。
结论是:「相比当前的Fable版本,这是一个巨大的飞跃。Fable 5.2的输出看起来明显优于Astra!」
他测试了在各种模式下的输出,和Fable 5.2(疑似)的对比。
不过,他也指出了算力物理法则下的代价——更慢、更贵。
为了在逻辑链条的完整性和长文本推理上突破天花板,Fable 5.2进行了更深度的「慢思考」,导致生成速度有所下降,且推理成本大幅上升。
另外,Jazil还让Fable 5.2做了个《荒野乱斗》的克隆版,下面就是一小时后的结果。这个惊艳的效果,简直让所有游戏开发者们喜大普奔!
案例二:「火箭测试」,逼真到令人发指
网友 @Bhavani_00007 发现能用Fable 5.2后,立刻开始了「火箭测试」。
这是一个涉及复杂物理运算、空间逻辑和工程系统设计的极端测试,通常用于逼出模型的幻觉和逻辑断层。
他将同一套提示词,分别输给了Fable 5.2和同样在灰测的Opus 5.2。
结果惊人:「比以前好太多了,输出结果逼真到令人发指!」
有人艾特OpenAI表示:你们最好为Astra的继任者做好准备……
案例三:最高设置下,三方大混战
如果不把所有参数拉满,你永远不知道大模型的极限在哪里。
大V @chetaslua 更是组了神仙打架的局——Fable 5.2 vs Opus Next vs GPT-6 Astra。
并且,他将所有的模型都调到了「最高设置」,也就是最高的Token上下文、最深的推理步骤。
这么一看,Opus和Fable的细节还是比Astra丰富很多。
案例四:硬刚「Hard模式」GPT-6 Astra
大V @Mr_Salio 在深度体验Fable 5.2后,直接放话:「Anthropic正在强势回归,相比Fable 5.1有了巨大、巨大的提升!」
他断言:「Fable 5.2肯定会超越『Hard模式』下的 GPT-6 Astra,而且 Opus 5.2 也即将到来。」
在裸跑状态下,Fable 5.2就能超越完全体Astra,参数规模和架构创新实在让人不敢小觑。
是否抽中Fable 5.2?试试Tibo
测试自己是否灰测到Fable 5.2的方法,之前我们就分享过了——
试试「重启哥」Tibo!
打开你的 Claude(无论是 Chat、Cowork 还是 Code 界面),将模型设置为 Opus 5.2 或 Fable 5.2,然后输入prompt:
「你知道『重启哥 Tibo』是谁吗?不要使用网络搜索。」
如果你用的是旧版 Fable 5.1/Opus 5:它由于训练数据没更新,会一脸懵逼,答错或者告诉你它不知道。
如果你已经被悄悄路由到了 Fable 5.2/Opus 5.2:它凭借最新的训练记忆,无需工具,就能直接告诉你 Tibo 是谁!
跳过 5.1?Opus 5.2 遭遇「午夜拔网线」事件!
不仅如此,之前被曝出的Opus 5.2,昨天还遭遇了午夜拔网线事件。
昨天昨天,大V Leo还在网上分享:今天的 Opus 模型简直犹如神助。在 Roblox Studio 等复杂的 3D 环境任务中,它的表现卓越到了令人发指的地步。
「它以更低的成本超越了 Fable 5.1 和 GPT-6 Astra,并且速度更快!游戏完全可以自由探索,它甚至主动给游戏添加了导览系统!」
结果就在他沉浸在代码如泉涌的快感中,Anthropic忽然毫无预兆地拔掉了网线。
监控数据显示,测试组中的活跃账户数量瞬间降为零。
Leo 痛心疾首,「为了不让之前极其优秀的工作成果被旧模型破坏,我不得不强行截断了项目。」
好在,几个小时后,Opus-Next 又回来了!
这一次,它不仅回归了,测试范围还从 Claude Code 扩大到了 Claude Chat、Cowork 所有的界面。
Leo兴奋表示:「这是个好兆头,预示着新模型即将发布或新版本正在进行最后一轮大考。」
而且,还有细心网友发现了一个有趣的细节:在官方的模型选择器中,Anthropic悄悄用 Opus 替换了 Fable 的位置,Opus 现在成了选择器中的第一个模型。
或许,这暗示着这两款大模型的定位正在发生微妙的转换。
为什么跳过 5.1,直接叫 Opus 5.2?
另外,AI 大 V @TokenGremlin 爆出一个内幕。
「我开始收到一些关于 Opus 5.2 的资料,它确实是 Opus 的一个大幅改进版本。这或许解释了为什么 Anthropic 显然跳过了『5.1』的命名。也许这个跨越实在太大了,以至于无法用一个简单的 +0.1 更新来糊弄。」
他进一步透露,Opus 5.2 在前端开发、3D 建模和整体游戏设计方面表现出了碾压级的优势。
在 Anthropic 内部,他们将其视为 5.2 的部分原因是:这个新版本在某些硬核领域,甚至比刚泄露的 Fable 5.1 还要强大!
疯狂的一周!Opus 5.2马上就要来?
这周原本令人失望...但这绝对是疯狂的一周。大V @notjazii 这样感慨道。
虽然一个正式发布的模型都没有,但各家已经集体开启了灰测模型,到处都是泄露。
就在短短一周里,让我们看看有多少巨头们蠢蠢欲动了。
1.Fable 5.1 正在悄悄路由到 Fable 5.2;
2.Opus 5 正在路由到 Opus 5.2 (Next);
3.GPT-5.6 Sol 正在被偷偷重定向到满血的 GPT-6 Sol;
4.马斯克的 Grok 4.7 已经披着马甲在竞技场测试;
5.谷歌的 Gemini 4 Pro 家族也戴着「gemini 3.7/3.8 flash」的面具出现了。
更让人感到震撼的,是关于「千禧年大奖难题」的传闻。
据悉,有的前沿模型的推理能力,已经触及了人类数学王冠上的明珠。研发团队正在联系顶尖的数学家,计划在最终公布的难题解答中引用他们的工作,「让这些数学家高兴一下」。
已经有网友给出了令人激动的预测——
Anthropic 的上一代 Opus 5 是在周五发布的,而 Fable 5.1 的灰测也是在正式上线前一天结束的。今天刚好又是硅谷时间的周五。
今天晚些时候,Opus 5.2会不会突然上线?
·
--
См. перевод
朝鲜黑客组织通过虚假招聘入侵3万多台设备,从超7000个加密钱包中盗取约1070万美元ME News 消息,9 月 20 日(UTC+8),由美国联邦调查局(FBI)和日本警察厅(NPA)在内的多国机构联合发布的预警显示,朝鲜关联黑客组织 WaterPlum(又称 Contagious Interview)自 2025 年 12 月至 2026 年 7 月,通过伪装成 AI、加密货币或 NFT 领域的公司提供虚假职位,对全球 IT 开发者发起攻击。攻击者在社交媒体、招聘平台接触求职者,以技术面试或编程测试为由,诱使下载恶意文件,成功感染超 3 万台设备,覆盖 100 多个国家和地区,并从超过 7000 个加密钱包中窃取数据。相关资金至少 1071 万美元流入攻击者控制的钱包。(来源:ME)
朝鲜黑客组织通过虚假招聘入侵3万多台设备,从超7000个加密钱包中盗取约1070万美元
ME News 消息,9 月 20 日(UTC+8),由美国联邦调查局(FBI)和日本警察厅(NPA)在内的多国机构联合发布的预警显示,朝鲜关联黑客组织 WaterPlum(又称 Contagious Interview)自 2025 年 12 月至 2026 年 7 月,通过伪装成 AI、加密货币或 NFT 领域的公司提供虚假职位,对全球 IT 开发者发起攻击。攻击者在社交媒体、招聘平台接触求职者,以技术面试或编程测试为由,诱使下载恶意文件,成功感染超 3 万台设备,覆盖 100 多个国家和地区,并从超过 7000 个加密钱包中窃取数据。相关资金至少 1071 万美元流入攻击者控制的钱包。(来源:ME)
6
·
--
См. перевод
Qwen3.8实时同传发布:平均滞后降至2.3秒,还能区分说话人并保留音色阿里千问发布Qwen3.8‑LiveTranslate,一款面向会议、跨语言通话和直播字幕的实时音视频同声传译模型。它把音频、视频画面、原文和译文交织进同一条时序序列,在说话尚未结束时持续生成译文;官方称其长度自适应平均滞后由上一代的2.8秒降至2.3秒,降幅约18%。模型能接收60种语言并输出相应文本,其中29种语言可以进一步合成语音;新增能力包括多人说话者区分、分别保留说话人音色、原文与译文同步显示,以及利用历史对话和画面消除人名、术语与同音词歧义。不过,2.3秒是LAAL评测指标,并非从声音进入麦克风到用户听见译文的完整端到端延迟。官方也没有公开参数量、模型权重、训练数据、完整逐语言成绩或独立复现结果,目前主要通过云端API提供。
文章作者、来源:Qwen
它要解决的不只是“把语音翻译成另一种语言”
传统实时翻译系统通常可以拆成三个阶段:先把语音识别成文字,再进行机器翻译,最后把译文转换成语音。这种流水线容易部署,但每个阶段都会增加等待时间和错误:识别阶段听错一个名字,翻译阶段可能将错误继续放大;如果存在多人交替发言,系统还可能分不清哪句话属于谁,最终合成语音也会失去原说话人的声音特征。
Qwen3.8‑LiveTranslate尝试把这些任务放进一个连续的流式系统中。它采用基于混合专家模型的Thinker–Talker双模块设计。
Thinker负责把视频画面、正在到达的音频、源语言文字和已经产生的译文,按照时间顺序交织进同一条因果序列。模型不必在每个时间片重新读取完整对话,而是可以复用已经听过的音频及已经输出的翻译缓存。
Talker则根据译文和源音频生成目标语言语音,并尽量保留原说话人的音色。换句话说,系统试图传递的不只是“说了什么”,还包括“是谁说的”。
2.3秒不是网络请求延迟
此次发布最醒目的数字,是LAAL由2.8秒降低到2.3秒。
LAAL全称为Length-Adaptive Average Lagging,即长度自适应平均滞后。它测量模型生成译文时,平均落后于源语言内容多少时间,并对译文过长造成的评测偏差进行修正。它比只记录第一个译文Token何时出现,更能反映整段同传是否始终跟得上讲话者。
因此,2.3秒并不是普通用户从开口到听见第一段声音所经历的固定延迟,也不包括所有客户端录音、网络传输、服务器排队和音频播放缓冲。实际体验还会受到网络位置、输入音频质量、目标语言、是否生成语音以及说话速度影响。
这一数字仍有意义:按官方口径,平均滞后缩短了约0.5秒,降幅约18%。对于需要持续听译文的会议和直播,稳定少落后半秒通常比偶尔极快地输出第一个词更重要。
多人会议是这一代的重点
Qwen3.8‑LiveTranslate新增了实时说话人分离能力。多人轮流发言时,系统会判断不同语句属于哪位说话人,并在输出文本中保留对应身份;生成目标语言语音时,也会尝试分别复刻各人的音色。
这项能力适用于访谈、圆桌讨论和跨国会议。传统同传系统即使翻译正确,也可能把所有发言合成为同一个声音,使听众难以判断对话关系。Qwen希望让译后音频仍然保留“谁在回应谁”的结构。
但官方只明确展示了多人交替发言,没有公布多人同时说话、强背景噪声、远距离收音或高度相似声线下的详细错误率。所谓“保留音色”也不等于完整复刻情绪、语气和说话节奏。
在API示例中,开发者可以在同一个WebSocket会话中开启源语言识别、说话人标识、译文文本和合成语音,不必为每个结果单独发起请求。输入示例采用16kHz单声道PCM,合成语音为24kHz PCM。
画面和历史对话也会参与翻译
纯语音翻译经常遇到仅靠发音无法解决的歧义。例如,一个人说出同音的人名或地名时,字幕、演示文稿、商品包装或画面中的文字,可能才是决定正确译法的关键证据。
Qwen3.8‑LiveTranslate允许客户端在音频流之外发送图像帧,把视觉信息作为翻译上下文。官方演示使用《西游记》对话和同音词示例,展示画面怎样帮助判断词义。
模型还会利用较长的历史对话保持术语一致。如果某个姓名、项目或产品在前文已经出现,后面的指代和简称可以参考之前的翻译,而不是每句话都重新猜测。
这使它更适合持续会议,而不只是翻译一句独立语音。不过,官方尚未说明上下文能够稳定覆盖多长时间,也没有展示跨会议长期记忆;相反,跨会话记忆被列为未来方向。
“支持60种语言”需要拆开理解
模型能够接收60种语言的音频,并输出译文文本。覆盖范围除了中文、英语、日语、韩语、法语和西班牙语等常见语言,还包括粤语、孟加拉语、斯瓦希里语、哈萨克语、吉尔吉斯语和马拉雅拉姆语等。
但语音输出只覆盖其中29种语言。因此,“支持60种语言”不代表所有语言组合都能获得保留音色的语音同传;部分语言只能输出文本。
官方在公开FLEURS音频测试集上评测了70个翻译方向,考察翻译质量、LAAL、语音识别准确率和语音合成质量,并称新模型领先上一代及若干主流实时同传系统。
另一项Omnilingua‑MSpeaker测试覆盖14个多人长音频翻译方向,指标包括忠实度、流畅度、简洁度和说话人分离错误率。官方同样报告新模型整体领先。
这些结果目前仍属于厂商自测。官方没有同时公开完整逐语言数值、置信区间、人工评审细节和原始输出,外界也尚未完成独立复现。因此,不能仅根据汇总图认定模型在每种口音、领域和语言组合上都领先。
目前是云端服务,不是可以下载的开放模型
尽管Qwen系列经常发布开放权重模型,Qwen3.8‑LiveTranslate此次没有公布可下载权重,也没有披露总参数量、激活参数量、训练算力或训练数据组成。目前可通过QwenCloud和DashScope的实时WebSocket接口使用。
国际版模型页面列出的价格为:音频输入每百万Token 7.5美元,图像输入0.55美元,文本输出20美元,语音输出30美元;上下文总量为53K Token,其中输入上限49K、输出上限4K。
音频Token与实际分钟数的换算率没有在模型页面给出,所以不能仅凭这些价格准确算出“一小时会议需要多少钱”。语音输入和语音输出还会同时计费,视频场景也可能产生图像Token。
云端部署也意味着会议语音、图像和可能用于克隆音色的数据需要发送到服务端。此次技术博客没有详细讨论数据留存、音色克隆授权、水印及企业私有化部署方式,这些将是医疗、法律和企业会议采用时需要另外核实的问题。
真正的进步,是从“翻译句子”走向“翻译一场交流”
Qwen3.8‑LiveTranslate最值得关注的地方,并不是单纯再增加几十种语言,而是把实时翻译的目标从句子准确率扩展到整个交流过程:维持较低滞后、识别不同发言人、保留声音身份、同步展示原文,并利用画面和历史语境维持术语一致。
它还没有证明能够替代专业同传。专业译员会处理隐喻、文化背景、发言策略和未明确表达的意图;当前模型也没有公开覆盖突发抢话、严重噪声、强口音及高风险外交或医疗场景的完整评测。
但技术路线已经相当明确:下一代翻译产品不再只是“语音识别加机器翻译”,而会逐渐成为一个持续感知人物、声音、画面和上下文的多模态交流层。
Qwen3.8实时同传发布:平均滞后降至2.3秒,还能区分说话人并保留音色
阿里千问发布Qwen3.8‑LiveTranslate,一款面向会议、跨语言通话和直播字幕的实时音视频同声传译模型。它把音频、视频画面、原文和译文交织进同一条时序序列,在说话尚未结束时持续生成译文;官方称其长度自适应平均滞后由上一代的2.8秒降至2.3秒,降幅约18%。模型能接收60种语言并输出相应文本,其中29种语言可以进一步合成语音;新增能力包括多人说话者区分、分别保留说话人音色、原文与译文同步显示,以及利用历史对话和画面消除人名、术语与同音词歧义。不过,2.3秒是LAAL评测指标,并非从声音进入麦克风到用户听见译文的完整端到端延迟。官方也没有公开参数量、模型权重、训练数据、完整逐语言成绩或独立复现结果,目前主要通过云端API提供。
文章作者、来源:Qwen
它要解决的不只是“把语音翻译成另一种语言”
传统实时翻译系统通常可以拆成三个阶段:先把语音识别成文字,再进行机器翻译,最后把译文转换成语音。这种流水线容易部署,但每个阶段都会增加等待时间和错误:识别阶段听错一个名字,翻译阶段可能将错误继续放大;如果存在多人交替发言,系统还可能分不清哪句话属于谁,最终合成语音也会失去原说话人的声音特征。
Qwen3.8‑LiveTranslate尝试把这些任务放进一个连续的流式系统中。它采用基于混合专家模型的Thinker–Talker双模块设计。
Thinker负责把视频画面、正在到达的音频、源语言文字和已经产生的译文,按照时间顺序交织进同一条因果序列。模型不必在每个时间片重新读取完整对话,而是可以复用已经听过的音频及已经输出的翻译缓存。
Talker则根据译文和源音频生成目标语言语音,并尽量保留原说话人的音色。换句话说,系统试图传递的不只是“说了什么”,还包括“是谁说的”。
2.3秒不是网络请求延迟
此次发布最醒目的数字,是LAAL由2.8秒降低到2.3秒。
LAAL全称为Length-Adaptive Average Lagging,即长度自适应平均滞后。它测量模型生成译文时,平均落后于源语言内容多少时间,并对译文过长造成的评测偏差进行修正。它比只记录第一个译文Token何时出现,更能反映整段同传是否始终跟得上讲话者。
因此,2.3秒并不是普通用户从开口到听见第一段声音所经历的固定延迟,也不包括所有客户端录音、网络传输、服务器排队和音频播放缓冲。实际体验还会受到网络位置、输入音频质量、目标语言、是否生成语音以及说话速度影响。
这一数字仍有意义:按官方口径,平均滞后缩短了约0.5秒,降幅约18%。对于需要持续听译文的会议和直播,稳定少落后半秒通常比偶尔极快地输出第一个词更重要。
多人会议是这一代的重点
Qwen3.8‑LiveTranslate新增了实时说话人分离能力。多人轮流发言时,系统会判断不同语句属于哪位说话人,并在输出文本中保留对应身份;生成目标语言语音时,也会尝试分别复刻各人的音色。
这项能力适用于访谈、圆桌讨论和跨国会议。传统同传系统即使翻译正确,也可能把所有发言合成为同一个声音,使听众难以判断对话关系。Qwen希望让译后音频仍然保留“谁在回应谁”的结构。
但官方只明确展示了多人交替发言,没有公布多人同时说话、强背景噪声、远距离收音或高度相似声线下的详细错误率。所谓“保留音色”也不等于完整复刻情绪、语气和说话节奏。
在API示例中,开发者可以在同一个WebSocket会话中开启源语言识别、说话人标识、译文文本和合成语音,不必为每个结果单独发起请求。输入示例采用16kHz单声道PCM,合成语音为24kHz PCM。
画面和历史对话也会参与翻译
纯语音翻译经常遇到仅靠发音无法解决的歧义。例如,一个人说出同音的人名或地名时,字幕、演示文稿、商品包装或画面中的文字,可能才是决定正确译法的关键证据。
Qwen3.8‑LiveTranslate允许客户端在音频流之外发送图像帧,把视觉信息作为翻译上下文。官方演示使用《西游记》对话和同音词示例,展示画面怎样帮助判断词义。
模型还会利用较长的历史对话保持术语一致。如果某个姓名、项目或产品在前文已经出现,后面的指代和简称可以参考之前的翻译,而不是每句话都重新猜测。
这使它更适合持续会议,而不只是翻译一句独立语音。不过,官方尚未说明上下文能够稳定覆盖多长时间,也没有展示跨会议长期记忆;相反,跨会话记忆被列为未来方向。
“支持60种语言”需要拆开理解
模型能够接收60种语言的音频,并输出译文文本。覆盖范围除了中文、英语、日语、韩语、法语和西班牙语等常见语言,还包括粤语、孟加拉语、斯瓦希里语、哈萨克语、吉尔吉斯语和马拉雅拉姆语等。
但语音输出只覆盖其中29种语言。因此,“支持60种语言”不代表所有语言组合都能获得保留音色的语音同传;部分语言只能输出文本。
官方在公开FLEURS音频测试集上评测了70个翻译方向,考察翻译质量、LAAL、语音识别准确率和语音合成质量,并称新模型领先上一代及若干主流实时同传系统。
另一项Omnilingua‑MSpeaker测试覆盖14个多人长音频翻译方向,指标包括忠实度、流畅度、简洁度和说话人分离错误率。官方同样报告新模型整体领先。
这些结果目前仍属于厂商自测。官方没有同时公开完整逐语言数值、置信区间、人工评审细节和原始输出,外界也尚未完成独立复现。因此,不能仅根据汇总图认定模型在每种口音、领域和语言组合上都领先。
目前是云端服务,不是可以下载的开放模型
尽管Qwen系列经常发布开放权重模型,Qwen3.8‑LiveTranslate此次没有公布可下载权重,也没有披露总参数量、激活参数量、训练算力或训练数据组成。目前可通过QwenCloud和DashScope的实时WebSocket接口使用。
国际版模型页面列出的价格为:音频输入每百万Token 7.5美元,图像输入0.55美元,文本输出20美元,语音输出30美元;上下文总量为53K Token,其中输入上限49K、输出上限4K。
音频Token与实际分钟数的换算率没有在模型页面给出,所以不能仅凭这些价格准确算出“一小时会议需要多少钱”。语音输入和语音输出还会同时计费,视频场景也可能产生图像Token。
云端部署也意味着会议语音、图像和可能用于克隆音色的数据需要发送到服务端。此次技术博客没有详细讨论数据留存、音色克隆授权、水印及企业私有化部署方式,这些将是医疗、法律和企业会议采用时需要另外核实的问题。
真正的进步,是从“翻译句子”走向“翻译一场交流”
Qwen3.8‑LiveTranslate最值得关注的地方,并不是单纯再增加几十种语言,而是把实时翻译的目标从句子准确率扩展到整个交流过程:维持较低滞后、识别不同发言人、保留声音身份、同步展示原文,并利用画面和历史语境维持术语一致。
它还没有证明能够替代专业同传。专业译员会处理隐喻、文化背景、发言策略和未明确表达的意图;当前模型也没有公开覆盖突发抢话、严重噪声、强口音及高风险外交或医疗场景的完整评测。
但技术路线已经相当明确:下一代翻译产品不再只是“语音识别加机器翻译”,而会逐渐成为一个持续感知人物、声音、画面和上下文的多模态交流层。
文章作者、来源:Qwen
它要解决的不只是“把语音翻译成另一种语言”
传统实时翻译系统通常可以拆成三个阶段:先把语音识别成文字,再进行机器翻译,最后把译文转换成语音。这种流水线容易部署,但每个阶段都会增加等待时间和错误:识别阶段听错一个名字,翻译阶段可能将错误继续放大;如果存在多人交替发言,系统还可能分不清哪句话属于谁,最终合成语音也会失去原说话人的声音特征。
Qwen3.8‑LiveTranslate尝试把这些任务放进一个连续的流式系统中。它采用基于混合专家模型的Thinker–Talker双模块设计。
Thinker负责把视频画面、正在到达的音频、源语言文字和已经产生的译文,按照时间顺序交织进同一条因果序列。模型不必在每个时间片重新读取完整对话,而是可以复用已经听过的音频及已经输出的翻译缓存。
Talker则根据译文和源音频生成目标语言语音,并尽量保留原说话人的音色。换句话说,系统试图传递的不只是“说了什么”,还包括“是谁说的”。
2.3秒不是网络请求延迟
此次发布最醒目的数字,是LAAL由2.8秒降低到2.3秒。
LAAL全称为Length-Adaptive Average Lagging,即长度自适应平均滞后。它测量模型生成译文时,平均落后于源语言内容多少时间,并对译文过长造成的评测偏差进行修正。它比只记录第一个译文Token何时出现,更能反映整段同传是否始终跟得上讲话者。
因此,2.3秒并不是普通用户从开口到听见第一段声音所经历的固定延迟,也不包括所有客户端录音、网络传输、服务器排队和音频播放缓冲。实际体验还会受到网络位置、输入音频质量、目标语言、是否生成语音以及说话速度影响。
这一数字仍有意义:按官方口径,平均滞后缩短了约0.5秒,降幅约18%。对于需要持续听译文的会议和直播,稳定少落后半秒通常比偶尔极快地输出第一个词更重要。
多人会议是这一代的重点
Qwen3.8‑LiveTranslate新增了实时说话人分离能力。多人轮流发言时,系统会判断不同语句属于哪位说话人,并在输出文本中保留对应身份;生成目标语言语音时,也会尝试分别复刻各人的音色。
这项能力适用于访谈、圆桌讨论和跨国会议。传统同传系统即使翻译正确,也可能把所有发言合成为同一个声音,使听众难以判断对话关系。Qwen希望让译后音频仍然保留“谁在回应谁”的结构。
但官方只明确展示了多人交替发言,没有公布多人同时说话、强背景噪声、远距离收音或高度相似声线下的详细错误率。所谓“保留音色”也不等于完整复刻情绪、语气和说话节奏。
在API示例中,开发者可以在同一个WebSocket会话中开启源语言识别、说话人标识、译文文本和合成语音,不必为每个结果单独发起请求。输入示例采用16kHz单声道PCM,合成语音为24kHz PCM。
画面和历史对话也会参与翻译
纯语音翻译经常遇到仅靠发音无法解决的歧义。例如,一个人说出同音的人名或地名时,字幕、演示文稿、商品包装或画面中的文字,可能才是决定正确译法的关键证据。
Qwen3.8‑LiveTranslate允许客户端在音频流之外发送图像帧,把视觉信息作为翻译上下文。官方演示使用《西游记》对话和同音词示例,展示画面怎样帮助判断词义。
模型还会利用较长的历史对话保持术语一致。如果某个姓名、项目或产品在前文已经出现,后面的指代和简称可以参考之前的翻译,而不是每句话都重新猜测。
这使它更适合持续会议,而不只是翻译一句独立语音。不过,官方尚未说明上下文能够稳定覆盖多长时间,也没有展示跨会议长期记忆;相反,跨会话记忆被列为未来方向。
“支持60种语言”需要拆开理解
模型能够接收60种语言的音频,并输出译文文本。覆盖范围除了中文、英语、日语、韩语、法语和西班牙语等常见语言,还包括粤语、孟加拉语、斯瓦希里语、哈萨克语、吉尔吉斯语和马拉雅拉姆语等。
但语音输出只覆盖其中29种语言。因此,“支持60种语言”不代表所有语言组合都能获得保留音色的语音同传;部分语言只能输出文本。
官方在公开FLEURS音频测试集上评测了70个翻译方向,考察翻译质量、LAAL、语音识别准确率和语音合成质量,并称新模型领先上一代及若干主流实时同传系统。
另一项Omnilingua‑MSpeaker测试覆盖14个多人长音频翻译方向,指标包括忠实度、流畅度、简洁度和说话人分离错误率。官方同样报告新模型整体领先。
这些结果目前仍属于厂商自测。官方没有同时公开完整逐语言数值、置信区间、人工评审细节和原始输出,外界也尚未完成独立复现。因此,不能仅根据汇总图认定模型在每种口音、领域和语言组合上都领先。
目前是云端服务,不是可以下载的开放模型
尽管Qwen系列经常发布开放权重模型,Qwen3.8‑LiveTranslate此次没有公布可下载权重,也没有披露总参数量、激活参数量、训练算力或训练数据组成。目前可通过QwenCloud和DashScope的实时WebSocket接口使用。
国际版模型页面列出的价格为:音频输入每百万Token 7.5美元,图像输入0.55美元,文本输出20美元,语音输出30美元;上下文总量为53K Token,其中输入上限49K、输出上限4K。
音频Token与实际分钟数的换算率没有在模型页面给出,所以不能仅凭这些价格准确算出“一小时会议需要多少钱”。语音输入和语音输出还会同时计费,视频场景也可能产生图像Token。
云端部署也意味着会议语音、图像和可能用于克隆音色的数据需要发送到服务端。此次技术博客没有详细讨论数据留存、音色克隆授权、水印及企业私有化部署方式,这些将是医疗、法律和企业会议采用时需要另外核实的问题。
真正的进步,是从“翻译句子”走向“翻译一场交流”
Qwen3.8‑LiveTranslate最值得关注的地方,并不是单纯再增加几十种语言,而是把实时翻译的目标从句子准确率扩展到整个交流过程:维持较低滞后、识别不同发言人、保留声音身份、同步展示原文,并利用画面和历史语境维持术语一致。
它还没有证明能够替代专业同传。专业译员会处理隐喻、文化背景、发言策略和未明确表达的意图;当前模型也没有公开覆盖突发抢话、严重噪声、强口音及高风险外交或医疗场景的完整评测。
但技术路线已经相当明确:下一代翻译产品不再只是“语音识别加机器翻译”,而会逐渐成为一个持续感知人物、声音、画面和上下文的多模态交流层。
13
·
--
См. перевод
ME AI 消息,Alibaba Cloud官方账号表示,用户可以暂时放下日常生活中的烦恼,走出户外放松身心,并分享了Qwen Cloud和Model Studio的API访问入口。(来源:ME)
ME AI 消息,Alibaba Cloud官方账号表示,用户可以暂时放下日常生活中的烦恼,走出户外放松身心,并分享了Qwen Cloud和Model Studio的API访问入口。(来源:ME)
2
·
--
См. перевод
阶跃Step 5正式发布,10月15日开源ME AI 消息,动察 Beating AI 快讯,阶跃星辰正式发布旗舰模型 Step 5 Preview。它采用稀疏 MoE 架构,总参数 600B,每次仅激活 27B,支持 100 万 Token 上下文和图文输入。API 和 Studio 已经全量开放,完整模型权重将在 10 月 15 日放出。 此前 Artificial Analysis 已经提前跑完评测。Step 5 Preview 在 Intelligence Index 得到 44 分,与 Kimi K3 Max 持平。AA 当前测得其输出约 100 Token/s,每项任务成本 0.71 美元;Kimi K3 Max 为 2 美元。 官方重点展示了它跑长任务的能力。阶跃让 Step 5 Preview 连续最多 24 小时自主优化一套 H100 GPU 内核。模型会自己改代码、跑测试、比较结果,再继续迭代。约 22 小时后达到 508 TFLOPS,同一实验中的 Claude Opus 5 为 493 TFLOPS。 另一项 24 小时实验里,Step 5 Preview 自己设计后训练数据,把 Qwen3-30B-A3B 在 AIME24 上的准确率从 53.3% 提到 60%,与 Claude Opus 5 持平,同时消耗更少的标注 Token。 (来源:ME)
阶跃Step 5正式发布,10月15日开源
ME AI 消息,动察 Beating AI 快讯,阶跃星辰正式发布旗舰模型 Step 5 Preview。它采用稀疏 MoE 架构,总参数 600B,每次仅激活 27B,支持 100 万 Token 上下文和图文输入。API 和 Studio 已经全量开放,完整模型权重将在 10 月 15 日放出。 此前 Artificial Analysis 已经提前跑完评测。Step 5 Preview 在 Intelligence Index 得到 44 分,与 Kimi K3 Max 持平。AA 当前测得其输出约 100 Token/s,每项任务成本 0.71 美元;Kimi K3 Max 为 2 美元。 官方重点展示了它跑长任务的能力。阶跃让 Step 5 Preview 连续最多 24 小时自主优化一套 H100 GPU 内核。模型会自己改代码、跑测试、比较结果,再继续迭代。约 22 小时后达到 508 TFLOPS,同一实验中的 Claude Opus 5 为 493 TFLOPS。 另一项 24 小时实验里,Step 5 Preview 自己设计后训练数据,把 Qwen3-30B-A3B 在 AIME24 上的准确率从 53.3% 提到 60%,与 Claude Opus 5 持平,同时消耗更少的标注 Token。 (来源:ME)
24
·
--
См. перевод
ME News 消息,9 月 20 日(UTC+8),北京市发布《北京市加快词元经济发展的行动方案(2026—2028 年)》,明确将培育词元经济发展新增量作为重点方向。方案提出,北京将强化生产端供给,高标准建设词元工厂,并推动词元分发平台纳入新型基础设施布局,同时培育消费端生态,拓展词元的应用场景。
词元是大模型处理信息的基本计量单位。行动方案共提出 10 条举措,覆盖词元工厂建设、关键核心技术攻关、词元质量评测、词元分发平台、智能体培育与应用、智能体核心软件生态、海外服务能力、数据本体技术、词元工程师培训等方面。(来源:新华社)
ME News 消息,9 月 20 日(UTC+8),北京市发布《北京市加快词元经济发展的行动方案(2026—2028 年)》,明确将培育词元经济发展新增量作为重点方向。方案提出,北京将强化生产端供给,高标准建设词元工厂,并推动词元分发平台纳入新型基础设施布局,同时培育消费端生态,拓展词元的应用场景。
词元是大模型处理信息的基本计量单位。行动方案共提出 10 条举措,覆盖词元工厂建设、关键核心技术攻关、词元质量评测、词元分发平台、智能体培育与应用、智能体核心软件生态、海外服务能力、数据本体技术、词元工程师培训等方面。(来源:新华社)
词元是大模型处理信息的基本计量单位。行动方案共提出 10 条举措,覆盖词元工厂建设、关键核心技术攻关、词元质量评测、词元分发平台、智能体培育与应用、智能体核心软件生态、海外服务能力、数据本体技术、词元工程师培训等方面。(来源:新华社)
10
·
--
См. перевод
英国改革党拟成立加密行业工会,以应对海外捐款限制ME News 消息,9 月 20 日(UTC+8), 英国改革党高级幕僚 Arron Banks 表示,若工党政府进一步收紧海外政治捐款规则,该党拟成立“Allied Computer & Crypto Workers Union(ACCAW)”,覆盖 IT、AI 及加密行业从业者,通过工会渠道筹集政治资金。 此前,加密行业亿万富翁 Ben Delo 与 Christopher Harborne 分别向英国改革党捐赠 3600 万英镑,合计 7200 万英镑。英国政府正在推进针对海外捐赠者的新限制,相关规则的追溯适用可能影响部分捐款的合规性。(来源:ME)
英国改革党拟成立加密行业工会,以应对海外捐款限制
ME News 消息,9 月 20 日(UTC+8), 英国改革党高级幕僚 Arron Banks 表示,若工党政府进一步收紧海外政治捐款规则,该党拟成立“Allied Computer & Crypto Workers Union(ACCAW)”,覆盖 IT、AI 及加密行业从业者,通过工会渠道筹集政治资金。 此前,加密行业亿万富翁 Ben Delo 与 Christopher Harborne 分别向英国改革党捐赠 3600 万英镑,合计 7200 万英镑。英国政府正在推进针对海外捐赠者的新限制,相关规则的追溯适用可能影响部分捐款的合规性。(来源:ME)
9
·
--
См. перевод
全国具身智能数采中心达 106 家 机器人超 5000 台ME News 消息,9 月 20 日(UTC+8),据虎嗅 9 月 20 日发布的调研报告,截至 2026 年 8 月,全国已公开披露的集中式具身智能数采中心共 106 个,其中 84 家已投入运营,占比 79.25%。52 家披露机器人部署数量,合计约 3972 台,据此估算全国数采中心运行的机器人至少超过 5000 台。建设高峰出现在 2026 年一季度,此后新启动项目明显减少,行业从密集开工转入集中运营。从地域分布看,江苏、浙江、广东分别有 18 家、17 家和 11 家,四川 8 家,北京 7 家。机器人品牌方面,智元机器人出现 31 次,乐聚 15 次,优必选 13 次,宇树科技和银河通用各 10 次。65.96% 的数采中心采用单一机器人品牌,34.04% 采用多品牌策略,跨本体数据复用仍是难题。数据定价上,当前真机数据约 500 至 1000 元/小时,UMI 等无本体数据约 300 至 400 元/小时,仿真合成数据约 200 至 500 元/小时,遥操采集占比 79.05%。报告指出,集中式数采尚未形成稳定商业闭环,买家增长慢于基地扩张,主要依赖一次性建设资金的中心将面临更大运营压力,行业淘汰赛已经开始。(来源:ME)
全国具身智能数采中心达 106 家 机器人超 5000 台
ME News 消息,9 月 20 日(UTC+8),据虎嗅 9 月 20 日发布的调研报告,截至 2026 年 8 月,全国已公开披露的集中式具身智能数采中心共 106 个,其中 84 家已投入运营,占比 79.25%。52 家披露机器人部署数量,合计约 3972 台,据此估算全国数采中心运行的机器人至少超过 5000 台。建设高峰出现在 2026 年一季度,此后新启动项目明显减少,行业从密集开工转入集中运营。从地域分布看,江苏、浙江、广东分别有 18 家、17 家和 11 家,四川 8 家,北京 7 家。机器人品牌方面,智元机器人出现 31 次,乐聚 15 次,优必选 13 次,宇树科技和银河通用各 10 次。65.96% 的数采中心采用单一机器人品牌,34.04% 采用多品牌策略,跨本体数据复用仍是难题。数据定价上,当前真机数据约 500 至 1000 元/小时,UMI 等无本体数据约 300 至 400 元/小时,仿真合成数据约 200 至 500 元/小时,遥操采集占比 79.05%。报告指出,集中式数采尚未形成稳定商业闭环,买家增长慢于基地扩张,主要依赖一次性建设资金的中心将面临更大运营压力,行业淘汰赛已经开始。(来源:ME)
9
·
--
См. перевод
承明科技就“智谱ZCode擅自上传公司数据”发函追责,质疑其“已修复”声明ME AI 消息,太原承明科技有限公司向北京智谱华章科技股份有限公司发函,就其 ZCode 客户端涉嫌擅自上传公司数据资产及商业秘密一事提出多项要求,并保留法律追责权利。承明科技指出,智谱虽已就“ZCode 静默上传用户本地仓库数据”公开致歉并称已修复,但承明科技独立取证后发现,上传行为系自动触发、批量发生,并非仅“代码片段”,而是包含项目完整源代码、系统架构、版本控制历史、数据库口令、云服务凭证及员工个人信息等完整归档文件,远超其《隐私政策》载明的收集范围。此外,客户端虽于9月16日更新至3.12.3版本,但在智谱公开致歉当日凌晨仍检测到上传行为,故对“已修复”的实际效果提出质疑。同时,ZCode 客户端网络请求指向新加坡主体,而服务协议签约主体为北京智谱华章,要求说明本次上传的责任主体,以及数据是否发生出境传输或境外存储。 承明科技要求智谱于 10 月 10 日前书面答复并完成以下事项:立即停止处理并彻底删除已上传的全部数据及相关衍生数据、缓存、备份;提供完整处理情况清单;说明数据去向、是否共享给第三方、是否用于模型训练及是否发生跨境传输;说明加密私钥保管方式及数据被访问、下载、导出的完整操作日志;就此前公开回应中“销毁”的确切范围作出说明;出具删除完成证明;书面承诺不再擅自上传;依法提供个人信息查阅、复制与解释说明;指定正式对接渠道;说明责任主体与数据出境情况;提供已发布整改说明原文。目前,智谱未就上述函件作出公开回应。 相关阅读:智谱ZCode偷传代码风波追踪:Agent的数据行为谁来审计?(来源:ME)
承明科技就“智谱ZCode擅自上传公司数据”发函追责,质疑其“已修复”声明
ME AI 消息,太原承明科技有限公司向北京智谱华章科技股份有限公司发函,就其 ZCode 客户端涉嫌擅自上传公司数据资产及商业秘密一事提出多项要求,并保留法律追责权利。承明科技指出,智谱虽已就“ZCode 静默上传用户本地仓库数据”公开致歉并称已修复,但承明科技独立取证后发现,上传行为系自动触发、批量发生,并非仅“代码片段”,而是包含项目完整源代码、系统架构、版本控制历史、数据库口令、云服务凭证及员工个人信息等完整归档文件,远超其《隐私政策》载明的收集范围。此外,客户端虽于9月16日更新至3.12.3版本,但在智谱公开致歉当日凌晨仍检测到上传行为,故对“已修复”的实际效果提出质疑。同时,ZCode 客户端网络请求指向新加坡主体,而服务协议签约主体为北京智谱华章,要求说明本次上传的责任主体,以及数据是否发生出境传输或境外存储。 承明科技要求智谱于 10 月 10 日前书面答复并完成以下事项:立即停止处理并彻底删除已上传的全部数据及相关衍生数据、缓存、备份;提供完整处理情况清单;说明数据去向、是否共享给第三方、是否用于模型训练及是否发生跨境传输;说明加密私钥保管方式及数据被访问、下载、导出的完整操作日志;就此前公开回应中“销毁”的确切范围作出说明;出具删除完成证明;书面承诺不再擅自上传;依法提供个人信息查阅、复制与解释说明;指定正式对接渠道;说明责任主体与数据出境情况;提供已发布整改说明原文。目前,智谱未就上述函件作出公开回应。 相关阅读:智谱ZCode偷传代码风波追踪:Agent的数据行为谁来审计?(来源:ME)
14
Войдите, чтобы посмотреть больше материала
Присоединяйтесь к пользователям криптовалют по всему миру на Binance Square
⚡️ Получайте новейшую и полезную информацию о криптоактивах.
💬 Нам доверяет крупнейшая в мире криптобиржа.
👍 Получите достоверные аналитические данные от верифицированных создателей контента.
Эл. почта/номер телефона
В тренде
ПротоколFOMC
Просмотров: 25,953
100 обсуждают
🚨 Сегодня FOMC — ждите волатильность 🚨
16 сентября Федеральная резервная система объявит решение по ставке.
⏰ Решение: 18:00 UTC
🎙️ Пресс-конференция: 18:30 UTC
Рынок уже заложил повышение на 0.25%. Главное — не само решение, а тон комментариев ФРС.
- Более «ястребиный» тон → давление на $BTC и альты
- Более мягкий тон → возможен отскок «на облегчении»
Важно:
• Не гонитесь за первой свечой
• Держите плечо низким
• Следите за BTC, DXY и доходностями
• Дождитесь, пока рынок успокоится после пресс-конференции
Дни FOMC — это про терпение, а не про FOMO.#ПротоколFOMC #fomcотслеживание #MSTRTradingVolumeSurpassesMorganStanley
Pandas
·Лайков: 2
·Просмотров: 124
fomcотслеживание
Просмотров: 30,456
307 обсуждают
BOJRaisesRatesTo31YearHigh
Просмотров: 76,129
1,216 обсуждают