


2024.03.14
Введение проекта
Запущенная в июне прошлого года компания Grass создает децентрализованную сеть парсинга веб-страниц, ориентированную на превращение общедоступных веб-данных в наборы данных искусственного интеллекта. Сеть принадлежит и управляется пользователями, и это самый простой способ взаимодействия с ИИ для любого человека. Каждый может быстро создать свой собственный узел Grass. Подробности можно узнать в руководстве, опубликованном Goose ранее. Вы также можете воспроизвести его на своем мобильном телефоне!
В настоящее время цена Whales достигла 4,6 U/1000 баллов на рынке и за его пределами. В условиях сети 75% IP-адрес одного устройства может добывать около 50 000 баллов в месяц, что составляет 240 U. Давным-давно Гусь просил вас майнить, но многим было лень майнить. Теперь я говорю вам, что вы можете майнить 240u с включенным компьютером или мобильным телефоном в течение месяца, пока вы повесите еще несколько единиц. в домах родственников и друзей во время китайского Нового года будет несколько 240у. Есть ли у вас немного сожаления? Если вы пожалеете об этом, приходите и быстро сделайте домашнее задание! !
В настоящее время Грасс планирует запустить первый сводный пакет данных уровня 2 на SOL. Гусь специально разделил его на версию, которая слишком длинна для чтения, и официальную версию статьи, чтобы друзья могли ее прочитать и понять.
Слишком долго смотреть
До того, как Грасс предложил этот план, у него была только концепция DEPIN плюс AI, но теперь он планирует построить собственную публичную сеть искусственного интеллекта. Это означает, что Grass расширилась до другой бизнес-модели, которая полностью отличается от предыдущей. Она добавила функции реестра данных и функции процессора ZK из своего предыдущего простого бизнеса по оказанию помощи компаниям, занимающимся искусственным интеллектом, в очистке данных. Как только уровень 2 будет построен, его концепция станет SOL+DEPIN+AI+первая концепция объединения данных. Четыре концепции накладываются друг на друга. Я не буду говорить, насколько это ценно. Ребята, не поторопитесь и не раскопайте это?
Руководство по версии для ПК:
https://weibo.com/ttarticle/p/show?id=2309404997006383775962
Инструкция по мобильной версии:
https://weibo.com/ttarticle/p/show?id=2309404998038614573232
позитивный
Трава: первое в истории объединение данных уровня 2
За последние несколько недель мы опубликовали некоторый контент, объясняющий роль Грасса в стеке искусственного интеллекта. Теперь вы узнали, что этот протокол выполняет множество функций, помогая разработчикам получать доступ к сетевым данным для обучения своих моделей. Это критический первый этап процесса ИИ и отправная точка для всего развития.
В случае Grass набор узлов размещается на резидентных устройствах, собирая и обрабатывая необработанные данные из сети. Он очищает и преобразует данные в структурированные наборы данных для обучения ИИ. Самое приятное то, что он собирает сетевые данные таким образом, что вовлекает и вознаграждает за участие почти миллион человек по всему миру. Он единолично создает категорию в сфере предоставления данных ИИ, и именно поэтому некоторые крупнейшие компании в мире, занимающиеся ИИ, предпочитают работать с нами. Это уровень данных ИИ.
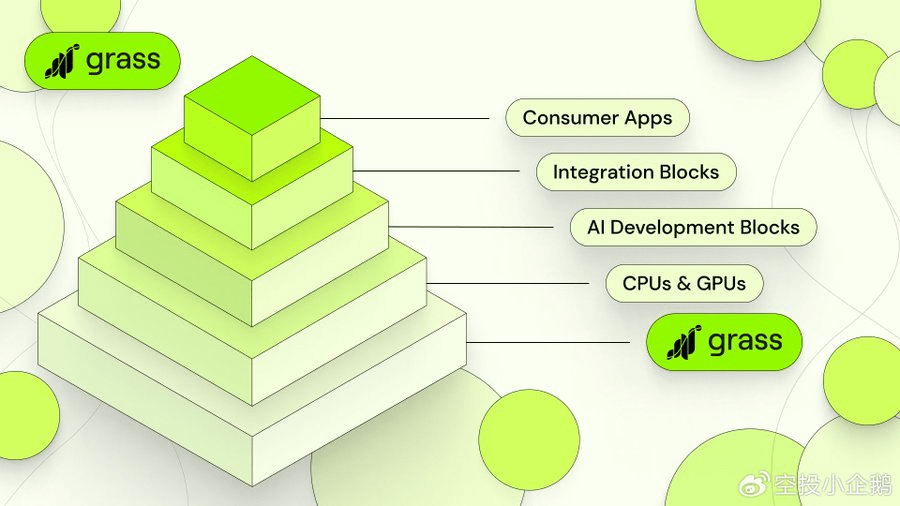
Тем временем мы провели последние несколько недель, размышляя о текущем состоянии искусственного интеллекта. Мы спросили себя, какие проблемы являются наиболее насущными и что мы можем сделать для их решения, будучи важной частью инфраструктуры искусственного интеллекта.
Мы пришли к выводу, что самая большая проблема, с которой сегодня сталкивается ИИ, — это отсутствие прозрачности данных. Просто посмотрите новости и вы все поймете. Спросите себя, почему модель искусственного интеллекта сравнивает Илона Маска с Гитлером? Или вычеркнуть целые этносы из мировой истории? Были ли использованы неправильные данные во время обучения? Или, что еще хуже, использование достоверных данных, которые выборочно дают неправильные ответы?
Ответ: мы не знаем. И мы не знаем, потому что нет никакого способа узнать. Мы не знаем, на каких данных были обучены эти модели, потому что не существует механизма, позволяющего это доказать. У пользователей нет возможности проверить происхождение данных, как и у разработчиков нет возможности проверить их самостоятельно.
Это проблема, которую Grass планирует решить, и сейчас мы создаем объединение данных уровня 2 для решения этой проблемы. Как, спросите вы?
Пожалуйста, позвольте нам объяснить.
Уровень второй. Как создавать источники данных
Миру нужен способ доказать происхождение данных обучения ИИ, и именно это Грасс сейчас и строит. Вскоре каждый раз, когда данные будут очищены узлом Grass, метаданные будут регистрироваться для аутентификации веб-сайта, с которого были получены данные. Эти метаданные затем навсегда внедряются в каждый набор данных, что позволяет разработчикам быть полностью уверенными в его происхождении. Затем они могут поделиться этой родословной с пользователями, которые могут быть уверены, что модель ИИ, с которой они взаимодействуют, не была намеренно обучена давать вводящие в заблуждение ответы.
Это потребовало значительных усилий и потребовало серьезных расширений нашего протокола для подготовки к масштабированию операций очистки до десятков миллионов сетевых запросов в минуту. Каждый запрос потребует проверки, которая будет иметь большую пропускную способность, чем может обеспечить любой L1. Вот почему мы объявили о планах по созданию решения уровня 2 для значительного обновления наших возможностей. L2 будет независимым накопительным пакетом, оснащенным процессором ZK, чтобы метаданные можно было группировать для проверки и использовать для обеспечения постоянного происхождения для каждого создаваемого нами набора данных. Это необходимо для того, чтобы базовый уровень всей разработки ИИ мог перейти на следующий этап.
Преимуществ у этого много: это защитит от загрязнения данных, расширит возможности искусственного интеллекта с открытым исходным кодом и обеспечит прозрачность моделей, с которыми мы взаимодействуем каждый день.
Далее мы опишем базовую конструкцию системы.
Архитектура Грасса
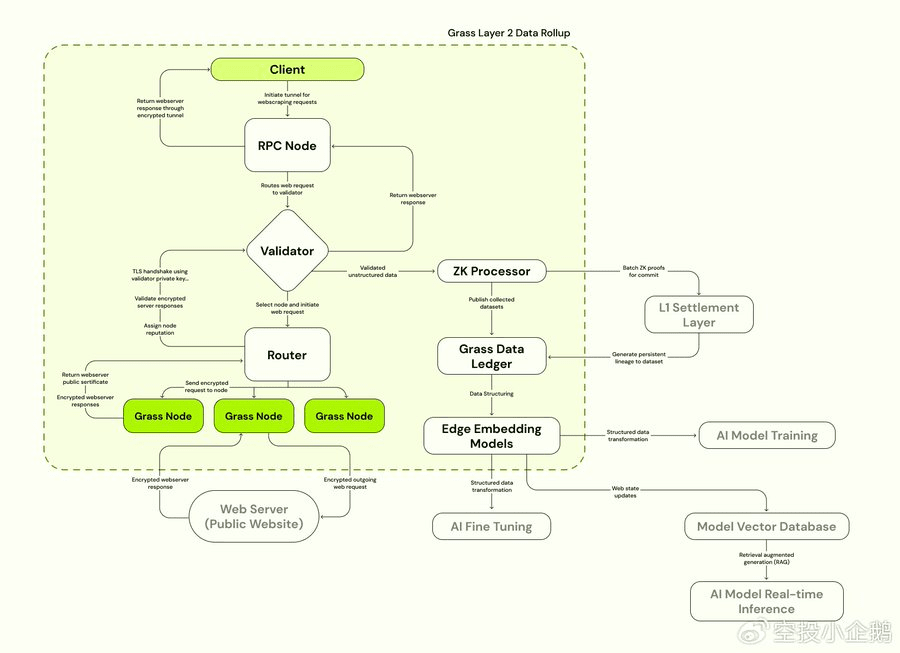
Самый простой способ понять эти обновления — посмотреть на график сводного данных Grass. Слева, между клиентом и веб-сервером, вы видите сеть Грасса в ее традиционном понимании. Клиент делает сетевой запрос, проходит через валидатор и в конечном итоге направляется через узел Grass. Сервер веб-сайта, запрошенный клиентом, ответит на сетевой запрос, позволяя сканировать его данные и отправлять их обратно по линии. Затем данные будут очищены, обработаны и подготовлены для обучения моделей ИИ следующего поколения.
На диаграмме L2 справа вы увидите два основных дополнения, которые будут добавлены с запуском суверенного уровня 2 Grass: реестр данных Grass и процессор ZK.
Оба они имеют свои собственные функции, поэтому мы объясним их одну за другой.
Журнал данных травы
Реестр данных — это последнее место хранения всех данных Grass. Это постоянный реестр каждого набора данных, просканированного на Grass, теперь со встроенными метаданными для записи его происхождения с момента создания. Подтверждение метаданных для каждого набора данных будет храниться на уровне расчетов Solana, а сами данные расчетов будут доступны через реестр. Необходимо отметить важность того, чтобы у Grass было место для хранения данных, которые он очищает, хотя мы скоро к этому вернемся.
ЗК процессор
Как мы описали выше, цель процессора ZK — помочь документировать происхождение наборов данных, собранных в сети Grass. Представьте себе этот процесс.
Когда узел в сети — другими словами, пользователь, использующий расширение Grass — отправляет сетевой запрос на данный веб-сайт, он возвращает зашифрованный ответ, содержащий все данные, запрошенные узлом. По сути, это момент рождения нашего набора данных и момент его возникновения, который необходимо записать.
И именно этот момент мы фиксируем, когда записываем метаданные. Он содержит множество полей — сеансовый ключ, URL-адрес сканируемого веб-сайта, IP-адрес целевого веб-сайта, временную метку транзакции и, конечно же, сами данные. Это вся информация, необходимая для того, чтобы без сомнения знать, что конкретный набор данных получен с веб-сайта, которым он якобы является, и, следовательно, что конкретная модель ИИ была правильно и добросовестно обучена.
Роль процессора ZK заключается в том, что эти данные необходимо обрабатывать в цепочке, но мы не хотим, чтобы все эти данные были видны валидаторам Solana. Более того, огромное количество сетевых запросов, выполняемых на Grass, в будущем неизбежно превысит пропускную способность любого L1 — даже такого мощного L1, как Solana. Вскоре Grass будет масштабироваться до уровня выполнения десятков миллионов сетевых запросов в минуту, при этом метаданные для каждого запроса должны будут обрабатываться в цепочке. Для нас было бы невозможно отправить эти транзакции на L1 без того, чтобы процессор ZK сначала не провел доказательства и не объединил их в пакеты. Поэтому Л2 – это единственно возможный путь достижения поставленных нами целей.
Итак, почему это так важно?
Преимущества уровня 2
реестр данных
Важность реестра данных заключается в том, что он превращает масштабирование Grass в другую – и принципиально иную – бизнес-модель. Хотя протокол будет продолжать тщательно проверять покупателей, которые отправляют свои собственные сетевые запросы и собирают свои данные в сети, все большая часть его деятельности будет включать данные, уже хранящиеся в реестре. Благодаря этой возможности Grass теперь может стратегически собирать данные для обучения LLM и размещать их в постоянно расширяющемся репозитории данных.
Этот репозиторий представляет собой уровень данных модульного стека искусственного интеллекта, из которого разработчики могут выбирать строительные блоки для обучения бесконечному количеству различных моделей. По сути, это миниатюрная модель Интернета, предоставляющая обучающие данные, которые уже структурированы и готовы к употреблению ИИ.
ЗК процессор
Мы подробно рассмотрели, почему процессоры ZK важны. Позволяя нам создавать доказательства метаданных, документирующих происхождение набора данных Grass, он предоставляет разработчикам и пользователям механизм проверки того, что модель ИИ действительно была обучена правильно. Это само по себе очень важно.
Однако есть одна вещь, о которой мы раньше не упомянули.
Помимо записи веб-сайта, с которого был получен набор данных, метаданные также указывают узлы, через которые набор данных перемещался по сети. Примечательно, что это означает, что каждый раз, когда узел сканирует сеть, он может получить признание за свою работу, не раскрывая никакой идентифицирующей информации о себе.
Итак, почему это важно?
Это важно, потому что как только вы сможете доказать, какие узлы какую работу выполнили, вы сможете начать пропорционально вознаграждать их. Некоторые узлы более ценны, чем другие. Некоторые узлы сканируют больше данных, чем их коллеги. И это именно те узлы, которые нам необходимо стимулировать для продолжения быстрого расширения сети, которое мы наблюдали в течение последних нескольких месяцев. Мы считаем, что этот механизм значительно увеличит вознаграждение для наиболее нуждающихся регионов по всему миру, в конечном итоге побуждая людей в этих местах регистрироваться и экспоненциально увеличивать емкость сети.
Излишне говорить, что чем больше сеть, тем больше у нас возможностей сканирования и тем больше хранилище сетевых данных, которые мы храним. Неизбежно возникнет петля положительной обратной связи, и больше данных означает, что у нас будет больше доступных лабораторий искусственного интеллекта, которым необходимы данные для обучения, тем самым создавая стимулы для дальнейшего роста сети.
в заключение
В целом, большинство нерешенных проблем в области искусственного интеллекта сегодня связаны с отсутствием понимания того, как обучаются модели, что, по нашему мнению, можно решить, предоставив ИИ с открытым исходным кодом системы, которые проверяют происхождение данных. Наше решение — создать первую в истории систему объединения данных уровня 2, которая позволит внедрить механизмы записи метаданных из всех источников наборов данных.
Доказательства ZK этих данных будут храниться на уровне расчетов L1, а сами метаданные в конечном итоге будут связаны с базовыми наборами данных, поскольку сами наборы данных хранятся в нашем собственном реестре данных. Grass обеспечивает уровень данных для модульных стеков искусственного интеллекта, и эти разработки обеспечат большую прозрачность и вознаграждение поставщикам узлов, пропорциональное объему выполняемой ими работы.
Это обновление должно помочь рассказать о некоторых наших предстоящих проектах и прояснить мысли, лежащие в основе наших решений. Мы рады внести свой вклад в повышение прозрачности ИИ и рады множеству возможных вариантов использования наших продуктов в будущем. Эти обновления откроют огромные возможности для разработчиков, поэтому, если вы или ваша команда заинтересованы в разработке на Grass, свяжитесь с нами в Discord. Спасибо за вашу поддержку и, пожалуйста, следите за обновлениями.
Получите долю в революции искусственного интеллекта.