
Как выбрать подходящую вычислительную инфраструктуру для ИИ
Большинство команд, работающих с ИИ, неправильно выбирают провайдеров вычислительных ресурсов.
Они сравнивают почасовые тарифы на H100, изучают рейтинги провайдеров и выбирают самый дешёвый вариант. Через полгода они сталкиваются с ограничениями по доступным мощностям, ростом расходов и зависимостью от поставщика.
В чём проблема? При выборе вычислительных ресурсов нужно учитывать требования рабочих нагрузок, а не только цены на GPU.
Вот более эффективный подход.
1. Сначала задайте правильные вопросы
Прежде чем выбрать провайдера, учтите пять факторов:
- Рабочая нагрузка: пакетное обучение или инференс с низкой задержкой?
- Бюджет: экспериментальные расходы или предсказуемый крупномасштабный спрос?
- DevOps: способна ли ваша команда управлять инфраструктурой нескольких провайдеров?
- Соответствие требованиям: нужны ли вам HIPAA, SOC 2 или региональные ограничения на обработку данных?
- Масштабируемость: справится ли инфраструктура с внезапным десятикратным ростом спроса?
Ответы определяют, какая модель вычислений вам подходит.
2. Разберитесь в трёх моделях вычислений
Гиперскейлеры (AWS/GCP): зрелые экосистемы, высокий уровень соответствия требованиям и интегрированные инструменты. Однако они часто отличаются высокими ценами, платой за исходящий трафик и медленным одобрением квот на GPU.
Неооблака: конкурентные цены на GPU и более быстрый доступ к вычислительным ресурсам, но потенциально большая зависимость от мощностей одного провайдера.
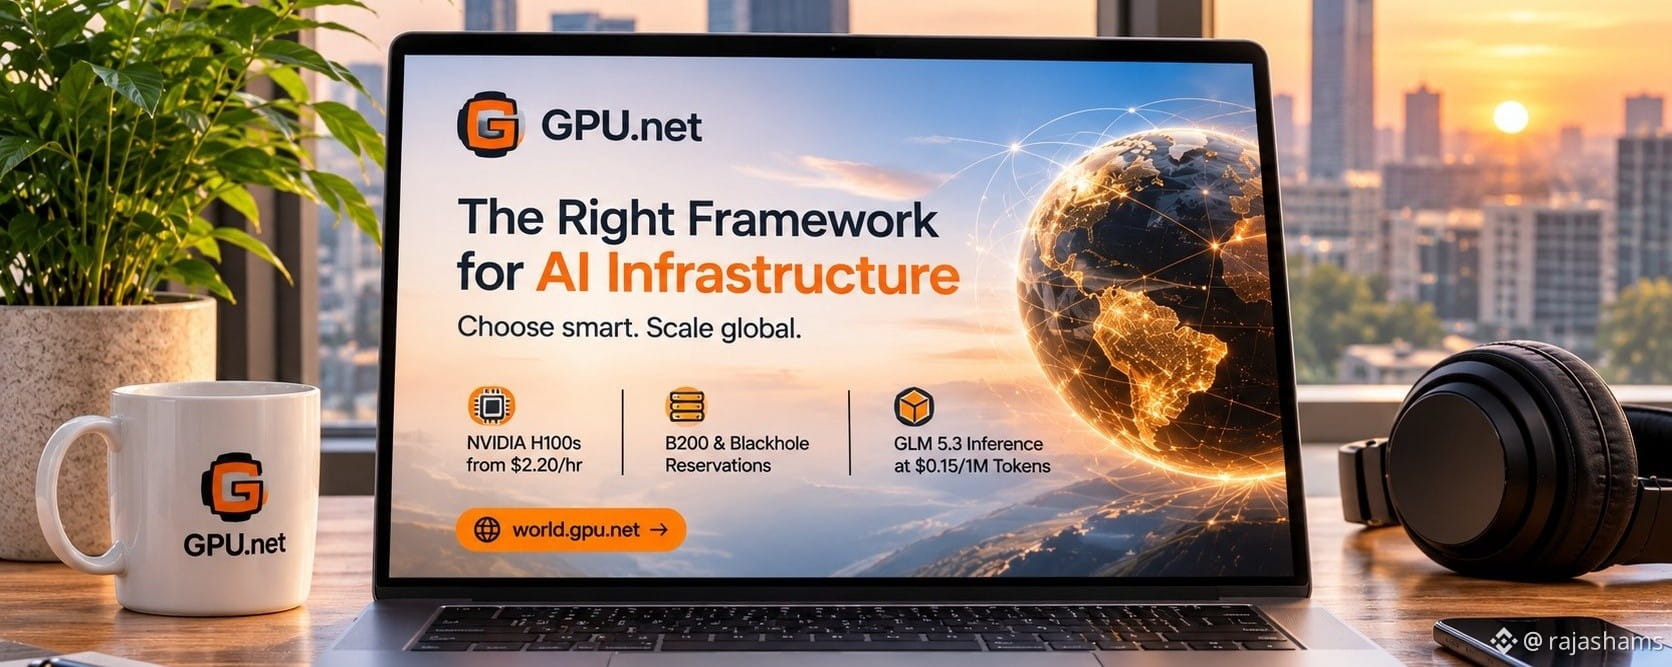
Агрегированные вычислительные сети (GPU.net): объединяют распределённые мощности GPU через единую торговую площадку, обеспечивая более широкий доступ к вычислительным ресурсам, конкурентные цены и гибкое масштабирование.
Каждая модель подходит для разных задач. Цель — избежать ненужных ограничений инфраструктуры.
3. Обучение и инференс — не одно и то же
Это одна из самых дорогостоящих ошибок, которые допускают команды ИИ.
Для обучения нужны мощные кластеры GPU, высокоскоростные соединения, например NVLink, и эффективная пакетная обработка.
Для инференса важны низкая задержка, географическое распределение, быстрое время запуска, высокая доступность и оптимизированная стоимость токена.
Обучение проходит интенсивными этапами. Инференс продолжается всё время, пока пользователи работают с вашим ИИ-продуктом.
Ваша стратегия развития инфраструктуры должна учитывать и то и другое.
4. Масштабируйте инфраструктуру поэтапно
- До соответствия продукта рынку (Pre-PMF): отдавайте приоритет вычислительным ресурсам по запросу. Не берите на себя долгосрочные обязательства, пока спрос остаётся неопределённым.
- Ранний рост: разделяйте кластеры для обучения и инференса. Проанализируйте расходы за 60 дней, прежде чем рассматривать резервирование мощностей.
- Масштабирование в продакшене: снижайте зависимость от одного поставщика с помощью переносимых развертываний, открытых стандартов контейнеризации и инфраструктуры нескольких провайдеров.
Не создавайте инфраструктуру для компании, которой вы ещё не стали.
5. Место GPU.net
GPU.net объединяет распределённые вычислительные мощности GPU и сервисы ИИ в единую экосистему.
В предложение входят:
- GPU NVIDIA H100 от $2.20 в час.
- Возможность зарезервировать B200 и Blackwell.
- Инференс GLM 5.3 с совместимостью с OpenAI по цене $0.15 за 1 млн токенов.
Более широкая экосистема также объединяет вычисления на GPU с хостируемыми моделями, ИИ-агентами и возможностями получать доход от использования GPU.
Общая картина
Будущее инфраструктуры ИИ не будет определяться одним облачным провайдером.
Оно будет зависеть от того, насколько эффективно рабочие нагрузки получают доступ к глобальным вычислительным ресурсам с учётом стоимости, географии, доступности и задержки.
Конкурентное преимущество будет заключаться не просто во владении большим количеством GPU. Оно будет зависеть от доступа к нужным вычислительным ресурсам в нужное время и по нужной цене
Изучите экосистему GPU.net: https://world.gpu.net/
#AI #GPU #DePIN #AIInfrastructure #C#cloudcomputing #Aİ #CloudInfrastructure #GPURental #DePIN