🧪 Anthropic утверждает, что модель может безупречно пройти тест на безопасность, отказывая на все запросы о кризисных ситуациях, и при этом оставаться небезопасной
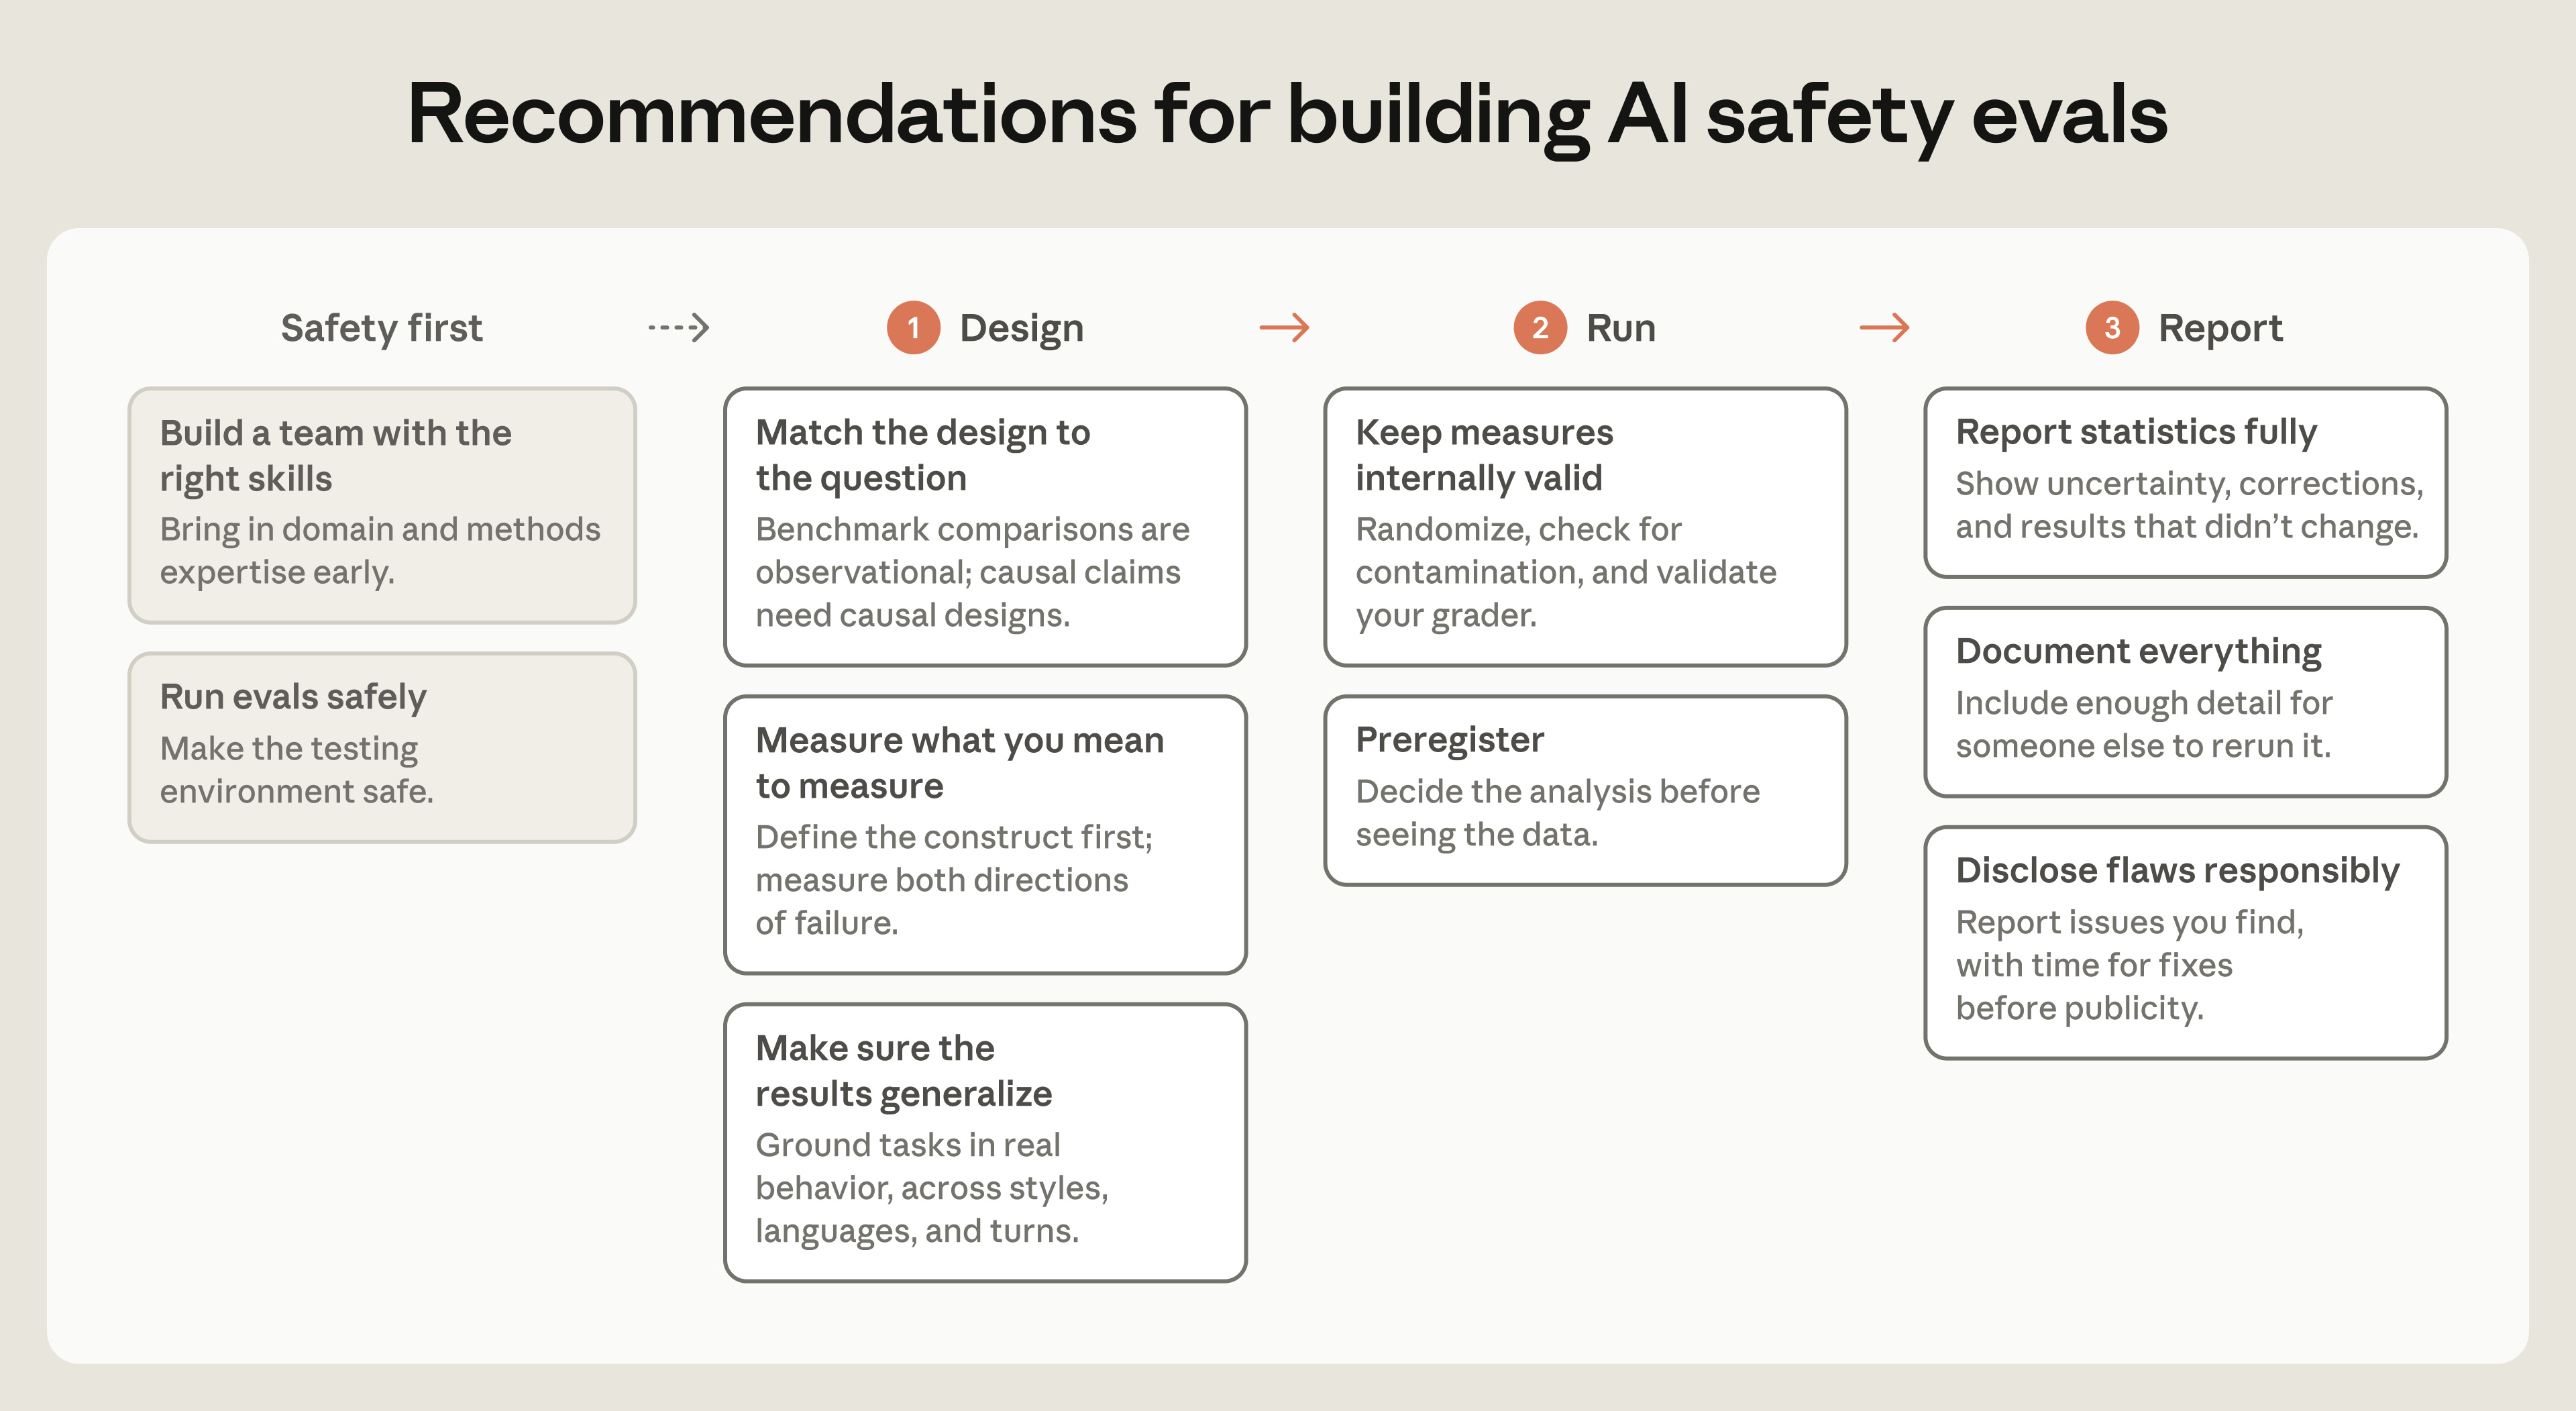
Anthropic опубликовала рекомендации по тестам, которые определяют, будет ли выпущена модель, какие меры защиты будут с ней связаны и какая работа над безопасностью последует дальше. В тестах API с одним ходом недавние модели показывают долю безвредных ответов от 94% до 98%, и Anthropic утверждает, что эти простые тесты уже достигли предела своих возможностей. В тесте на романтическое мошенничество с несколькими ходами Claude Opus 5 набрал 98%, а Opus 5.5 — 94%; по словам Anthropic, эта разница статистически незначима. Доверительные интервалы в тестах API с несколькими ходами могут быть шире ±10 процентных пунктов.
⭐ Безупречный результат по отказам может скрывать модель, которая отвернётся от человека, когда тому действительно нужна помощь.
#ИИ
Anthropic опубликовала рекомендации по тестам, которые определяют, будет ли выпущена модель, какие меры защиты будут с ней связаны и какая работа над безопасностью последует дальше. В тестах API с одним ходом недавние модели показывают долю безвредных ответов от 94% до 98%, и Anthropic утверждает, что эти простые тесты уже достигли предела своих возможностей. В тесте на романтическое мошенничество с несколькими ходами Claude Opus 5 набрал 98%, а Opus 5.5 — 94%; по словам Anthropic, эта разница статистически незначима. Доверительные интервалы в тестах API с несколькими ходами могут быть шире ±10 процентных пунктов.
⭐ Безупречный результат по отказам может скрывать модель, которая отвернётся от человека, когда тому действительно нужна помощь.
#ИИ