

Теперь Claude Code читает ваши файлы на Opus.
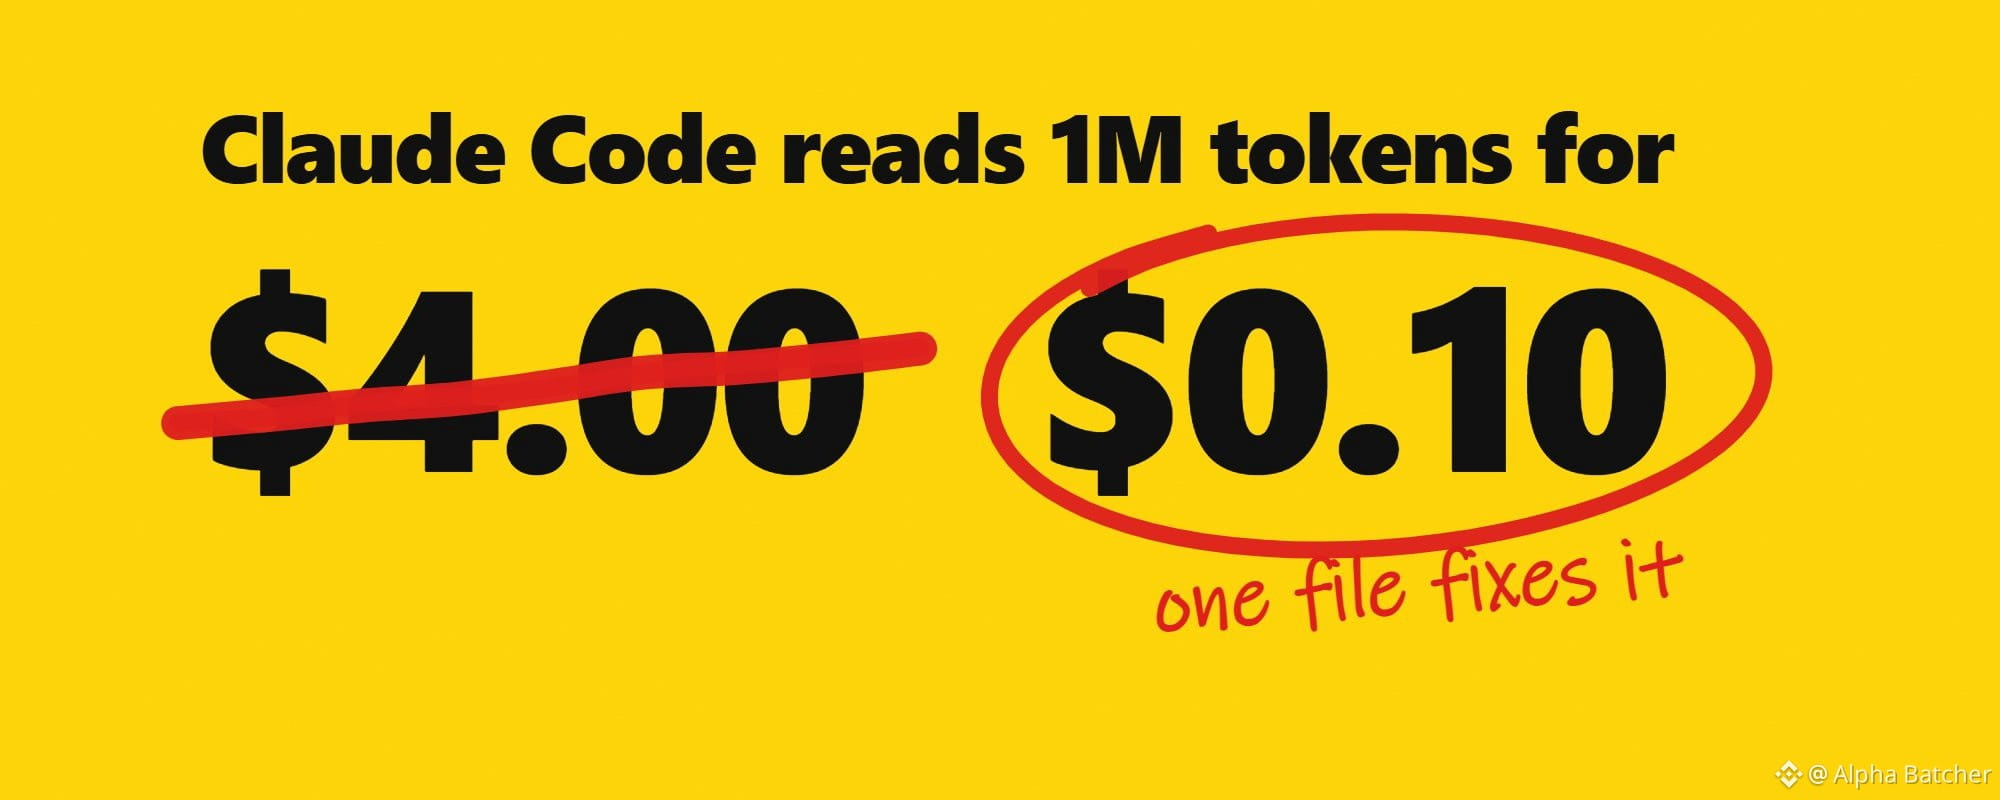
Встроенный субагент Explore, которому Claude поручает поиск по вашей кодовой базе, раньше работал на Haiku. В текущих версиях он работает на модели вашего сеанса. При настройках по умолчанию это Opus 5.5: $4 за миллион входных токенов против $0,10 у Haiku 5.5.
это одна настройка. Anthropic опубликовала цифры по остальным вариантам в руководстве по выбору модели Claude от 9 ноября и в сентябрьской статье о стоимости задачи на Opus 5.5:
• Если выполнять каждую задачу с низким уровнем усилий, а при высокой нагрузке повторно запускать только неудачные, успешно завершаются около 97% задач, стоимость каждой — $0,17. Если выполнять каждую задачу с высоким уровнем усилий, успешно завершаются 95,3% задач, стоимость каждой — $0,29.
• ведущий агент на Opus с максимум 25 рабочими агентами на Sonnet обходился примерно на треть дешевле, чем один Opus, при примерно таком же результате.
• при использовании API-ключа шестиминутный перерыв на кофе при контексте в 120K токенов превращает следующее чтение кэша за $0.02 в запись за $0.60.
• в одном бенчмарке из 20 задач на 2 задачи пришлось 43% расходов.
в этом курсе эти числа превращаются в настройки. каждая глава заканчивается текстом, который нужно вставить в Claude Code, и после каждой главы вы будете тратить меньше:
• на что уходят деньги: ходы, кэш, вывод и модель
• переведите Explore и другие инструменты чтения на Haiku
• задайте уровень усилий до смены модели
• сохраняйте кэш тёплым
• отправляйте меньше на каждом ходу
• выбирайте модель под задачу
• ведущий и недорогие исполнители
• измерьте на своих задачах
если у вас есть всего 30 секунд, вот весь курс в этих 5 строках:
создайте субагента с именем Explore и model: haiku, а всем субагентам, которые только читают, назначьте Haiku.
начните со среднего уровня усилий. запускайте пакеты на low и повторно выполняйте только неудачные задачи на high.
при использовании API-ключа сжимайте контекст до перерыва, а не после него.
сократите CLAUDE.md до менее чем 200 строк и отключите MCP-серверы, которыми не пользуетесь.
оставьте Opus решения и правки кода, а после каждой реальной задачи проверяйте /usage.
на что уходят деньги
задача Claude Code — это цикл: прочитать диалог, вызвать инструмент, прочитать результат, повторить. каждый проход цикла — один запрос, и его цену определяют 4 фактора.
• ходы. каждый ход повторно отправляет весь диалог. в примере Anthropic задача, в которой контекст за 40 ходов увеличивается с 20K до 120K токенов, отправляет около 2,8 млн входных токенов. та же задача за 25 ходов отправляет около 1,75 млн.
• чтение кэша. большая часть того, что повторно отправляется на каждом ходу, уже была отправлена на предыдущем, поэтому тарифицируется как чтение кэша: $0.20 за миллион на Opus 5.5 — в 20 раз меньше цены входных токенов в $4. эти 2,8 млн токенов обойдутся в $11.20 без кэша, $1.62 при попадании в кэш в 90% случаев и около $0.99 при 96%.
• вывод. $20 за миллион на Opus 5.5 — в 100 раз дороже чтения кэша. обдумывание тарифицируется как вывод, даже если Claude Code показывает вам только краткое резюме. 60K выходных токенов стоят $1.20 — столько же, сколько чтение 6 млн токенов из кэша.
• модель. она определяет цену каждого токена, и каждый субагент, наследующий модель, наследует и её цену.
в конце следующей настоящей задачи выполните /usage и прочитайте 3 строки:
доля кэша: высокая при длинной сессии. низкая означает долгую паузу, смену модели или подключение MCP-сервера посреди сессии.
вывод относительно ввода: большой объём вывода при небольшом изменении означает, что усилия тратятся впустую или модель повторяет попытки.
общий объём ввода относительно размера диалога: если он во много раз больше, значит, было много ходов. прочитайте сессию и найдите цикл.
вы получите одну строку из счёта, которую нужно исправить в первую очередь.
меньше ходов и тёплый кэш экономят больше, чем любая скидка.
переведите Explore и другие инструменты чтения на Haiku
субагент — это помощник, которого Claude запускает для побочной задачи. он работает в собственном контекстном окне и возвращает краткое резюме, а его токены оплачиваются по цене его собственной модели.
встроенные субагенты Claude Code согласно документации:
• Explore ищет по вашей кодовой базе в режиме только для чтения. он работает на модели вашей сессии. если в вашей сессии используется Fable, Explore переключается на Opus при работе с подпиской Claude, аккаунтом Anthropic Console или шлюзом, а на Bedrock, Google Cloud, Foundry, Claude Platform on AWS и шлюзе приложений Claude остаётся на Fable.
• Plan проводит исследование в режиме планирования. он наследует модель вашей сессии.
• general-purpose исследует и редактирует. он тоже наследует модель.
файл с именем Explore в папке agents заменяет встроенный вариант и сохраняет собственную модель. в руководстве Anthropic предлагается сделать именно так.
сохраните это как ~/.claude/agents/Explore.md для всех проектов или как .claude/agents/Explore.md для одного проекта:
---
name: Explore
description: Быстрый агент для поиска и изучения кодовой базы в режиме только для чтения. Используйте его, чтобы находить файлы, искать код и отвечать на вопросы «где это находится».
tools: Read, Grep, Glob
model: haiku
omitClaudeMd: true
---
Только поиск и чтение. Никогда не создавай и не редактируй файлы. Указывай пути к файлам, номера строк и краткое описание найденного.
omitClaudeMd запускает его без вашего CLAUDE.md, как и встроенный Explore. перезапустите Claude Code, если раньше папки agents не было, и выполните claude update: в Anthropic API псевдоним haiku указывает на Haiku 5.5 начиная с v2.1.293. На Bedrock, Google Cloud, Foundry и Claude Platform on AWS он по-прежнему означает Haiku 4.5.
сделайте то же самое для каждого помощника, который только читает логи, результаты тестов или результаты поиска. вот пример самой Anthropic:
---
name: log-reader
description: Читает результаты тестов и логи, сообщает о каждом упавшем тесте. Используйте после запуска тестов.
tools: Read, Grep, Glob, Bash
model: haiku
---
Читай переданные тебе логи. Для каждого сбоя укажи файл, название теста и первую строку ошибки. Не редактируй файлы.
чтобы назначить всем субагентам одну модель, задайте переменную окружения CLAUDE_CODE_SUBAGENT_MODEL. Модель, указанная в файле субагента, имеет приоритет над переменной.
оставьте правки кода и решения за основной моделью. небольшая модель, неверно понявшая результат поиска, отправит основную модель не к тому файлу, и основная модель заплатит за это отклонение.
поиск, чтение логов и результатов тестов обойдутся вам в $0.10 за миллион входных токенов вместо $4. в следующий раз, когда Claude будет делегировать задачу, выполните /tasks и посмотрите, какая модель назначена каждому субагенту.
отдельный файл для каждого читателя — и чтение больше не оплачивается по тарифам Opus.
задайте уровень усилий до смены модели
уровень усилий определяет, сколько модель думает, пишет и вызывает инструменты на каждом ходу. у Opus 5.5 есть уровни low, medium, high и xhigh, а также max для одной сессии. по умолчанию в Claude Code используется medium.
Anthropic измерила это на части SWE-bench Pro с Opus 5.5:
• medium: примерно на 2,5 пункта ниже high при стоимости около 70% от него.
• low: примерно на 8 пунктов ниже high при стоимости около трети от него.
• xhigh: примерно на 1,4 пункта выше high при стоимости в 2,5 раза больше.
а вот запуск, который превзошёл все остальные: всё на low, а на high повторно запускаются только неудачные задачи. примерно 97% задач выполнено по $0.17 за каждую против 95,3% по $0.29, когда все задачи выполнялись на high.
это работает, только если Claude может проверить свою работу: с помощью теста, сборки или скрипта, вызывающего конечную точку. проверка стоит один ход и его вывод. повышение усилий добавляет обдумывание на каждом ходу.
если модель справляется недостаточно хорошо, руководство Anthropic предлагает действовать в таком порядке:
1. дайте ей возможность проверить свою работу.
2. повысьте уровень усилий на одну ступень.
3. перейдите к следующей, более мощной модели и задайте уровень усилий ниже, чем использовали для меньшей модели.
для пакета задач выполните /effort low и вставьте:
выполни все задачи из todo.md по одной. после каждой запусти её тест. запиши задачи, тесты которых не прошли, в failed.md, указав для каждой первую строку ошибки. не меняй ничего за пределами этого репозитория и ничего не отправляй.
затем выполни /effort high и вставь:
повтори только задачи из failed.md и снова запусти их тесты. сообщи, какие из них всё ещё не проходят. ничего не отправляй.
сначала вы недорого проверяете всё, а высокий уровень усилий используете только там, где первая попытка не удалась.
при использовании API-ключа или подписки смена уровня усилий сохраняет кэш. на Bedrock, Agent Platform от Google Cloud или через шлюз она очищает кэш, поэтому меняйте уровень во время перерыва.
сначала low, затем high для неудачных задач — и вы платите за обдумывание только там, где оно меняет результат.
сохраняйте кэш тёплым
кэш хранит ту часть диалога, повторную отправку которой Claude Code не оплачивает по полной цене. для Opus 5.5 чтение кэша стоит 5% от цены нового входного токена. запись в кэш стоит 1,25 цены входного токена для кэша на 5 минут и в 2 раза больше для кэша на час.
срок хранения зависит от способа оплаты: час при подписке Claude, 5 минут при использовании API-ключа или облачного провайдера и 5 минут, когда подписка начинает использовать кредиты за потребление.
вот что происходит во время перерыва на кофе. при контексте в 120K токенов чтение стоит около $0.02, а новая запись в кэш на 5 минут — около $0.60. сделайте шестиминутный перерыв при использовании API-ключа — и следующий ход оплатит запись в кэш.
следующие действия также заставляют следующий ход оплачивать запись в кэш:
• смена модели: у новой модели пустой кэш.
• подключение или отключение MCP-сервера посреди сессии.
• первое включение быстрого режима в диалоге.
• сжатие контекста, при котором переписывается история, соответствовавшая кэшу.
• изменение уровня усилий на Bedrock, Agent Platform от Google Cloud или через шлюз.
настройте всё это в начале сессии и не меняйте настройки, пока она работает.
сжимайте контекст во время естественного перерыва, пока кэш ещё тёплый. при 150K токенов /compact стоит около $0.25 и экономит около $0.025 на каждом последующем ходе, то есть окупается примерно за 10 ходов. после перерыва длиннее срока хранения кэша та же команда /compact повторно прочитает весь диалог: это обойдётся примерно в $0.75 при 150K токенов.
/clear ничего не стоит, поэтому используйте её между несвязанными задачами. /rewind возвращает к более раннему ходу, который ещё есть в кэше, если нужно отбросить какой-то путь.
перед тем как отойти, вставьте:
/compact сохрани названия упавших тестов, файлы, которые мы изменили, и следующий шаг
когда вы вернётесь, вас будет ждать короткий диалог, который ещё хранится в кэше.
сжимайте контекст до перерыва на кофе, а не после него.
отправляйте меньше на каждом ходу
каждый ход повторно отправляет всё, что было до него. при контексте в 20K токенов чтение кэша за ход стоит около $0.004 на Opus 5.5. при 150K оно стоит около $0.03, поэтому 30 ходов обойдутся в $0.90 только за чтение — против примерно $0.12 при 20K.
до того, как вы что-либо введёте, загружаются 3 вещи:
• CLAUDE.md загружается в каждую сессию и повторно отправляется на каждом ходу. в документации Anthropic по расходам рекомендуется не превышать 200 строк.
• MCP-серверы. при запуске загружаются только названия инструментов и инструкции сервера, а полное описание загружается при использовании инструмента. выполните /mcp и отключите серверы, которыми не пользуетесь.
• старые инструкции. запросы, написанные для более старой модели, могут заставить Opus 5.5 писать больше и повторно вызывать инструменты. в бенчмарке поддержки Anthropic из 44 обращений переход с Opus 4.8 на Opus 5.5 с низким уровнем усилий снизил расходы примерно на 18%, а команда Claude Code /claude-api prompt-audit сократила их ещё на 9%.
сначала выполните /claude-api prompt-audit, затем вставьте:
прочитай мой CLAUDE.md и все файлы, которые он подключает. предложи версию короче 200 строк: оставь команды сборки и тестирования, правила, которые Claude не может вывести из кода, и всё, что раньше ломалось. перенеси остальное в docs/ и добавь ссылку на него из CLAUDE.md. покажи мне diff и ничего не меняй, пока я не скажу «давай».
вы получите более короткий CLAUDE.md без старых инструкций-ритуалов и список серверов, которые можно отключить.
короткий контекст удешевляет каждый ваш ход.
выбирайте модель под задачу
цены за миллион токенов:
• Haiku 5.5: $0.10 за ввод и $0.50 за вывод для запросов до 100K токенов; выше этого объёма — $0.50 и $2.50.
• Sonnet 5.5: $2 за ввод и $10 за вывод.
• Opus 5.5: $4 за ввод и $20 за вывод.
• Fable 5.2: $8 за ввод и $40 за вывод.
рекомендации Anthropic для начала:
• Haiku 5.5: классификация, маршрутизация, извлечение данных и субагенты, которые ищут файлы, читают логи или составляют краткие сводки.
• Sonnet 5.5: хорошо определённые задачи программирования, например исправления ошибок и реализация функций по спецификации; чат, повседневные документы и задачи для агента, которые выполняются снова и снова.
• Opus 5.5 на medium: повседневная разработка и отладка, а также всё, в чём вы не уверены. это модель по умолчанию в Claude Code.
• Fable 5.2: крупные рефакторинги и миграции, архитектура, глубокие исследования и руководство множеством субагентов. переходите на неё, если Opus 5.5 на high всё ещё не справляется.
более высокая цена за токен не всегда означает более высокую стоимость задачи. на FrontierCode 2.0 Fable 5.2 на high набрала примерно столько же, сколько Opus 5.5 на max: 45,3% против 45,5%, при примерно вдвое меньшей стоимости задачи. прежде чем повышать усилия для Opus выше high на сложной задаче, попробуйте Fable с более низким уровнем усилий.
меняйте модель во время естественного перерыва. кэш принадлежит модели, которая его создала, поэтому первый ход на новой модели оплачивает запись всего диалога. сначала выполните /compact или начните заново с коротким письменным планом.
псевдоним opusplan использует Opus для планирования, а Sonnet — для правок. это переносит изменения кода на более дешёвую модель, в отличие от описанной выше настройки для чтения, поэтому сначала измерьте результат на своих задачах, прежде чем делать его настройкой по умолчанию.
вставьте:
прочитай todo.md. для каждой задачи укажи модель и уровень усилий, с которых стоит начать: Haiku для поиска и чтения логов, Sonnet для чётко определённых исправлений по спецификации, Opus на medium для повседневной работы и всего неясного, Fable для миграций, крупных рефакторингов и работы с множеством субагентов. сохрани routing.md, записав для каждой задачи отдельную строку с причиной выбора. ничего не меняй в настройках.
вы получите routing.md с моделью и уровнем усилий для каждой задачи ещё до начала работы.
Opus по умолчанию, Haiku для чтения, Fable, если Opus на high не справляется.
ведущий и недорогие исполнители
если задача не помещается в одно контекстное окно, поручите руководство самой мощной модели, а отдельные части — более дешёвым.
на внутреннем бенчмарке, который искал дефекты примерно в 22 миллионах токенов исходного кода, ведущий агент на Opus 5.5 с рабочими агентами на Sonnet 5.5 — до 25 одновременно — обходился примерно на треть дешевле, чем один Opus 5.5 с уровнем усилий по умолчанию, при примерно таком же результате.
не используйте этот подход, если работа представляет собой одну цепочку зависимых шагов или помещается в одно контекстное окно. в таких случаях планирование и объединение результатов обходятся дороже, чем дают экономии.
не раздувайте команды. команды агентов — экспериментальная функция: каждый участник запускается в собственном экземпляре Claude Code, а в документации Anthropic по расходам указано, что команда расходует примерно в 7 раз больше токенов, чем стандартная сессия, если участники работают в режиме планирования. выключайте каждого участника, когда он закончил свою часть.
инструмент advisor объединяет недорогого исполнителя с более мощным советником, к которому тот может обратиться за помощью. в собственной таблице Anthropic ни одна из 4 пар не превзошла однозначно исполнителя без советника, поэтому сначала измерьте, как часто ваш исполнитель просит о помощи, и только потом платите за советника.
вставьте:
раздели [задачу] на независимые части, каждая из которых помещается в одно контекстное окно. ты — ведущий: запиши план в plan.md, затем передай каждую часть субагенту на Sonnet, указав список файлов, которые ему разрешено менять, и объедини полученные результаты. части не должны редактировать одни и те же файлы. после каждого объединения запускай тесты. покажи мне plan.md до запуска любого субагента.
вы получите plan.md, части задачи, выполненные параллельно на Sonnet, и Opus, использованный для плана и объединения результатов.
ведущий принимает решения, а исполнители читают и печатают.
измерьте на своих задачах
все приведённые выше числа получены в тестах Anthropic. ваши результаты зависят от кодовой базы и ваших привычек.
• /usage в конце задачи показывает токены, долю кэша и примерную стоимость в долларах по прайсу. команда /cost делает то же самое. в тарифах Pro, Max, Team и Enterprise сумма в долларах служит ориентиром того, сколько работы вы выполнили, а на том же экране отображаются полосы использования.
• /effort status показывает уровень усилий, а /tasks — модель, на которой работает каждый субагент.
• для команды Claude Code Analytics API показывает примерную стоимость на пользователя, а Usage and Cost API разбивает расходы по моделям и на токены из кэша и вне кэша.
• ориентир из документации Anthropic по расходам: около $13 на разработчика за активный день при использовании в организациях и менее $30 в день для 90% пользователей.
выберите одну настоящую задачу из бэклога и выполните её в двух конфигурациях. для каждой конфигурации один раз вставьте:
я сравниваю две конфигурации на одной и той же задаче. задача: [задача]. выполни её, запусти тест и, когда закончишь, сообщи, сколько ходов потребовалось и что помогло бы их сократить. ничего не отправляй.
после каждого запуска проверьте /usage, затем выполните /clear, переключитесь с помощью /model или /effort и вставьте запрос снова.
вы получите собственную стоимость задачи для каждой конфигурации.
ориентируйтесь на собственный результат /usage.
одна вставка настроит читателей на Haiku, сократит CLAUDE.md и задаст маршрутизацию моделей. откройте Claude Code в репозитории и вставьте:
помоги мне тратить меньше в Claude Code, шаг за шагом. после каждого шага покажи изменение и дождись моего «давай».
1. создай ~/.claude/agents/Explore.md: name Explore, описание быстрого поискового агента в режиме только для чтения, tools Read, Grep, Glob, model: haiku, omitClaudeMd: true и текст с указанием только искать и читать, никогда не создавать и не редактировать файлы.
2. создай .claude/agents/log-reader.md с model: haiku. он читает вывод тестов и логи, сообщает о каждом сбое, указывая файл, название теста и первую строку ошибки, и никогда не редактирует файлы.
3. прочитай CLAUDE.md и все файлы, которые он подключает, и предложи версию короче 200 строк. перенеси остальное в docs/.
4. перечисли MCP-серверы в моей конфигурации и отметь те, которые в этом репозитории никогда не используются.
5. прочитай todo.md и создай routing.md, указав начальную модель и уровень усилий для каждой задачи.
не меняй другие настройки, ничего не отправляй и ничего не удаляй без разрешения.
после вставки у вас будет:
• Explore и читатель логов на Haiku.
• CLAUDE.md короче 200 строк, остальное — в docs/.
• список MCP-серверов, которые можно отключить.
• routing.md: модель и уровень усилий для каждой задачи.
настройка на одной странице
EXPLORE ~/.claude/agents/Explore.md, model: haiku, omitClaudeMd: true.
READERS субагенты для чтения логов и поиска на haiku. правки кода остаются за основной моделью.
EFFORT по умолчанию medium. пакетные задачи — на low, неудачные повторно запускаются на high.
VERIFY тест или сборка, которые Claude может запустить, прежде чем вы повысите уровень усилий.
CACHE подписка — 1 час, API-ключ — 5 минут. выполняйте /compact перед перерывом.
CONTEXT CLAUDE.md короче 200 строк. неиспользуемые MCP-серверы отключены.
MODEL haiku для чтения, sonnet для чётко определённых задач, opus на каждый день, fable для самых сложных.
TEAMS ведущий на opus и исполнители на sonnet — только если задача не помещается в одно контекстное окно.
CHECK /usage после реальных задач, /tasks для моделей субагентов.
сделайте скриншот этой страницы.
сегодня вечером сохраните файл Explore, перезапустите Claude Code и выполните /tasks в следующий раз, когда он будет искать по вашему коду.