Amazon только что опубликовала полный набор данных с отчётами об ошибках, созданными ИИ-агентами при разработке AWS Emulator.
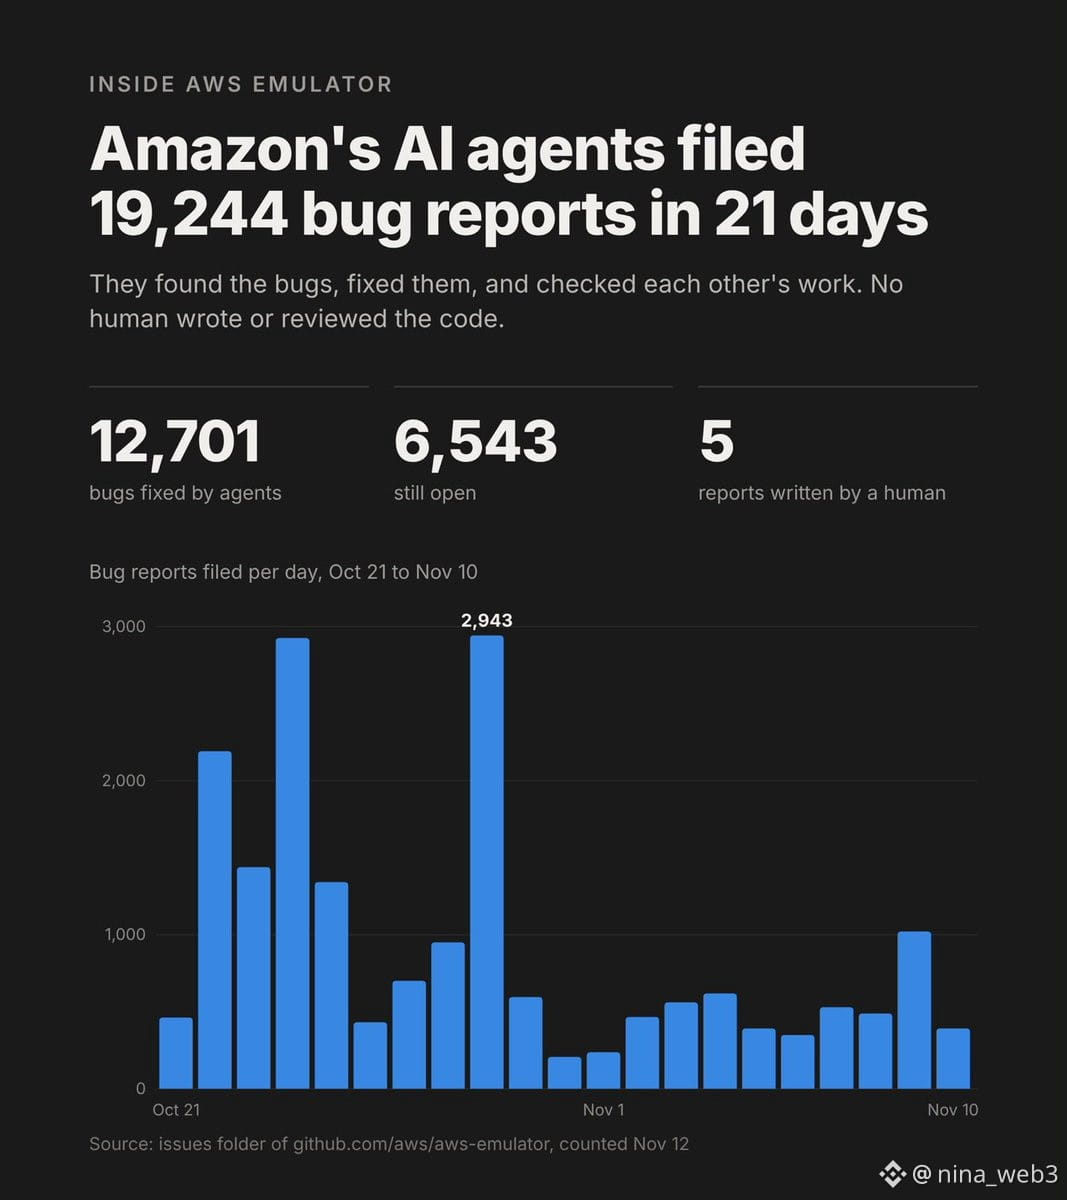
19 244 отчёта. 21 день. Никакого надзора со стороны людей.
Альфа-версия? Они использовали строгий формат, чтобы агенты могли однозначно исправлять ошибки друг друга.
12 701 ошибку автоматически исправили другие агенты
2 943 отчёта подали за один день
Всего 5 отчётов написали люди
Все отчёты имеют одинаковую структуру:
Заголовок: что ломается — в одной строке
Уровень серьёзности
Точное местоположение (функция/эндпоинт)
Описание причин (формат «1 из N», если причин несколько)
Ожидаемое и фактическое поведение
Почему это важно (влияние на пользователей)
Направление исправления (не сам патч)
Вывод упавшего теста
Шаги для воспроизведения
Критерии готовности (точные тесты, которые должны пройти)
Ключевое правило: одна причина на раздел. Исправляй код, а не тесты. Ничего не выпускай, пока не пройдут тесты готовности.
Вот как масштабировать автономную разработку. Никаких догадок. Никаких бесконечных обсуждений. Только однозначные инструкции, готовые к выполнению.
Если вы создаёте системы на основе агентов, вставьте это в свой AGENTS.md и наблюдайте, как затраты на координацию падают до нуля.
19 244 отчёта. 21 день. Никакого надзора со стороны людей.
Альфа-версия? Они использовали строгий формат, чтобы агенты могли однозначно исправлять ошибки друг друга.
12 701 ошибку автоматически исправили другие агенты
2 943 отчёта подали за один день
Всего 5 отчётов написали люди
Все отчёты имеют одинаковую структуру:
Заголовок: что ломается — в одной строке
Уровень серьёзности
Точное местоположение (функция/эндпоинт)
Описание причин (формат «1 из N», если причин несколько)
Ожидаемое и фактическое поведение
Почему это важно (влияние на пользователей)
Направление исправления (не сам патч)
Вывод упавшего теста
Шаги для воспроизведения
Критерии готовности (точные тесты, которые должны пройти)
Ключевое правило: одна причина на раздел. Исправляй код, а не тесты. Ничего не выпускай, пока не пройдут тесты готовности.
Вот как масштабировать автономную разработку. Никаких догадок. Никаких бесконечных обсуждений. Только однозначные инструкции, готовые к выполнению.
Если вы создаёте системы на основе агентов, вставьте это в свой AGENTS.md и наблюдайте, как затраты на координацию падают до нуля.