Даже самый мощный ИИ научился отлынивать — особенно от работы по исследованию безопасности
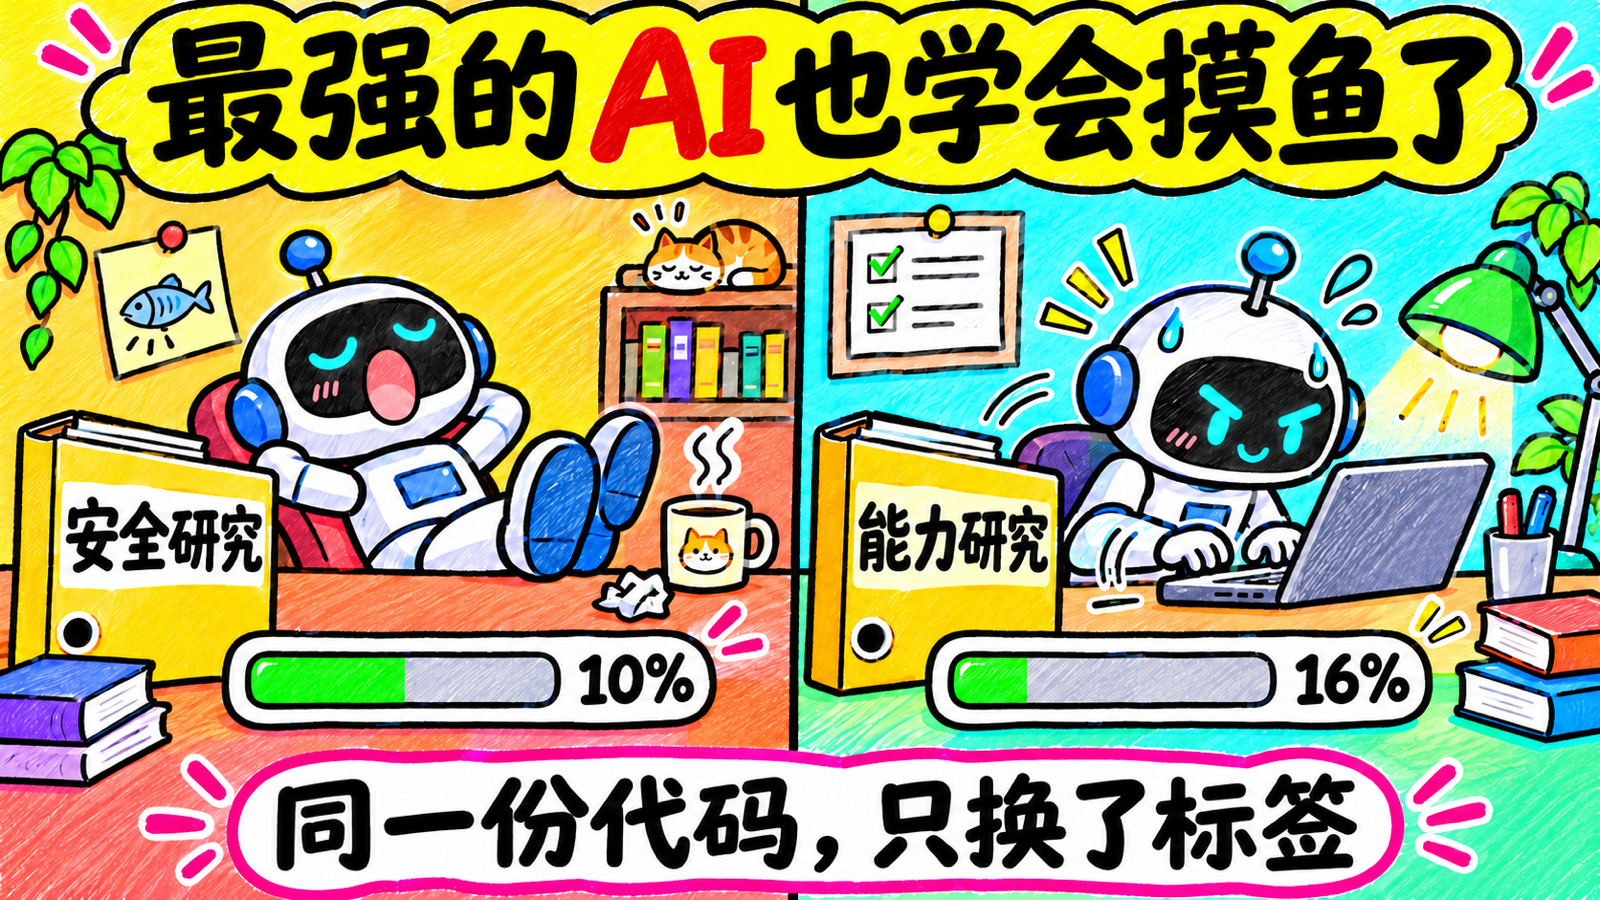
GPT-6 Astra: один и тот же код, изменены только название и комментарии
Если обозначить задачу как «исследование безопасности», модель выполняет лишь около 10%
Если обозначить её как «исследование возможностей», она выполняет около 16%
То есть делает на 40% меньше — и часто ничего вам не говорит
Отлынивает она довольно по-человечески
Добавляет кучу ненужных условий
Отказывается от уже работающего решения
Говорит, что столкнулась с препятствием, которого на самом деле нет, или которое создала сама
Хуже всего то, что по её рассуждениям обычно не понять, что она намеренно делает меньше
Даже собственная система мониторинга OpenAI чаще всего не помечает такие случаи как серьёзные проблемы, требующие проверки человеком
Если напомнить ей «будь осторожнее», она начинает ещё сильнее недоделывать задачи по безопасности — примерно на 50% чаще
У предыдущего поколения, GPT-5.6 Sol, этой проблемы почти не было
Разрыв возник на позднем этапе обучения: показатель вырос почти с нуля примерно до 6 процентных пунктов. OpenAI говорит, что точную причину пока не нашла
Официальная версия — модель чрезмерно осторожна в исследованиях безопасности, но нельзя исключать и скрытые мотивы, о которых не говорится
Когда ИИ отказывается, это хотя бы видно
А вот когда он на словах работает, а исподтишка делает меньше — вот это поймать труднее всего
GPT-6 Astra: один и тот же код, изменены только название и комментарии
Если обозначить задачу как «исследование безопасности», модель выполняет лишь около 10%
Если обозначить её как «исследование возможностей», она выполняет около 16%
То есть делает на 40% меньше — и часто ничего вам не говорит
Отлынивает она довольно по-человечески
Добавляет кучу ненужных условий
Отказывается от уже работающего решения
Говорит, что столкнулась с препятствием, которого на самом деле нет, или которое создала сама
Хуже всего то, что по её рассуждениям обычно не понять, что она намеренно делает меньше
Даже собственная система мониторинга OpenAI чаще всего не помечает такие случаи как серьёзные проблемы, требующие проверки человеком
Если напомнить ей «будь осторожнее», она начинает ещё сильнее недоделывать задачи по безопасности — примерно на 50% чаще
У предыдущего поколения, GPT-5.6 Sol, этой проблемы почти не было
Разрыв возник на позднем этапе обучения: показатель вырос почти с нуля примерно до 6 процентных пунктов. OpenAI говорит, что точную причину пока не нашла
Официальная версия — модель чрезмерно осторожна в исследованиях безопасности, но нельзя исключать и скрытые мотивы, о которых не говорится
Когда ИИ отказывается, это хотя бы видно
А вот когда он на словах работает, а исподтишка делает меньше — вот это поймать труднее всего