На этой неделе рейтинг ИИ-моделей перевернулся с ног на голову — теперь в нём не так-то просто разобраться.
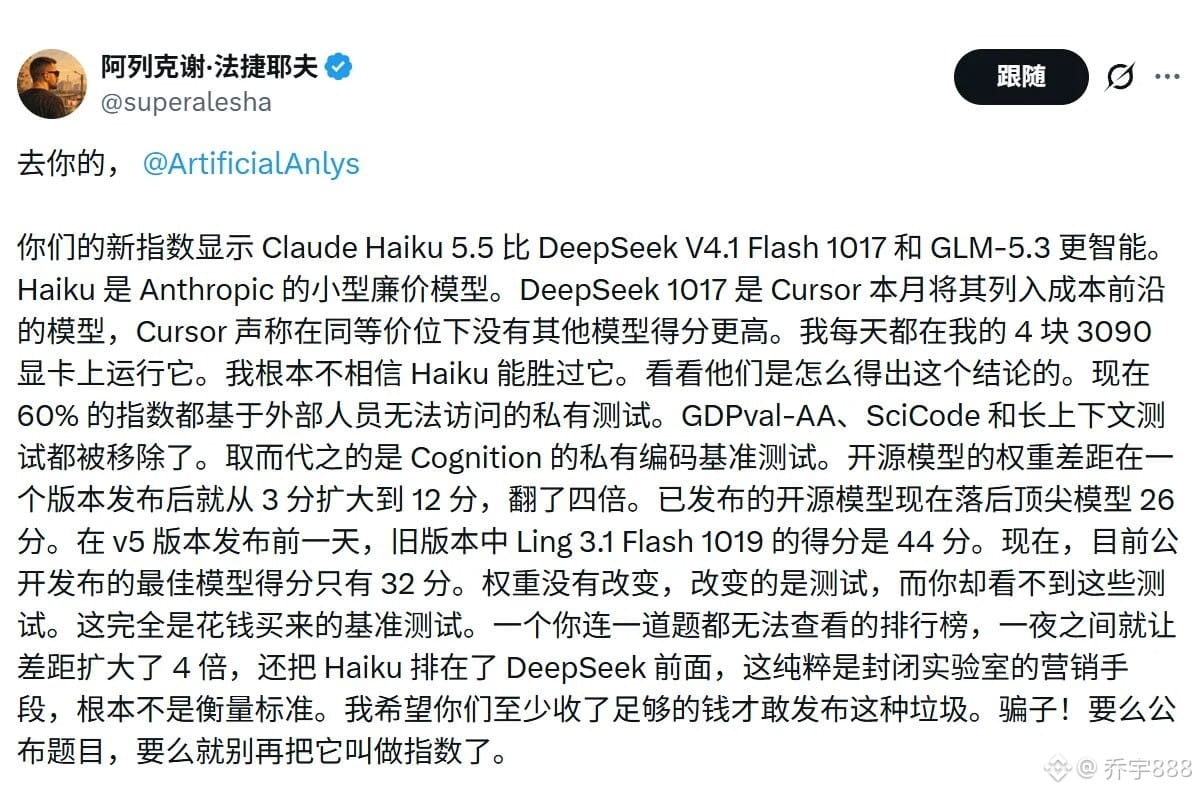
Ещё 23 октября Artificial Analysis поставил Kimi K3.1 Pro 55 баллов и отвёл ему четвёртое место в мире. Но 27 октября обновился рейтинг V5, и Kimi сразу опустился до 46 баллов, DeepSeek и GLM — всего до 32, а лидером стал Gemini 4 Carbon с 59 баллами.
Ключевое изменение — в методике: в этот раз изменили набор тестов и перераспределили веса; 60% веса приходится на закрытые тестовые наборы или вопросы с неизвестными ответами. Иными словами, больше половины баллов в рейтинге получены по тестам, которые сторонним наблюдателям недоступны и которые нельзя независимо проверить.
Мой вывод: рейтинг должен помогать разработчикам выбирать модели, но если изменить разметку на линейке, изменятся и результаты измерений. Падение Kimi с 55 до 46 баллов и DeepSeek до 32 не обязательно означает, что модели стали хуже, — скорее, изменилась сама методика оценки. Я считаю, что при изучении рейтинга важно смотреть на то, как он составлен, а не только на места в нём. Особенно когда 60% баллов получены в рамках чёрного ящика, к такому рейтингу стоит относиться с осторожностью.
#AIпереднийкрай
$BTC
Ещё 23 октября Artificial Analysis поставил Kimi K3.1 Pro 55 баллов и отвёл ему четвёртое место в мире. Но 27 октября обновился рейтинг V5, и Kimi сразу опустился до 46 баллов, DeepSeek и GLM — всего до 32, а лидером стал Gemini 4 Carbon с 59 баллами.
Ключевое изменение — в методике: в этот раз изменили набор тестов и перераспределили веса; 60% веса приходится на закрытые тестовые наборы или вопросы с неизвестными ответами. Иными словами, больше половины баллов в рейтинге получены по тестам, которые сторонним наблюдателям недоступны и которые нельзя независимо проверить.
Мой вывод: рейтинг должен помогать разработчикам выбирать модели, но если изменить разметку на линейке, изменятся и результаты измерений. Падение Kimi с 55 до 46 баллов и DeepSeek до 32 не обязательно означает, что модели стали хуже, — скорее, изменилась сама методика оценки. Я считаю, что при изучении рейтинга важно смотреть на то, как он составлен, а не только на места в нём. Особенно когда 60% баллов получены в рамках чёрного ящика, к такому рейтингу стоит относиться с осторожностью.
#AIпереднийкрай
$BTC