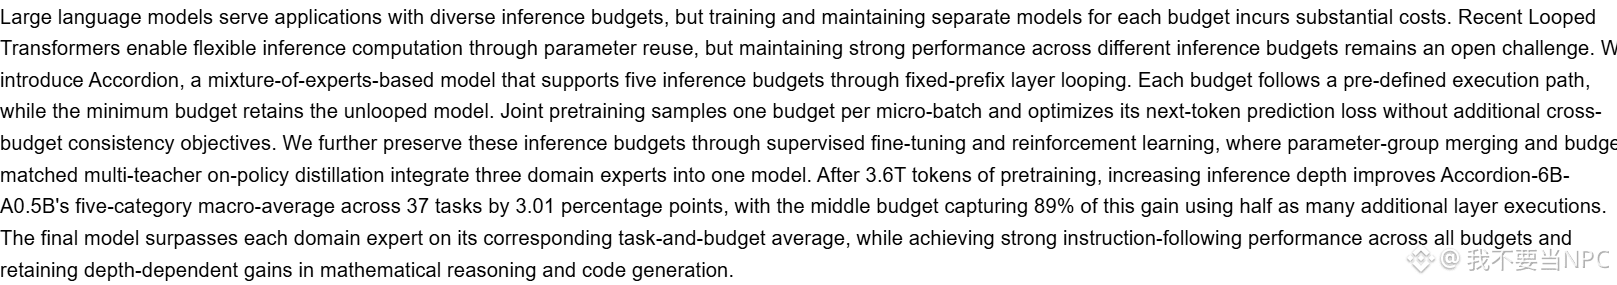
Accordion 是篇 arXiv 预印本,做的事挺具体:用固定前缀层循环,让同一个模型支持五档推理预算。最低档不循环,其余各走自己的执行路径;预训练时每个 micro-batch 只采一档,单独算 next-token loss,不额外加跨预算一致性目标。
6B-A0.5B 预训练 3.6T token 后,推理深度往上加,37 个任务的五类宏平均提升 3.01 个百分点;中间那档用一半的额外层执行量,拿到了这段增益的 89%。后面还靠参数组合并和预算对齐的多教师 on-policy 蒸馏,把三个领域专家合进一个模型。
还没过同行评审,数字先当参考。我更在意的是那 89%:多花的算力换增益,拐点可能比想象中来得早。
$BTC
6B-A0.5B 预训练 3.6T token 后,推理深度往上加,37 个任务的五类宏平均提升 3.01 个百分点;中间那档用一半的额外层执行量,拿到了这段增益的 89%。后面还靠参数组合并和预算对齐的多教师 on-policy 蒸馏,把三个领域专家合进一个模型。
还没过同行评审,数字先当参考。我更在意的是那 89%:多花的算力换增益,拐点可能比想象中来得早。
$BTC