

В прошлый раз я измерял, сколько времени занимает создание одного доказательства. Один из читателей заметил, что я проверил только случай с одной транзакцией, но не протестировал ситуацию, когда одновременно поступает много транзакций. На настоящем сервере организации транзакции не выстраиваются в очередь по одной, поэтому на этот раз я запустил сервис генерации доказательств Rayls и в течение нескольких минут непрерывно подавал на него от 1 до 16 запросов одновременно.
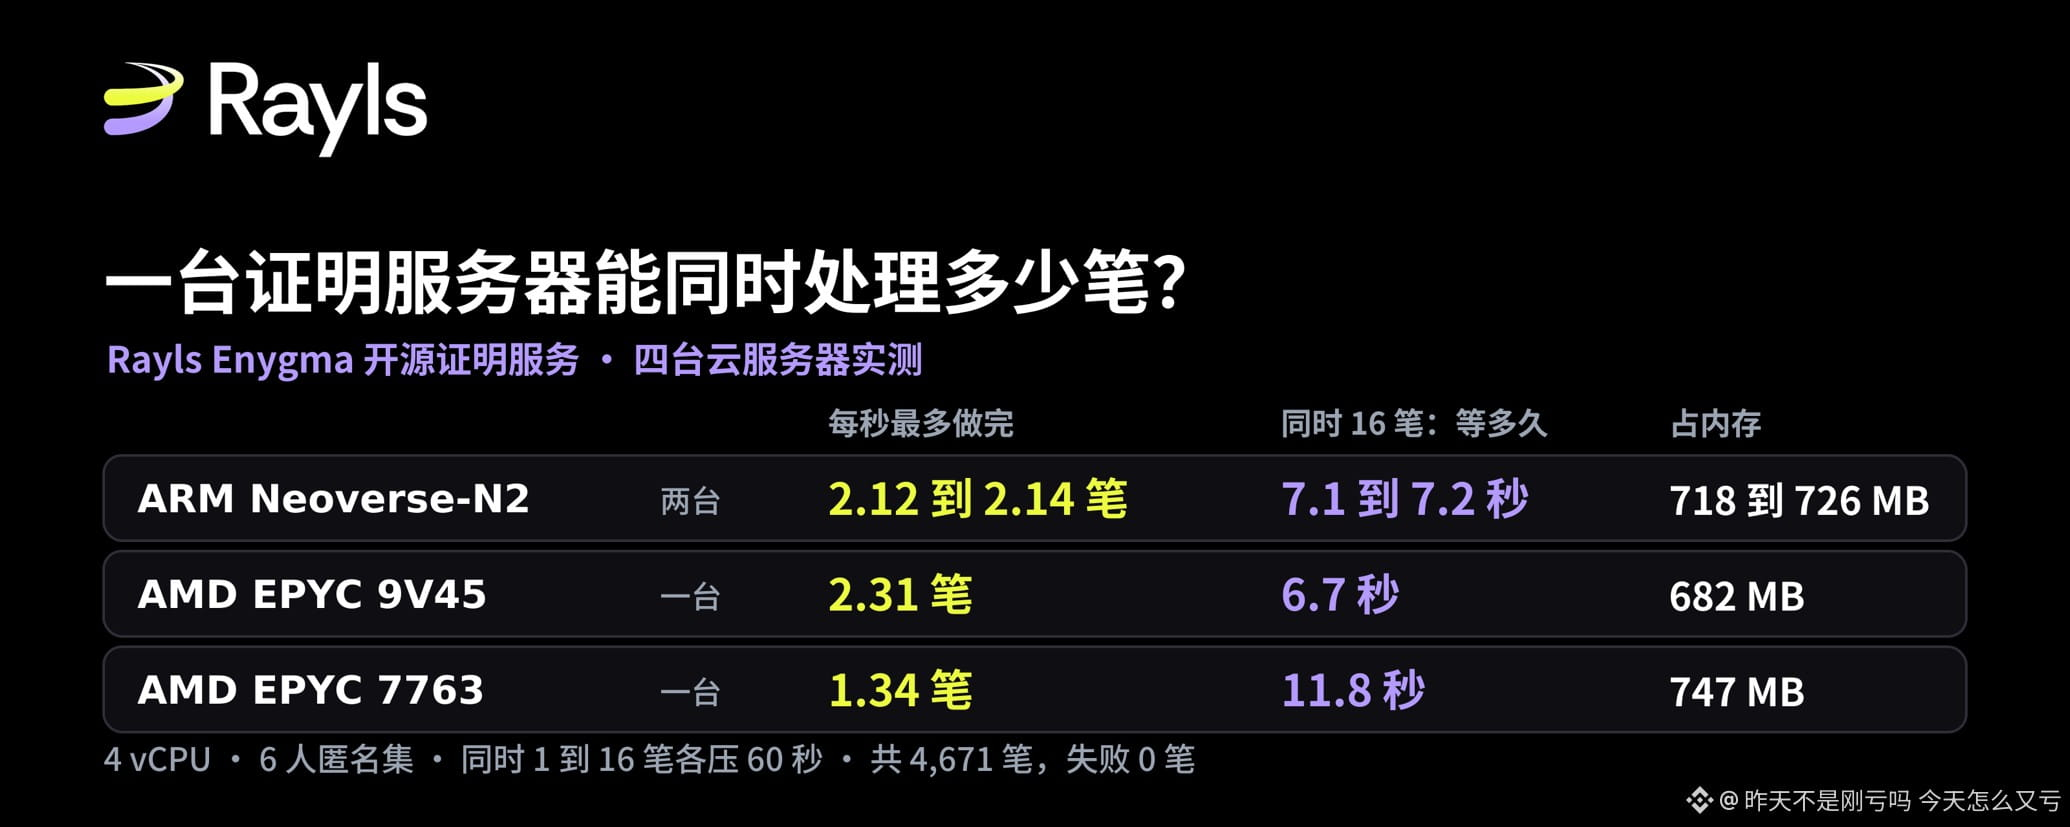
Короткий ответ. Возьмём в качестве примера анонимный набор из 6 участников в схеме приватных переводов Rayls Enygma. Облачный сервер с 4 виртуальными процессорами способен одновременно принять 16 запросов и обработать их все без сбоев, но завершает всего 1,3–2,3 транзакции в секунду. Когда одновременно обрабатывается больше 2–4 запросов, дополнительные запросы не ускоряют завершение работы — просто каждый запрос ждёт дольше и требует больше памяти: при 16 одновременных запросах медианное время ожидания одного перевода увеличивается с 0,5–0,9 до 6,7–11,8 секунды, а потребление памяти растёт примерно с 260 МБ до 680–750 МБ.
Ниже я расскажу, откуда взялись эти цифры, почему получились именно такие результаты и что они означают для организации, которая собирается самостоятельно генерировать доказательства.
Почему важнее знать, сколько операций обрабатывается одновременно, а не сколько времени занимает одна
Доказательство с нулевым разглашением можно представить как математическое подтверждение: плательщик не раскрывает сумму и контрагента, но всё равно доказывает сети корректность операции. Для создания такого подтверждения требуется множество вычислений на эллиптических кривых, которые почти полностью выполняются на CPU.
В предыдущей статье рассматривалось, сколько времени занимает вычисление одного доказательства. Но серверы организаций получают запросы партиями, по несколько одновременно. Для сервиса, загружающего CPU на полную мощность, именно количество одновременно обрабатываемых операций определяет пропускную способность, время ожидания и расход памяти — эти показатели и нужно учитывать при закупке и развёртывании оборудования.
Эта проблема касается не только Rayls. С такой же дилеммой сталкиваются все системы, которые генерируют доказательства с нулевым разглашением на собственных серверах. Различаются лишь размеры схем и оборудование.
Как проводилось тестирование и как его повторить
Как и прежде, тестировался открытый сервис доказательств Rayls rayls-sovereign-gnark-api, коммит 67c4c26; в коде не изменили ни одной строки. Код теста находится в общедоступном репозитории hansonhan0520-lang/enygma-bench. В этот раз добавили написанный только на стандартной библиотеке Go инструмент нагрузочного тестирования loadgen и скрипт run_load.sh. GitHub Actions запускает их автоматически, а журналы сохраняются в папке results репозитория.
Нагрузочный тест проводился так: HTTP-сервис доказательств Rayls запускался без изменений, после чего одновременно обрабатывались 1, 2, 4, 8 и 16 запросов. Каждая ступень длилась 60 секунд, первые 5 секунд отводились на разогрев и не учитывались. Фиксировалось время выполнения каждого запроса, а память процесса сервиса считывалась каждые 0,1 секунды. В конце тест запускался на 5 минут с 4 одновременно обрабатываемыми запросами; результаты подсчитывались интервалами по 30 секунд.
Все приведённые здесь цифры получены при запуске Actions 39977915567 (23 октября 2026 года). Тест был выполнен по одному разу на четырёх независимо выделенных облачных серверах: двух с ARM Neoverse-N2, одном с AMD EPYC 9V45 и одном с AMD EPYC 7763. На каждом было по 4 vCPU. Всего обработано 4 671 запрос, ошибок не было.
Уточню, что именно здесь нового. Генератор тестовых данных и измерение времени одной операции взяты из предыдущей статьи. Новые части этой статьи — пропускная способность реального сервиса при параллельной обработке, задержки в хвосте распределения и потребление памяти, нагрузка в течение 5 минут, а также сравнительный эксперимент с закреплением за CPU.
Чем больше операций обрабатывается одновременно, тем медленнее работа — ускорения не происходит
На всех четырёх машинах наблюдалась одна и та же закономерность. При увеличении числа одновременно обрабатываемых операций с 1 до 2 растёт число операций в секунду: на N2 примерно на треть, на 9V45 примерно на 18%, на 7763 примерно на 14%. Пик достигается при 4 одновременных операциях: на N2 — 2,12–2,14 операции в секунду, на 9V45 — 2,31, на 7763 — 1,34. При дальнейшем увеличении числа запросов до 16 пропускная способность не растёт, а падает на 4–10% относительно пикового значения.
Время ожидания при этом неуклонно увеличивается. При одной одновременно обрабатываемой операции медианное время запроса составляет 0,52–0,86 секунды; при 16 — уже 6,70–11,81 секунды, то есть в 11–14 раз больше. Самый медленный 1% запросов приходится ждать 10,00–13,91 секунды.
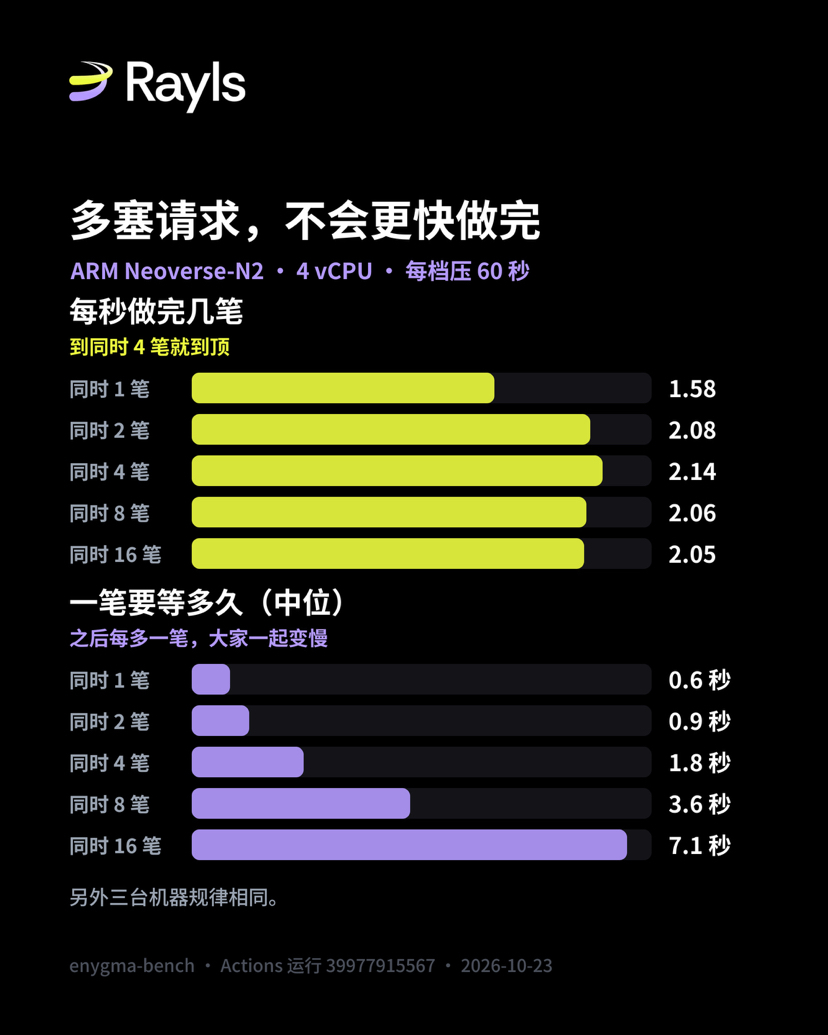
Журналы самого сервиса показывают, на что уходит время ожидания. Сервис доказательств Rayls записывает для каждого запроса внутреннее время генерации доказательства. При 16 одновременных запросах разница между медианным внутренним временем и общим временем, измеренным снаружи, составляет менее 3%. Иными словами, запросы не стоят в очереди у входа: вычисления начинаются сразу, и все 16 запросов замедляются, конкурируя за 4 vCPU. Это подтверждается и чтением кода: сервис не ограничивает число параллельных запросов, а каждый запрос сразу переходит к генерации доказательства.
За этим стоит общая закономерность: на полностью загруженной машине количество одновременно обрабатываемых операций равно числу операций в секунду, умноженному на время выполнения одной операции. Когда пропускная способность достигает предела, добавление запросов приводит лишь к увеличению времени выполнения.
Каждая дополнительная обрабатываемая операция занимает около 30 МБ памяти
После запуска сервиса и загрузки ключа для схемы на 6 участников в режиме простоя он использует 210–217 МБ памяти. Чем больше запросов обрабатывается одновременно, тем выше потребление: при 16 запросах пиковое значение составляет 682–747 МБ. На каждую дополнительную одновременно обрабатываемую операцию приходится примерно 28–32 МБ. Для машины с 4 vCPU и 16 ГБ памяти это не проблема, но при внезапном всплеске запросов и отсутствии ограничений потребление памяти будет линейно расти вместе с их числом.
Пять минут непрерывной работы без замедления
Тест с 4 одновременно обрабатываемыми запросами шёл непрерывно 5 минут, результаты подсчитывались каждые 30 секунд. На всех четырёх машинах пропускная способность в каждом интервале отклонялась от собственного среднего не более чем на 7%: на двух N2 она составляла 2,03–2,23 операции в секунду, на 9V45 — 2,13–2,37, на 7763 — 1,30–1,43. Пиковое потребление памяти оставалось в диапазоне 421–505 МБ, признаков постоянного роста не было. За всё время ни один запрос не завершился ошибкой.
Предположение из предыдущей статьи теперь проверено сравнительным экспериментом
В предыдущей статье я заметил, что переход с 2 vCPU на 4 vCPU ускорил работу на Intel-машине лишь в 1,17 раза, и объяснил это тем, что, согласно lscpu, «на двух ядрах работает по два потока». Рецензент указал, что облачный сервер — это виртуальная машина, а видимое число ядер не позволяет судить о распределении ресурсов на физическом оборудовании. Это объяснение было лишь предположением.
В этот раз я закрепил программу генерации доказательств за конкретными CPU с помощью taskset и сравнил на одной машине две конфигурации по два CPU: два потока на одном ядре или по одному потоку на каждом из двух разных ядер. Тест провели в три раунда, чередуя порядок, чтобы избежать смещения из-за изменения состояния машины со временем. На обеих машинах AMD результаты в каждом раунде были одинаковыми: два потока на одном ядре работали лишь в 1,10–1,18 раза быстрее, чем один CPU; два разных ядра — в 1,53–1,57 раза быстрее. На N2 без гиперпоточности два CPU давали ускорение в 1,49–1,58 раза.
Таким образом, объяснение, что «из-за гиперпоточности 3-й и 4-й vCPU дают лишь небольшой прирост», теперь подкреплено результатами сравнения на одной и той же машине. Но важно обозначить ограничения: это топология, видимая внутри виртуальной машины; я не могу увидеть, как хост распределяет физические ядра.
Нужно пояснить ещё один момент. Ускорение примерно в 1,5 раза при закреплении за двумя CPU ниже, чем приблизительно в 1,9 раза в предыдущей статье, где CPU не закреплялись, а Go ограничивался двумя потоками. Одна из возможных причин — при отсутствии закрепления другие фоновые потоки программы могли использовать ещё два CPU. Отдельно это не измерялось. Поэтому результаты с закреплением CPU подходят для сравнения разных условий, но не для оценки производительности.
Что это означает для организации, которая собирается самостоятельно генерировать доказательства
Этот раздел содержит выводы, а не результаты измерений.
Во-первых, установите для сервиса доказательств предел параллельной обработки — примерно равный числу CPU, — а остальные запросы ставьте в очередь. Пропускная способность достигает пика уже при 2–4 операциях; запросы сверх этого предела лишь замедляют каждую выполняющуюся операцию и увеличивают расход памяти. В этой работе не тестировалась версия с ограничением параллельной обработки, поэтому насколько очередь поможет уменьшить задержки в хвосте распределения — вопрос, который ещё предстоит проверить.
Во-вторых, измеряйте пропускную способность на реальном оборудовании, а не ориентируйтесь на название типа машины. В этом тесте один и тот же x64-раннер GitHub с 4 vCPU показывал 2,31 завершённой операции в секунду при распределении на AMD EPYC 9V45 и всего 1,34 — на AMD EPYC 7763. Разница превышает 40%.
В-третьих, рассчитывайте количество машин по пропускной способности, а не по времени выполнения одной операции. В предыдущей статье оценка по времени выполнения одной операции дала для машины с 4 vCPU примерно 1,41–1,58 операции в секунду. В этом тесте измеренная пропускная способность при 4 одновременно обрабатываемых запросах в течение 5 минут составила 2,15–2,29 операции в секунду на N2 и 9V45 и 1,35 — на 7763. На примере N2 это примерно на 36% выше, чем 1,58 операции в секунду, полученные в предыдущей статье расчётом по времени одной операции.
По этим цифрам пересчитаем британскую CHAPS: в 2025 финансовом году в среднем 210 483 операции в день. Если распределить их по расчётному окну каждого рабочего дня с 06:00 до 18:00, получится около 4,87 операции в секунду — потребуется 2,1–3,6 таких машин. В американской Fedwire в 2025 году в среднем было 869 187 операций в день. При 22 часах работы в сутки это около 10,97 операции в секунду — потребуется 4,8–8,1 машины. Это лишь приблизительная оценка вычислительных ресурсов для генерации доказательств первого порядка, а не пропускной способности расчётов Rayls. Она не учитывает внутридневные пики нагрузки и накладные расходы реестра и ретрансляторов. Кроме того, доказательства генерируют сами учреждения, инициирующие переводы, поэтому нагрузка изначально распределена между ними.
Что пока не определено
В этот раз тестировалась только схема перевода с анонимным множеством из 6 участников; схемы депозита, вывода и DvP не тестировались. Проверялся сам сервис доказательств Rayls, а не весь процесс расчётов Rayls, который также включает реестры отдельных организаций, ретрансляторы и узлы частной сети. Всё это невозможно запустить на общедоступном коде. Все четыре машины были виртуальными машинами на общих облачных серверах, а не физическими серверами и не производственной средой Rayls. Сборка мусора в Go использовала настройки по умолчанию; после их изменения график потребления памяти может выглядеть иначе. В общедоступных материалах мне не удалось найти сведения о конфигурации оборудования и параллельной обработки в производственной среде Rayls.
Мой вывод
Обычный облачный сервер с 4 vCPU может одновременно принять десятки запросов на доказательства с нулевым разглашением, не выдавая ошибок, и стабильно работать так несколько минут. Но у его производительности есть жёсткий предел — примерно от одной до чуть более двух операций в секунду. Если превысить его, дополнительные запросы приведут лишь к более долгому ожиданию и большему расходу памяти.
Критерий проверки прост: любой желающий может запустить enygma-load на странице Actions репозитория enygma-bench и проверить, достигает ли пропускная способность пика при 2–4 одновременно обрабатываемых операциях на выделенной ему машине. Если Rayls в будущем опубликует конфигурацию производственного сервиса доказательств — например, установлено ли ограничение на параллельную обработку и какое используется оборудование, — этот нагрузочный тест можно будет напрямую применить для сравнения.
Источники:
Исходный код сервиса доказательств Rayls, raylsnetwork/rayls-sovereign-gnark-api, коммит 67c4c26 (20 августа 2026 года): https://github.com/raylsnetwork/rayls-sovereign-gnark-api/commit/67c4c26696016b48e70950e284ae1a51b7d0cf0e
Код нагрузочного теста для этой статьи и все журналы, запуск Actions 39977915567 (23 октября 2026 года): https://github.com/hansonhan0520-lang/enygma-bench
Тест одной операции из предыдущей статьи и журналы, запуск Actions 37741247183 (8 октября 2026 года): https://github.com/hansonhan0520-lang/enygma-bench
Характеристики размещённых на GitHub раннеров (проверено 8 октября 2026 года): https://docs.github.com/en/actions/reference/runners/github-hosted-runners
Статистика Fedwire Funds за 2025 год (страница обновлена 26 января 2026 года): https://www.frbservices.org/resources/financial-services/wires/volume-value-stats/annual-stats.html
Статистика платежей и расчётов Банка Англии, среднее число операций CHAPS за день в 2025 финансовом году: https://www.bankofengland.co.uk/payment-and-settlement/payment-and-settlement-statistics
#Rayls $RLS #доказательстваСНулевымРазглашением