Nillion: как сделать данные полезными, не жертвуя конфиденциальностью
Я изучаю Nillion, и его подход к слепым вычислениям — одна из самых интересных идей, с которыми я сталкивался в сфере защиты конфиденциальности.
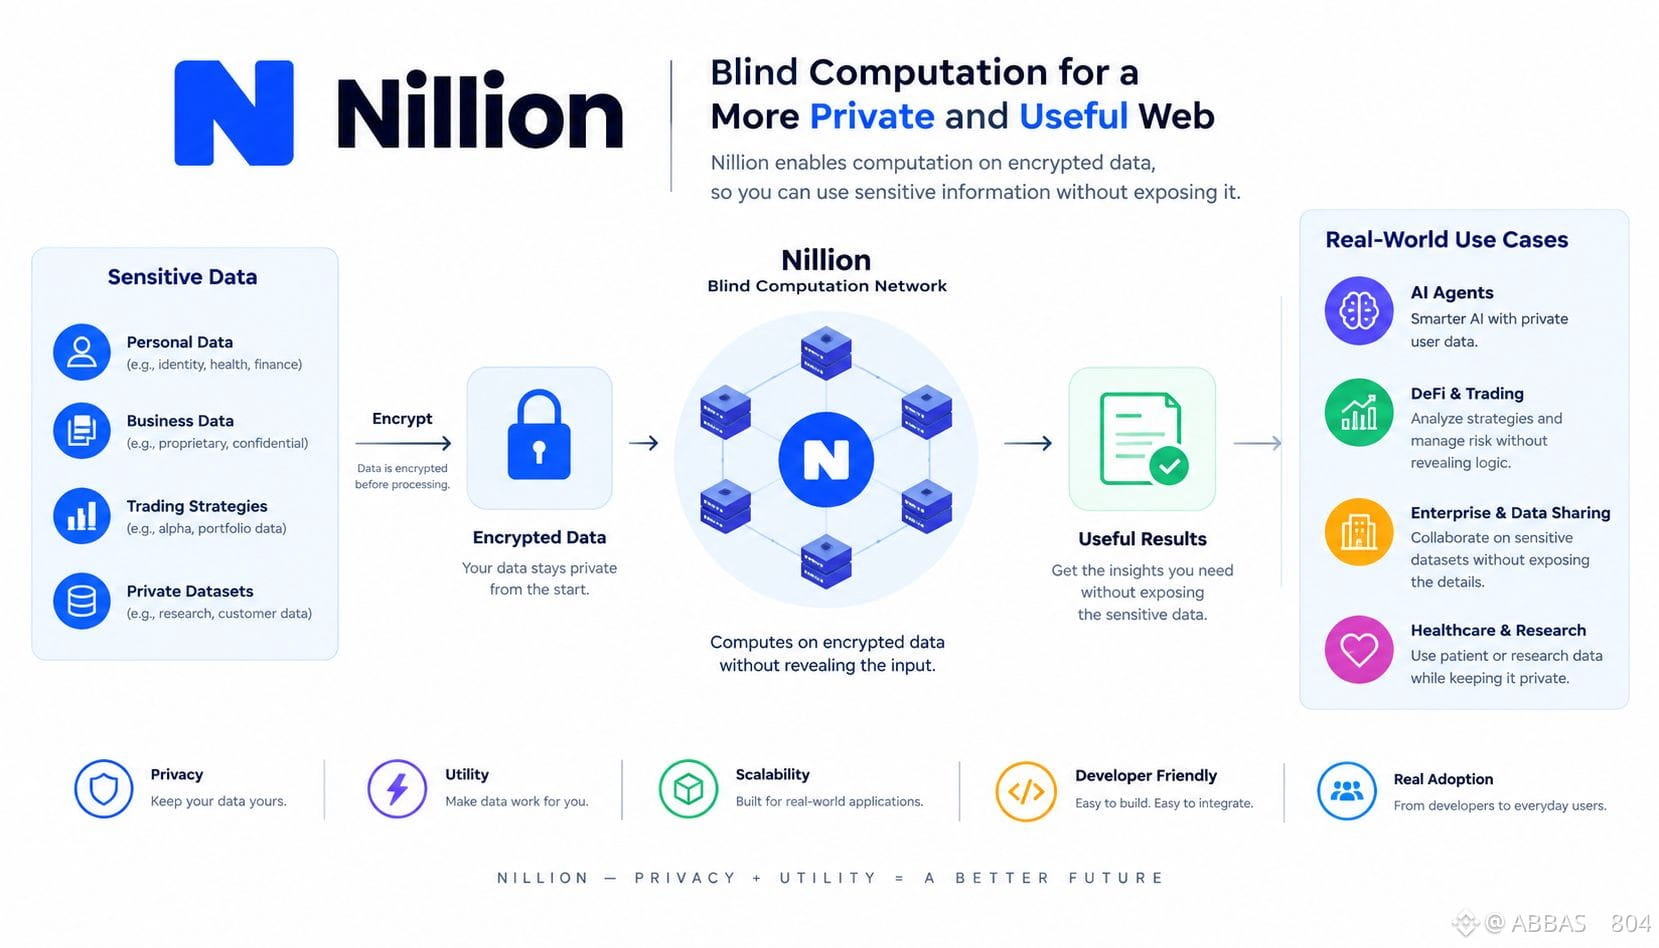
Основная идея впечатляет: что, если приложения смогут обрабатывать конфиденциальную информацию, не раскрывая без необходимости исходные данные? Вместо того чтобы заставлять пользователей выбирать между конфиденциальностью и практической пользой, Nillion стремится обеспечить и то и другое.
Представьте, что ИИ-агенты получают доступ к личным данным и выдают более точные результаты, не раскрывая приватную информацию. Подумайте о торговых системах, анализирующих конфиденциальные стратегии без раскрытия их логики, или о компаниях, которые совместно работают с чувствительными наборами данных, защищая ценную информацию.
Это не просто теоретические вопросы. По мере развития ИИ, децентрализованных финансов и приложений, работающих с данными, всё важнее становится защищать информацию, сохраняя её полезность.
Однако сама технология — лишь часть истории. Реальное внедрение будет зависеть от безопасности, производительности вычислений, удобства для разработчиков и того, насколько легко команды смогут интегрировать Nillion в существующие приложения.
Мне особенно интересно, какие проекты строятся на этой сети, какие задачи они решают и возвращаются ли пользователи, потому что технология действительно приносит пользу.
Для меня главный вопрос не просто в том, работают ли слепые вычисления, а в том, смогут ли они стать практической инфраструктурой для приложений, которые ежедневно обрабатывают конфиденциальные данные.
Где, на ваш взгляд, Nillion сможет оказать наибольшее влияние: в ИИ-агентах, DeFi или обмене данными с сохранением конфиденциальности?
#nil $NIL @Nillion