

19 сентября Rayls опубликовал статью (Privacy has a price). В заголовке было написано honest math, но по всей статье был дан лишь один числовой диапазон: доказательство занимает от нескольких сотен миллисекунд до нескольких секунд. Я несколько недель подряд писал про приватную архитектуру Rayls. На этот раз делюсь с вами новым материалом: я скачал опубликованный код доказательства, реально прогнал его десятки раз — и спешу поделиться этой интересной находкой!
Сначала скажу, о чём был блог. Его ключевые тезисы можно сжать в две фразы. Первая — где именно цена: конфиденциальные транзакции дороже прозрачных — дорого именно генерировать zk-доказательства, а проверка при этом получается дешевле; для базового конфиденциального перевода доказательство на обычном коммерческом оборудовании занимает от нескольких сотен миллисекунд до нескольких секунд. Вторая — что стоит спрашивать: организации не должны смотреть только на TPS, нужно спрашивать, каков будет throughput при той приватности и уровне аудита, которые им реально нужны, и при работе с реальной бизнес-нагрузкой. В блоге считают, что объём расчётов между банками небольшой и полностью укладывается в возможности систем конфиденциальных расчётов.
Эта статья делает очень простую вещь: берёт вопрос, который сам блог сформулировал, и задаёт его открытым кодом Enygma. Всё, что ниже написано как «блог говорит», — это утверждения из оригинала; «я измерил/я посчитал» — это мои собственные результаты и выводы, пожалуйста, смотрите раздельно.
Как я измерял
Доказательство с нулевым разглашением можно понимать как математическую расписку: плательщик не раскрывает ни баланс, ни сумму, но может доказать сети, что эта операция корректна. Система доказательств, которую использует Enygma, называется Groth16; код сервиса, который генерирует доказательства, открыт в репозитории GitHub rayls-sovereign-gnark-api. В README его назначение описано как proof-API за Privacy Ledger и Private Network Hub.
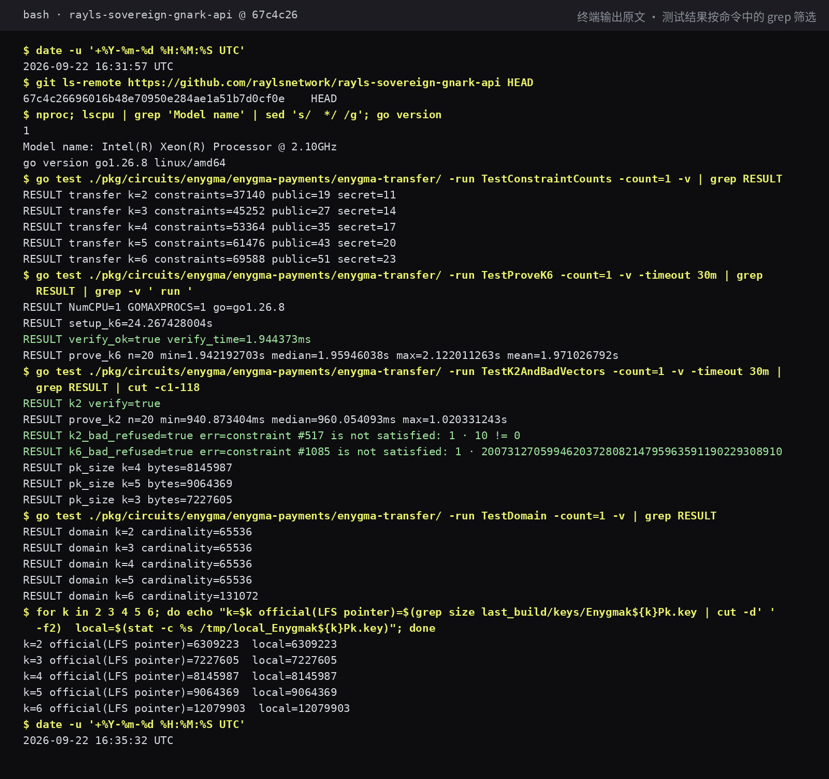
Я измерял main-ветку в самом последнем коммите от 22 сентября 2026 года: 67c4c26. Схема и код доказательств ни на одну строку не изменены. Я лишь добавил несколько тестовых файлов, чтобы вызывать собственные функции доказательств репозитория; подставляемые данные транзакций взяты из тестового набора, который идёт вместе с репозиторием: по одной группе для k=2 и k=6.
Здесь k — размер анонимного множества (anon set). По коду схемы: одна транзакция перевода заставляет сгенерировать обязательство по сумме для k участников; отправитель прячется среди них, и посторонним не видно, кто именно платит кому. Чем больше k, тем глубже скрытие и тем больше схема. В репозитории в скрипте стресс-тестирования используется k=6.
Ключи я сгенерировал у себя на машине тем же groth16.Setup с одинаковыми параметрами. Это не влияет на время: время генерации определяется структурой схемы и не зависит от конкретных чисел в ключах. В README репозитория тоже сказано, что ключевой набор в репозитории сам по себе — продукт одностороннего Setup для разработки и тестирования, а не результат многосторонней доверенной настройки; для продакшн-развёртывания требуется отдельная церемония. Это соответствует тому, что в блоге говорится про «доверенную настройку» для Groth16.
Тестовое окружение — однопроцессорная Linux-виртуалка: Intel Xeon 2.1GHz, 3GB памяти. Для каждого значения k подряд генерировалось 20 доказательств; затем после нескольких минут перерыва весь тестовый прогон повторялся во втором раунде.
Измеренные числа
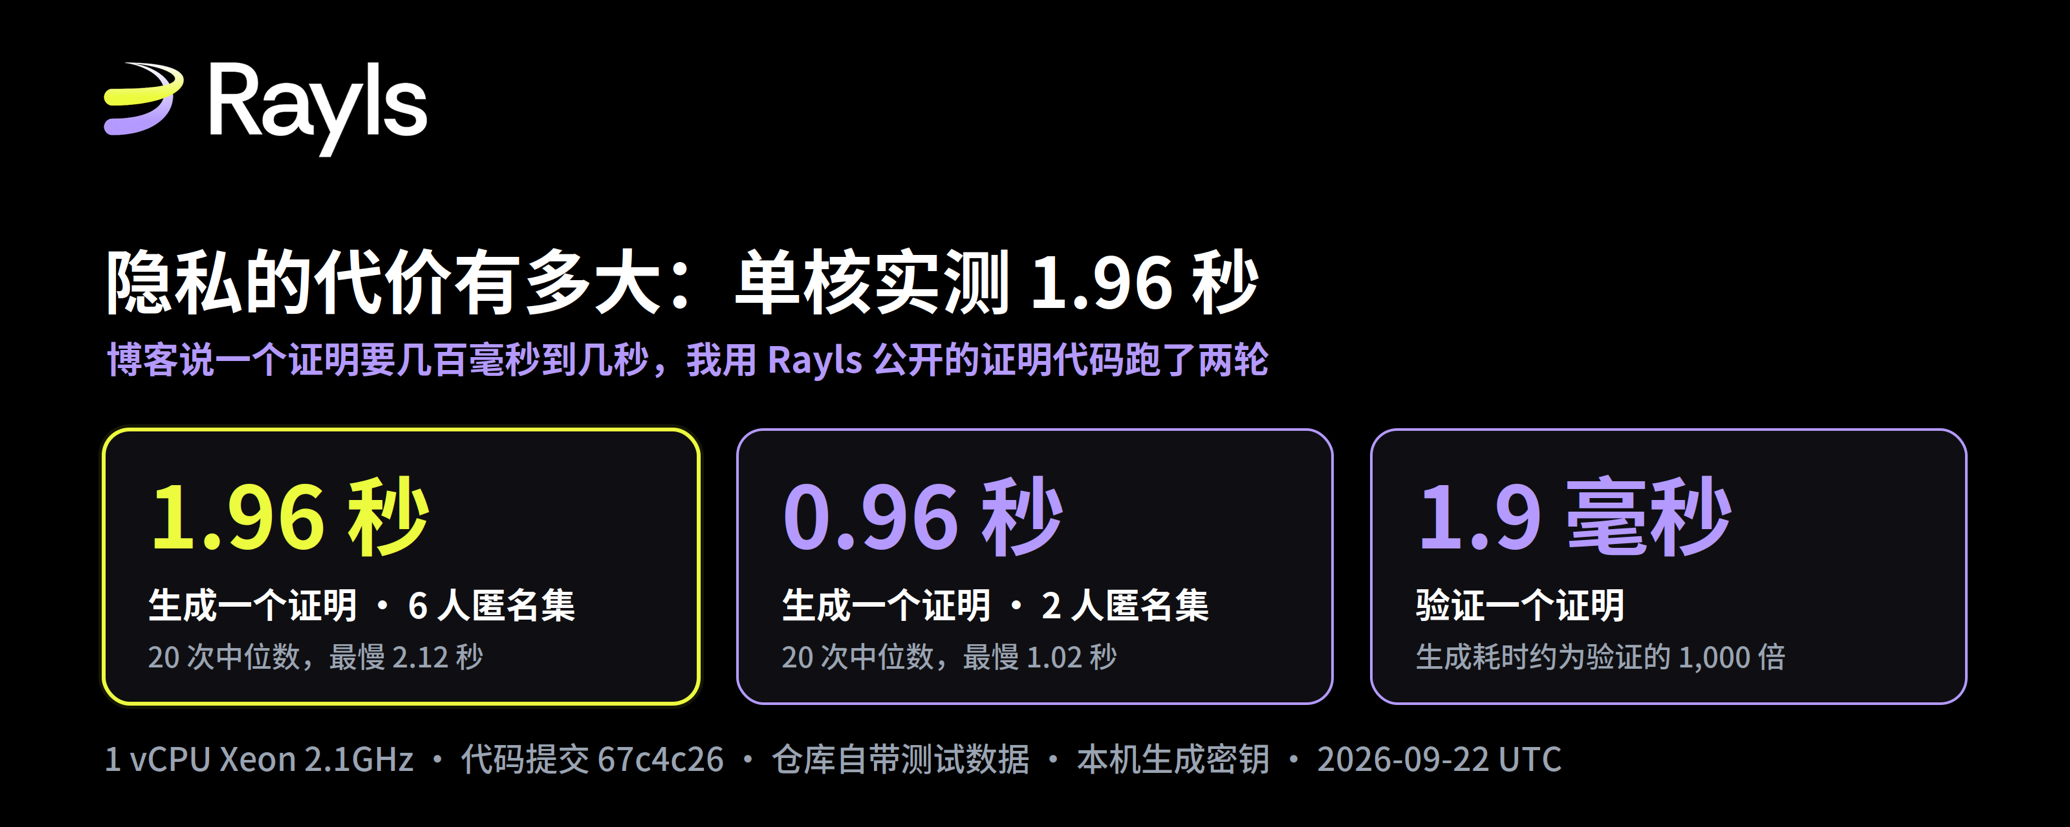
Результаты второго раунда: доказательство при k=6 — медиана 1,96 секунды из 20 запусков; самый быстрый 1,94 с, самый медленный 2,12 с; медиана для k=2 — 0,96 секунды. В первом раунде было 1,97 с и 0,96 с соответственно; различие между двумя раундами меньше 1%. Проверка одного доказательства занимает всего 1,9 миллисекунды.
Эти цифры попадают в интервал, который дал блог. Но важнее другое — соотношение времени на генерацию и на проверку: 1,96 секунды против 1,9 миллисекунды, примерно 1000:1. Блог утверждает, что основное время уходит на генерацию, а проверка очень дешёвая. Это соотношение превращает слова «в основном» в конкретный множитель.
Я сделал ещё одну обратную проверку. В тестовом наборе есть две группы данных с намеренно внесёнными ошибками: в группе k=2 сумму перевода изменили с 0 на 10, а в группе k=6 подменили одно значение хеша. В обеих группах на этапе доказательства проверка была отклонена; в каждом случае выдавалась ошибка про то, что нарушено условие №517 и №1085 соответственно, так что доказательство сгенерировать не удавалось. Конечно, это не доказывает отсутствие у схемы уязвимостей — лишь то, что эти две очевидные подделки блокируются.
Детали, которых нет в двух блогах
Первый момент — масштаб схемы. На каждый дополнительный участвующий участник количество constraints стабильно увеличивается на 8 112: с 37 140 при k=2 — до 69 588 при k=6, это прямая линия. Но система доказательств при распределении вычислительного пространства для схемы округляет до степеней двойки: k=2…k=5 помещаются в пределы 65 536, а при k=6 выходит за 4 052 и вычислительный масштаб сразу перепрыгивает до 131 072.
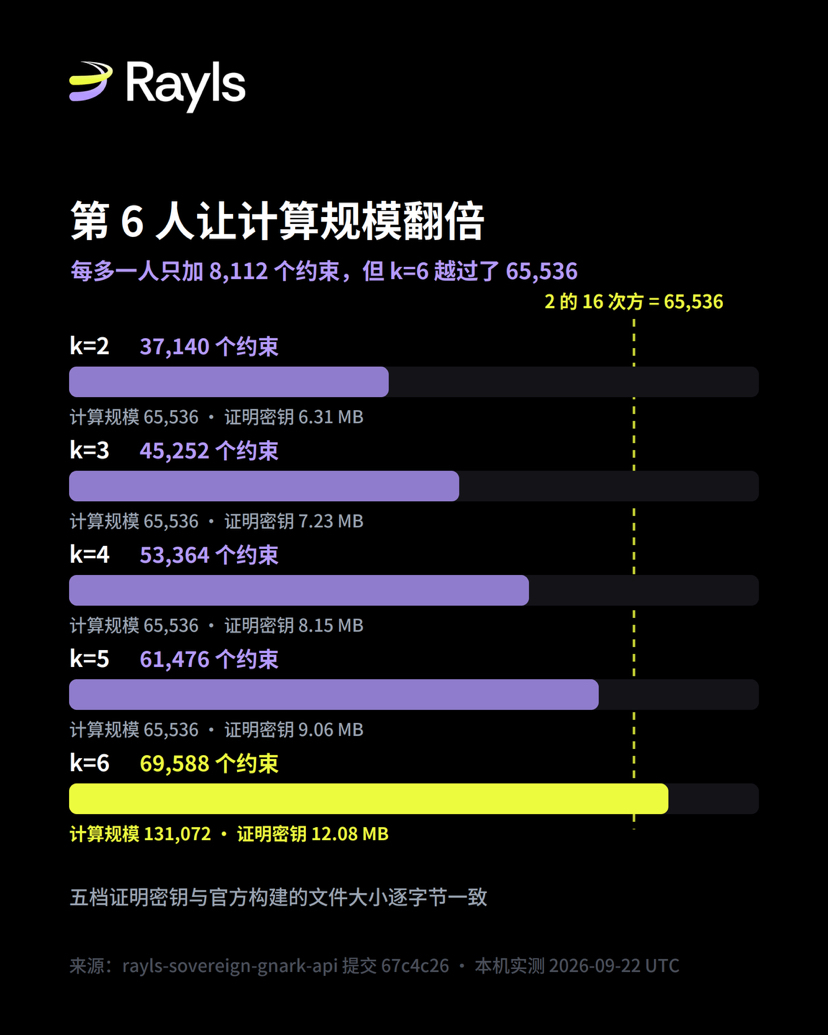 Доказательство — в размере файла с ключом доказательства. Для k=2…k=5 размер ключа стабильно увеличивается на 918 382 байта на каждом шаге; а при k=6 увеличение происходит сразу на 3 015 534 байта — это более чем втрое больше, чем приросты на предыдущих этапах. По направлению изменения времени тоже совпадает: при переходе от k=2 к k=6 constraints становится больше на 87%, а время генерации — больше на 104%. Насколько именно долго занимает шаг при переходе через границу, можно определить только по данным транзакций для k=3…k=5, чтобы разрезать процесс; сейчас репозиторий предоставляет только k=2 и k=6, поэтому я могу подтвердить только то, что направление совпадает. Если в производстве используется k=6, то оно как раз по другую сторону этой границы, и тогда цена перехода с k=5 на k=6 будет больше, чем между предыдущими значениями; это моё предположение, а не формулировка блога.
Второй момент — согласованность. Я сгенерировал пять наборов ключей доказательств из открытого исходного кода; размеры файлов и официальные сборочные артефакты из репозитория совпадают вплоть до байта, и ключ верификации для k=6 тоже совпадает. Содержимое ключей, разумеется, отличается: каждый Setup заново случайно генерирует параметры. Но размеры полностью совпадают, что говорит о том, что структура схем, полученная из открытого исходного кода, — та же самая, что и в официальной сборке. В прошлый раз, когда я упоминал про аудит Axyl, я писал, что между публичным репозиторием и приватной версией для аудита есть фрагмент истории, который нельзя проследить. На этот раз, в части сервиса доказательств, хотя бы этот кусок — между исходниками и официальной сборкой — совпал; а совпадает ли официальная сборка с продакшн-развёртыванием — публичные материалы пока ответить не позволяют.
Вставить вопросы из блога в реальные нагрузки
Сначала подключу предыдущее. В той статье я разбирал источники нескольких чисел из раздела про 15 000+ TPS — они описывали слой консенсуса Axyl. В этот раз измеряется другой слой: то есть время генерации доказательства, которое уходит на каждую конфиденциальную транзакцию именно у отправителя. Цифры двух слоёв нельзя складывать и нельзя взаимозаменять.
Масштаб, который приводит блог: у крупных агентских банков — несколько тысяч операций в день, а у сервиса токенизированного real-time gross settlement уровня центрального банка — десятки тысяч крупных переводов в день. Я подставил вместо этого открытые данные двух готовых систем. Fedwire Funds Service ФРС: среднесуточно 869 187 операций в 2025 году; CHAPS Великобритании: среднесуточно 210 483 операции за весь 2025 год — это соответственно в десятки раз и в несколько раз больше, чем приведённые блогом примеры.
Ниже — то, что я посчитал, а не формулировки блога. По замерам на одном ядре: 1,96 секунды на доказательство при k=6. Тогда одним ядром за день максимум генерируется около 44 000 доказательств. Если подставить все среднесуточные операции Fedwire за 2025 год и пересчитать на доказательства k=6, нужно примерно 473 ядро-часа, то есть 20 ядер «непрерывно» весь день; для CHAPS — около 115 ядро-часов, меньше 5 ядер. В материалах Банка Англии за 2021 год записано, что рекорд по числу операций CHAPS за один день был 320 034 операции 29 марта 2018 года — примерно в 1,7 раза больше, чем среднее число за день в том году; по этому пиковому значению получается лишь около 174 ядро-часов.
Этот расчёт нужно явно оговорить. Он переводит всё в предположение «одно доказательство — одно ядро»; доказательства независимы друг от друга и поэтому могут одновременно генерироваться на разных ядрах. Подсчитывается именно время генерации доказательства перевода. Пополнение, извлечение и DvP — это другие схемы. Кроме того, сетевой обмен и расчёты в блокчейне сюда не входят. Ещё блог говорит, что доказательства генерируются отправителем, то есть нагрузка естественно распределена по нодам каждой организации, а не сосредоточена на одной машине.
Итак, мой вывод такой: блог утверждает, что объём межбанковских расчётов находится в пределах возможностей системы конфиденциальных расчётов — и это утверждение при реальных масштабах всё ещё верно. Их же приведённые объёмы меньше, чем реальные цифры; если подставить реальные значения, то вывод всё равно остаётся обоснованным. Наоборот, это делает пример из оригинала более убедительным, чем исходная подача. В части про retail-платежи блог сам признаёт, что это настоящий узкий bottleneck; текущие цифры тот вывод не меняют.
Как использовать этот набор цифр
Все эти цифры получены на одном ядре, поэтому это можно считать скорее консервативной отправной точкой. Причина в коде: при генерации доказательства gnark самые тяжёлые multi-scalar multiplications разбиваются на несколько задач и вычисляются параллельно по числу ядер CPU (runtime.NumCPU() напрямую читается в backend/groth16/bn254/prove.go). Серверы организаций обычно многопроцессорные/многоядерные: одно и то же доказательство будет распределено по большему числу ядер, и время будет меньше, чем здесь в однопоточном/однодерном результате. Насколько именно быстрее — зависит от числа ядер и производительности одного ядра.
Этот материал измеряет сам процесс генерации доказательства для схемы перевода. В полной цепочке HTTP-сервиса есть ещё и разбор JSON и сетевые накладные расходы; хранение, извлечение и DvP — это уже другие виды схем. Совпадение размеров ключей говорит о том, что структура схем одна и та же, но не означает, что содержимое ключей одинаковое; это я уже объяснял ранее.
Моё мнение
Заголовок блога — honest math, но в тексте приведён только один интервал. После этих прогонов интервал оказался корректным, и вывод по части межбанковских расчётов тоже выдерживает проверку.
Я бы больше хотел увидеть следующий шаг. В бенчмарках Axyl на странице с результатами указаны условия вроде комиссии из четырёх узлов и транзакции на 512 байт; и производительность доказательств Enygma тоже заслуживает такого же уровня детализации: при следующей публикации чисел нужно указать значение k и аппаратную конфигурацию — тогда организации смогут, как и я, самостоятельно воспроизвести. Это именно те заявления о производительности, которые выдерживают проверку в производственной эксплуатации, о которых в конце говорит сам блог. Воспроизвести несложно: команды на скриншоте — это полностью весь процесс.
Источник для справки: официальный блог Rayls (Privacy has a price: the honest math behind confidential settlement at scale) (19 сентября 2026 года); GitHub raylsnetwork/rayls-sovereign-gnark-api, коммит 67c4c26 (прочитан и измерен 22 сентября 2026 года); годовая статистика Fedwire Funds Service ФРС (обновлено 26 января 2026 года); материалы Банка Англии Payment and settlement statistics и (A brief introduction to RTGS and CHAPS) (версия 2021 года).