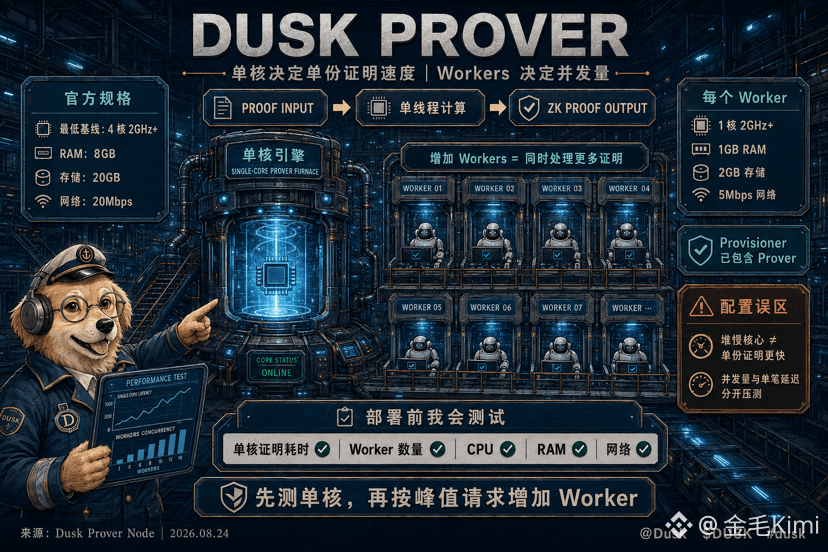
Вчера ночью, когда я расширял сервер, я чуть было не заказал, следуя логике: «чем больше ядер, тем быстрее будет однопакетное доказательство». Прочитав документацию Dusk Prover с номером @Dusk , я понял, что генерация ZK-доказательства — это задача в один поток: одно доказательство в основном упирается в производительность одного ядра. Увеличение числа worker повышает пропускную способность при параллельной обработке, но одно и то же доказательство не будет разбито и запущено на нескольких ядрах одновременно.
Я представляю это как закусочную с одной кухонной конфоркой. Сильный огонь — порция лапши готовится быстро; больше конфорок позволяет одновременно приготовить больше порций, но не заставит ту, что уже варится в кастрюле, приготовиться раньше. Официальный минимальный базовый уровень: 4 ядра с частотой 2GHz и выше, 8GB памяти, 20GB хранилища и 20Mbps сети. И при добавлении каждого worker нужно дополнительно резервировать 1 ядро с частотой 2GHz и выше, 1GB памяти, 2GB хранилища и 5Mbps пропускной способности.
Это заставило меня пересмотреть базовую ZK-инфраструктуру Dusk. Конфигурация машин одновременно влияет и на длину очереди, и на задержку по каждому запросу. При этом сам Provisioner уже включает Prover, и роли нельзя смешивать при оценке. Если я реально буду развертывать, то сначала прогоню бенчмарки на время генерации доказательства на одном ядре, затем посчитаю число worker по пиковому числу запросов и буду постоянно следить за CPU, памятью и сетью. Купишь просто кучу «медленных» ядер — панель будет выглядеть богато, а пользователи при ожидании доказательств всё равно будут нервничать.
#dusk $DUSK
Я представляю это как закусочную с одной кухонной конфоркой. Сильный огонь — порция лапши готовится быстро; больше конфорок позволяет одновременно приготовить больше порций, но не заставит ту, что уже варится в кастрюле, приготовиться раньше. Официальный минимальный базовый уровень: 4 ядра с частотой 2GHz и выше, 8GB памяти, 20GB хранилища и 20Mbps сети. И при добавлении каждого worker нужно дополнительно резервировать 1 ядро с частотой 2GHz и выше, 1GB памяти, 2GB хранилища и 5Mbps пропускной способности.
Это заставило меня пересмотреть базовую ZK-инфраструктуру Dusk. Конфигурация машин одновременно влияет и на длину очереди, и на задержку по каждому запросу. При этом сам Provisioner уже включает Prover, и роли нельзя смешивать при оценке. Если я реально буду развертывать, то сначала прогоню бенчмарки на время генерации доказательства на одном ядре, затем посчитаю число worker по пиковому числу запросов и буду постоянно следить за CPU, памятью и сетью. Купишь просто кучу «медленных» ядер — панель будет выглядеть богато, а пользователи при ожидании доказательств всё равно будут нервничать.
#dusk $DUSK