#dusk $DUSK @Dusk
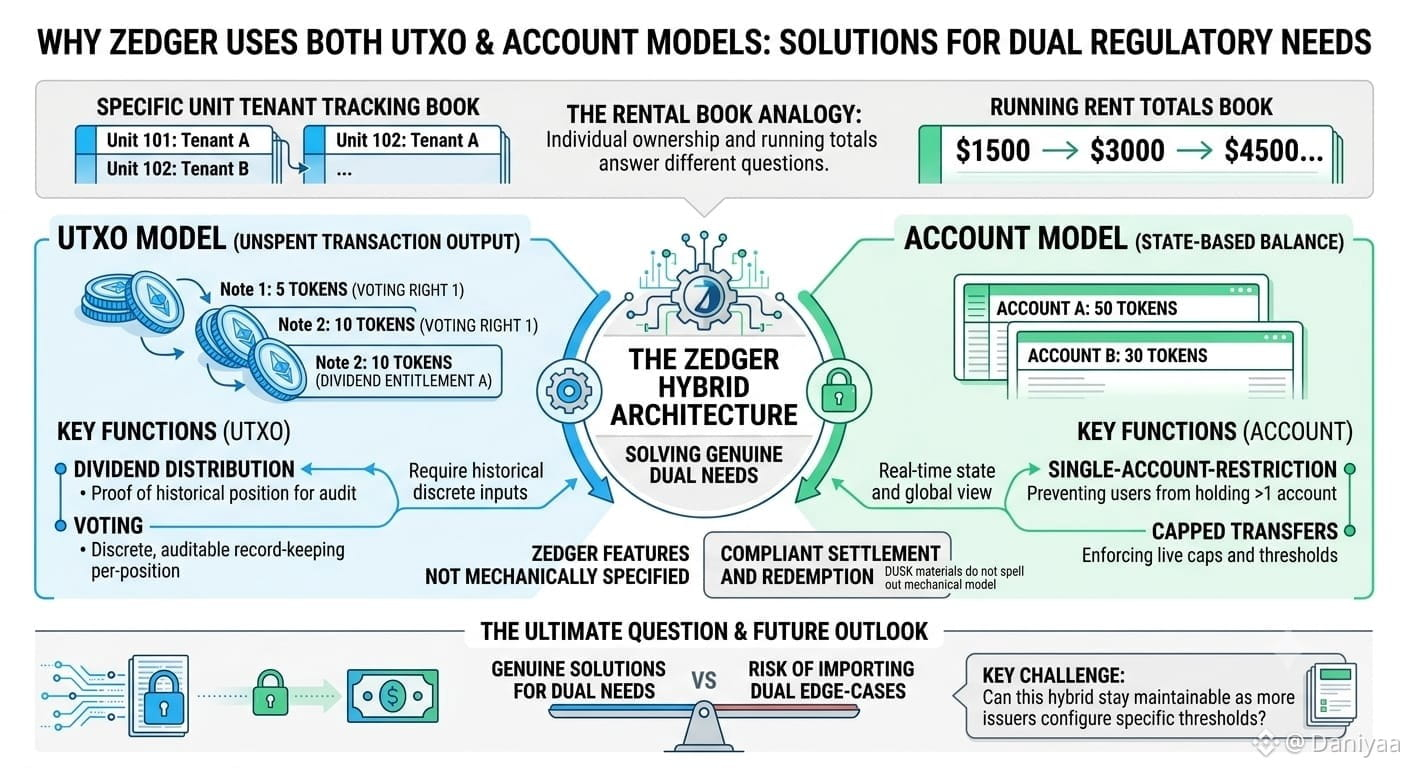
Моя тётя ведёт два отдельных реестра для бизнеса по сдаче недвижимости в аренду — один фиксирует, какой конкретный юнит принадлежит какому арендатору, а второй отслеживает общую сумму арендной платы, собранную в этом месяце. Я спросил, почему нельзя вести одну книгу. Она сказала, что индивидуальное владение и текущие итоговые суммы отвечают на принципиально разные вопросы, и попытка заставить одну книгу делать и то и другое приводит к тому, что оба ответа становятся ненадёжными.
Я предположил, что Zedger выберет одну модель. Это предположение рухнуло, когда я проследил, почему он объединяет оба подхода — функция за функцией.
Материалы Dusk перечисляют пять вещей, которые Zedger конкретно поддерживает: соответствующее расчётное закрытие и выкуп, недопущение предварительно одобренных пользователей к превышению более одного аккаунта, распределение дивидендов, голосование и ограниченные переводы. Я разложил по категориям, куда именно каждое требование попадает, и отметил, откуда это достаточно ясно следует. Ограничение на один аккаунт и ограниченные переводы явно требуют аккаунт-стиля проверки живой позиции — этот конкретный владелец уже выше порога прямо сейчас. Распределение дивидендов и голосование требуют дискретного, проверяемого ведения записей по каждой позиции — ближе к UTXO-подобному индивидуальному учёту записок.
Стоит сказать честно: материалы Dusk не расписывают, какая именно модель механически обрабатывает расчёт и выкуп. Я не буду гадать о том механизме только ради того, чтобы список выглядел более «полным».
Ни одна из моделей по отдельности не закрывает те функции, которые я смог подтвердить. Система только с аккаунтами с трудом доказывает конкретную прошлую позицию для дивидендного аудита. Система только с UTXO с трудом обеспечивает живое ограничение без одновременной проверки всех записок.
Настоящая проверка для DUSK — сохранится ли эта гибридная схема поддерживаемой по мере того, как больше эмитентов будут настраивать свои собственные пороги поверх неё.
Сочетание двух учётных моделей решает реальные задачи с двойными потребностями или просто переносит два набора пограничных кейсов вместо одного?