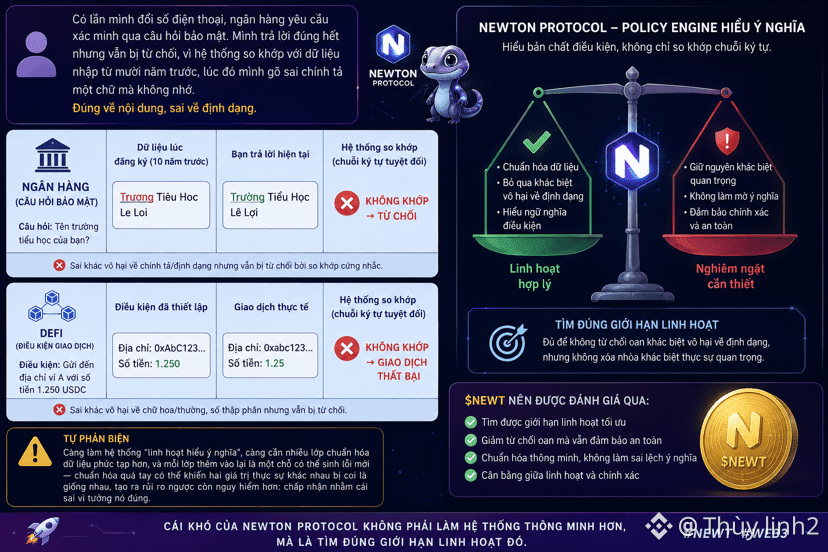
Однажды я менял номер телефона, и банк запросил подтверждение через контрольные вопросы. Я ответил на всё правильно, но всё равно получил отказ, потому что система сверяла данные с введёнными десять лет назад, а тогда я сделал опечатку в одном слове и уже не помнил об этом. По сути верно, по формату — нет, и система не умеет различать эти два вида ошибки.
В DeFi бывает точно такая же путаница — адрес кошелька, записанный в верхнем или нижнем регистре, может различаться, округлённое число — от десятичной дроби, и всё это может привести к тому, что условие, верное по сути, будет считаться несоответствующим, просто потому что происходит абсолютное сопоставление строк, а не понимание смысла.
@NewtonProtocol если строить policy engine, который понимает смысл условий, а не только жёстко сопоставляет строки, можно снизить число таких несправедливых отказов.
Самокритика: но чем больше система становится «гибкой и понимающей смысл», тем больше ей нужно сложных слоёв нормализации данных, а каждый добавленный слой — это ещё одно место, где может возникнуть новая ошибка. Чрезмерная нормализация может привести к тому, что два действительно разных значения будут считаться одинаковыми, создавая обратный риск, ещё более опасный: случайно принять неверное за правильное.
Сложность @NewtonProtocol не в том, чтобы сделать систему умнее, а в том, чтобы найти правильную границу этой гибкости — достаточную, чтобы не отказывать без причины из-за безвредных различий в формате, но не стирать при этом и действительно важные различия.
$NEWT следует оценивать по тому, удалось ли найти эту границу, а не только по тому, применяется ли семантическое понимание.
#newt $LAB $SAROS