Как должен масштабироваться децентрализованный ИИ? @OpenGradient
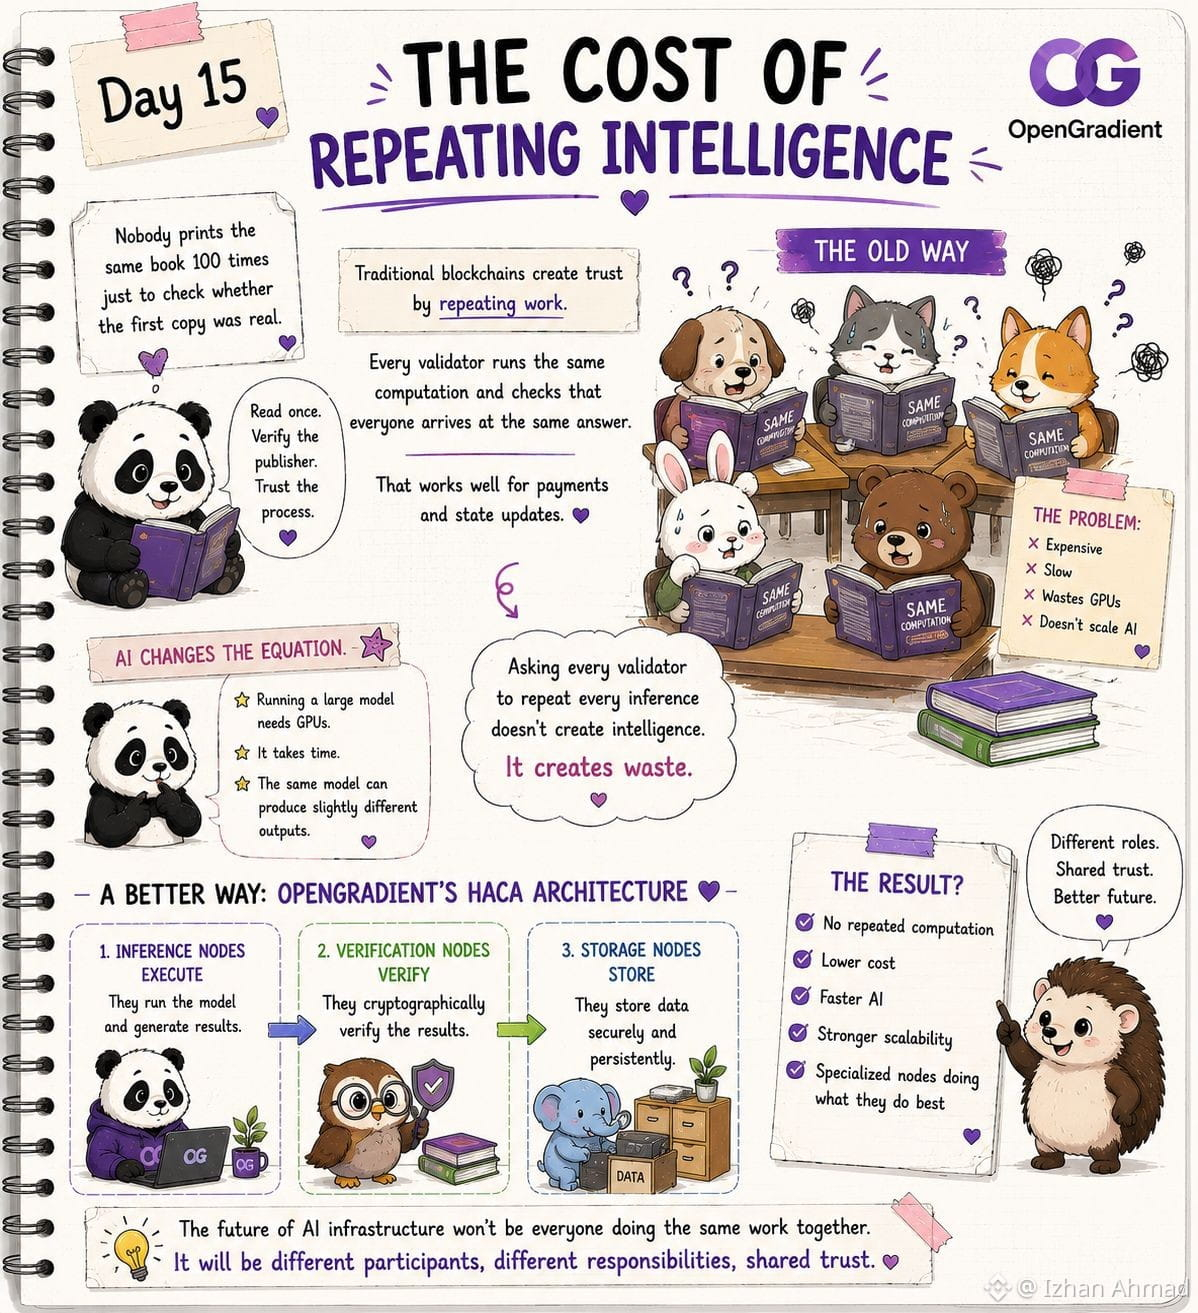
Никто не печатает одну и ту же книгу 100 раз только чтобы проверить, была ли первая копия настоящей.
Это было бы абсурдно.
Вы читаете книгу один раз, проверяете издателя и доверяете процессу, который ее создал. Эта мысль осталась со мной, когда я читал о том, как блокчейны и ИИ взаимодействуют. Традиционные блокчейны создают доверие, повторяя работу. Каждый валидатор выполняет одно и то же вычисление и проверяет, что все приходят к одному и тому же ответу. Для платежей и простых транзакций такой подход работает удивительно хорошо.
ИИ меняет уравнение. Запуск большой модели — это не то же самое, что проверка передачи токена. Для этого нужны GPU, время и значительные ресурсы. Иногда даже одна и та же модель может выдавать чуть разные результаты в зависимости от того, как она запущена. Просить каждого валидатора повторять каждый вывод (inference) — это не делает систему умнее.
Это создает больше отходов.
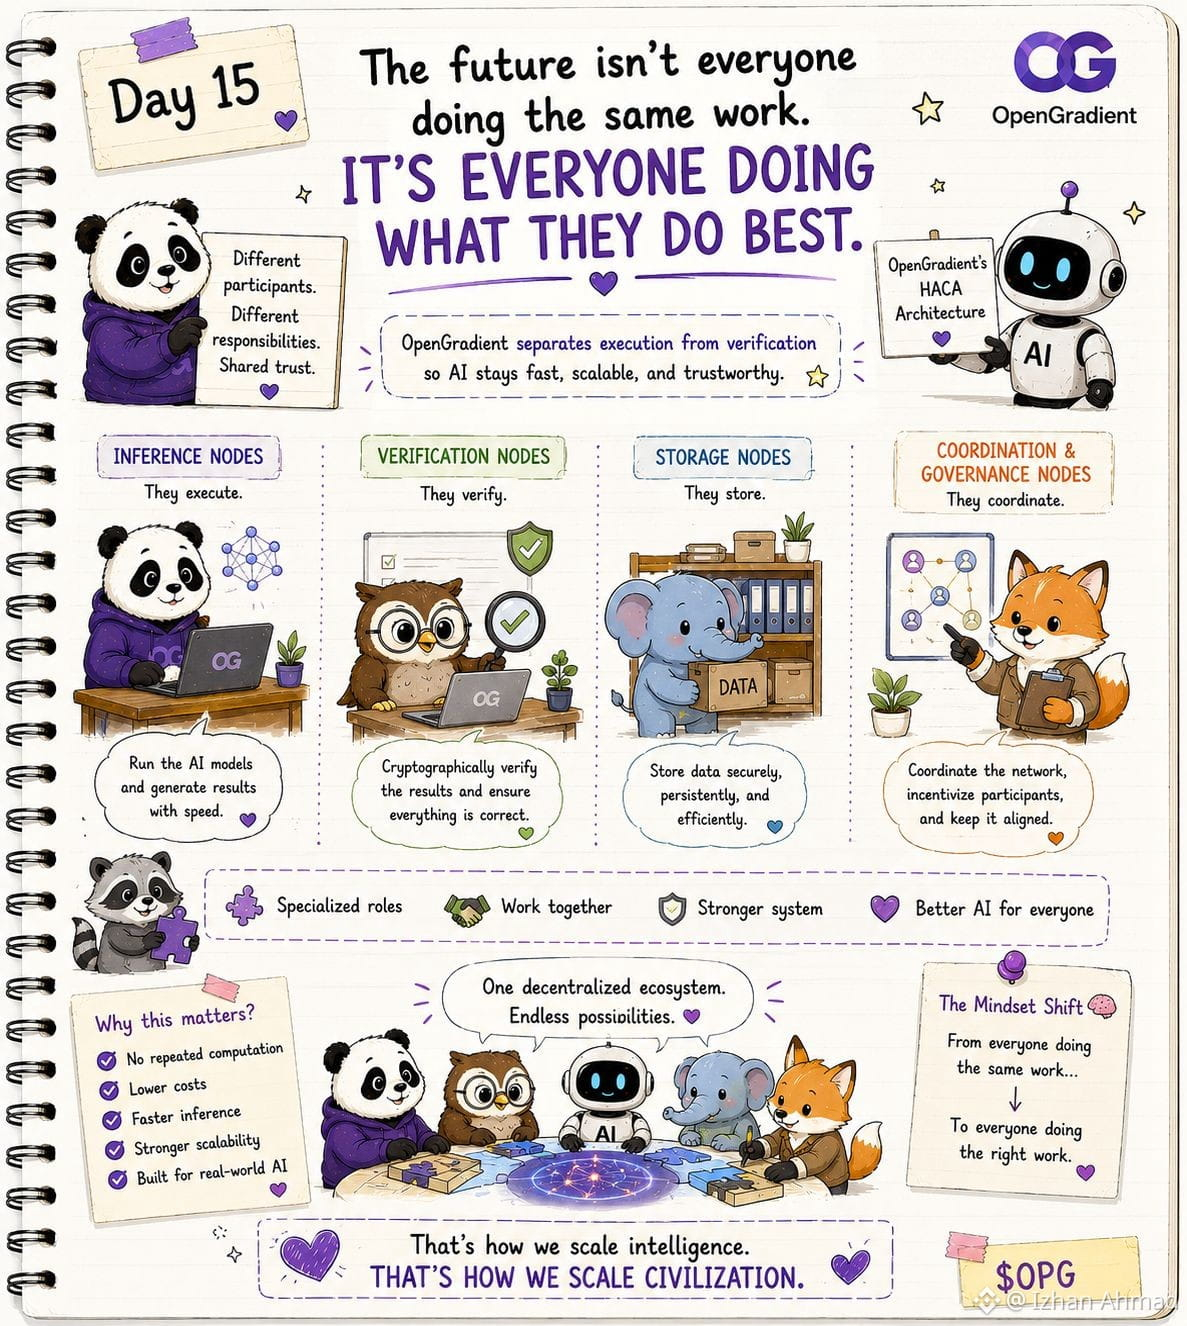
Один из элементов @OpenGradient архитектуры, который показался мне особенно интересным, — решение разделить выполнение и верификацию, вместо того чтобы заставлять каждый узел делать все. Узлы вывода выполняют. Узлы верификации проверяют. Узлы хранения хранят. Каждый участник фокусируется на том, что у него получается лучше всего, а сеть поддерживает общее доверие.
Чем больше я об этом думаю, тем сильнее мне кажется, что будущее инфраструктуры ИИ может не выглядеть так, будто все делают одну и ту же работу вместе. Возможно, это будет больше похоже на то, как устроены общества: разные участники, разные обязанности, общее доверие. Это ощущается не столько как масштабирование вычислений, сколько как масштабирование цивилизации.
#OPG #AIInfrastructure #verifiableAI #HACA #DecentralizedAI $OPG $TAC $UB
Everyone verifies everything
50%
Specialized nodes with trust
0%
Centralized AI providers
50%
Not sure yet
0%
4 проголосовали • Голосование закрыто