#opg $OPG Когда я впервые столкнулся с OpenGradient, моя реакция была довольно плоской. Это звучало как одна из тех знакомых попыток объединить ИИ и блокчейн в одну историю, и чаще всего такие истории кажутся более нагруженными языком, чем реальным содержанием. Поэтому я не ожидал потратить много времени на размышления об этом.
Но что-то об этом оставалось в заднем плане моего разума. Не потому что это казалось очевидно правильным, а потому что это указывало на дискомфорт, который уже существует в том, как ИИ работает сегодня.
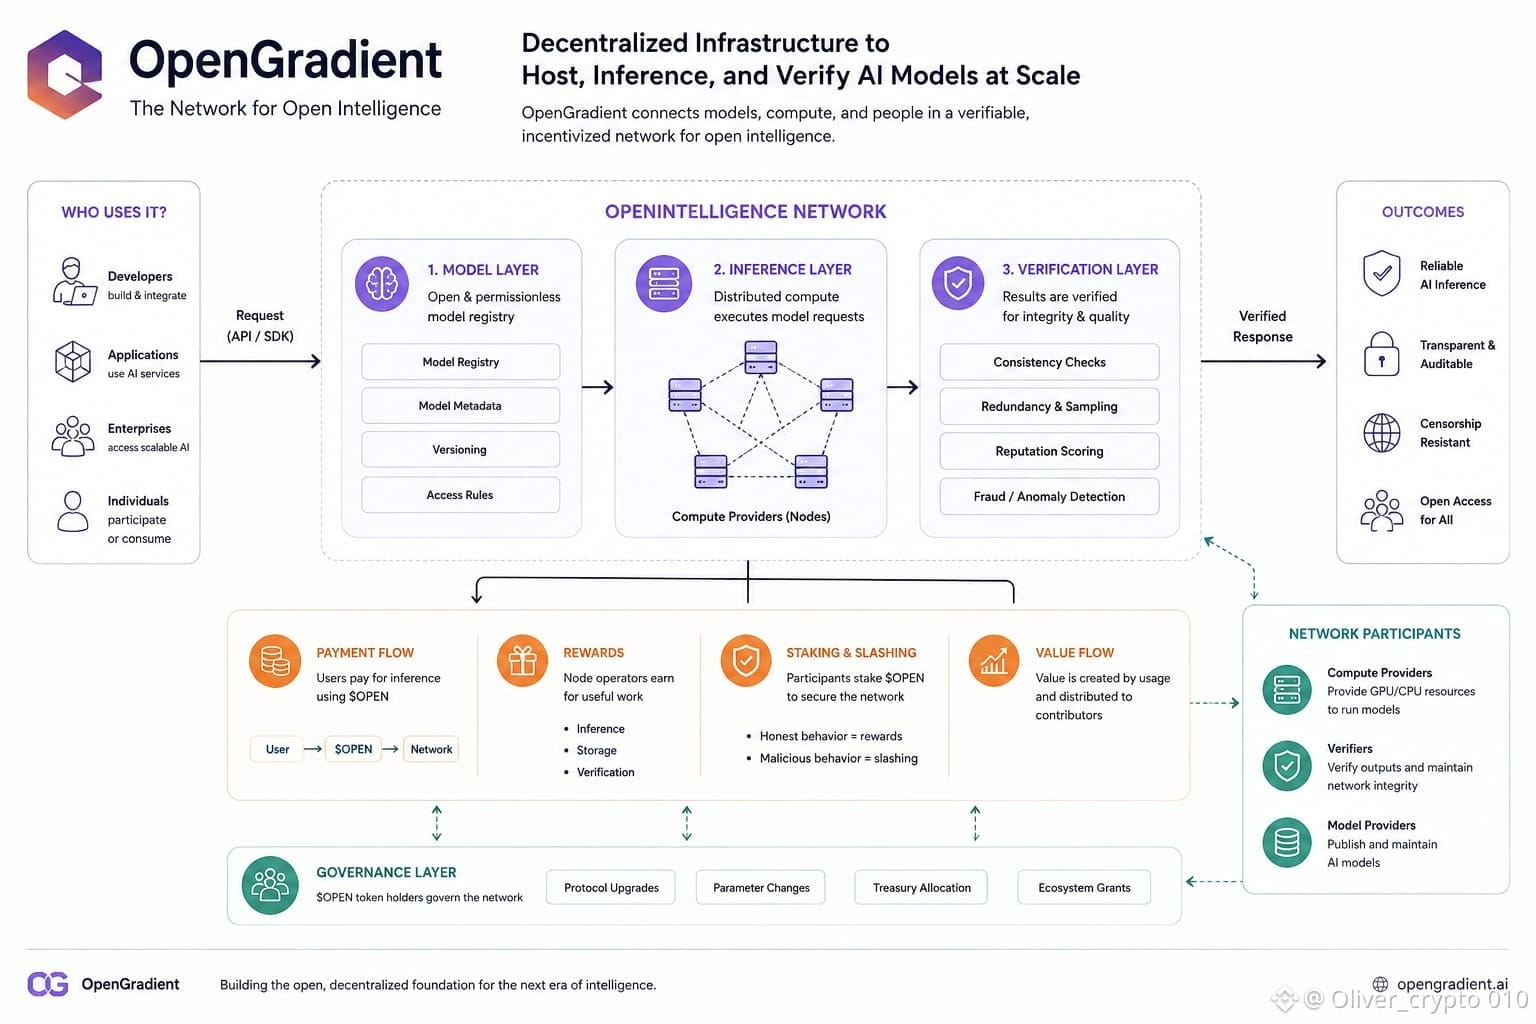
Большинство людей воспринимает ИИ как что-то "отдаленное" в облаке, но это немного вводит в заблуждение. На практике небольшое количество систем тихо контролируют, где находятся модели, как они работают и кто получает к ним доступ. Это эффективно, да, но это также означает, что много невидимых решений уже принято до того, как пользователь когда-либо введет запрос. OpenGradient пытается сместить этот центр тяжести или, по крайней мере, распределить его, чтобы ИИ не был заблокирован в одном наборе серверов или воротах.
Что делает это интересным, так это не идея децентрализации сама по себе, а то, что происходит, когда вы действительно пытаетесь применить ее к чему-то столь непредсказуемому, как вывод ИИ. В отличие от простой вычислительной задачи, здесь нет четкого "правильного или неправильного" ответа. Это означает, что доверие становится чем-то, что необходимо закладывать в систему, а не предполагать на краях.
И вот здесь все становится запутанным в очень человеческом смысле. Стимулы начинают тянуть в разные стороны. Некоторые участники заботятся о скорости, другие — о точности, третьи — просто о вознаграждениях. В итоге вы получаете систему, которая уже не просто техническая — она поведенческая.
Я не совсем уверен, что эти системы когда-либо вырвутся из-под влияния централизации. Но я также не думаю, что это единственное, на что стоит обратить внимание. Даже несовершенные попытки, такие как эта, сдвигают разговор о том, кто имеет право хостить интеллект, и этот вопрос, похоже, будет иметь все большее значение в будущем.
@OpenGradient