
Июнь на северо-востоке — это сезон дождей, влажный и липкий воздух и непрекращающийся дождь снаружи вызывают безосновательную тревогу. Как раз сегодня завершается задача $OPEN #CreatorPad , и вокруг витает атмосфера, полная призывов к действию и громких лозунгов «Данные для всех в эпоху ИИ». Я заварила чашку крепкого, горького кофе и уставилась на экран компьютера, где мелькала старая новость о совместном запуске OpenLedger и Story Protocol «AI Автоматическое удостоверение авторских прав», погружаясь в долгий и мучительный эмоциональный аттракцион.
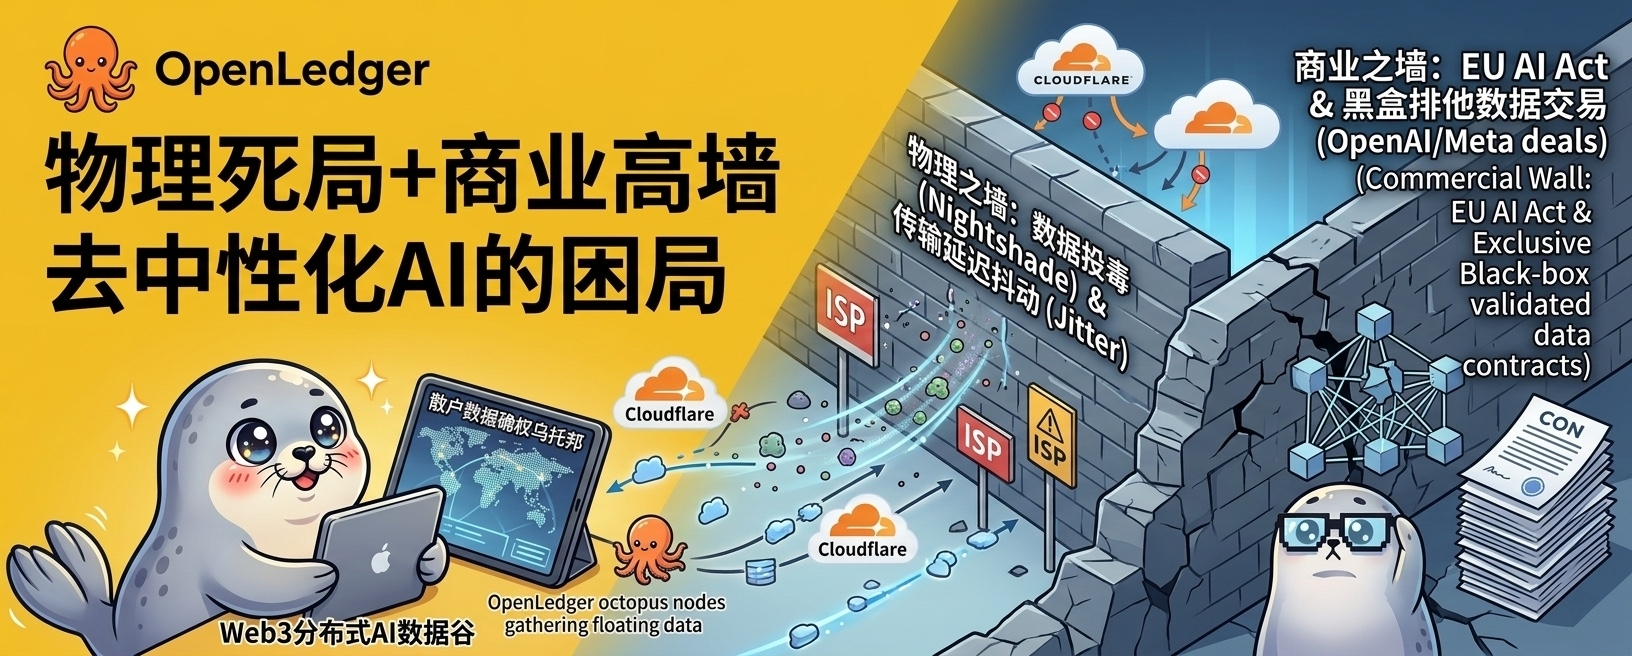
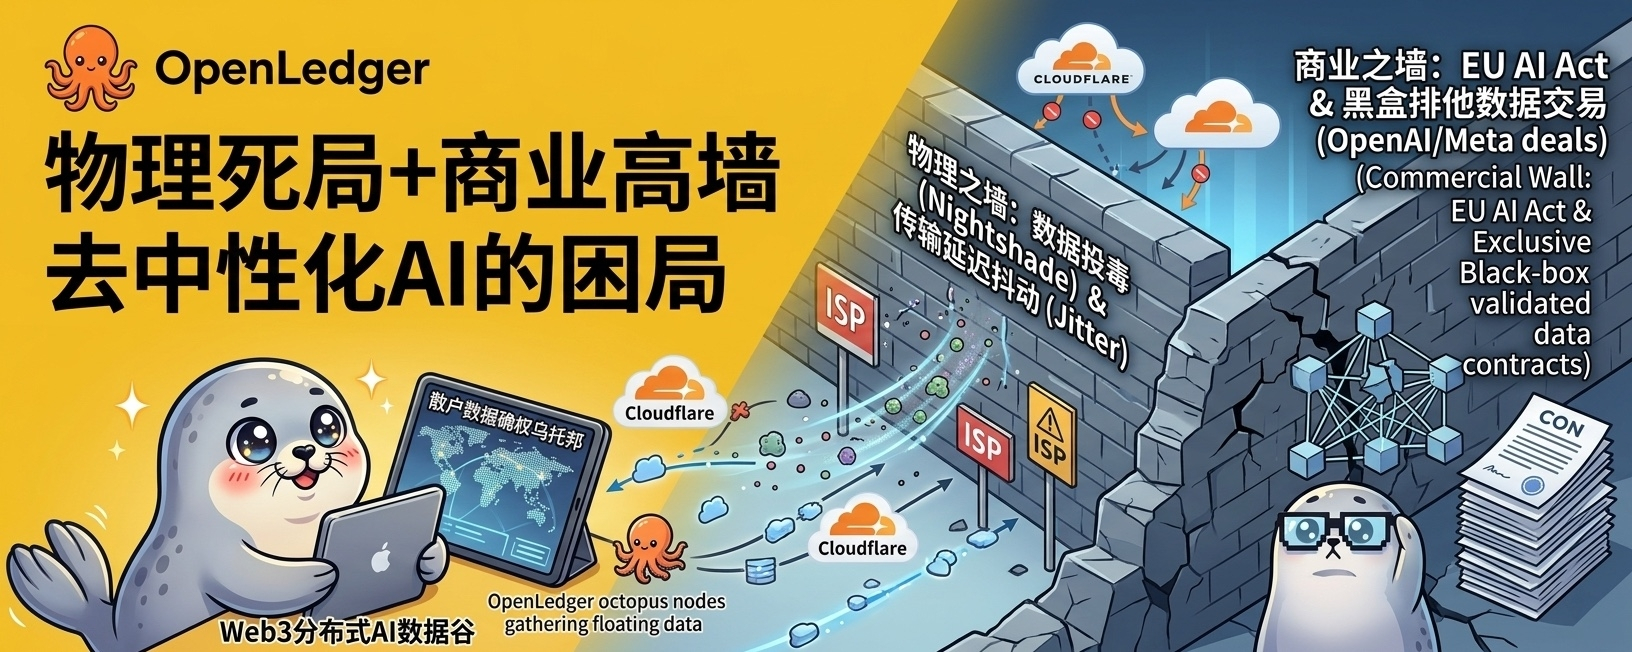
Сегодня, когда я заставила себя выйти за пределы узкого юридического взгляда и взглянуть на всю эту технологическую карту и бизнес-замкнутый круг через призму сетевой инженерии и логики машинного обучения, тот первоначальный восторг словно лопнувший пузырь, оставил только холод в душе — я поняла, что эта грандиозная нарративная конструкция перед высокими стенами физических законов, безопасности данных и реального коммерческого права так же хрупка, как промокшая бумага.
Удивительное начало: когда-то я тоже встал и аплодировал.
Нужно признать, что @OpenLedger и Story Protocol совместно нарисовали крайне привлекательную картину на чисто логическом уровне. В традиционной цепочке AI индустрии создатели, очистители данных и крайние узлы всегда находятся на самом дне пищевой цепи. Такие гиганты, как OpenAI и Google, без зазрения совести используют свои огромные вычислительные мощности и юридические команды, чтобы безжалостно извлекать бесплатные данные со всего мира для обучения своих моделей. А #OpenLedger предложенные Datanets (данные с правом собственности на сообщество) и ModelFactory, как раз задевают эту боль. Их сочетание с Story Protocol создает почти идеальный замкнутый цикл: розничные инвесторы вносят данные через узлы, OpenLedger использует Proof of Attribution (доказательство вклада) для записи каждого вашего вклада в AI модель в блокчейне; как только эта модель генерирует вызов (Inference) в коммерческой реализации, базовый протокол Story Protocol автоматически активируется, чтобы выплачивать роялти в виде микротранзакций через токены OPEN реальным вкладчикам данных.
Разве это не идеальная справедливая дистрибутивная AI утопия? Если честно, когда я впервые увидел этот дизайн, я чуть не встал и не аплодировал. Но именно эта логическая самообоснованность заставила меня, в последующие дни, при каждом новом обнаружении скрытой угрозы испытывать всё большее разочарование.
Смертельная уязвимость под тенью «Nightshade»: децентрализованный консенсус не защищает от «отравления данных».
OpenLedger всё время подчеркивает, что его Datanets способны производить высококачественные обучающие материалы. Но здесь есть огромный, почти неразрешимый логический парадокс: механизм консенсуса в децентрализованной сети может лишь проверить, достигнуто ли «согласие» по данным, но не может проверить «абсолютную истинность» данных в физическом мире.
Еще в 2023 году команда Чикагского университета выпустила инструмент под названием Nightshade, который взорвал мир гиков. Смотрите на изображение ниже. Ужас этой штуки заключается в том, что она может вносить изменения в изображение или текст на уровне пикселей, которые невозможно заметить невооруженным глазом. Вы смотрите на кота, а AI модель распознает его как собаку.
Теперь, если этот ужасный инструмент внедрить в дистрибутивную сеть OpenLedger, что произойдет?
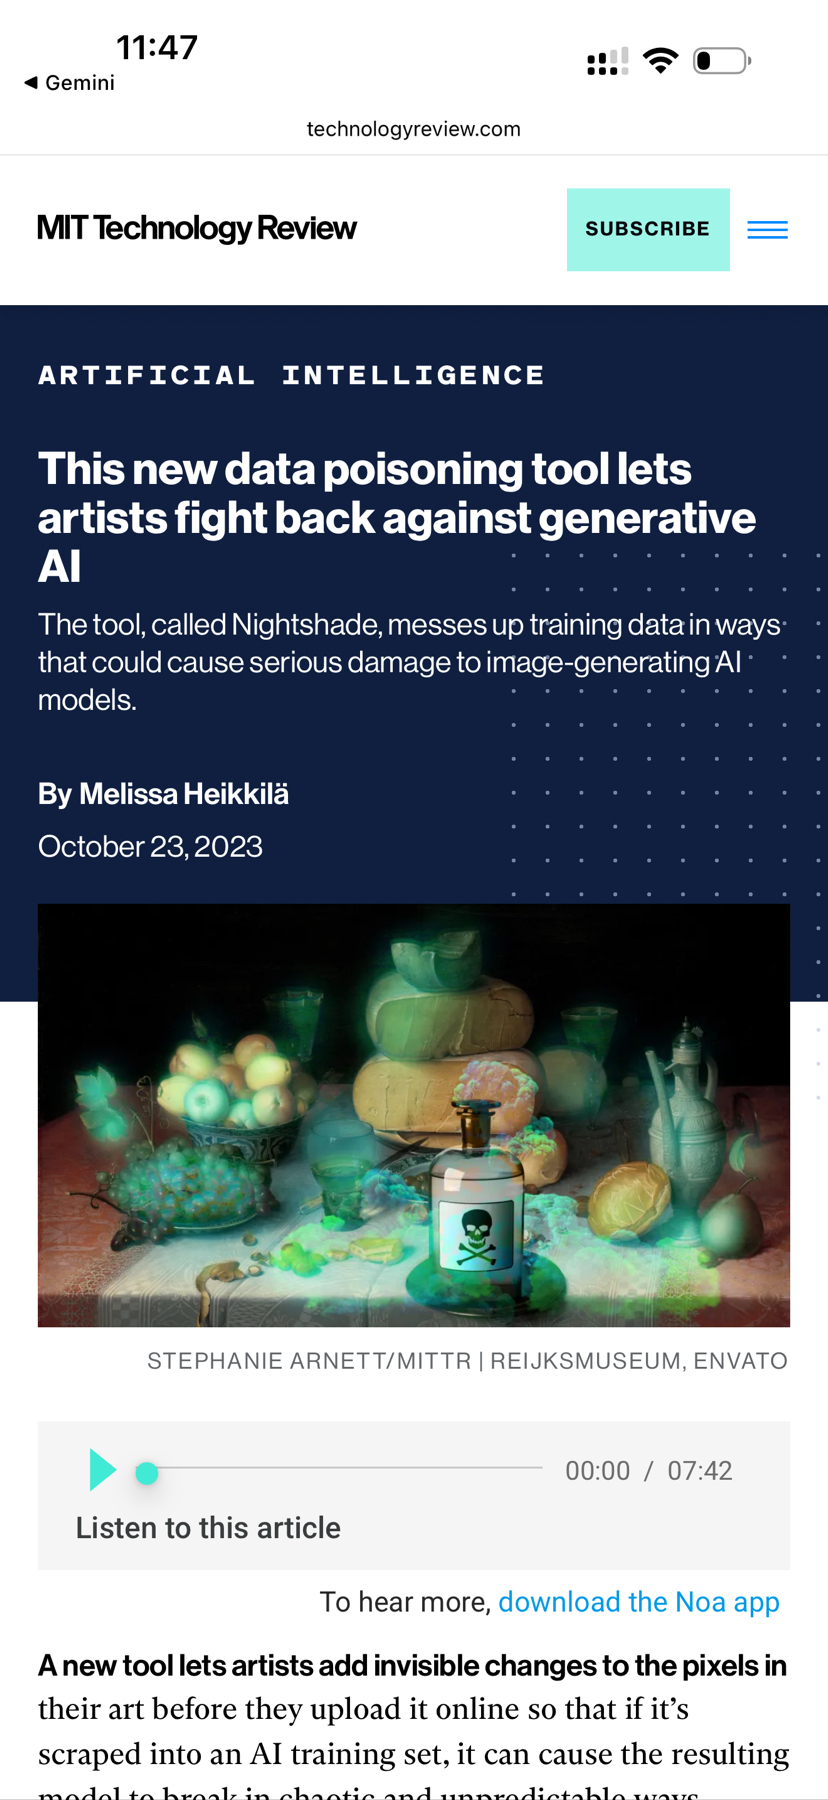
В децентрализованной сети без разрешений любой узел может отправлять данные. Если злонамеренная хакерская организация или конкурент использует инструмент, подобный Nightshade, чтобы провести «невидимое отравление» огромного объема данных, а затем распределяет их через десятки тысяч анонимных узлов в сеть OpenLedger, алгоритм консенсуса сети просто будет проверять, соответствуют ли эти данные хешам или формату. Узлы даже могут голосовать за эти «отравленные данные» из-за общего интереса. Каков же результат? Как только B2B AI модель приобретает этот загрязненный децентрализованный набор данных, вес нейронной сети всей модели может быть разрушен, что в машинном обучении называется «коллапсом модели».
В традиционных централизованных компаниях очистка данных имеет строгую внутреннюю изоляцию и механизмы ответственности; а в такой полностью децентрализованной сети, кто будет отвечать за «отравление» данных? Если даже «чистота» данных не может быть гарантирована на 100% в инженерном плане, какая оценка в миллиарды долларов AI единорога рискнет доверить свою жизненно важную модель анонимной сети, которая может быть подвержена злонамеренному отравлению? Эта мысль заставляет меня вздрагивать. Так называемое «право на данные» предполагает, что данные должны быть «хорошими». Если нельзя защититься от атак на данные, то всё, что производит эта сеть, — это куча дорогого цифрового мусора.
Физическое проклятие задержки (Jitter): кошмар для корпоративных AI потоков.
Вторым пунктом, который сломал мою психологическую защиту, стала крайне реальная физическая преграда. Если вы недавно следили за событиями в Силиконовой долине, то знаете, что такие компании, как Groq, которые специально разрабатывают LPU (устройства обработки языка) для AI, или последняя архитектура Blackwell от NVIDIA, все они безумно борются за один показатель: супернизкую задержку и высокую согласованность пропускной способности данных. Современные потоки данных коммерческого AI (Pipeline) требуют, чтобы задержка передачи данных между векторной базой данных и вычислительными единицами достигала уровня микросекунд (Microsecond). А что пытается построить OpenLedger? Она хочет полагаться на дистрибуцию данных через терминалы, находящиеся по всему миру, с абсолютно разными сетевыми условиями для очистки и векторизации данных.
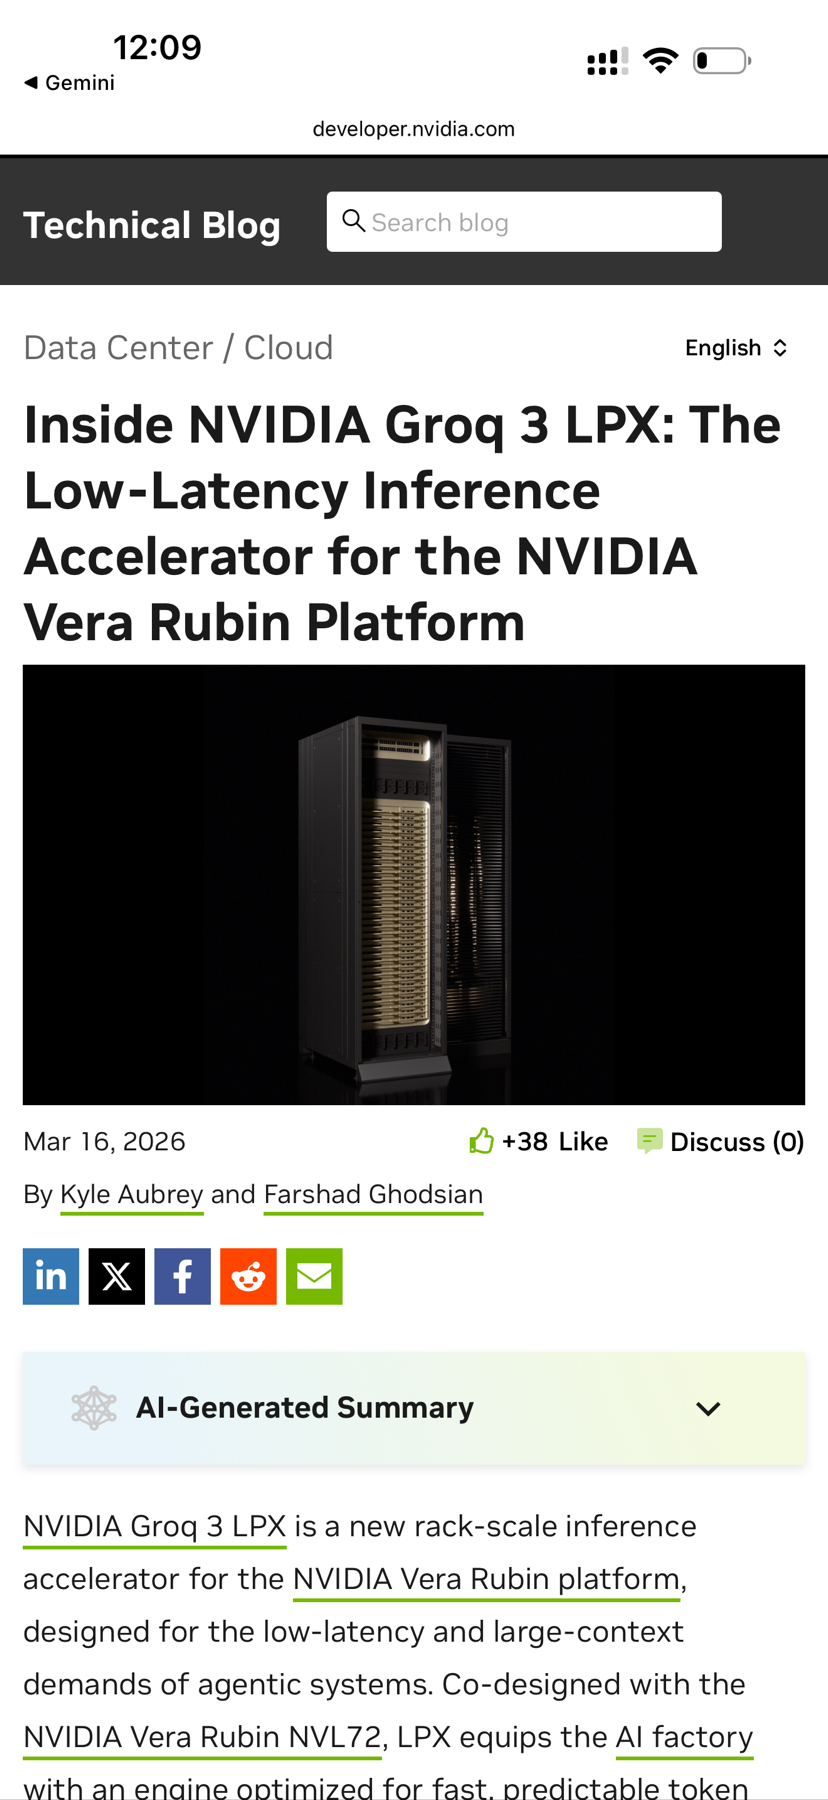
Я глубоко обсуждал эту область с коллегой, у которого есть опыт облачного развертывания. Смотрю на эту архитектуру и просто не могу поверить, как это абсурдно. Если узел в Японии сталкивается с перегрузкой сети, или узел на Ближнем Востоке сегодня испытывает замедление скорости, задержка в обработке данных может резко возрасти до нескольких сотен миллисекунд, а то и секунд. Для B2B корпоративных AI приложений, требующих абсолютной стабильности и мгновенной обратной связи, такие задержки и уровень потерь пакетов абсолютно неприемлемы. Они пытаются бросить вызов законам физики, используя «децентрализованное» политически правильное решение, чтобы обойти световую скорость передачи и топологию сети. Это всё равно что пытаться тянуть Boeing 747 с помощью десяти тысяч собранных тракторов. Концепция выглядит привлекательно, но реальность неумолима.
Когда я накладываю эти два физических парадокса друг на друга, первоначальное чувство удивления полностью заменяется почти холодным разумом.
Невидимая цена для IP розничных инвесторов.
В процессе постепенного охлаждения эмоций есть еще одно измерение, которое меня пугает: это физическое давление на децентрализованный сбор данных в реальном мире.
Короче говоря, когда домашний узел с широкополосным интернетом неосознанно касается брандмауэра целевого сайта, его IP моментально маркируется международным CDN как «источник злонамеренной атаки». Этот удар наносит прямой удар по капиллярам, на которых существует сеть OpenLedger, и накладывает на нарратив «каждый вносит вклад, каждый получает выгоду» тяжелую тень.
Отсутствие коммерческого замыкания: кто заплатит за «самоуправляемую» цепочку в свете законопроекта о AI в ЕС?
Ещё более безнадежно то, что эта система автоматических роялти совершенно разорвана от реальной юридической и коммерческой логики закупок. Мы должны признать крайне жестокую реальность: «авторские права» и «ройалти», определяемые децентрализованной сетью, вовсе не имеют никакой силы для принудительного возврата налогов и соблюдения в юридической области традиционных гигантов AI Web2. В 2026 году компании, такие как OpenAI и Meta, уже выработали свои основные юридические стратегии, подняв флаг «добросовестного использования» или подписав эксклюзивные черные ящики соглашений по лицензированию данных с крупными медиа-группами. Эти гиганты, обладающие абсолютной властью в отрасли, не имеют никаких коммерческих стимулов для взаимодействия с децентрализованной системой расчетов роялти, состоящей из анонимных розничных инвесторов, находящейся в серой зоне закона. Без доступа к этим крупнейшим покупателям автоматическая система роялти OpenLedger в конечном итоге окажется лишь игрой в «саморазвлечение» для разработчиков внутри экосистемы.
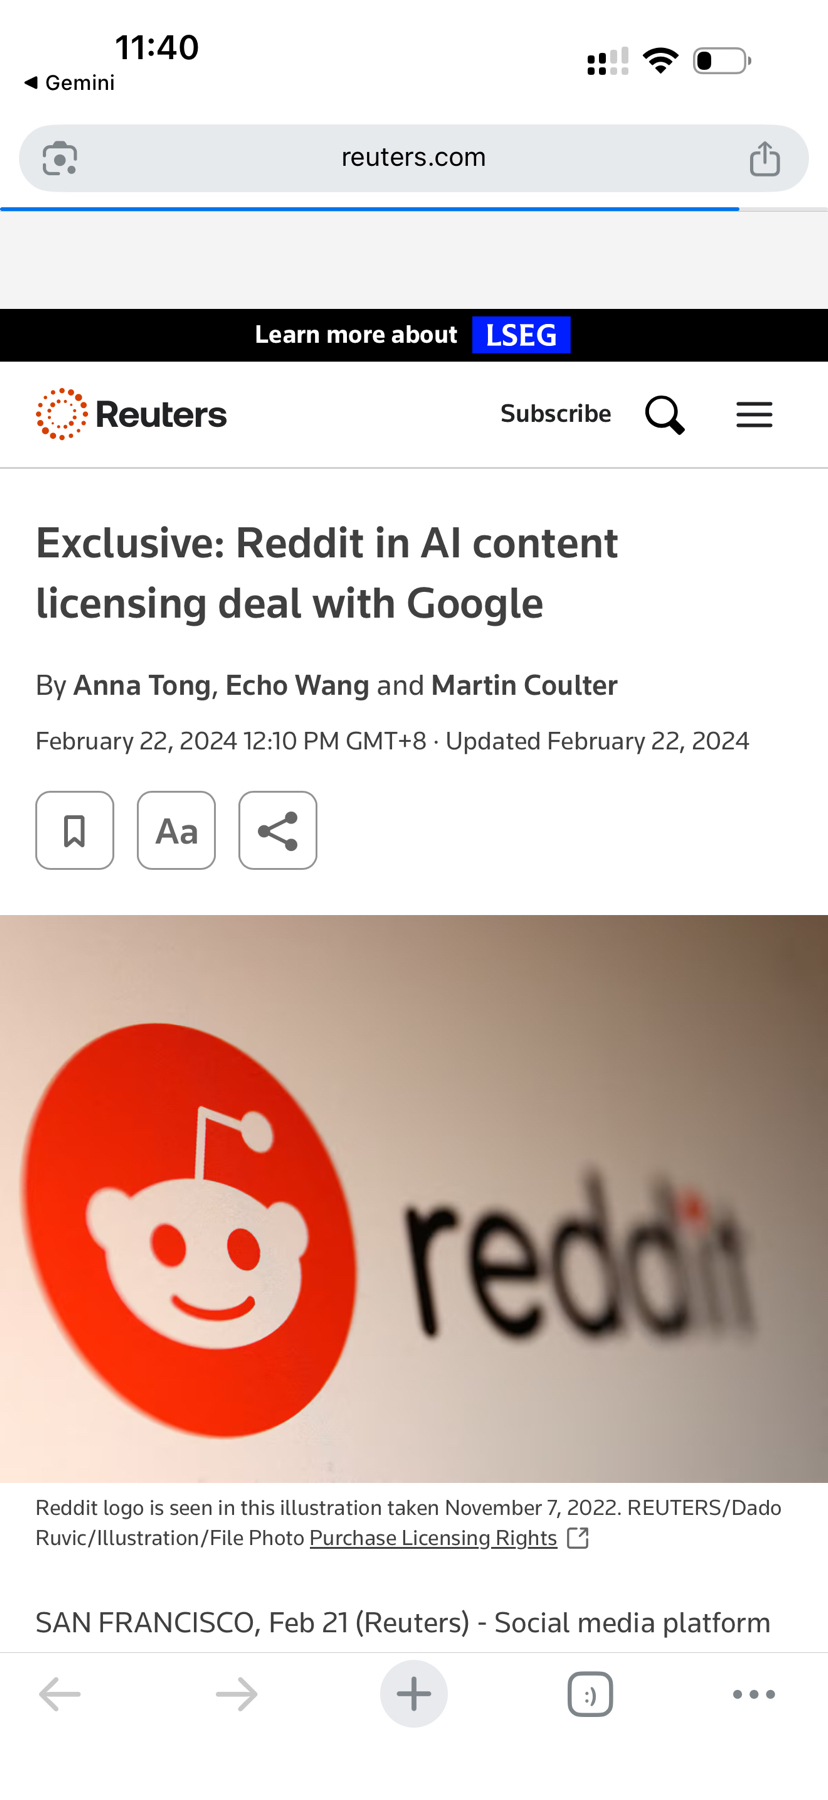
Например, согласно достоверному отчету Reuters, еще в 2024 году Google и Reddit достигли соглашения о ежегодных 60 миллионах долларов на данные для AI.
А железный занавес регуляции ЕС практически полностью закрыл этот узкий путь. С постепенным введением в действие AI-акта ЕС, «чистота» данных для обучения больших моделей поднята на беспрецедентный политический и юридический уровень. Согласно этапам реализации закона, начиная с августа 2025 года, поставщики общих AI-моделей должны открыто публиковать «достаточно детализированные» резюме содержимого обучающих данных и строго соблюдать стратегии управления данными и соблюдения авторских прав; для высокорисковых AI-систем данные должны быть трассируемыми, без смещения и без нарушения авторских прав. Совсем недавно, Европейская комиссия четко потребовала от всех производителей базовых моделей, действующих на территории, предоставить аудиторские отчеты о источниках сбора данных и процессах очистки; любые данные с неясным происхождением или потенциальным риском нарушения авторских прав могут привести к тому, что вся модель будет вынуждена быть снята с рынка.
При таких почти строгих требованиях к наследию данных (Data Lineage) Datanets от OpenLedger почти踩到了 каждую мину. Его распределённый поток зависит от тысяч неподтвержденных узлов по всему миру для загрузки и первичной очистки; даже если только один из этих узлов злонамеренно вносит небольшое количество защищённых «отравленных данных», соответствие всего набора данных на цепи мгновенно рухнет. Ни одна коммерческая AI компания не рискнёт доверить свою огромную модель, в которую вложены миллионы, а также содержащую её основную бизнес-логистику, анонимной сети с низкой чистотой данных. Как бы высоки ни были идеалы децентрализации, перед холодным лицом аудиторских отчетов о соответствии любая «согласованность сообщества» не может заменить юридическую силу сертификатов белого списка.
Заключение | Сохраняйте искру, но не платите за физические тупики и коммерческие иллюзии.
За окном продолжает идти дождь, а кофе в чашке уже давно остыло. Я не ненавижу команду OpenLedger, наоборот, я ярый сторонник DeAI. Я признаю, что архитектура OpenLoRA добилась прорыва в эффективности развертывания на одном GPU, и основатель Pryce Adade-Yebesi действительно имеет дальновидное видение. Но когда я снимаю всю эту роскошную оболочку, я вижу хрупкий консенсус, который не может противостоять атакам на данные; это основа, которая не выдерживает требований к низкой задержке для корпоративного AI; это бизнес-модель, которая не может найти опору в реальных законах о авторских правах и стратегии закупок гигантов. Это не из-за того, что я отчаялся в отношении DeAI+DePIN, наоборот, я очень хочу, чтобы эта ниша выжила, и я не могу больше терпеть, что какой-либо проект, не имея коммерческих покупателей, юридических льгот и реальной защиты IP, ставит домашние узлы и активы IP на передний план, чтобы противостоять гневу гигантов.
Прежде чем официальные лица смогут представить действительно независимый отчет о «тестировании на устойчивость к отравлению данных», проведенный третьей стороной, подтверждающий, что их задержка сети соответствует требованиям для индустриального векторного поиска, и представить подлинный финансовый отчет о соблюдении порядка закупок с мировыми AI гигантами, я собираюсь снизить свои ожидания до нуля. Любые планы по «триллиону автоматических роялти» в моих глазах должны учитывать риски. Сохраняйте минимальное участие, сохраняйте искру, но никогда не позволяйте риску активов выйти за рамки разумного — в этом июне, полном нарративных ловушек, сохранять долю критического мышления и рациональности, возможно, единственное, что мы можем оставить себе.
Я выключил экран, и холод всё ещё не уходит.