То, что меня беспокоило на середине задачи OpenLedger $OPEN #OpenLedger @OpenLedger , так это слово "коллаборативный." Оно повсюду в контексте — коллаборативные наборы данных, коллаборативное обучение моделей, интеллект, принадлежащий сообществу. И когда смотришь на то, что на самом деле строится сейчас, это абсолютно другая форма.
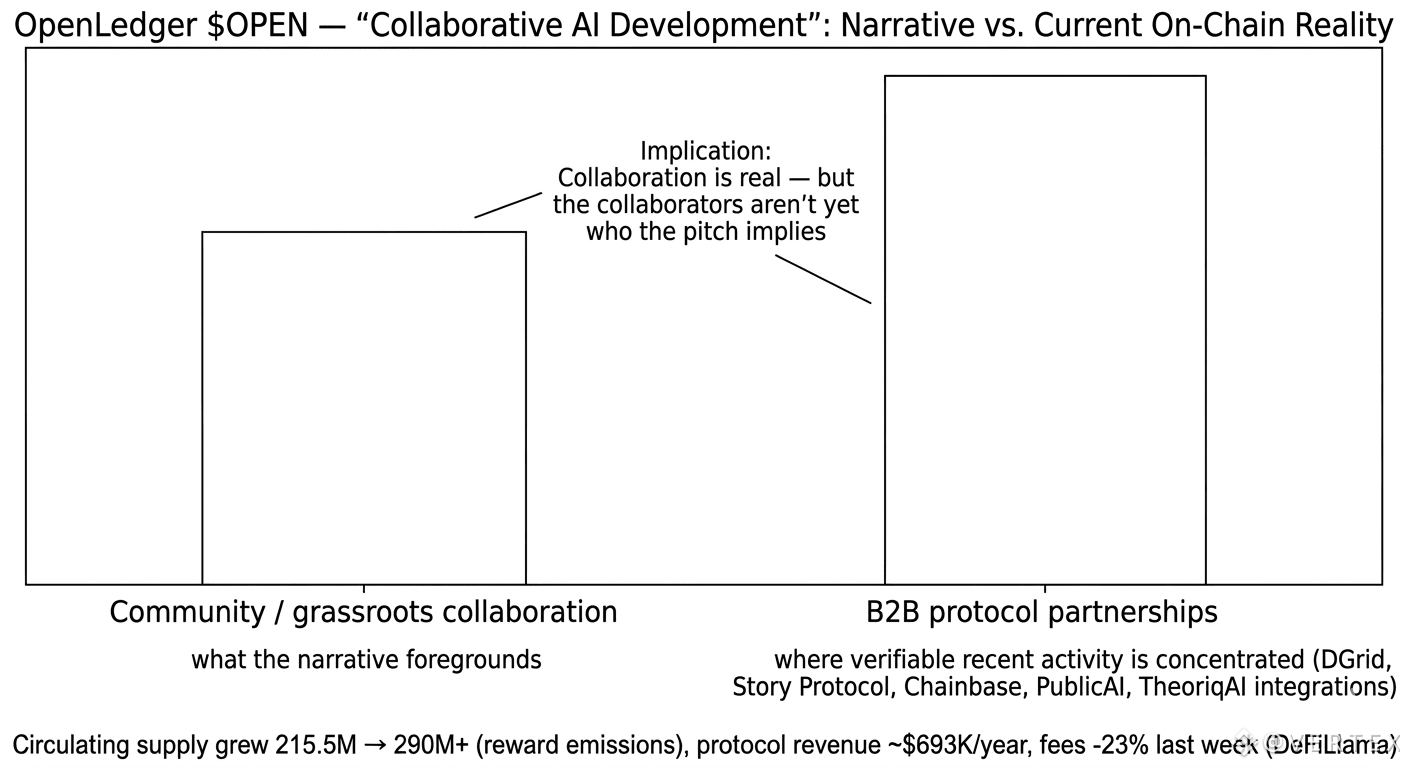
Недавняя активность почти полностью состоит из двусторонних протокольных партнерств: DGrid для вычислений, Story Protocol для лицензирования прав, Chainbase для данных Web3, PublicAI для аннотации, TheoriqAI для агентов. Каждое из них — это рукопожатие между двумя командами, а не открытая деятельность участников. Тем временем CoinMarketCap показывает, что обращающаяся эмиссия выросла с 215,5M до более чем 290M OPEN, в основном благодаря эмиссиям вознаграждений сообщества — при этом годовая выручка протокола составляет около $693K, а сборы упали на 23% на прошлой неделе по данным DeFiLlama. Токены вышли, а использование еще не последовало.
Я немного подумал об этом после завершения задачи. Модель партнерства B2B может на самом деле быть более быстрым путем к реальному рабочему AI-пайплайну. Возможно, коллаборация данных на уровне grassroots требует корпоративной структуры, прежде чем сможет функционировать в масштабе. Это разумный выбор дизайна. Но это действительно значит, что "коллаборативный" в коллаборативной разработке AI в настоящее время указывает на очень специфическую группу.
Кто на самом деле появится в Datanets, когда инфраструктура партнерства будет готова… эта часть еще предстоит написать.
Недавняя активность почти полностью состоит из двусторонних протокольных партнерств: DGrid для вычислений, Story Protocol для лицензирования прав, Chainbase для данных Web3, PublicAI для аннотации, TheoriqAI для агентов. Каждое из них — это рукопожатие между двумя командами, а не открытая деятельность участников. Тем временем CoinMarketCap показывает, что обращающаяся эмиссия выросла с 215,5M до более чем 290M OPEN, в основном благодаря эмиссиям вознаграждений сообщества — при этом годовая выручка протокола составляет около $693K, а сборы упали на 23% на прошлой неделе по данным DeFiLlama. Токены вышли, а использование еще не последовало.
Я немного подумал об этом после завершения задачи. Модель партнерства B2B может на самом деле быть более быстрым путем к реальному рабочему AI-пайплайну. Возможно, коллаборация данных на уровне grassroots требует корпоративной структуры, прежде чем сможет функционировать в масштабе. Это разумный выбор дизайна. Но это действительно значит, что "коллаборативный" в коллаборативной разработке AI в настоящее время указывает на очень специфическую группу.
Кто на самом деле появится в Datanets, когда инфраструктура партнерства будет готова… эта часть еще предстоит написать.