

Я всё время возвращаюсь к простому вопросу, который, похоже, стоит в основе многого в крипте: что именно мы владеем, когда система говорит, что она «децентрализована»? В платежах, владение очевидно. В кредитовании это капитал. В блокчейнах, построенных для вычислений, ответ становится менее ясным, потому что самое ценное часто не сам реестр, а данные, модели и системы координации, которые его питают. OpenLedger пытается сделать этот скрытый слой видимым. На своём сайте он описывает себя как AI блокчейн, созданный для разблокировки ликвидности вокруг данных, моделей и агентов, а его белая книга обрисовывает проект вокруг механизма, называемого Доказательство Атрибуции. Эта формулировка уже говорит мне о чём-то важном: это меньше утверждение о том, что AI должен быть «ончейн» в каком-то абстрактном смысле, и больше предложение о том, что входные данные для AI должны отслеживаться, кредитоваться и становиться экономически читабельными.
Проблема, которую он решает, не возникла за одну ночь. Годы подряд ИИ-системы улучшались, поглощая огромные объемы данных из открытых и частных источников, но люди, которые собирали, очищали, размечали или специализировали эти данные, редко имели какой-либо надежный путь к признанию или компенсации. В собственной статье OpenLedger это сказано напрямую: обучающие данные часто рассматриваются как анонимные и статичные, тогда как вкладчики остаются оторванными от ценности, которую их данные помогают создать. Это не только этическая претензия. Это еще и структурная проблема, потому что, когда данные превращаются во невидимый вход, у сторонних наблюдателей исчезает причина продолжать вносить качественные материалы, относящиеся к конкретной предметной области. В итоге получается знакомый крипто-шаблон в другой форме: ценность концентрируется в центре, а происхождение становится чем-то второстепенным.
Ранние попытки решить эту проблему обычно терпели неудачу по одной из двух причин. Некоторые системы пытались строить маркетплейсы для наборов данных, но останавливались на простом перечислении или лицензировании, не отслеживая, как конкретный вклад повлиял на конкретный результат. Другие делали ставку на прозрачность моделей в широком смысле — это полезно, но все равно не отвечает на более сложный вопрос атрибуции. В whitepaper OpenLedger прямо сказано, что он хочет проверяемую связь между поведением модели и обучающими данными, которые повлияли на нее, с распределением вознаграждений на основе этой связи. Это более амбициозное утверждение, чем просто открытость. Он пытается превратить атрибуцию в инфраструктуру, а не просто в документацию. Разница важна: документацию можно игнорировать, тогда как с инфраструктурой сложнее обходиться.
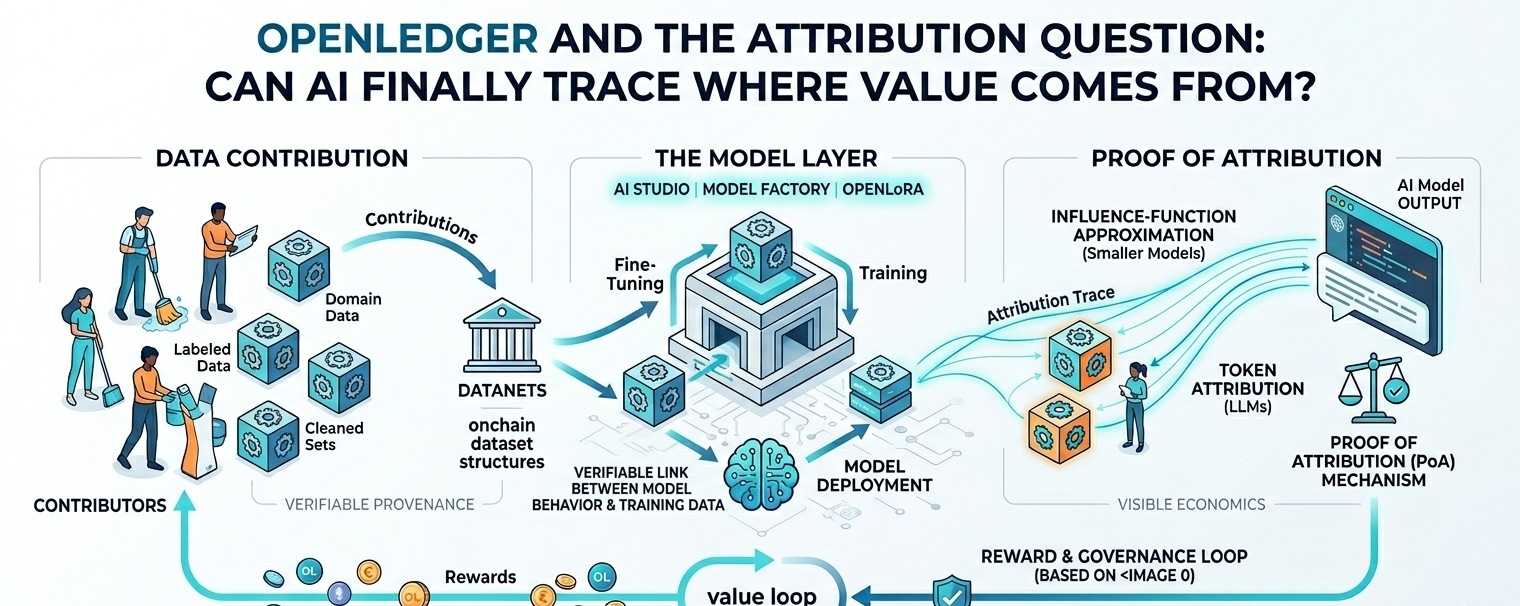
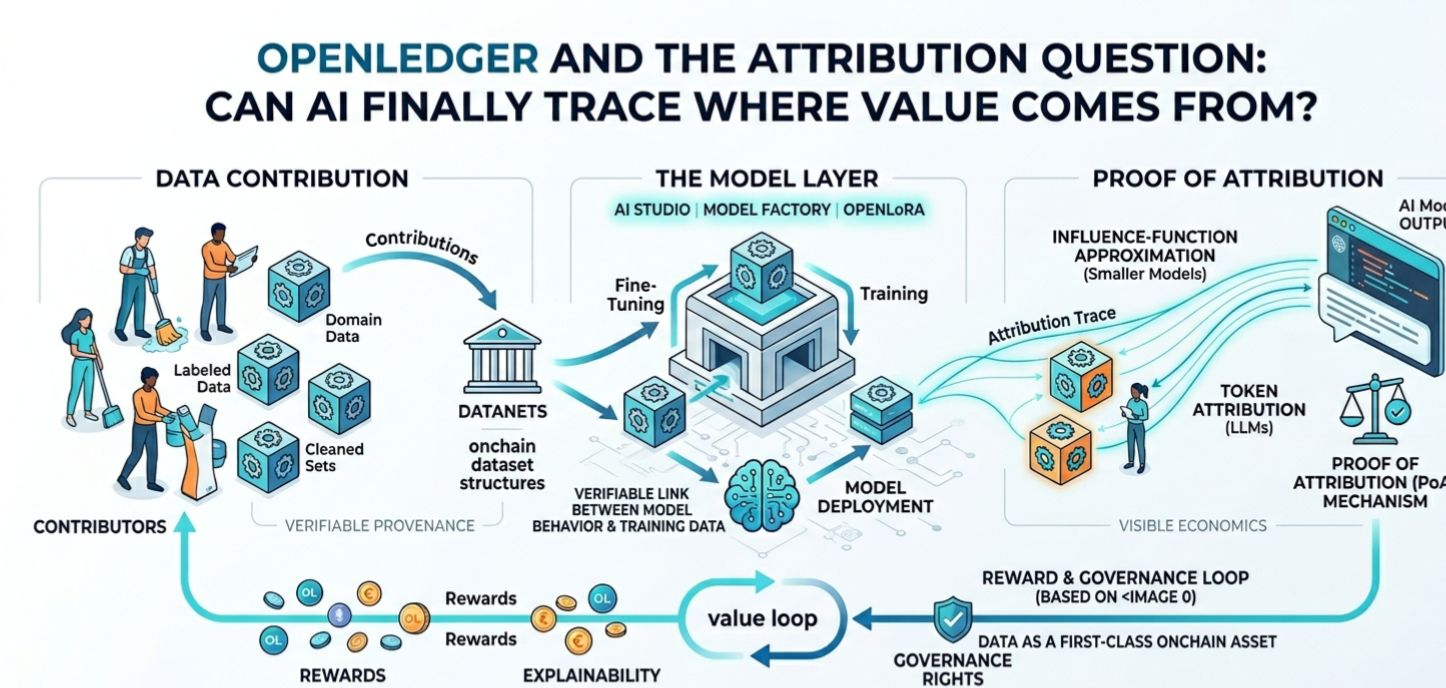
Архитектура, которую описывает OpenLedger, включает несколько движущихся частей, а логика проектирования довольно проста для понимания. В центре находятся DataNets — в статье они описаны как ончейн-структуры наборов данных, создаваемые через вклад со стороны сообщества. В собственных материалах проекта DataNets — это место, где сообщества совместно создают, модерируют и вносят наборы данных, которые позже начинают влиять на обучение моделей. Затем идет модельный слой: OpenLedger описывает AI Studio, Model Factory и OpenLoRA. Первое предназначено для сборки, второе — для дообучения, а третье — для более дешевого развертывания. Более общая идея в том, что сбор данных, обучение моделей и обслуживание моделей — не отдельные миры; их связывают происхождение, атрибуция и вознаграждения. Именно эта связка и есть главный тезис проекта.
Доказательство атрибуции — это то место, где этот тезис становится конкретным. В whitepaper OpenLedger говорит, что использует два разных метода атрибуции в зависимости от размера модели: приближения функции влияния для меньших моделей и атрибуцию токенов на основе суффиксного массива для больших моделей. Это говорит мне о том, что команда осознает: атрибуция — это не одна-единственная однородная техническая задача. Для небольших моделей можно использовать градиентные приближения того, как удаление одной точки данных меняет лосс; а для больших языковых моделей нужен другой подход, который сравнивает выходные токены со сжатым представлением обучающего корпуса. Логика разумная, но она также раскрывает сложность: система — это не просто «доказательство» вклада в юридическом смысле. Она оценивает влияние с помощью доступнейших инструментов, а затем использует эту оценку, чтобы разделить кредит и вознаграждения.
Я считаю этот акцент важным, потому что он помогает удерживать проект честным. Многие разговоры об атрибуции в ИИ звучат более точными, чем они есть на самом деле. Дизайн OpenLedger более аккуратный. В статье сказано, что выходные данные модели, метаданные и временные метки фиксируются в ончейне, а атрибуция рассчитывается после вывода, чтобы вознаграждения вкладчиков можно было распределять на основе относительного влияния. Это делает систему проверяемой, но не делает ее магически идеальной. Она может показать цепочку происхождения и путь вознаграждения; но она не способна стереть неоднозначность, которая всегда живет внутри сложных систем машинного обучения. Атрибуция в ИИ редко является чистой записью в реестре. Обычно это приближение, обернутое в политику. Похоже, OpenLedger это понимает — даже при том, что оно подает это приближение как примитив протокола.
Вот здесь проект начинает выглядеть не столько как слоган, сколько как серьезный эксперимент. OpenLedger заявляет, что это не универсальная цепочка общего назначения. Он ориентирован на ИИ и модельные рабочие процессы, и даже противопоставляет себя универсальным блокчейнам, подчеркивая нативную атрибуцию данных, происхождение и управление, связанное с качеством моделей, а не изменения протокола. На бумаге эта специализация выглядит привлекательной. Слишком многие криптосистемы пытаются быть всем сразу, а это обычно означает, что они становятся расплывчатыми ровно в тот момент, когда им нужно быть точными. Более узкий фокус OpenLedger дает ему понятную задачу: отслеживать, откуда пришли данные для ИИ, кто их внес, как это повлияло на модели и как распределяются вознаграждения. Это цельная рамка. Достаточно ли ее — отдельный вопрос.
Однако технические обещания не снимают компромиссов. Такая система должна нести на себе вес регистрации, верификации, учета выводов, распределения вознаграждений и управления, стараясь при этом оставаться полезной для разработчиков, которые могут не хотеть лишнего трения в своем рабочем процессе. В статье предлагается публичный граф атрибуции, и даже намекается, что позже права на управление могут отражать влияние набора данных на модели. Это интеллектуально интересно, но также поднимает знакомые проблемы: кто решает правила атрибуции, как обрабатываются споры, что происходит, когда набор данных используется способами, которых исходный вкладчик не ожидал, и насколько дорогой станет система, когда использование масштабируется. Это не побочные вопросы. Это разница между фреймворком, которым можно восхищаться, и фреймворком, который можно реально принять.
Есть и более тонкая обеспокоенность насчет того, что именно измеряется. Если атрибуция становится основой для вознаграждений, то представление протокола о влиянии начинает формировать поведение вкладчиков. Это может быть полезно, потому что поощряет данные более высокого качества и более продуманную модерацию. Но это также может сужать стимулы непредвиденными способами, потому что вкладчики могут оптимизировать не за широкой полезностью, а за прослеживаемым влиянием. Собственные материалы OpenLedger описывают потоки вознаграждений, объяснимость и доказательства, привязанные к каждому ответу,— именно такой механизм способен повысить подотчетность. Однако тот же механизм может создавать давление, заставляя упрощать сложные вклады до того, что атрибуционная система может распознать проще всего. Иными словами, протокол может вознаграждать то, что он способен измерить, прежде чем он полностью поймет, что действительно важно. Это не уникальный изъян OpenLedger, но это реальное ограничение дизайна.
Еще одно тихое препятствие — принятие. Проект такого типа нуждается не только в сильной истории. Ему нужны наборы данных, в которые стоит вносить вклад, разработчики, которые готовы обучать или дообучать через его стек, и пользователи моделей, которым действительно важна прослеживаемость происхождения, чтобы предпочесть более подотчетную систему более простой. Страницы собственной экосистемы OpenLedger указывают на такие продукты, как Explorer, staking, AI Studio и слой Open Circle community, что предполагает попытку создать социальную и техническую «поверхность», необходимую для устойчивого участия. Это разумно. Но инфраструктура имеет значение только если люди, использующие ИИ, ощущают отсутствие происхождения как реальную цену. Многие этого пока не делают — по крайней мере, не в полной мере. Поэтому первая аудитория для системы такого типа, вероятно, — это те, кто уже ближе всего к проблеме: вкладчики данных, узкие разработчики моделей, аудиторы и сообщества, пытающиеся создавать ИИ под конкретную предметную область, сохраняя при этом некоторую прослеживаемость.
При этом остается открытой более крупная неопределенность, вероятно, самая интересная вещь в OpenLedger. Проект пытается превратить данные в первоклассный ончейн-актив, и эта идея звучит убедительнее, чем может показаться вначале, потому что ИИ действительно зависит от цепочки вкладов, которая обычно скрыта от взгляда. Но чем сильнее проект делает ставку на атрибуцию, тем больше ему приходится доказывать, что система достаточно точна, достаточно легковесна и достаточно справедлива, чтобы пережить рамки whitepaper. Я понимаю, почему проблема снова и снова всплывает: ИИ продолжает потреблять больше ценности, чем он может прозрачно возвращать. OpenLedger — это одна из попыток ответить на этот дисбаланс. Неразрешенный вопрос в том, будет ли будущее ИИ действительно вознаграждать системы, делающие вклад видимым, или же сама видимость останется слишком дорогой для того, чтобы рынок мог полностью ее принять.