


Чем дольше я смотрю на OpenLoRA от @OpenLedger , тем меньше воспринимаю её как очередную оптимизацию для ИИ. Для меня это скорее похоже на проверку того, может ли вся экономика OpenLedger работать в принципе в масштабе вообще.
Интересно, что к такому выводу я пришёл не через техническое описание продукта, а через простой вопрос: что будет, если OpenLoRA убрать из архитектуры?
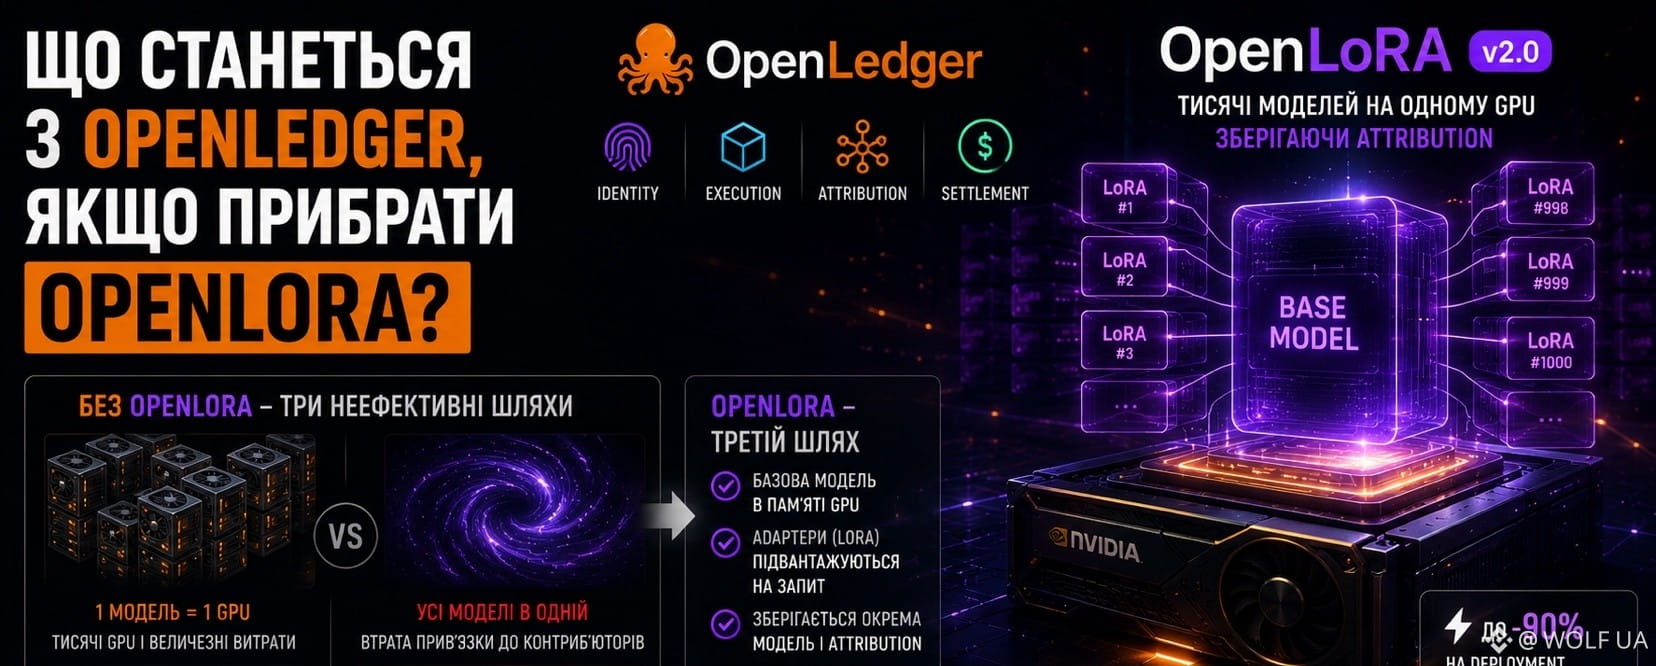
Сначала коротко о самой технологии. OpenLoRA построена вокруг идеи эффективного запуска большого количества fine-tuned моделей без необходимости выделять отдельный GPU под каждую. Базовая модель остается загруженной постоянно, а LoRA-адаптеры подключаются только в момент запроса. Команда заявляет о возможности обслуживать тысячи адаптеров на одном GPU и существенно снижать расходы на инференс. Механизмы вроде 4-bit quantization, dynamic loading и flash attention описаны открыто. А вот цифры про тысячи моделей и экономию до 90% пока остаются результатами внутренних тестов — независимых измерений я не нашел.
А теперь вернемся к вопросу об отсутствии OpenLoRA.
В основе @OpenLedger лежит Proof of Attribution. Идея проста: система должна знать, какие данные повлияли на конкретную модель и ее результат. Но если сеть хочет поддерживать не десятки, а тысячи специализированных моделей — юридических, финансовых, медицинских, исследовательских — возникает проблема размещения.
Первый вариант очевиден: отдельная модель на отдельном GPU. Но тогда экономика очень быстро начинает напоминать не Web3, а традиционный облачный бизнес с огромными счетами за вычисления.
Второй вариант — объединить все в одну большую модель и управлять поведением через промпты. Это дешевле, но тогда attribution теряет точность. Становится сложно понять, кто именно внес вклад в результат и кому принадлежит вознаграждение.
Фактически OpenLoRA пытается найти третий путь. Сохранить отдельность моделей без необходимости умножать количество GPU. Если эта схема работает так, как заявлено, тогда OpenLedger получает шанс масштабировать собственную экономику без потери привязки между моделью, данными и контрибьюторами.
Именно поэтому я смотрю на OpenLoRA не как на инструмент для ускорения инференса. Таких решений на рынке достаточно. Для @OpenLedger она выполняет другую роль — удерживает связь между выполнением модели и механикой attribution.
Однако здесь остается главный вопрос. Насколько рынку вообще нужна эта особенность?
Если компании и разработчики начнут требовать прозрачного происхождения данных и справедливого распределения доходов, тогда OpenLoRA может оказаться важным элементом будущей AI-инфраструктуры. Если же рынок продолжит выбирать только скорость и дешевизну, то даже самая изящная архитектура рискует остаться нишевым решением.
Поэтому для меня OpenLoRA — это не история про GPU. Это ставка на то, что через несколько лет ценность attribution станет не менее важной, чем само качество модели.
А как ты оцениваешь подобные технологии? Ждешь независимых бенчмарков и доказательств или готов дать проекту кредит доверия, если сама логика решения выглядит убедительно?
