


Когда я смотрю на OpenLedger, я начинаю думать не столько о блокчейне, сколько о проблеме, которая тихо нарастает под поверхностью цифровой экономики на протяжении многих лет.
Думаю, мы достигли точки, когда данные стали одним из самых ценных ресурсов в мире, но отношения между теми, кто их создает, и теми, кто на этом зарабатывает, остаются удивительно разрозненными. Каждый день люди генерируют огромные объемы информации через беседы, приложения, транзакции, поисковые запросы и онлайн-активность. Эти данные питают системы ИИ, улучшают модели и помогают компаниям создавать все более мощные продукты. Однако большинство участников rarely участвуют в той ценности, которая возникает из их вкладов.
Меня интересует, что этот дисбаланс не возник, потому что кто-то намеренно так его спроектировал. Во многих отношениях это просто результат эволюции интернета. Централизованные платформы стали эффективными местами для сбора, организации и монетизации информации. Со временем, собственность на данные, собственность на инфраструктуру и захват ценности стали сосредоточены в одних и тех же местах.
Поскольку искусственный интеллект становится все более важным, я думаю, эта проблема становится все более трудной для игнорирования.
Модели AI зависят от огромных наборов данных. Эти наборы данных поступают от бесчисленных людей, бизнесов, приложений и систем. Разработчики моделей вносят экспертизу и инновации. Пользователи предоставляют отзывы, которые улучшают производительность. Тем не менее, несмотря на количество участников, вовлеченных в процесс, экономическая структура часто кажется удивительно узкой.
Чем больше я изучаю это пространство, тем больше я чувствую, что проблема заключается не только в технологии. Она также экономическая.
Вопрос больше не в том, как построить лучший AI. Вопрос в том, как построить системы, которые справедливо координируют людей, данные, модели и агентов, которые делают AI возможным с самого начала.
Здесь OpenLedger привлек мое внимание.
Вместо того, чтобы сосредоточиться исключительно на производительности модели или вычислительной мощности, я вижу, что OpenLedger пытается решить более глубокую структурную проблему. Проект, похоже, начинается с относительно простой идеи: если данные, AI модели и автономные агенты становятся продуктивными цифровыми активами, то, возможно, им нужна инфраструктура, способная отслеживать вклад и распределять ценность более прозрачно.
Мне эта перспектива интересна, потому что она смещает разговор от чистой технологии к дизайну стимулов.
В большинстве обсуждений AI данные рассматриваются как сырьё. Они попадают в систему, способствуют обучению, а затем в значительной степени исчезают из вида. Связь между первоначальным вкладчиком и будущей ценностью, генерируемой этими данными, часто становится невозможной для измерения.
OpenLedger, похоже, исследует альтернативный подход.
Когда я читаю о проекте, я не вижу, что он пытается позиционировать данные как пассивный вход. Вместо этого я вижу попытку рассматривать данные как экономический актив, который может продолжать генерировать ценность в рамках более широкой сети. Идея, похоже, заключается в том, что если вклад можно идентифицировать и атрибутировать, то вознаграждения могут потенциально распределяться более эффективно.
На первый взгляд, это звучит просто.
Чем больше я об этом думаю, тем более сложным это становится.
Измерять вклад внутри AI систем не легко. Данные редко создают ценность в изоляции. Модель может зависеть от тысяч наборов данных. Несколько вкладчиков могут одновременно влиять на результаты. Полезность информации часто меняется со временем.
Из-за этого я думаю, что настоящая проблема, с которой сталкивается OpenLedger, заключается не в том, может ли блокчейн записывать транзакции. Настоящая проблема заключается в том, можно ли измерить сам вклад в значимом ключе.
Это различие имеет значение.
Многие проекты блокчейн сосредотачиваются на создании инфраструктуры. OpenLedger, похоже, задает другой вопрос: как инфраструктура может поддерживать экономическую атрибуцию в экосистемах AI?
Я нахожу этот вопрос значительно более интересным.
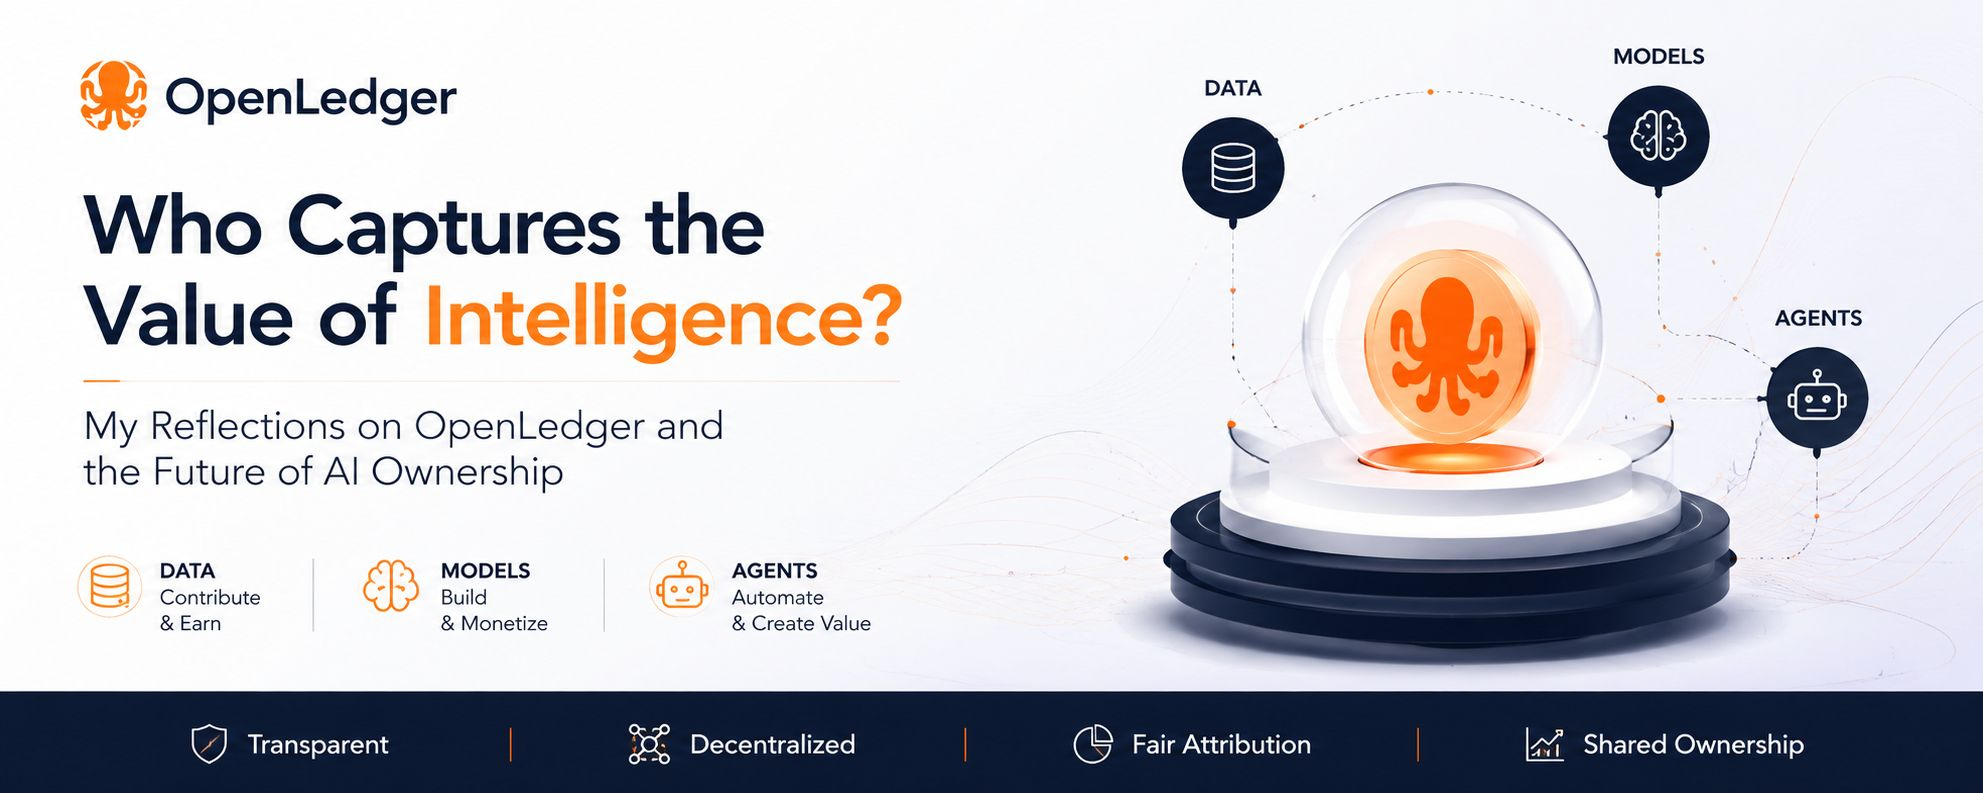
Когда я отступаю и смотрю на более широкую картину, я вижу разработку AI как высоко взаимосвязанной процесс. Поставщики данных создают ресурсы. Разработчики строят модели. Приложения предоставляют полезность. Пользователи генерируют обратную связь. Автономные агенты все чаще выполняют задачи от имени людей и организаций.
Никакие из этих компонентов не работают независимо.
Ценность, создаваемая системой, возникает из взаимодействий между ними.
Что я думаю, что OpenLedger пытается сделать, так это создать среду, где эти взаимодействия становятся экономически видимыми. Вместо того чтобы рассматривать данные, модели и агентов как отдельные миры, проект, похоже, исследует способы соединить их через общую структуру.
Если это будет успешно, это может потенциально уменьшить одну из самых больших неэффективностей в сегодняшней экономике AI: разрыв между вкладом и компенсацией.
Конечно, я также думаю, что важно оставаться реалистом.
История показывает, что системы стимулов невероятно трудно проектировать. Создавать вознаграждения легко. Создавать устойчивые вознаграждения гораздо сложнее.
Когда экономические стимулы вводятся, участники естественным образом адаптируют свое поведение вокруг них. Некоторые вносят подлинную ценность. Другие оптимизируют для вознаграждений. Со временем системы должны постоянно балансировать открытость, качество, справедливость и эффективность.
Это почему я думаю, что будущее OpenLedger будет зависеть так же от экономики, как и от технологии.
Инфраструктура может работать идеально, но если стимулы искажены, система все равно может испытывать трудности. Напротив, если стимулы остаются согласованными, сеть может потенциально привлечь все более ценные вклады со временем.
Еще один аспект, который заставляет меня думать, это идея ликвидности.
Я часто чувствую, что большая часть экономики AI содержит активы, которые ценны, но их трудно напрямую монетизировать. Данные имеют ценность, но часто лишены эффективных рынков. Модели создают полезность, но могут испытывать трудности с захватом продолжающегося экономического участия. Автономные агенты могут выполнять полезную работу, но часто действуют в рамках ограниченных экономических структур.
OpenLedger, похоже, исследует способы сделать эти активы более экономически активными.
Я думаю об этом почти как о превращении спящих ресурсов в продуктивный капитал.
Набор данных, который не используется, содержит потенциальную ценность. Модель, которая простаивает, содержит потенциальную ценность. Автономный агент, ожидающий задач, содержит потенциальную ценность. Проблема заключается в том, чтобы соединить эти ресурсы с системами, способными распознавать и вознаграждать их вклад.
Похоже, это одна из центральных идей OpenLedger.
Станет ли проект в конечном итоге успешным, я не могу с уверенностью предсказать.
Что я могу сказать, так это то, что нахожу направление интеллектуально увлекательным.
На протяжении многих лет обсуждения вокруг AI в основном сосредотачивались на самом интеллекте — как модели учатся, как они рассуждают и как они улучшаются. Все больше я думаю, что разговор смещается к собственности, атрибуции и распределению ценности.
Кто выигрывает, когда AI создает ценность?
Кто должен получать вознаграждение, когда данные способствуют успешному результату?
Как должны автономные агенты участвовать в цифровых экономиках?
Эти вопросы становятся все более важными по мере того, как системы AI становятся более способными.
Когда я смотрю на OpenLedger, я не вижу проект, который просто пытается объединить AI и блокчейн, потому что обе технологии популярны. Я вижу попытку решить структурную проблему, которая существует между ними. Проект, похоже, осознает, что одного интеллекта недостаточно. Экономическая координация тоже важна.
Во многих отношениях OpenLedger кажется экспериментом по переосмыслению того, как ценность движется через экосистемы AI.
Самая интересная часть, по крайней мере с моей точки зрения, заключается не в том, работает ли технология. Технологию часто можно улучшить со временем. Меня больше интересует, может ли система успешно согласовать стимулы среди поставщиков данных, строителей моделей, разработчиков и автономных агентов, не создавая чрезмерной сложности.
Это сложная задача.
Тем не менее, я верю, что это именно та проблема, которая определит следующий этап экономики AI.
Продолжая следить за OpenLedger, я возвращаюсь к одной и той же мысли. Будущее искусственного интеллекта может определяться не только тем, кто строит самые умные модели. Оно также может формироваться теми, кто создает самые эффективные системы для атрибуции, координации и распределения ценности, которую генерируют эти модели.
OpenLedger пытается исследовать эту возможность.
Станет ли это важной частью будущей инфраструктуры или просто важным экспериментом, я думаю, что вопросы, которые оно поднимает, гораздо более значимы, чем доступные сейчас ответы. И в быстро меняющемся ландшафте AI иногда самые ценные проекты не те, когда я смотрю на OpenLedger, я думаю меньше о блокчейне и больше о проблеме, которая тихо растет под поверхностью цифровой экономики на протяжении многих лет.
Я думаю, мы достигли точки, где данные стали одним из самых ценных ресурсов в мире, но связь между теми, кто их создает, и теми, кто извлекает из них выгоду, остается удивительно разъединенной. Каждый день люди генерируют огромные объемы информации через разговоры, приложения, транзакции, поиски и онлайн-активность. Эти данные питают системы AI, улучшают модели и помогают компаниям создавать все более мощные продукты. Тем не менее, большинство вкладчиков редко участвуют в ценности, которая возникает из их вклада.
Меня интересует, что этот дисбаланс не возник, потому что кто-то намеренно так его спроектировал. Во многих отношениях это просто результат эволюции интернета. Централизованные платформы стали эффективными местами для сбора, организации и монетизации информации. Со временем, собственность на данные, собственность на инфраструктуру и захват ценности стали сосредоточены в одних и тех же местах.
Поскольку искусственный интеллект становится все более важным, я думаю, эта проблема становится все более трудной для игнорирования.
Модели AI зависят от огромных наборов данных. Эти наборы данных поступают от бесчисленных людей, бизнесов, приложений и систем. Разработчики моделей вносят экспертизу и инновации. Пользователи предоставляют отзывы, которые улучшают производительность. Тем не менее, несмотря на количество участников, вовлеченных в процесс, экономическая структура часто кажется удивительно узкой.
Чем больше я изучаю это пространство, тем больше я чувствую, что проблема заключается не только в технологии. Она также экономическая.
Вопрос больше не в том, как построить лучший AI. Вопрос в том, как построить системы, которые справедливо координируют людей, данные, модели и агентов, которые делают AI возможным с самого начала.
Здесь OpenLedger привлек мое внимание.
Вместо того чтобы сосредотачиваться исключительно на производительности модели или вычислительной мощности, я вижу, что OpenLedger пытается решить более глубокую структурную проблему. Проект, похоже, начинается с относительно простой идеи: если данные, AI модели и автономные агенты становятся продуктивными цифровыми активами, то, возможно, им нужна инфраструктура, способная отслеживать вклад и распределять ценность более прозрачно.
Мне эта перспектива интересна, потому что она смещает разговор от чистой технологии к дизайну стимулов.
В большинстве обсуждений AI данные рассматриваются как сырьё. Они попадают в систему, способствуют обучению, а затем в значительной степени исчезают из виду. Связь между первоначальным вкладчиком и будущей ценностью, генерируемой этими данными, часто становится невозможной для измерения.
OpenLedger, похоже, исследует альтернативный подход.
Когда я читаю о проекте, я не вижу, что он пытается позиционировать данные как пассивный вход. Вместо этого я вижу попытку рассматривать данные как экономический актив, который может продолжать генерировать ценность в рамках более широкой сети. Идея, похоже, заключается в том, что если вклад можно идентифицировать и атрибутировать, то вознаграждения могут потенциально распределяться более эффективно.
На первый взгляд, это звучит просто.
Однако, чем больше я об этом думаю, тем более сложным это становится.
Измерять вклад внутри AI систем не легко. Данные редко создают ценность в изоляции. Модель может зависеть от тысяч наборов данных. Несколько вкладчиков могут одновременно влиять на результаты. Полезность информации часто меняется со временем.
Из-за этого я думаю, что настоящая проблема, с которой сталкивается OpenLedger, заключается не в том, может ли блокчейн записывать транзакции. Настоящая проблема заключается в том, можно ли измерить сам вклад в значимом ключе.
Это различие имеет значение.
Многие проекты блокчейн сосредотачиваются на создании инфраструктуры. OpenLedger, похоже, задает другой вопрос: как инфраструктура может поддерживать экономическую атрибуцию в экосистемах AI?
Я нахожу этот вопрос значительно более интересным.
Когда я отступаю и смотрю на более широкую картину, я вижу разработку AI как высоко взаимосвязанной процесс. Поставщики данных создают ресурсы. Разработчики строят модели. Приложения предоставляют полезность. Пользователи генерируют обратную связь. Автономные агенты все чаще выполняют задачи от имени людей и организаций.
Никакие из этих компонентов не работают независимо.
Ценность, создаваемая системой, возникает из взаимодействий между ними.
Что я думаю, что OpenLedger пытается сделать, так это создать среду, где эти взаимодействия становятся экономически видимыми. Вместо того чтобы рассматривать данные, модели и агентов как отдельные миры, проект, похоже, исследует способы соединить их через общую структуру.
Если это будет успешно, это может потенциально уменьшить одну из самых больших неэффективностей в сегодняшней экономике AI: разрыв между вкладом и компенсацией.
Конечно, я также думаю, что важно оставаться реалистом.
История показывает, что системы стимулов невероятно трудно проектировать. Создавать вознаграждения легко. Создавать устойчивые вознаграждения гораздо сложнее.
Когда экономические стимулы вводятся, участники естественным образом адаптируют свое поведение вокруг них. Некоторые вносят подлинную ценность. Другие оптимизируют для вознаграждений. Со временем системы должны постоянно балансировать открытость, качество, справедливость и эффективность.
Это почему я думаю, что будущее OpenLedger будет зависеть так же от экономики, как и от технологии.
Инфраструктура может работать идеально, но если стимулы искажены, система все равно может испытывать трудности. Напротив, если стимулы остаются согласованными, сеть может потенциально привлечь все более ценные вклады со временем.
Еще один аспект, который заставляет меня думать, это идея ликвидности.
Я часто чувствую, что большая часть экономики AI содержит активы, которые ценны, но их трудно напрямую монетизировать. Данные имеют ценность, но часто лишены эффективных рынков. Модели создают полезность, но могут испытывать трудности с захватом продолжающегося экономического участия. Автономные агенты могут выполнять полезную работу, но часто действуют в рамках ограниченных экономических структур.
OpenLedger, похоже, исследует способы сделать эти активы более экономически активными.
Я думаю об этом почти как о превращении спящих ресурсов в продуктивный капитал.
Набор данных, который не используется, содержит потенциальную ценность. Модель, которая простаивает, содержит потенциальную ценность. Автономный агент, ожидающий задач, содержит потенциальную ценность. Проблема заключается в том, чтобы соединить эти ресурсы с системами, способными распознавать и вознаграждать их вклад.
Похоже, это одна из центральных идей OpenLedger.
Станет ли проект в конечном итоге успешным, я не могу с уверенностью предсказать.
Что я могу сказать, так это то, что нахожу направление интеллектуально увлекательным.
На протяжении многих лет обсуждения вокруг AI в основном сосредотачивались на самом интеллекте — как модели учатся, как они рассуждают и как они улучшаются. Все больше я думаю, что разговор смещается к собственности, атрибуции и распределению ценности.
Кто выигрывает, когда AI создает ценность?
Кто должен получать вознаграждение, когда данные способствуют успешному результату?
Как должны автономные агенты участвовать в цифровых экономиках?
Эти вопросы становятся все более важными по мере того, как системы AI становятся более способными.
Когда я смотрю на OpenLedger, я не вижу проект, который просто пытается объединить AI и блокчейн, потому что обе технологии популярны. Я вижу попытку решить структурную проблему, которая существует между ними. Проект, похоже, осознает, что одного интеллекта недостаточно. Экономическая координация тоже важна.
Во многих отношениях OpenLedger кажется экспериментом по переосмыслению того, как ценность движется через экосистемы AI.
Самая интересная часть, по крайней мере с моей точки зрения, заключается не в том, работает ли технология. Технологию часто можно улучшить со временем. Меня больше интересует, может ли система успешно согласовать стимулы среди поставщиков данных, строителей моделей, разработчиков и автономных агентов, не создавая чрезмерной сложности.
Это сложная задача.
Тем не менее, я верю, что это именно та проблема, которая определит следующий этап экономики AI.
Продолжая следить за OpenLedger, я возвращаюсь к одной и той же мысли. Будущее искусственного интеллекта может определяться не только тем, кто строит самые умные модели. Оно также может формироваться теми, кто создает самые эффективные системы для атрибуции, координации и распределения ценности, которую генерируют эти модели.
OpenLedger пытается исследовать эту возможность.
\u003cm-272/\u003e \u003cc-274/\u003e \u003ct-276/\u003e
