

Чем дольше я наблюдаю за децентрализованными проектами данных, тем больше я чувствую, что большинство обсуждений сосредоточены на неправильной конкуренции.
Люди часто представляют это как гонку за поставкой данных.
Кто сможет собрать больше данных. Кто привлечет наибольшее количество участников. Кто построит самый большой рынок.
Но это может быть только поверхностный слой.
Сами данные никогда не были действительно дефицитным ресурсом.
Гораздо сложнее найти систему, способную преобразовывать сырые данные в интеллектуальные решения, которые можно проверять, постоянно улучшать и многократно генерировать ценность.
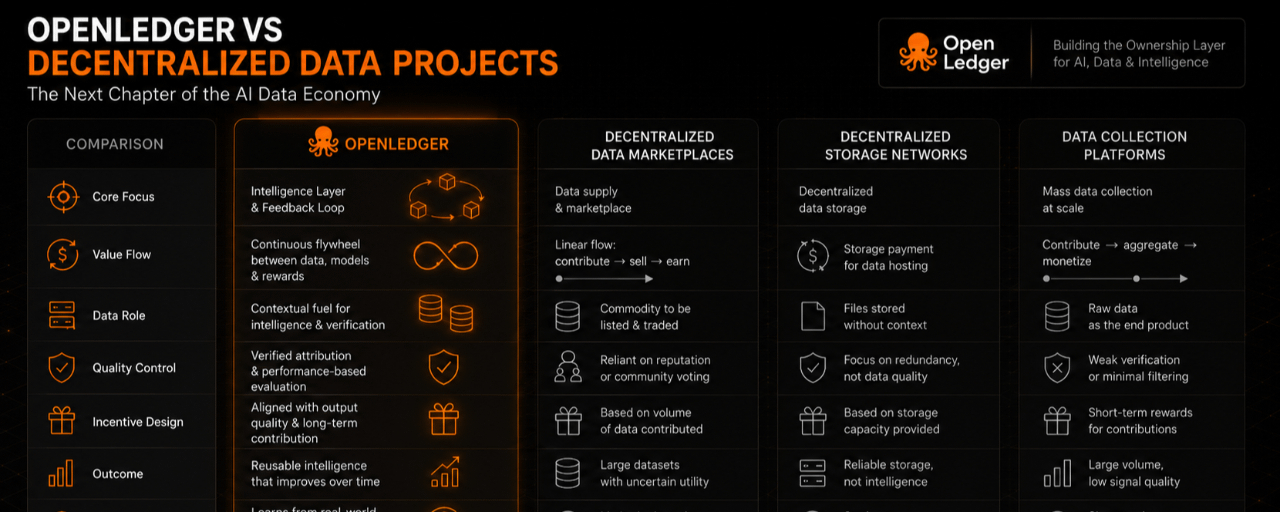
Вот почему мне особенно интересно изучать OpenLedger по сравнению со многими инициативами в сфере децентрализованных данных, которые появились за последние несколько лет.
Большинство проектов исходят из предположения, что если собрать достаточно данных, то остальная экосистема естественным образом разовьётся вокруг этого.
В теории это имеет смысл.
Однако на практике данные редко оказываются недостающим компонентом.
Настоящие сложности — это контекст, оценка качества и понимание того, какие датасеты дают лучшие результаты, чем другие.
И что ещё важнее: многие системы всё ещё испытывают трудности с тем, чтобы связать вкладчиков с той ценностью, которую создают их данные.
С моей точки зрения, OpenLedger подходит к этой задаче иначе.
Вместо того чтобы фокусироваться исключительно на создании огромного репозитория информации, цель, похоже, состоит в том, чтобы выстроить контур обратной связи, где данные, ИИ-модели и экономические стимулы непрерывно усиливают друг друга.
На первый взгляд это может показаться незначительным различием в дизайне.
На самом деле это создаёт совершенно другие стимулы поведения.
Потому что люди не реагируют только на технологии.
Они реагируют на стимулы.
Многие децентрализованные проекты с данными побуждают пользователей сначала предоставлять данные, а затем уже пытаться найти способы извлечь из них ценность.
Некоторые более новые подходы, включая OpenLedger, похоже, разворачивают этот процесс.
Значение, генерируемое результатами, становится отправной точкой, при этом данные выступают одним из компонентов в более крупном цикле создания ценности.
То, что выглядит как решение в продукте, может на самом деле отражать более широкий сдвиг в том, как рынок думает об ИИ.
Первая волна была одержима моделями.
Следующая волна была одержима данными.
Теперь внимание, похоже, смещается к другому вопросу:
Как мы строим системы, которые непрерывно учатся на взаимодействиях с реальным миром, а не просто накапливают всё большие датасеты?
Потому что данные не статичны.
Это отражение человеческого поведения.
И человеческое поведение постоянно меняется.
То, что сегодня особенно актуально, может устареть уже через несколько месяцев — по мере того как люди меняют способы поиска, общения и принятия решений.
Модель, обученная на реальности вчерашнего дня, может оказаться не оптимизированной для завтрашнего.
Возможно, именно поэтому я продолжаю уделять внимание проектам вроде OpenLedger.
Не потому, что они полностью решили задачу децентрализованных данных.
Но потому что они исследуют более фундаментальный вопрос.
Если в конечном итоге возникнет экономика, управляемая ИИ, где будет находиться реальная ценность?
Овладением данными?
Овладением моделями?
Или в том, чтобы владеть контуром обратной связи, который непрерывно связывает их между собой?
Я не думаю, что рынок ещё нашёл однозначный ответ.
Но всё больше ощущается, что следующая крупная конкуренция будет не о том, у кого больше всего данных.
Вопрос в том, кто сможет создавать системы, которые сохраняют данные ценными, пока мир — и человеческое поведение — продолжают развиваться.